이전 시리즈에서는 Cilium의 기본 개념과 Identity, Endpoint, IPAM 등을 쿠버네티스 환경에서 직접 실습했고, Socket LB(East-West Load Balancing)는 TCPDUMP를 기반으로 패킷을 하나하나 분석하며 이해를 진행했다. 다만 내용이 길어지면서 다음 주제인 North-South Load Balancing은 다루지 못했다. 이번 글에서는 North-South Load Balancing을 다루고자 한다.
North-South Load Balancing
지금까지 다룬 내용은 In-Cluster 내 Pod to Pod 통신, 즉 East-West 통신을 기반으로 진행했다. In-Cluster 통신의 경우 출발지 파드가 클러스터가 소유한 노드에 있기 때문에, 출발지 파드가 네트워크 연결을 요청할 때 connect() 함수를 eBPF로 후킹할 수 있었다. 하지만 North-South 통신의 경우 외부 클라이언트로부터 트래픽이 인입되기 때문에 connect() 함수를 후킹할 수 없다. 그렇기에 패킷이 도착하는 목적지 노드의 tc(tcx) 계층에서 DNAT을 수행해야 한다(cil_from_netdev@eth0). 그리고 백엔드가 다른 노드에 있다면 해당 노드로 패킷을 포워딩까지 해야 한다. 응답의 경우 처음 도착했던 노드를 통해서 최초의 외부 클라이언트에게 응답을 제공해야 한다(클라이언트는 요청했던 노드 IP:포트에서 응답을 기다리고 있기 때문이다).
North-South Load Balancing: 외부 트래픽을 쿠버네티스 노드 내 서비스로 전달
East-West Load Balancing: 내부 서비스 간 로드 밸런싱
North-South 로드밸런싱에는 3가지 모드가 존재한다.
SNAT 모드 (기본)
클러스터 외부 클라이언트에서 발생한 패킷이 노드 A에 도착했다고 가정하자. 이때 전송하려는 백엔드 파드가 노드 B에 있다면, 노드 A는 패킷의 소스를 자신의 IP로 변경(SNAT)한 뒤 노드 B로 전송한다. 응답받은 파드는 다시 노드 B로 전달하고 노드 B는 노드 A로 전달한다. 최종적으로 노드 A가 외부 클라이언트에게 응답한다.
ExternalTrafficPolicy가 local이라면 백엔드가 클라이언트의 IP를 볼 수 있지만, 그 외의 경우에는 소스 IP가 노드 A의 IP로 변경되어 있다. 또한 응답이 노드 A를 거치므로 네트워크 홉이 하나 더 생긴다.
DSR (Direct Server Return)
패킷이 노드 A에 도착했을 때 소스를 클라이언트 IP 그대로 유지한 채 노드 B로 전달한다. 전달받은 노드 B는 백엔드 파드에게 전달한다. 전달받은 백엔드 파드는 소스가 클라이언트 IP로 되어 있기 때문에 외부 클라이언트에게 직접 응답을 제공한다. 즉, 노드 A를 거치지 않는다.
장점이라면 클라이언트 IP를 보존할 수 있고, 응답 경로를 단축할 수 있다는 점이다. 다만, 최초 패킷을 받은 노드 A는 원래 목적지(클라이언트의 주소 정보)를 노드 B에게 어떻게든 전달해야 하는 과정이 필수적이다.
cilium-lab-worker(172.18.0.3) 노드에는 netshoot-7b776d8bd4-brh8b 파드가 배포되어 있고 cilium-lab-worker2(172.18.0.4) 노드에는 netshoot-7b776d8bd4-wlsk9 파드가 배포되어 있다. 각각 80번 포트의 웹서버가 동작 중이라고 가정할 때, 외부 도커 컨테이너(클러스터 외부)가 cilium-lab-worker 노드에 요청을 보내 cilium-lab-worker2 노드로 패킷이 전달되어 netshoot-7b776d8bd4-wlsk9 파드로 트래픽이 최종적으로 흐르는 상황이다. 그전에 netshoot Deployment에 NodePort 서비스를 추가한다.
# NodePort 서비스 추가
kubectl expose deployment netshoot --type=NodePort --port=80 --name=netshoot-np

kubectl get svc

NAME           TYPE        CLUSTER-IP      EXTERNAL-IP   PORT(S)        AGE
kubernetes     ClusterIP   10.96.0.1       <none>        443/TCP        25h
netshoot-np    NodePort    10.96.136.151   <none>        80:31178/TCP   20s
netshoot-svc   ClusterIP   10.96.57.113    <none>        80/TCP         24h
NodePort로 31178을 사용하는 것을 알 수 있다.
# 외부 도커 컨테이너 실행 및 HTTP 요청
docker run -d --name ext-client --network kind nicolaka/netshoot sleep infinity
docker exec ext-client curl http://172.18.0.3:31178

# cilium-lab-worker2에서 tcpdump 캡처 시작
docker exec cilium-lab-worker2 bash -c "apt update && apt install tcpdump -y"
docker exec cilium-lab-worker2 tcpdump -i any -n "tcp and (tcp port 80 or tcp port 31178)"

15:29:56.953692 cilium_vxlan P   IP 10.0.2.37.59516 > 10.0.0.203.80: Flags [S], seq 1729550172, win 65495, options [mss 65495,sackOK,TS val 3966506285 ecr 0,nop,wscale 7], length 0

15:29:56.954004 lxcb816d8186f24 In  IP 10.0.0.203.80 > 10.0.2.37.59516: Flags [S.], seq 1814208142, ack 1729550173, win 65418, options [mss 65430,sackOK,TS val 384236862 ecr 3966506285,nop,wscale 7], length 0

15:29:56.954120 cilium_vxlan Out IP 10.0.0.203.80 > 10.0.2.37.59516: Flags [S.], seq 1814208142, ack 1729550173, win 65418, options [mss 65430,sackOK,TS val 384236862 ecr 3966506285,nop,wscale 7], length 0
tcpdump로 cilium-lab-worker2에서 캡처한 패킷 중 중요 부분만 일부 표시 및 분석을 진행한다.
15:29:56.953692 cilium_vxlan P IP 10.0.2.37.59516 > 10.0.0.203.80: Flags [S], seq 1729550172, win 65495, options [mss 65495,sackOK,TS val 3966506285 ecr 0,nop,wscale 7], length 0
10.0.2.37 IP는 cilium-lab-worker의 cilium_host 인터페이스다. 이는 노드에서 트래픽이 나가는 지점이기에 해당 IP로 소스가 설정된다. 이 VXLAN 패킷을 cilium_vxlan 인터페이스에서 수신한다. 이를 cilium-lab-worker2 노드의 파드에 트래픽을 전달한다.
여기서 재미있는 점이 존재한다. 만약 cilium에서 kube-proxy가 존재하는 IPTables 상태였다면 노드 입장에서 파드의 veth pair 쌍인 lxcXXXXXX와 eth0 간 통신 과정에서 lxcXXXXXX로 패킷이 나가는 흐름이 캡처됐을 것이다. 하지만 현재는 cilium + eBPF 모드이기 때문에
호스트의 TC(TCX) 계층에서 수신한 패킷이 eBPF 프로그램인 cil_from_overlay에 의하여 내부적으로 bpf_redirect_peer() bpf helper 함수를 호출하여 lxcXXXXXX의 veth pair 인터페이스인 파드의 netns 내 eth0에 패킷을 포워딩한다. 그렇기에 파드의 veth pair(호스트에 설치된 인터페이스) lxcXXXXXX에는 패킷이 흐르지 않아 호스트에서 실행 중인 tcpdump에는 캡처되지 않는다.
15:29:56.954004 lxcb816d8186f24 In IP 10.0.0.203.80 > 10.0.2.37.59516: Flags [S.], seq 1814208142, ack 1729550173, win 65418, options [mss 65430,sackOK,TS val 384236862 ecr 3966506285,nop,wscale 7], length 0
이는 백엔드 파드의 응답이다. 처음 목적지인 cilium-lab-worker에 응답하는 것을 볼 수 있다. 다만, Out은 안 보이고 lxc In만 보이는 이유는 bpf_redirect_peer() bpf helper 함수가 단방향으로 패킷을 주입하는 함수이기 때문이다. 그렇기에 파드의 응답은 파드 내 netns에 설치된 eth0, 그리고 그 veth pair 쌍인 lxcXXXXXX에는 In으로 캡처된다.
15:29:56.954120 cilium_vxlan Out IP 10.0.0.203.80 > 10.0.2.37.59516: Flags [S.], seq 1814208142, ack 1729550173, win 65418, options [mss 65430,sackOK,TS val 384236862 ecr 3966506285,nop,wscale 7], length 0
이는 VXLAN 회신이다. 이처럼 SNAT 모드라면 요청과 응답이 모두 최초 트래픽의 진입 지점 노드를 통과한다는 것을 알 수 있다.
Cilium + eBPF 기반 DSR 모드에서의 패킷 캡처 확인
이전 SNAT 실습에서 클라이언트 소스 IP가 사라지고 응답 구간에서 노드의 추가 홉이 생기는 것을 볼 수 있었다. 이번에는 이 두 가지 단점을 해결하는 DSR(Direct Server Return) 방식을 확인한다.
IPIP
노드에서 향하는 트래픽을 IP IN IP 형식으로 IP 헤더 안에 IP 헤더를 포함시킨다. 즉, 터널 간 캡슐화를 진행한다. 캡슐화된 패킷은 해당 파드를 호스팅하는 노드로 라우팅되고, Cilium은 터널을 종료하고 외부 헤더를 제거한 후 DNAT를 수행하여 외부 목적지 주소로 식별된 백엔드 파드에 내부 패킷을 전달한다. 다만, Cilium VXLAN 통신에서는 사용할 수 없으며 네이티브 라우팅 환경에서만 사용이 가능하다.
IP Option
클라이언트가 접속했던 최초 진입 노드의 IP, 포트 정보가 IP Option 형태로 저장되어 추가된다. 다만 해당 기능을 사용하려면 네이티브 라우팅을 사용해야 하며 캡슐화 모드에서는 사용할 수 없다.
Geneve
클라이언트가 최초 진입하는 노드의 IP/포트를 Cilium IP Option을 추가하여 처리하면, 일부 데이터 센터 라우터는 IP 옵션을 알 수 없는 패킷을 Layer 2 Slow Path라는 소프트웨어 처리 단계로 전달한다. 또한 IP 옵션이 포함된 패킷의 양이 특정 임계값을 초과하면 해당 패킷을 버리는데, 이는 네트워크 성능에 영향을 미칠 수 있다. Cilium은 이러한 문제를 방지하기 위해 Geneve를 사용한 모드를 제공한다. 이는 라우팅 모드가 네이티브 모드인지 캡슐화 모드인지와 상관없다.
이번 실습에서는 IP Option을 사용해서 DSR 모드를 실습해보는 것으로 진행한다. 클러스터 설치부터 DSR 모드로 설정한다.
# 기존 클러스터 삭제
kind delete cluster -n cilium-lab

# 클러스터 설치 (without kube-proxy)
kind create cluster --config ./kind/kind-cilium.yaml

# DSR 모드 및 ip option DSR 모드로 cilium 설치
helm install cilium cilium/cilium --version 1.19.5 \
  --namespace kube-system \
  --set kubeProxyReplacement=true \
  --set k8sServiceHost=cilium-lab-control-plane \
  --set k8sServicePort=6443 \
  --set routingMode=native \
  --set autoDirectNodeRoutes=true \
  --set ipv4NativeRoutingCIDR=10.244.0.0/16 \
  --set loadBalancer.mode=dsr \
  --set loadBalancer.dsrDispatch=opt \
  --set bpf.masquerade=true

# cilium 설치 대기
cilium status --wait

# netshoot 디플로이먼트 파드 설치 및 노드포트 추가
kubectl create deployment netshoot --image=nicolaka/netshoot -- sleep 3600
kubectl scale deployment netshoot --replicas=2
kubectl expose deployment netshoot --type=NodePort --port=80 --name=netshoot-np

# 양쪽에 웹서버 띄우기
for p in $(kubectl get pod -l app=netshoot -o jsonpath='{.items[*].metadata.name}'); do
  kubectl exec $p -- sh -c "nohup python3 -m http.server 80 >/dev/null 2>&1 &"
done
sleep 2

# nodeport 서비스 포트 확인
kubectl get svc

# DSR 설치 확인
kubectl -n kube-system exec ds/cilium -- cilium status --verbose | grep -iA 12 "KubeProxyReplacement Details"
KubeProxyReplacement Details:
  Status:                True
  Socket LB:             Enabled
  Socket LB Tracing:     Enabled
  Socket LB Coverage:    Full
  Devices:               eth0    172.18.0.4 fc00:f853:ccd:e793::4 fe80::741a:1fff:fedc:4d08 (Direct Routing)
  Mode:                  DSR
    DSR Dispatch Mode:   IP Option/Extension
  Backend Selection:     Random
  Session Affinity:      Enabled
  NAT46/64 Support:      Disabled
  XDP Acceleration:      Disabled
  Services:
DSR 모드로 IP Option을 사용하는 것으로 클러스터 설치가 되었다는 것을 확인할 수 있다. 이제 앞서와 마찬가지로 cilium-lab-worker2에서 tcpdump로 외부 클라이언트로부터 요청한 패킷을 캡처한다.
cilium-lab-worker(172.18.0.3)
cilium-lab-worker2(172.18.0.4)
ext-client(172.18.0.5)
# ext-client(외부 클라이언트)가 cilium-lab-worker 노드에 요청
docker exec ext-client bash -c "nc -zv 172.18.0.3 32619"

# tcpdump 설치
docker exec cilium-lab-worker2 bash -c "apt update && apt install tcpdump -y"

# worker2에 감지된 패킷 캡처
docker exec cilium-lab-worker2 tcpdump -i any -n -v "tcp port 80 or tcp port 32619"

# 결과
tcpdump: data link type LINUX_SLL2
tcpdump: listening on any, link-type LINUX_SLL2 (Linux cooked v2), snapshot length 262144 bytes
14:53:31.872585 eth0  In  IP (tos 0x0, ttl 63, id 35763, offset 0, flags [DF], proto TCP (6), length 68, options (unknown 154))
    172.18.0.5.46726 > 10.0.0.7.80: Flags [S], cksum 0xb64c (incorrect -> 0x8887), seq 3961816526, win 65495, options [mss 65495,sackOK,TS val 4223527638 ecr 0,nop,wscale 7], length 0
14:53:31.872848 lxcad54fbc1e6bb In  IP (tos 0x0, ttl 64, id 0, offset 0, flags [DF], proto TCP (6), length 60)
    10.0.0.7.80 > 172.18.0.5.46726: Flags [S.], cksum 0xb64c (incorrect -> 0xdfea), seq 3447068812, ack 3961816527, win 65468, options [mss 65480,sackOK,TS val 1535338287 ecr 4223527638,nop,wscale 7], length 0
14:53:31.873011 eth0  Out IP (tos 0x0, ttl 63, id 0, offset 0, flags [DF], proto TCP (6), length 60)
    172.18.0.3.32619 > 172.18.0.5.46726: Flags [S.], cksum 0x585b (incorrect -> 0xbec0), seq 3447068812, ack 3961816527, win 65468, options [mss 65480,sackOK,TS val 1535338287 ecr 4223527638,nop,wscale 7], length 0
위처럼 패킷 덤프를 뜰 수 있다. 하나하나 곱씹어 본다.
14:53:31.872585 eth0  In  IP (tos 0x0, ttl 63, id 35763, offset 0, flags [DF], proto TCP (6), length 68, options (unknown 154))
    172.18.0.5.46726 > 10.0.0.7.80: Flags [S], cksum 0xb64c (incorrect -> 0x8887), seq 3961816526, win 65495, options [mss 65495,sackOK,TS val 4223527638 ecr 0,nop,wscale 7], length 0
14:53:31.872848 lxcad54fbc1e6bb In  IP (tos 0x0, ttl 64, id 0, offset 0, flags [DF], proto TCP (6), length 60)
외부 클라이언트(172.18.0.5)의 SYN 패킷이 worker2 백엔드로 이미 DNAT된 채, IP Option(type 154, length 68)을 달고 도착했다. 이때 SNAT과 달리 외부 클라이언트의 소스가 유지된다.
14:53:31.872848 lxcad54fbc1e6bb In  IP (tos 0x0, ttl 64, id 0, offset 0, flags [DF], proto TCP (6), length 60)
    10.0.0.7.80 > 172.18.0.5.46726: Flags [S.], cksum 0xb64c (incorrect -> 0xdfea), seq 3447068812, ack 3961816527, win 65468, options [mss 65480,sackOK,TS val 1535338287 ecr 4223527638,nop,wscale 7], length 0
14:53:31.873011 eth0  Out IP (tos 0x0, ttl 63, id 0, offset 0, flags [DF], proto TCP (6), length 60)
백엔드가 SYN-ACK를 응답한다. 소스 IP는 백엔드(10.0.0.7)이고 목적지는 클라이언트(172.18.0.5)이다. 여기까지는 소스가 백엔드 파드 IP로 되어 있다.
14:53:31.873011 eth0  Out IP (tos 0x0, ttl 63, id 0, offset 0, flags [DF], proto TCP (6), length 60)
    172.18.0.3.32619 > 172.18.0.5.46726: Flags [S.], cksum 0x585b (incorrect -> 0xbec0), seq 3447068812, ack 3961816527, win 65468, options [mss 65480,sackOK,TS val 1535338287 ecr 4223527638,nop,wscale 7], length 0
여기서 소스 IP가 cilium-lab-worker로 변경되어서 클라이언트에게 전달된 것을 확인할 수 있다. worker에서 worker2로 패킷을 전달할 때 IP Option에 원래 노드 IP(172.18.0.3.32619)를 추출해서 NAT 엔트리에 저장했고, 이를 백엔드 응답이 나갈 때 eth0(Out) 인터페이스에서 소스를 복원한다.
관측 가능성 (Hubble)
지금까지는 패킷이 왜 DROP되었는지, 왜 이 노드에서 DROP됐는지, 이 패킷의 Identity는 무엇이고 어떤 Identity를 향해 가는지 등을 monitor, bpf 명령어 또는 맵 등을 통해서 확인해왔다. 하지만 이때마다 명령어를 호출하고 조건을 걸고 다른 맵을 살펴보는 것은 운영 환경에서는 불리하게 작용한다. Cilium은 Hubble을 통해 앞서 말한 문제점을 해결하고 관찰 가능성을 제공한다. 즉, Hubble은 Identity·서비스·정책 판정이 붙은 구조화된 플로우로 보여준다.
Hubble의 구성 요소
Hubble Server: 각 cilium 에이전트에 내장되어 있다. eBPF 이벤트를 관측 데이터로 변환한다.
Hubble Relay: 여러 노드의 Hubble Server를 모아 클러스터 전역 뷰를 제공한다.
# hubble relay를 로컬 포트로 포워드
kubectl -n kube-system port-forward hubble-relay-785f7df-fst9d 4245:4245 &

# CLI가 해당 포트로 접속 및 마지막 10건 수집
hubble observe --server localhost:4245 --last 10

Aug  3 14:04:11.925: 10.0.2.178:51188 (host) -> kube-system/hubble-ui-6bb97d8894-zlsmx:8081 (ID:24960) to-endpoint FORWARDED (TCP Flags: ACK, FIN)
Aug  3 14:04:12.605: 172.18.0.4:53516 (remote-node)  172.18.0.4:4240 (remote-node) to-network FORWARDED (TCP Flags: ACK)
hubble observe 명령어를 통해 트래픽 플로우를 확인할 수 있다. 내용을 자세히 살펴보면 (host)와 (ID:24960)이 양쪽의 Identity다. host(예약 Identity)에서 hubble-ui 파드로 가는 것을 볼 수 있다. to-endpoint는 datapath의 어느 지점인지를 나타낸다. 이는 파드로 배달되는 단계이다. FORWARDED는 정책 판정(허용)이다. DROP이면 DROPPED로 뜨게 된다.
to-endpoint: 파드로 전달
to-stack: 호스트 커널 스택으로 전달
to-network: 노드 밖 네트워크로 전달
정책 기반 관찰
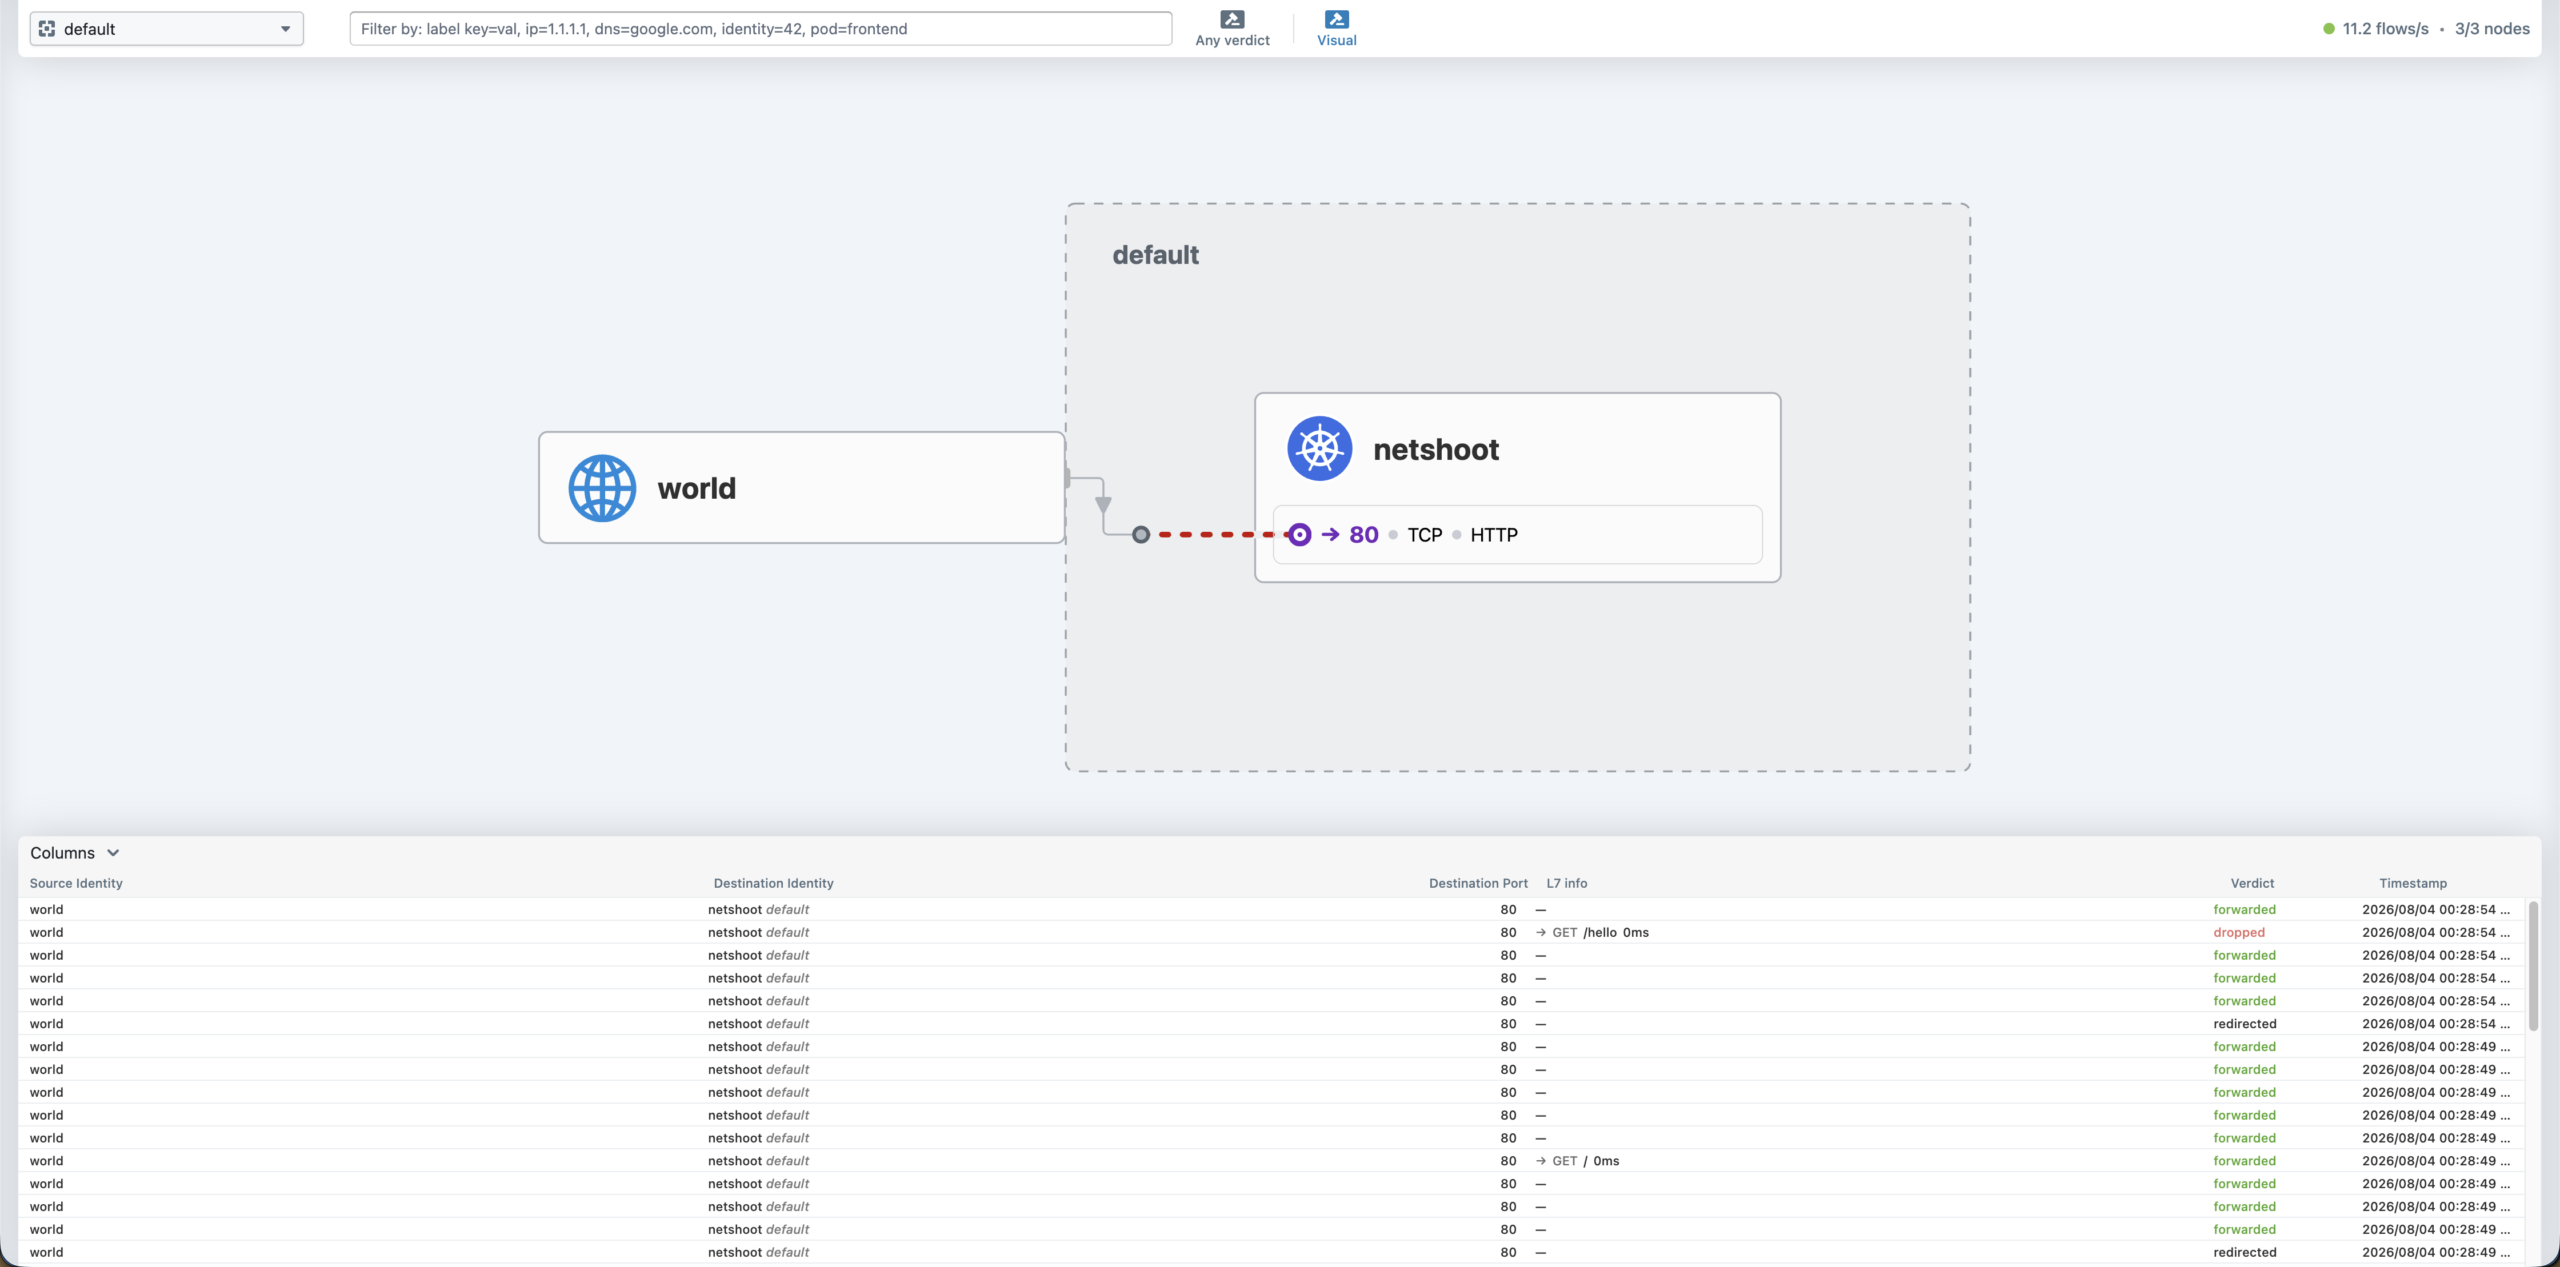
다음으로는 정책을 추가하여 관측을 진행한다. 이전에 배포해둔 외부 클라이언트 ext-client(172.18.0.5)가 존재한다고 가정한다.
위처럼 클러스터 내부 노드가 아닌 외부 클라이언트의 연결은 정책에서 DROP된 것을 확인할 수 있다.
L7 기반 정책 적용
eBPF는 커널에서 패킷 헤더(L3/L4)를 본다. 그런데 HTTP 메서드/경로/상태 코드는 TCP 스트림을 재조립해서 파싱해야 알 수 있다. 그렇기에 커널/eBPF에서 처리하기에는 어렵다. 그렇기에 cilium은 L7 트래픽 제어가 필요하면 트래픽을 Envoy 프록시로 우회시킨다. Envoy가 HTTP를 파싱하고 결과를 Hubble L7 flow에 넘긴다.
if (lb4_svc_is_l7_loadbalancer(svc)) {
    ...
    return 0;   /* Let the TC level eBPF datapath redirect to L7 LB. */
}
cilium clustermesh connect --context kind-cluster1 --destination-context kind-cluster2

Error: Unable to connect cluster: Cilium CA certificates do not match between clusters cluster1 and cluster2. Use --allow-mismatching-ca to allow this by adding remote CAs to the CA bundle
clustermesh로 서로 다른 클러스터를 연결하려면 CA를 공유해야 한다. 공유하기 위한 방법으로 아래 2가지가 존재한다.
공유 CA - 서로 다른 클러스터가 같은 CA를 사용한다.
--allow-mismatching-ca 옵션을 사용하여 각각 CA를 유지하면서 상대방 CA를 신뢰 목록에 추가한다.
kind-cluster2에서 CA를 지우고 kind-cluster1에서 복제한 CA로 덮어쓴다. 클러스터 간 CA 값이 동일한지 아래 명령어로 확인한 뒤, 다시 clustermesh로 클러스터 간 연결을 진행한다.
# 양쪽 CA 인증서 지문 비교
echo "=== cluster1 CA ==="
kubectl --context kind-cluster1 -n kube-system get secret cilium-ca -o jsonpath='{.data.ca\.crt}' | base64 -d | openssl x509 -noout -fingerprint -sha256
echo "=== cluster2 CA ==="
kubectl --context kind-cluster2 -n kube-system get secret cilium-ca -o jsonpath='{.data.ca\.crt}' | base64 -d | openssl x509 -noout -fingerprint -sha256
cilium clustermesh connect --context kind-cluster1 --destination-context kind-cluster2

ℹ️  Found ClusterMesh service IPs: [172.18.0.5]
ℹ️ Configuring Cilium in cluster kind-cluster1 to connect to cluster kind-cluster2
ℹ️ Configuring Cilium in cluster kind-cluster2 to connect to cluster kind-cluster1
✅ Connected cluster kind-cluster1  kind-cluster2!
kind-cluster1의 ipcache에서 kind-cluster2의 파드 IP 목록이 보이는 것을 확인할 수 있다. 추가적으로 remotecluster는 remote-node로, 노드가 원격 클러스터에 속한다는 뜻이다. 그리고 hastunnel + tunnelendpoint는 "저 노드로 VXLAN으로 캡슐화해서 전송하라"는 뜻이다.
통신 확인
연결된 클러스터에 각각 백엔드를 배포하고, 외부 클라이언트에서 nc 명령어로 통신 및 장애 테스트(failover)를 진행한다.
kubectl --context kind-cluster1 create deployment netshoot --image=nicolaka/netshoot -- sleep infinity
kubectl --context kind-cluster1 rollout status deployment/netshoot

# cluster2
kubectl --context kind-cluster2 create deployment netshoot --image=nicolaka/netshoot -- sleep infinity
kubectl --context kind-cluster2 rollout status deployment/netshoot

# IP 확인
kubectl --context kind-cluster1 get pod -l app=netshoot -o wide
kubectl --context kind-cluster2 get pod -l app=netshoot -o wide
kind-cluster1: 10.1.1.104
kind-cluster2: 10.2.1.103
배포된 파드에 대해 우선 클러스터 간 통신을 진행한다.
kubectl --context kind-cluster1 exec  netshoot-57fdfc7498-xkhh9 -- ping -c 3 10.2.1.103

PING 10.2.1.103 (10.2.1.103) 56(84) bytes of data.
64 bytes from 10.2.1.103: icmp_seq=1 ttl=63 time=0.738 ms
64 bytes from 10.2.1.103: icmp_seq=2 ttl=63 time=0.212 ms
kind-cluster1에서 kind-cluster2로 정상적인 통신을 확인했다. 이제 서비스를 배포하고 외부 클라이언트로의 통신을 확인한다.
# 양쪽에 웹서버 띄우기
for ctx in kind-cluster1 kind-cluster2; do
  for p in $(kubectl --context $ctx get pod -l app=netshoot -o jsonpath='{.items[*].metadata.name}'); do
    kubectl --context $ctx exec $p -- sh -c "nohup python3 -m http.server 80 >/dev/null 2>&1 &" 2>/dev/null
  done
done
sleep 2

# 양쪽에 같은 이름의 서비스 + global annotation
for ctx in kind-cluster1 kind-cluster2; do
  kubectl --context $ctx expose deployment netshoot --port=80 --type=NodePort --name=global-svc
  kubectl --context $ctx annotate service global-svc service.cilium.io/global="true"
done
먼저 웹서버 백엔드를 python3으로 실행한다. 그리고 양쪽에 같은 이름의 서비스를 배포하기 위해서는 service.cilium.io/global="true"라는 Annotation을 붙인다. 이 Annotation을 붙이면 cilium이 해당 서비스를 클러스터 전역 서비스로 인식한다. 즉 다른 클러스터의 같은 이름을 가진 서비스 백엔드를 자신의 LB 맵에 합친다.
kubectl --context kind-cluster1 get svc
kubectl --context kind-cluster2 get svc

# kind-cluster1의 서비스
NAME         TYPE        CLUSTER-IP      EXTERNAL-IP   PORT(S)
global-svc   NodePort    10.12.106.229           80:32498/TCP

# kind-cluster2의 서비스
NAME         TYPE        CLUSTER-IP     EXTERNAL-IP   PORT(S)
global-svc   NodePort    10.12.254.36           80:31935/TCP
그리고 노드 IP를 확인하면 kind-cluster1은 172.18.0.3, kind-cluster2의 경우 172.18.0.7이다. 외부 클라이언트에서 kind-cluster1의 노드포트로 요청을 전송한다.
docker exec ext-client nc -zv 172.18.0.3 32498
그리고 kind-cluster2에서 cilium monitor로 관련된 백엔드 endpoint를 모니터링한다.
kubectl --context kind-cluster2 exec -n kube-system cilium-pdvgw -- cilium monitor --related-to 230

-> endpoint 230 flow 0x64c148f2 , identity world->136352 state new ifindex lxcebea5111109e orig-ip 10.1.1.31: 10.1.1.31:45596 -> 10.2.1.103:80 tcp SYN
-> overlay flow 0x20c3614 , identity 136352->remote-node state reply ifindex cilium_vxlan orig-ip 0.0.0.0: 10.2.1.103:80 -> 10.1.1.31:45596 tcp SYN, ACK
-> endpoint 230 flow 0x64c148f2 , identity world->136352 state established ifindex lxcebea5111109e orig-ip 10.1.1.31: 10.1.1.31:45596 -> 10.2.1.103:80 tcp ACK
-> endpoint 230 flow 0x64c148f2 , identity world->136352 state established ifindex lxcebea5111109e orig-ip 10.1.1.31: 10.1.1.31:45596 -> 10.2.1.103:80 tcp ACK, FIN
-> overlay flow 0x20c3614 , identity 136352->remote-node state reply ifindex cilium_vxlan orig-ip 0.0.0.0: 10.2.1.103:80 -> 10.1.1.31:45596 tcp ACK, FIN
-> endpoint 230 flow 0x64c148f2 , identity world->136352 state established ifindex lxcebea5111109e orig-ip 10.1.1.31: 10.1.1.31:45596 -> 10.2.1.103:80 tcp ACK
정상적으로 외부 클라이언트는 kind-cluster2로 TCP 패킷을 전송했지만, kind-cluster2가 최종적으로 트래픽을 전달받아 응답한 것을 볼 수 있다.
kubectl --context kind-cluster1 exec -n kube-system ds/cilium -- cilium service list

ID   Frontend                Service Type   Backend
11   0.0.0.0:32498/TCP       NodePort       1 => 10.1.1.104:80/TCP (active)
                                            2 => 10.2.1.103:80/TCP (active)
13   10.12.106.229:80/TCP    ClusterIP      1 => 10.1.1.104:80/TCP (active)
                                            2 => 10.2.1.103:80/TCP (active)
kind-cluster1에서 cilium service list를 실행했을 때, 백엔드 맵에 각 클러스터에 배포된 백엔드 IP가 담겨 있는 것을 알 수 있다.
장애 테스트
kind-cluster1에 배포된 netshoot deployment의 replicas를 0으로 설정한 후 다시 패킷을 전송한다.
Connection to 172.18.0.3 32498 port [tcp/*] succeeded! 정상적으로 통신이 되는 것을 확인할 수 있다.
kubectl --context kind-cluster1 exec -n kube-system ds/cilium -- cilium service list

ID   Frontend                Service Type   Backend
11   0.0.0.0:32498/TCP       NodePort       1 => 10.2.1.103:80/TCP (active)
13   10.12.106.229:80/TCP    ClusterIP      1 => 10.2.1.103:80/TCP (active)
또한 서비스 맵에서 kind-cluster1에 배포된 백엔드 IP가 제거된 것을 볼 수 있다.
Affinity
추가적으로 로컬/원격 선호도를 Annotation으로 제어할 수 있다. 크로스클러스터의 경우 장애 발생 시 failover할 수 있는 장점이 있지만, 그만큼 네트워크 비용과 높은 레이턴시가 발생할 수 있다. 그렇기에 아래 Annotation으로 특정 상황에서만 크로스클러스터에 배포된 백엔드로 트래픽을 전달할 수 있다.
service.cilium.io/affinity: "local"    # 로컬 백엔드 우선, 없으면 원격
service.cilium.io/affinity: "remote"   # 원격 우선
service.cilium.io/affinity: "none"     # 구분 없이 균등 (기본)
kubectl --context kind-cluster1 annotate service global-svc service.cilium.io/affinity=local --overwrite
여기까지가 cilium clustermesh를 활용한 기본적인 고가용성 멀티클러스터 구축 방법이다. 고가용성뿐만 아니라 공유 서비스, 상태 저장 서비스와 상태 비저장 서비스의 분리 등 여러 방면에서 활용할 수 있다. 특히 공유 서비스의 경우, 각 클러스터 A, B, C끼리는 물리적 경계를 두고 A, B, C 클러스터가 공유하는 클러스터에만 연결을 맺는 방식이다. 이 공유 클러스터는 DNS 쿼리, 로깅 등 공통된 서비스만 모아서 처리할 수 있다.
이 글에서는 이전 시리즈에 이어 외부 클라이언트의 트래픽을 처리하는 North-South 통신(SNAT vs DSR)을 살펴보고, Cilium Hubble로 관측 가능성을 확인했으며, 멀티클러스터 통신 구축까지 다뤄보았다. Cilium은 iptables 같은 기존 레거시 구조에서 벗어나 eBPF를 이용해 다양한 시도를 이어가고 있는 오픈소스다. 그중에는 XDP를 이용해 로드밸런서까지 구축할 수 있을 만큼 강력하면서도 자유로운 확장성을 가진 영역도 있다.