테스트 데이터를 걷어내고 실제 서비스 성과 분석하기
게임 개발과 검증 과정에서 발생하는 QA 서버·테스트 앱의 이벤트가 섞이면 이용자 수, 매출, 구매 전환율 같은 핵심 KPI가 실제와 다르게 나타날 수 있다. Hive 애널리틱스의 지표 필터 관리에서 서버 ID 또는 앱 ID를 한 번 등록하면 해당 조건의 이벤트가 차트·퍼널·리텐션·대시보드에서 한꺼번에 제외된다. 여러 QA 서버나 테스트 앱을 운영하더라도 반복 설정 없이 실제 서비스 데이터를 기준으로 KPI를 분석할 수 있다.
테스트 환경 데이터가 섞인 분석 결과
게임을 개발하고 검증하는 과정에서는 QA 서버와 테스트 앱에서도 로그인, 구매, 콘텐츠 이용 등의 이벤트가 반복해서 발생한다. 이 기록이 실제 서비스 데이터와 함께 계산되면 이용자 수와 매출, 구매 전환율 같은 핵심 KPI가 달라질 수 있다.
차트마다 서버 ID나 앱 ID를 필터로 지정할 수도 있지만 분석 화면이 많아질수록 같은 조건을 반복해서 설정해야 한다. 새 차트에 조건을 빠뜨리거나 기존 대시보드를 일일이 수정하는 문제도 생길 수 있다.
일관된 기준이 필요한 데이터 분석
데이터 분석 담당자는 실제 서비스 성과를 기준으로 KPI를 산출하고 여러 조직이 활용할 수 있는 대시보드로 시각화해야 한다. 이때 QA 활동이나 테스트 결제가 포함되면 수치 변화가 이용자 반응에서 비롯된 것인지 테스트 과정에서 발생한 것인지 구분하기 어렵다.
특히 출시 전후나 업데이트 검수 기간에는 테스트 기록이 짧은 시간에 집중될 수 있다. 반복 분석의 정확성을 유지하려면 서비스와 테스트 환경을 모든 화면에서 같은 조건으로 분리할 필요가 있다.
Hive 애널리틱스의 지표 필터 관리
Hive 애널리틱스의 지표 필터 관리는 QA 서버 또는 테스트 앱 ID에서 발생한 이벤트 데이터를 지표에서 제외하는 기능이다. 프로젝트 단위로 속성을 선택해 조건을 등록하면 해당 환경의 이벤트가 차트·리텐션·퍼널에서 즉시 제외되며, 운영중인 대시보드에도 같은 기준이 적용된다.
필터 등록 시 속성으로 앱 ID 또는 서버 ID를 선택할 수 있으며, 선택한 속성의 목록에서 원하는 값을 하나 이상 등록할 수 있다. 여러 QA 서버나 테스트 앱을 운영하더라도 관련 값을 한 번에 관리해 분석 화면마다 같은 필터를 반복해서 설정하는 부담을 줄일 수 있다.
필터 목록에서는 제외 중인 프로젝트와 속성, 속성 값을 확인할 수 있다. 조건을 변경해야 할 때는 기존 항목을 삭제한 뒤 다시 등록해야 하며, 필터를 제거하면 해당 서버나 앱에서 발생한 데이터가 수치에 다시 포함될 수 있다.
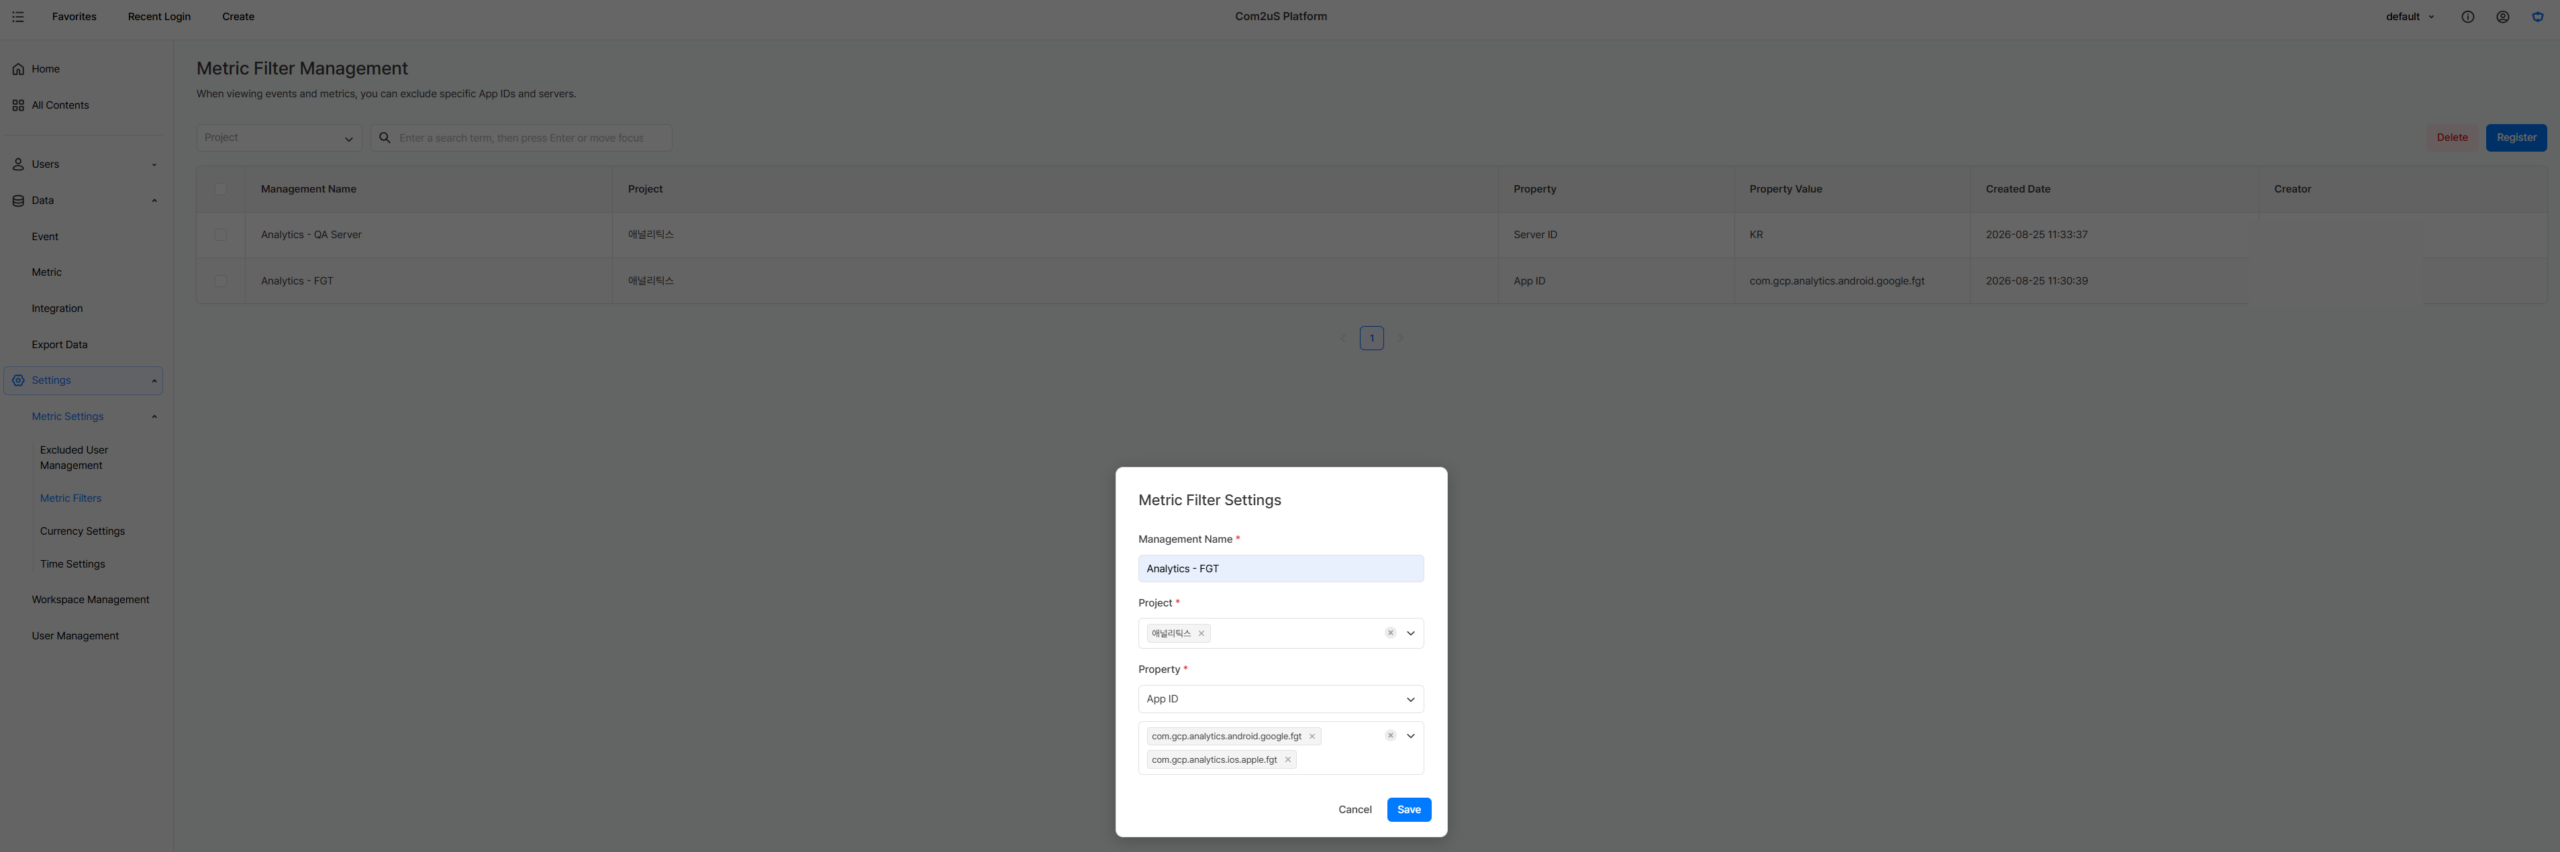
목록에 등록된 QA 서버와 FGT 조건은 모든 차트·리텐션·퍼널·대시보드에 일괄 적용된다.
실제 서비스 데이터 기준으로 KPI 관리해보기
지표 필터를 설정하면 테스트 환경을 분리한 상태에서 핵심 KPI를 분석하고 대시보드로 시각화할 수 있다.
QA 서버를 제외한 이용자 지표 확인
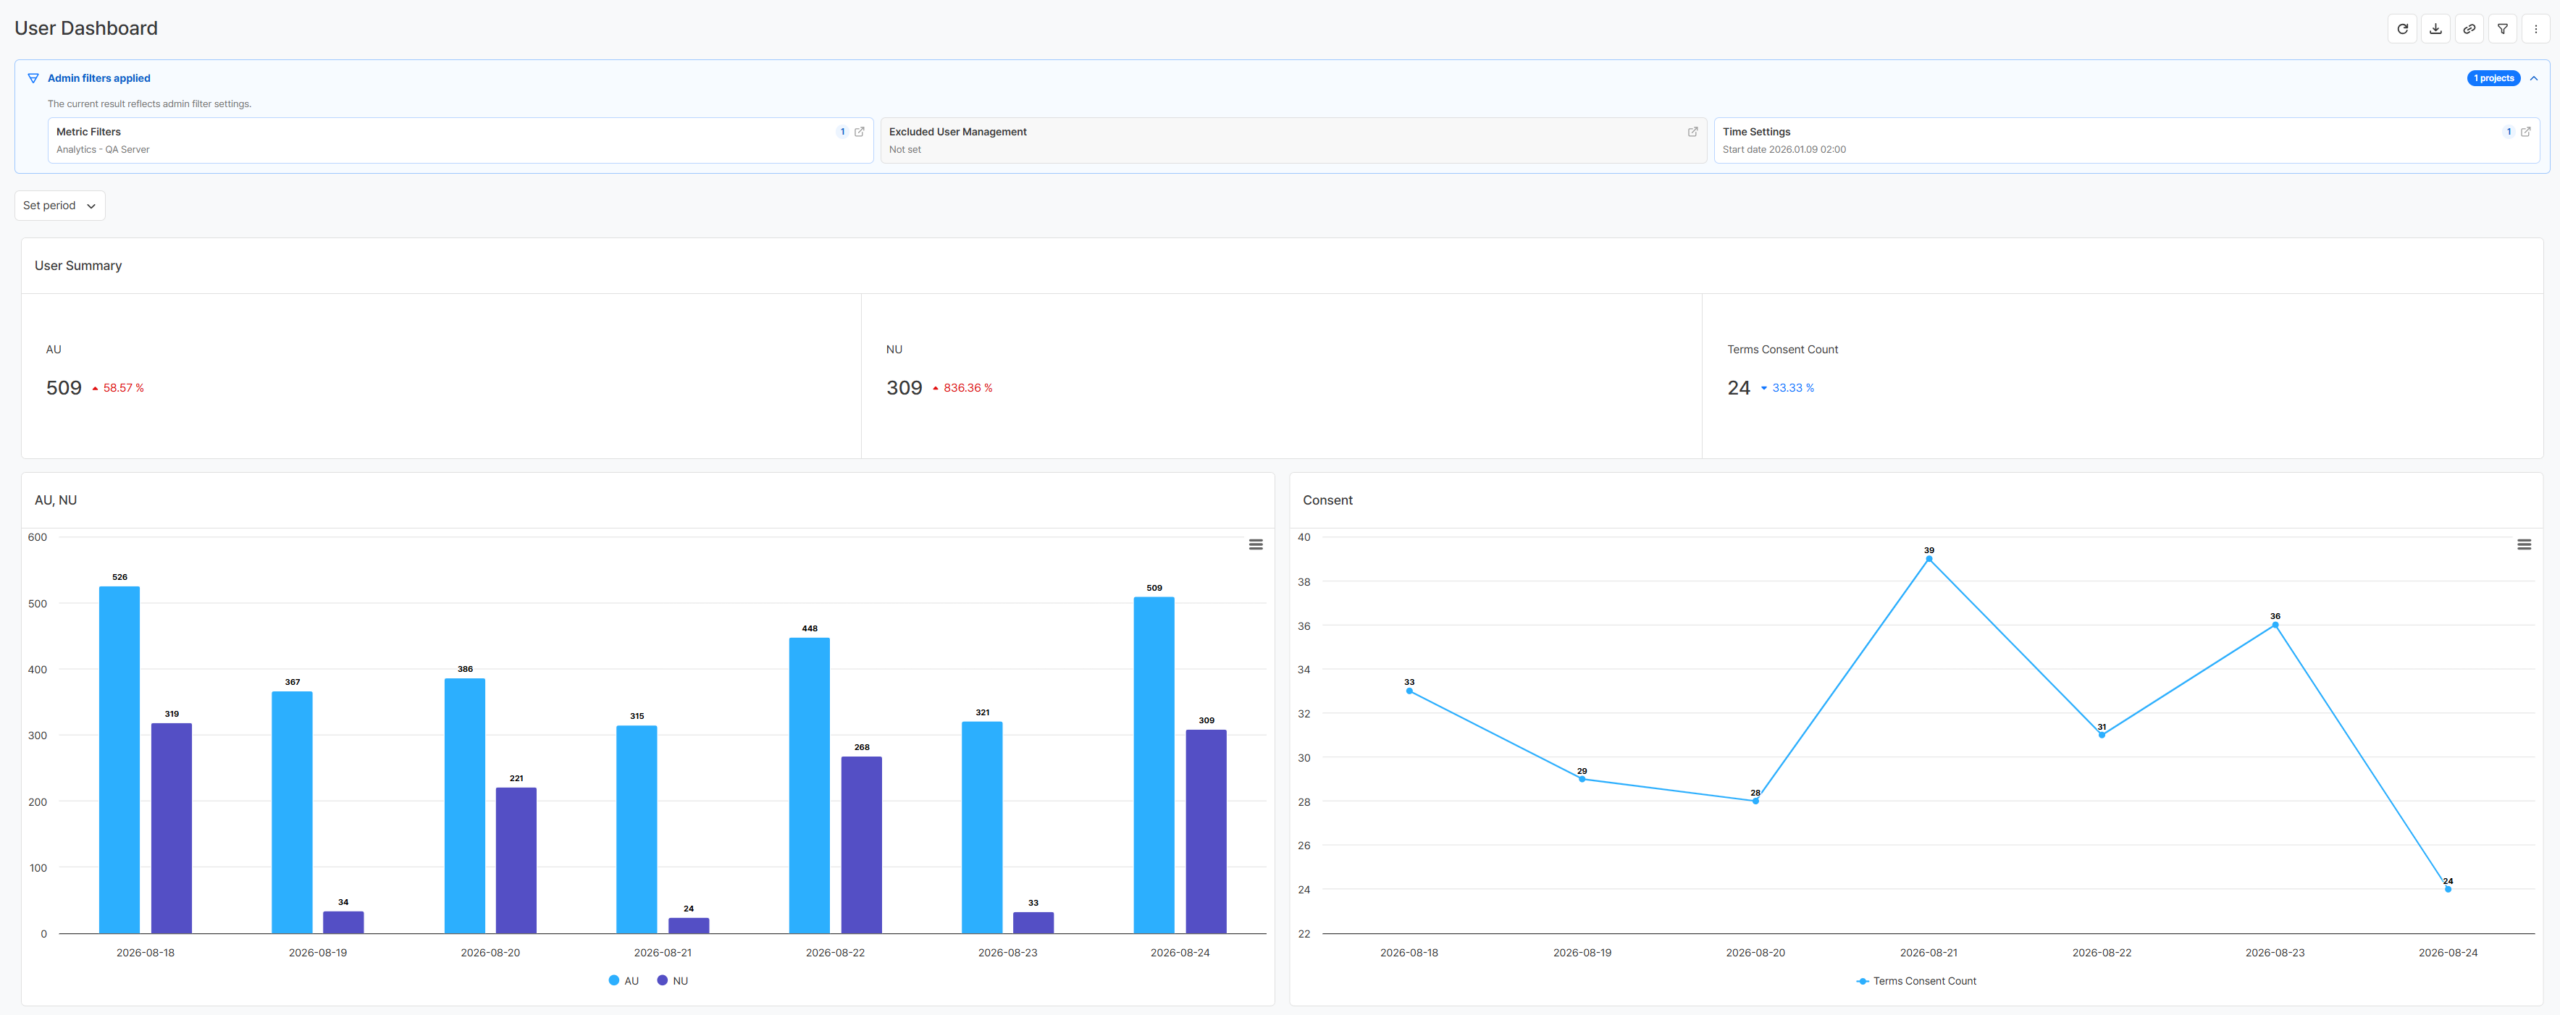
기능 검증을 위해 QA 서버에서 반복적으로 로그인하거나 콘텐츠를 이용하면 활성 사용자(AU)와 콘텐츠 참여 수가 실제보다 높게 나타날 수 있다. 해당 서버 ID를 제외하면 서비스 환경에서 활동한 이용자를 기준으로 변화 추이를 살펴볼 수 있다.
테스트 앱 ID를 제외한 구매 성과 분석
결제 연동이나 상품 검수를 진행하는 테스트 앱에서는 시험 구매가 반복될 수 있다. 앱 ID를 필터로 등록하면 테스트 기록을 분리하고 실제 매출과 구매 이용자 수, 구매 전환율을 중심으로 결과를 분석할 수 있다.
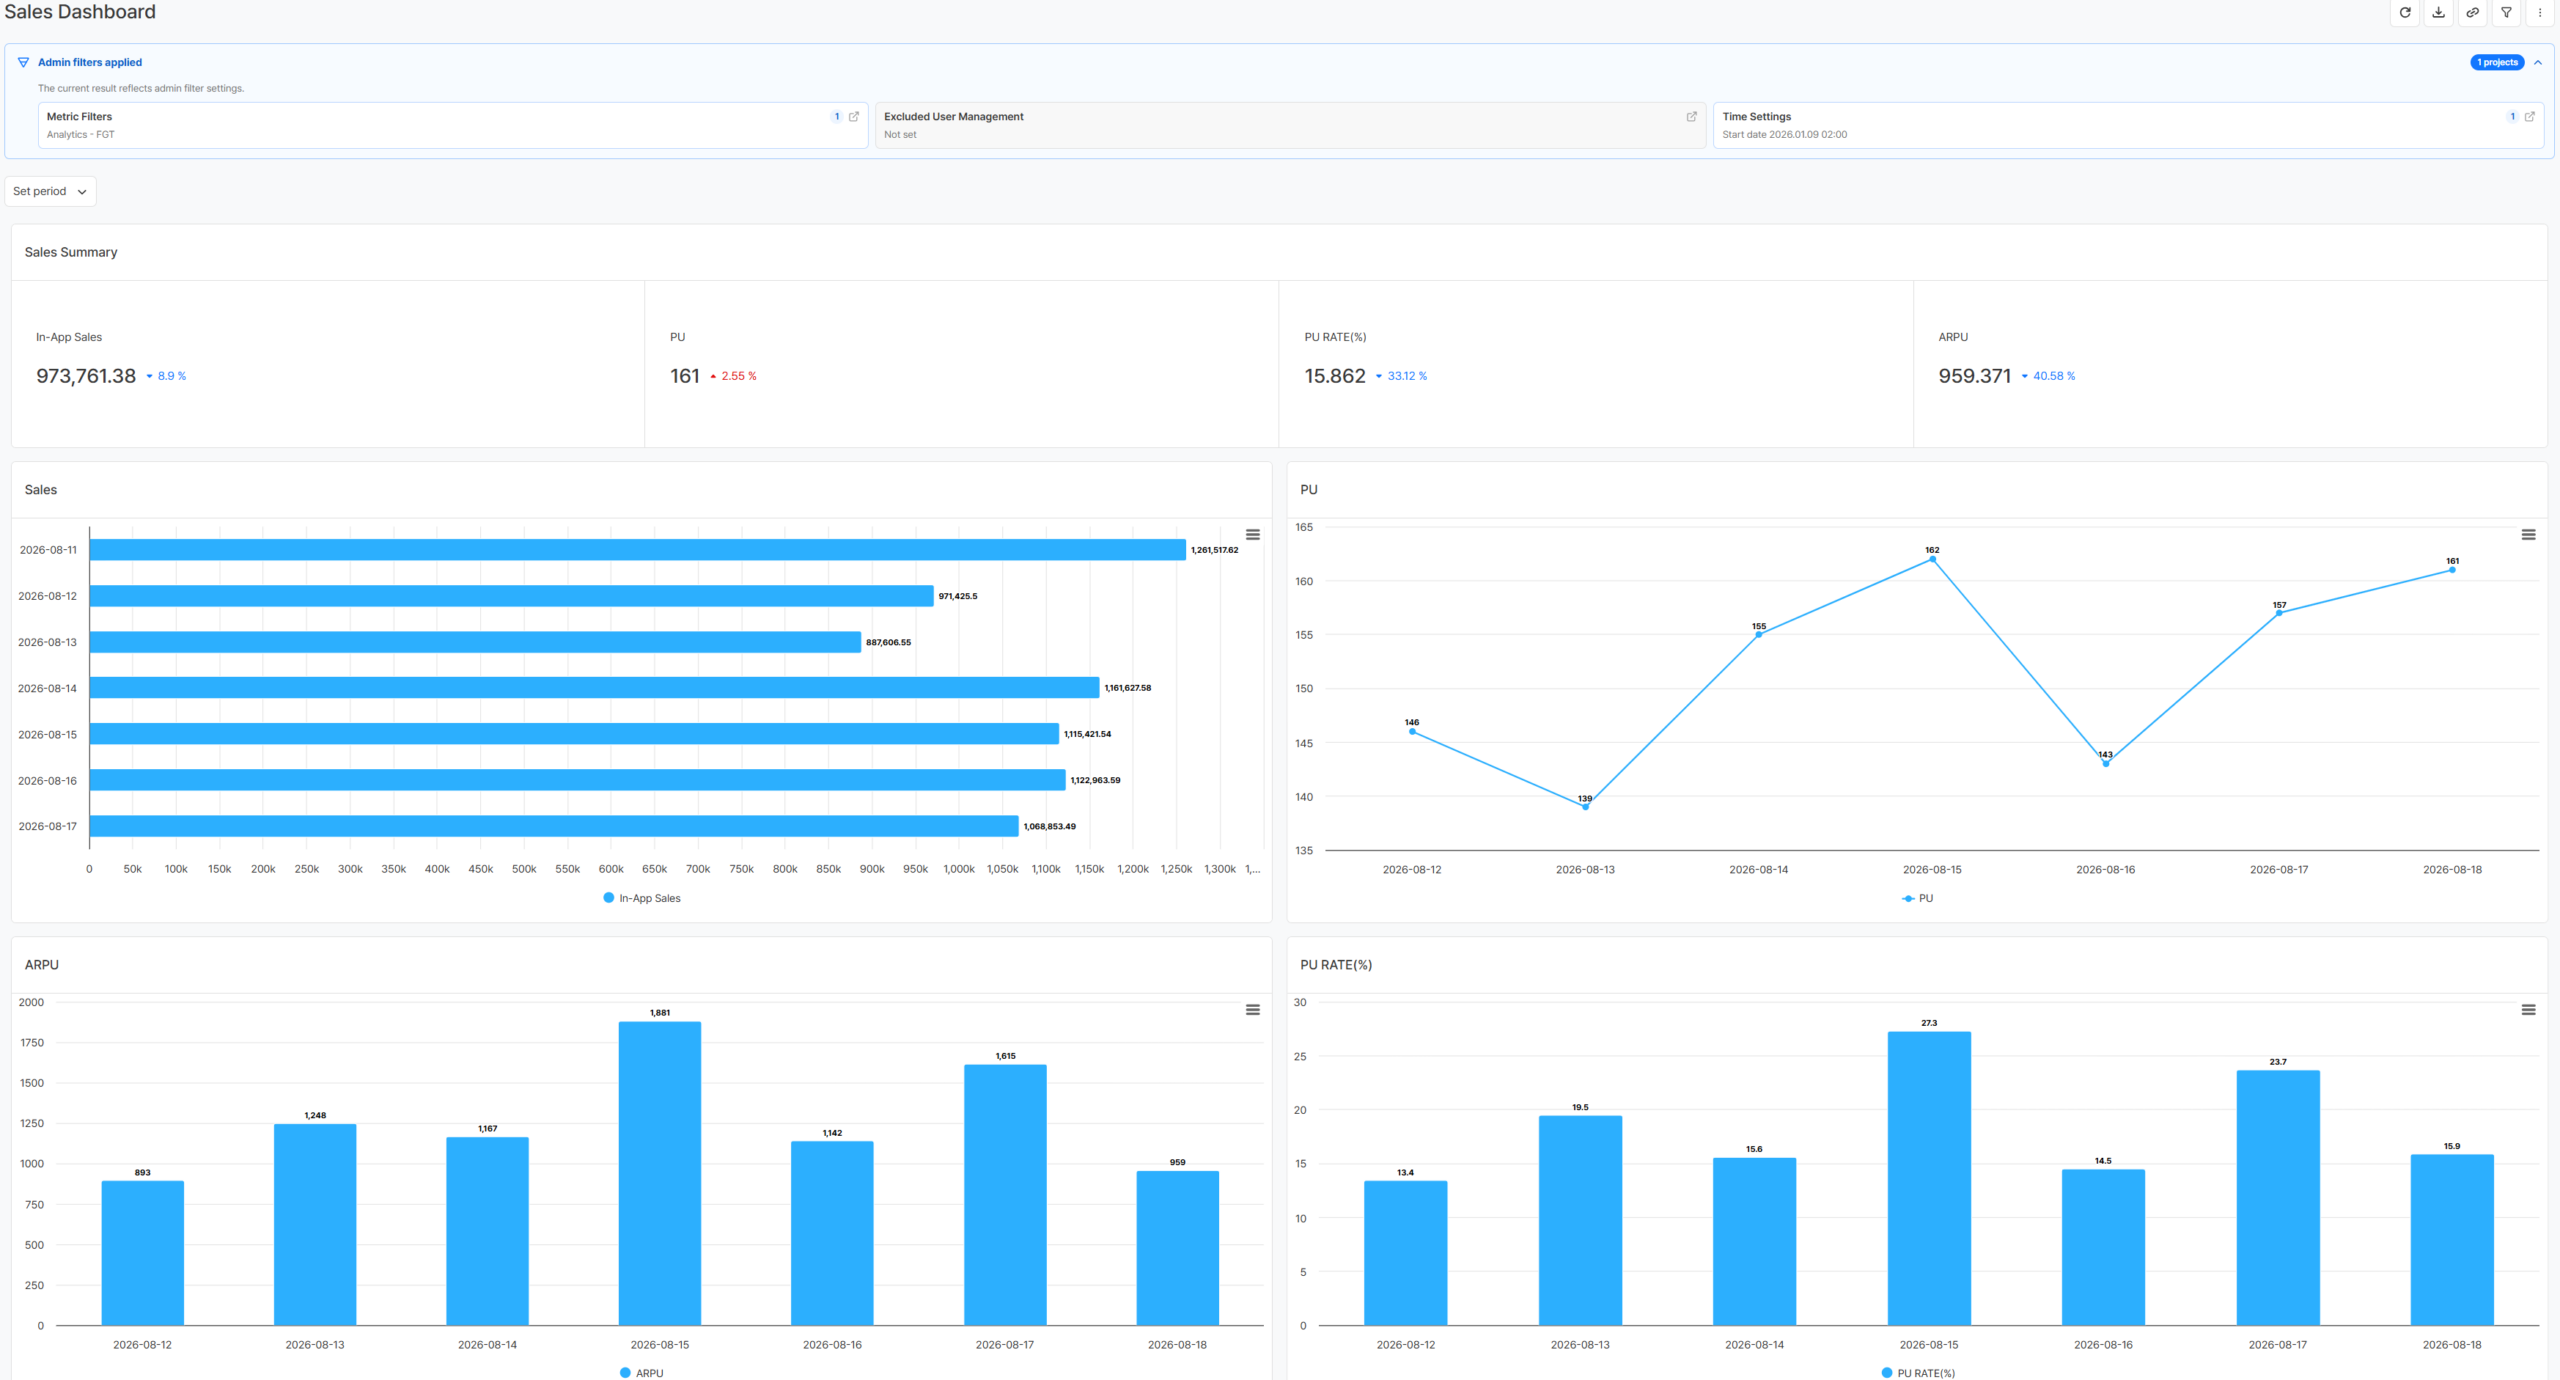
이상 수치의 원인 점검
평소와 다른 수치가 나타났다면 먼저 적용 중인 지표 필터와 서버 ID, 앱 ID 값을 확인할 수 있다. 테스트 환경이 새로 추가됐거나 식별 값이 바뀌었다면 필터를 갱신해 이후 분석에서도 같은 기준을 유지할 수 있다.
Hive 애널리틱스 시작해보기
설정 > 지표 설정 > 지표 필터 관리 메뉴에서 테스트 앱 ID와 QA 서버를 지표 필터로 등록할 수 있다. 목록을 정기적으로 업데이트해 일관된 분석 기준을 유지할 수 있다.
Hive 애널리틱스는 Hive SDK를 통해 게임 데이터를 자동으로 수집하고, 지표 필터로 QA 서버와 테스트 앱 ID에서 발생한 데이터를 제외해 핵심 KPI를 바로 분석할 수 있는 게임 전문 애널리틱스 솔루션이다. 지금 Hive 애널리틱스를 통해 테스트 환경의 데이터를 분리하고, 실제 서비스 데이터를 일관된 기준으로 살펴보자.
콘텐츠 완료 수치만으로는 이용자가 어느 단계에서 이탈했는지 알 수 없다. Hive 애널리틱스의 차트로 콘텐츠 수락·완료 규모와 완료율의 변화를 먼저 확인하고, 변화가 두드러진 시점은 퍼널로 이어서 단계별 전환·이탈 구간을 좁혀볼 수 있다. 이 흐름을 반복하면 기획 의도와 실제 이용 행동의 차이를 구체적인 구간 단위로 파악할 수 있다.
새로운 콘텐츠를 공개하면 참여 이용자 수와 완료 횟수부터 살펴보게 된다. 시작과 완료 수치가 기대와 다를 경우 콘텐츠 구성이나 난이도, 보상 등을 검토할 수 있지만, 두 결과만으로는 이용자가 어느 단계에서 멈췄는지 알기 어렵다.
시작한 이용자는 많지만 특정 구간을 통과하지 못했을 수도 있고, 마지막 단계까지 도달했지만 보상을 받지 않고 이탈했을 수도 있다. 콘텐츠가 의도한 흐름으로 이용되는지 판단하려면 시작과 완료뿐 아니라 중간 과정까지 함께 살펴볼 필요가 있다.
기획 의도와 실제 이용 흐름의 차이
기획 담당자는 콘텐츠의 진입 조건부터 진행 순서, 목표와 보상까지 하나의 경험으로 설계한다. 그러나 실제 이용자는 예상과 다른 순서로 행동하거나 특정 단계에서 반복적으로 이탈할 수 있다.
전체 참여 규모만 보면 콘텐츠에 대한 관심은 파악할 수 있지만, 진행 과정에서 발생한 문제까지 구분하기는 어렵다. 이용자가 콘텐츠를 시작한 뒤 어떤 단계를 거쳐 완료하는지 살펴보면 기획 의도와 실제 행동의 차이를 찾고, 검토가 필요한 구간을 구체화할 수 있다.
Hive 애널리틱스의 콘텐츠 흐름 분석
Hive 애널리틱스에는 게임 콘텐츠의 수락, 대기, 완료, 실패, 취소를 기록할 수 있도록 사전 정의된 이벤트가 제공된다. 정해진 스키마에 맞춰 콘텐츠 이벤트를 전송하면 이벤트 목록에서 확인하고 차트와 퍼널에 바로 활용할 수 있다.
콘텐츠 이벤트만으로 표현하기 어려운 진입, 중간 진행, 보상 획득 등의 행동은 커스텀 이벤트로 자유롭게 정의해 전송할 수 있다. 사전 정의된 이벤트와 커스텀 이벤트를 함께 사용하면 공통 상태는 일관된 기준으로 관리하면서 콘텐츠 구조까지 분석 범위에 포함할 수 있다.
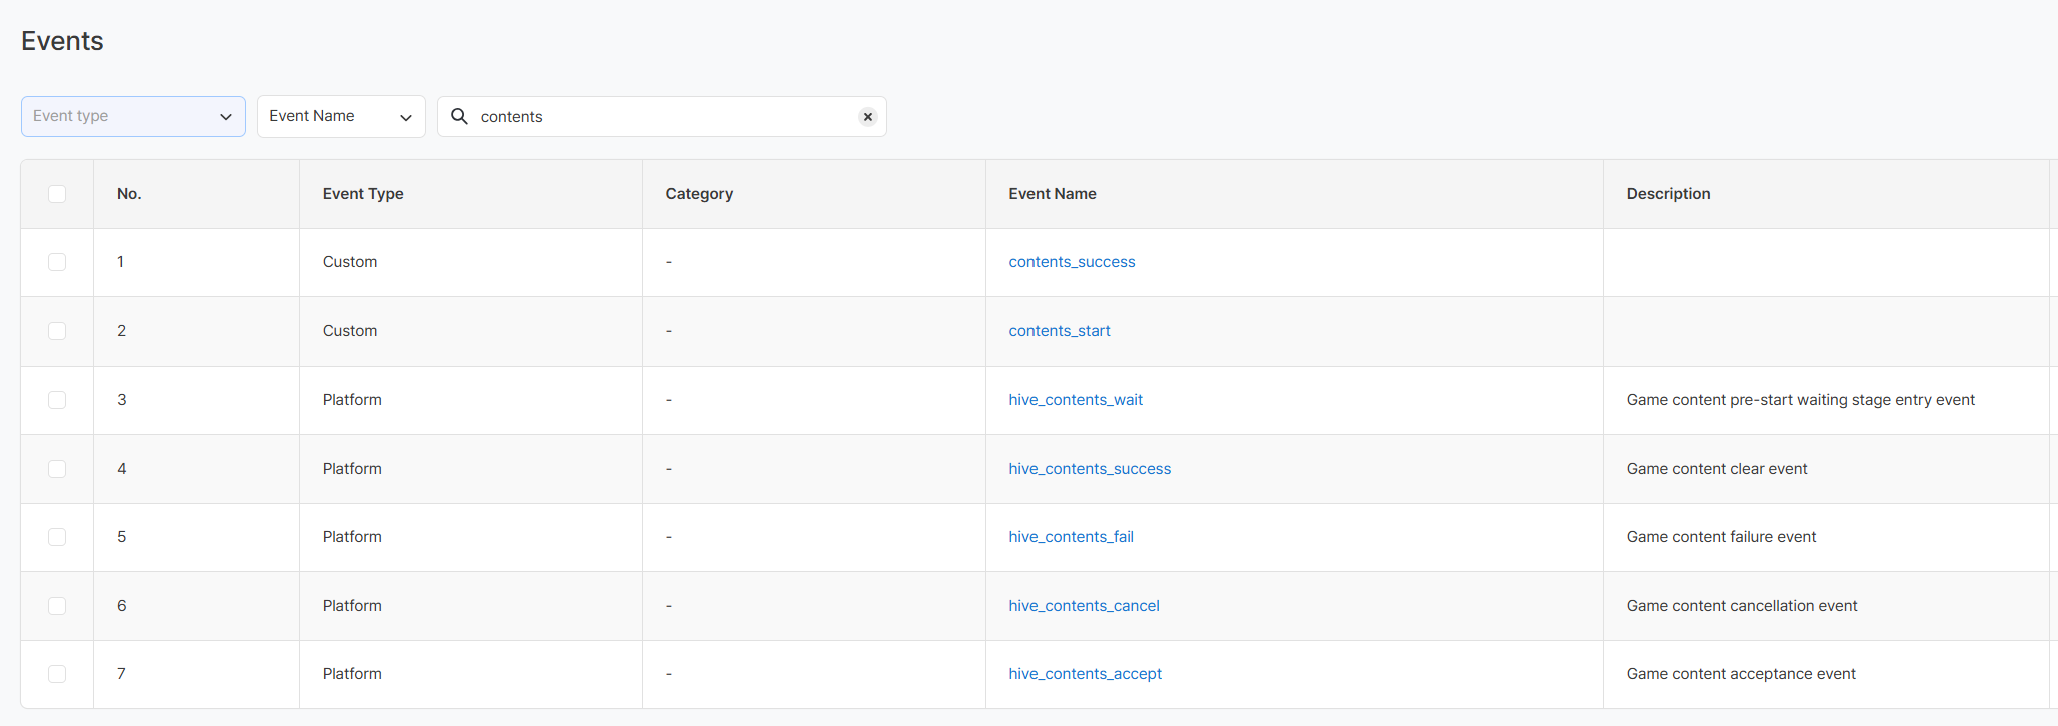
차트에서는 콘텐츠 수락과 완료 이용자 수, 완료율을 함께 구성해 전체 참여 규모와 기간별 변화를 비교하고, 변화가 두드러진 시점은 퍼널로 이어서 살펴볼 수 있다. 콘텐츠 수락, 진입, 시작, 완료와 같은 주요 행동을 순서대로 연결하면 각 단계의 전환과 이탈을 확인할 수 있다.
콘텐츠 단계별 이용 흐름 점검
콘텐츠 흐름은 먼저 차트에서 전체 규모와 결과를 확인한 뒤, 퍼널로 범위를 좁혀 단계별 이탈 구간을 살펴보는 방식으로 분석할 수 있다.
콘텐츠 수락과 완료 규모 비교
콘텐츠 수락 이용자 수와 완료 이용자 수, 수락 대비 완료율을 한 화면에 배치하면 참여 규모와 결과의 변화를 함께 확인할 수 있다. 예시 화면처럼 완료율이 40%대에서 점점 낮아져 20%대로 떨어진 날짜가 나타난다면 해당 시점을 상세 분석 대상으로 선택할 수 있다.
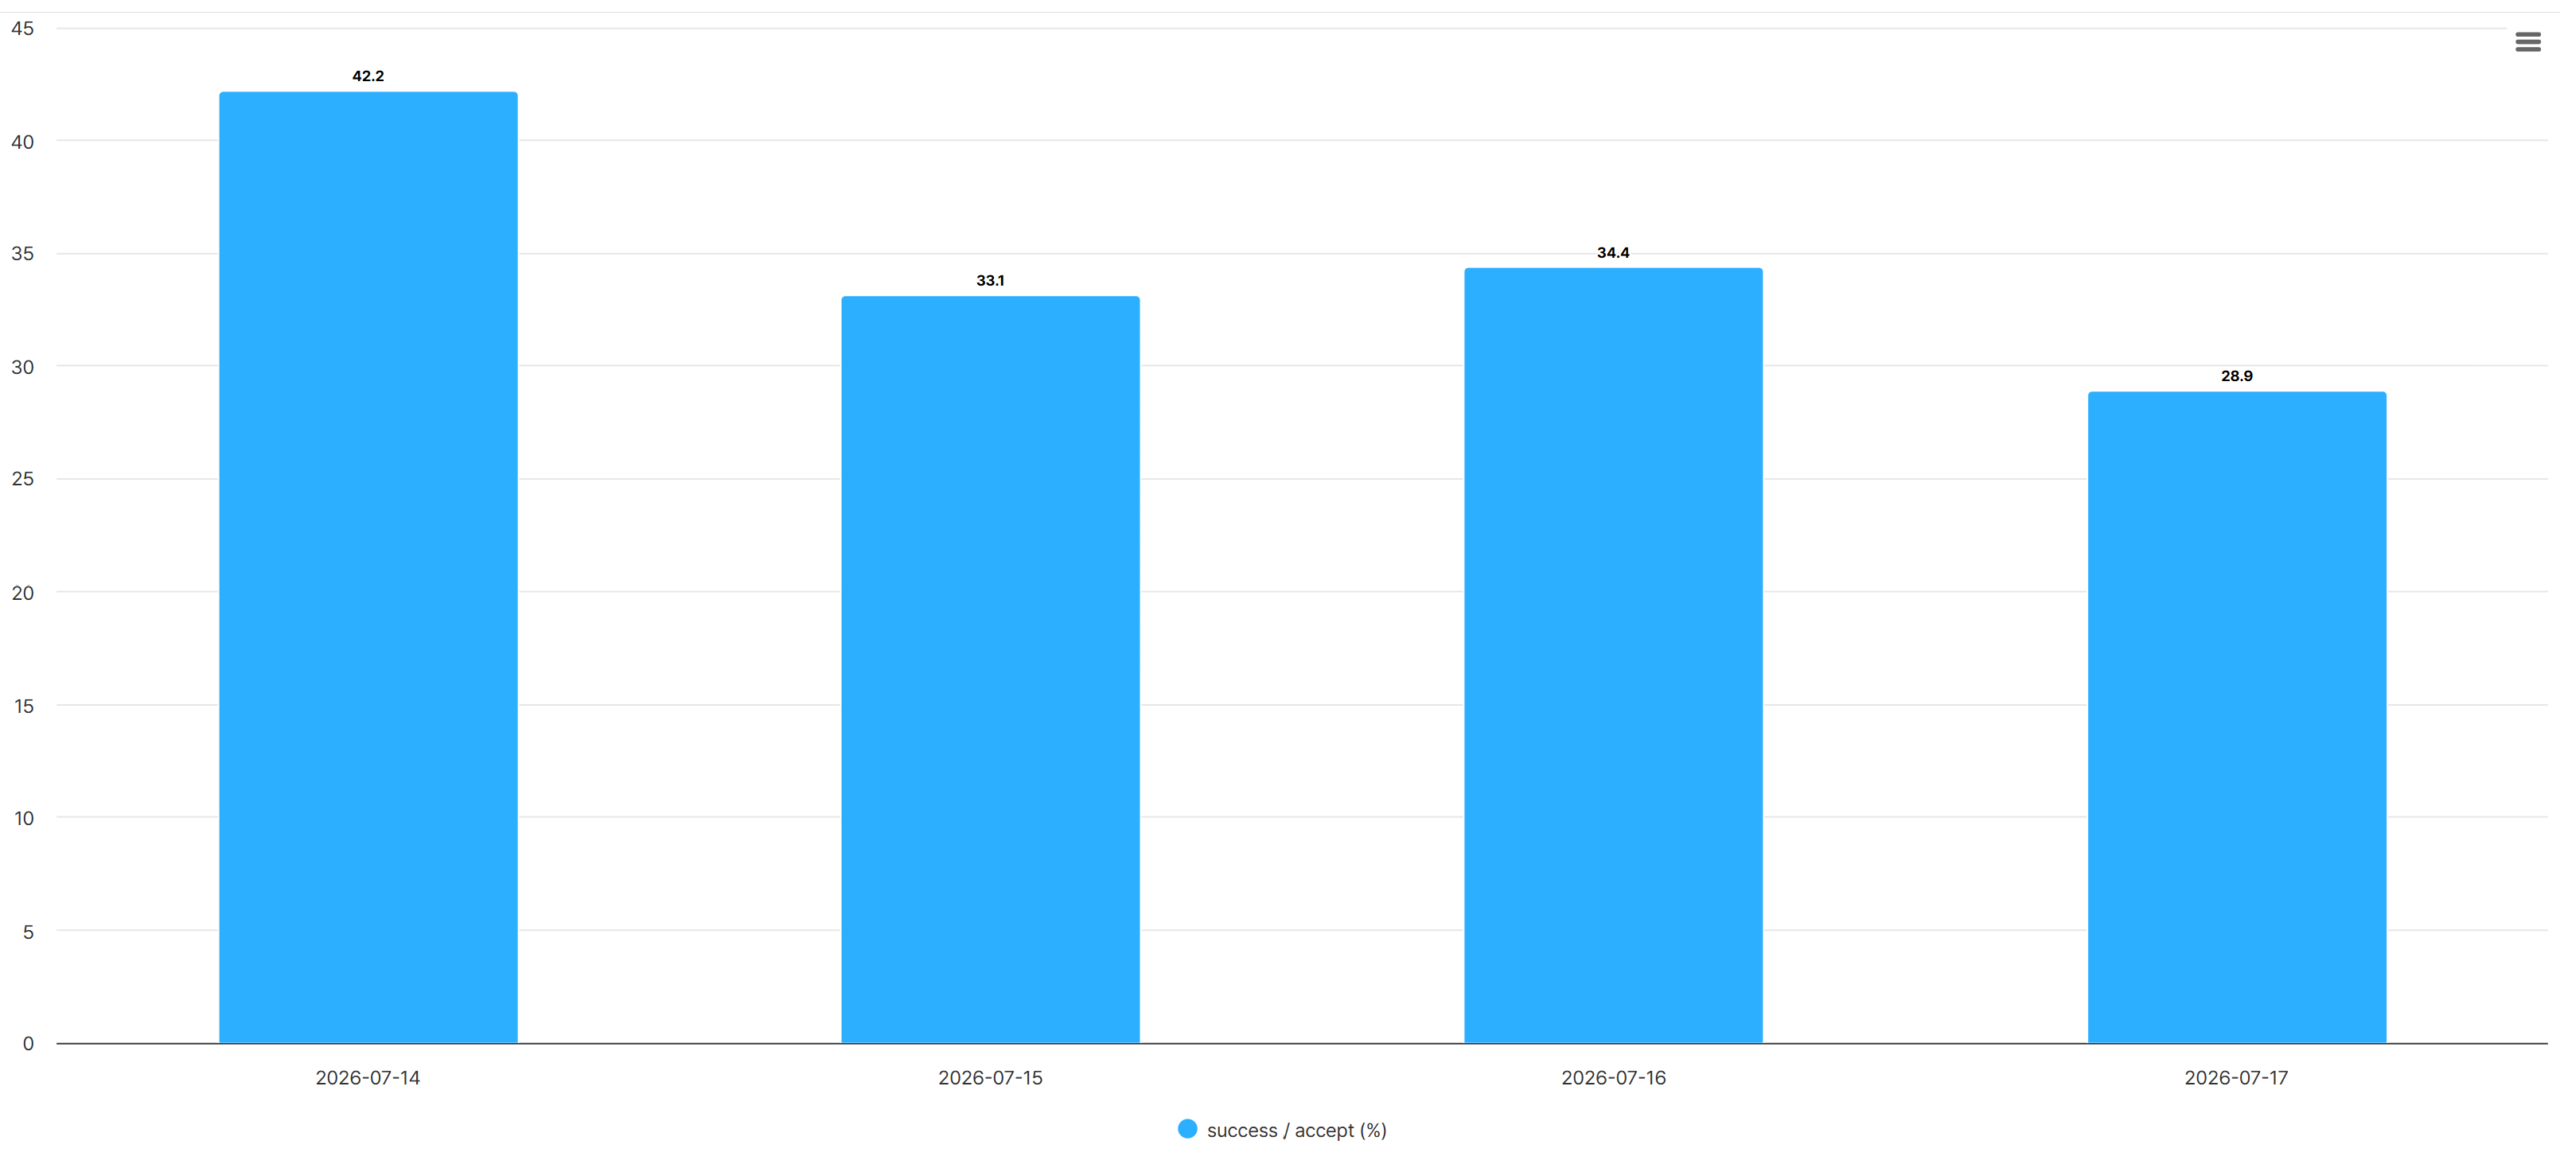
단계별 이탈 구간 확인
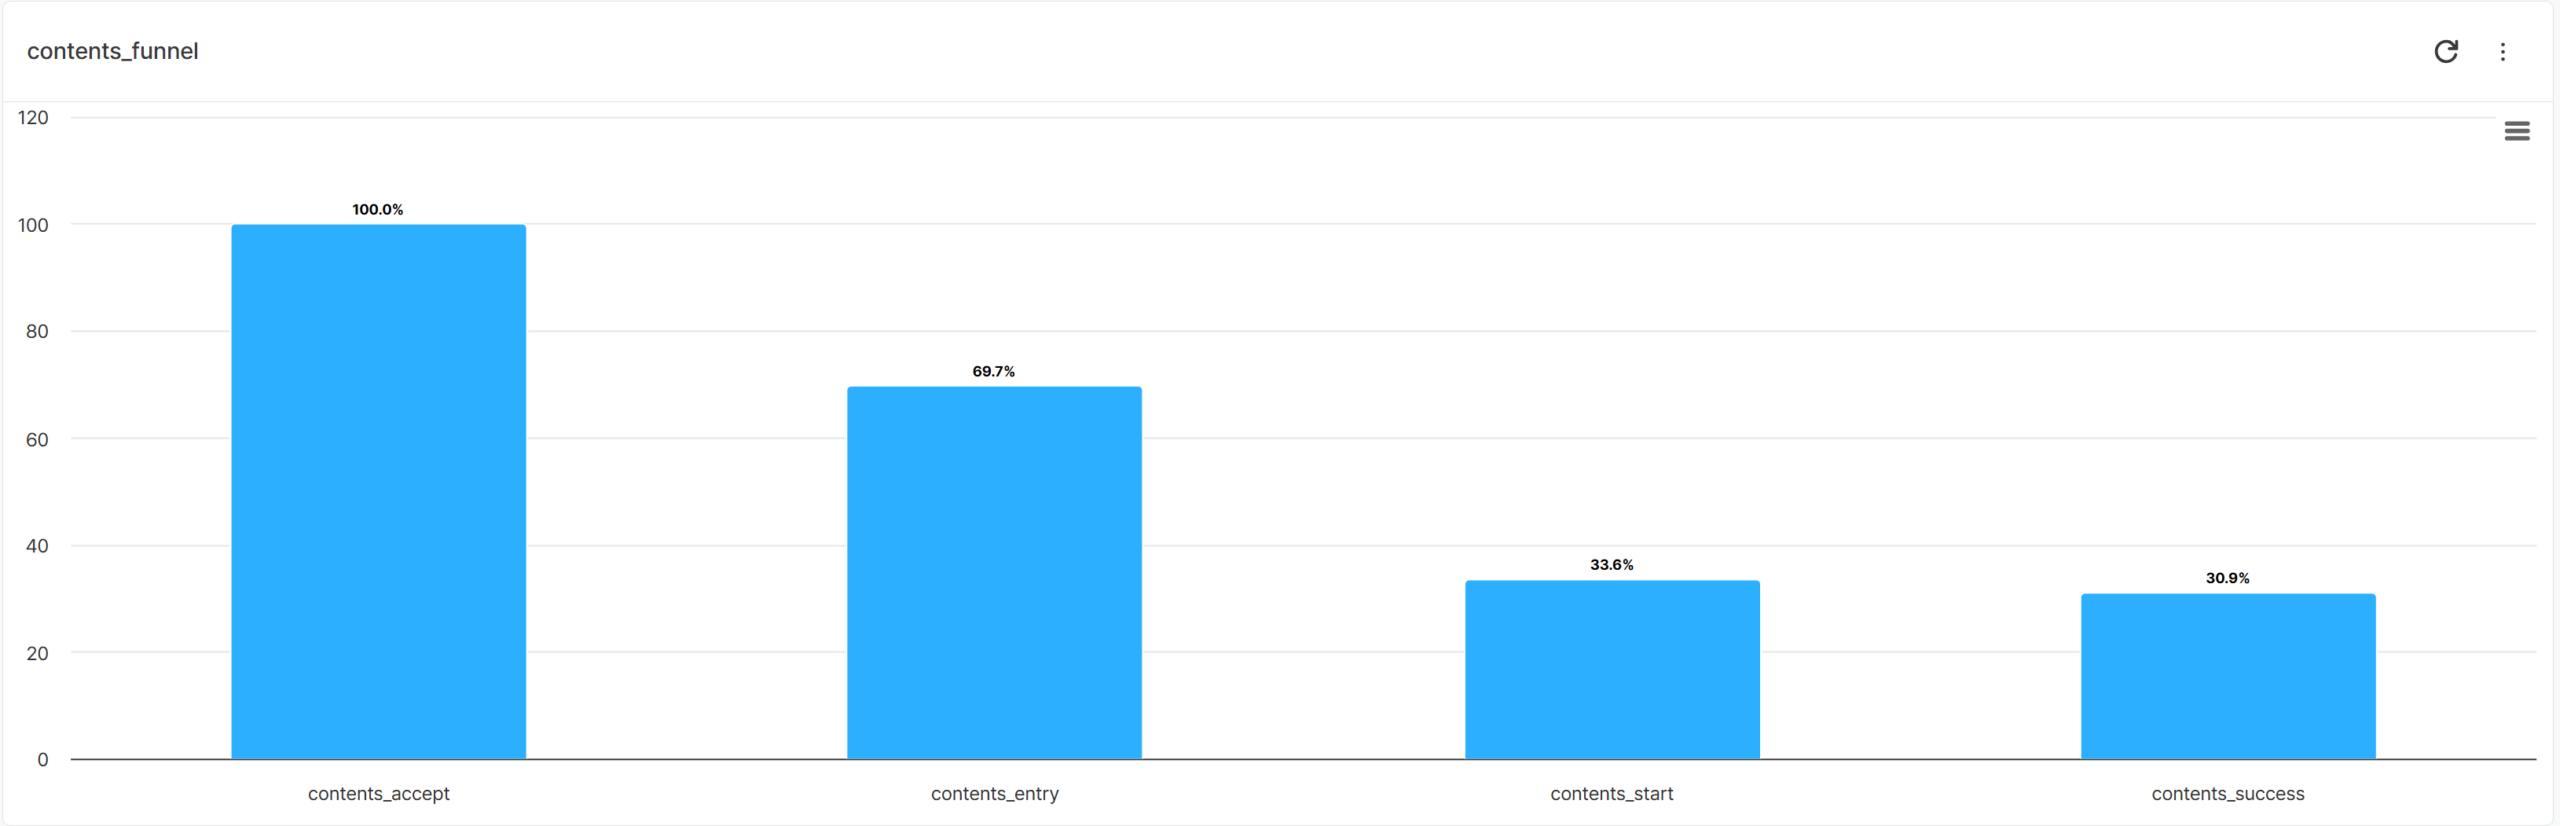
완료율이 낮아진 날짜의 콘텐츠 수락, 진입, 시작, 완료 이벤트를 퍼널로 확인하면 이용자가 어느 단계에서 이탈했는지 살펴볼 수 있다. 필요한 이용자 조건을 필터로 적용하면 특정 그룹의 흐름도 자세히 분석할 수 있다. 예시 화면에서는 콘텐츠 수락 이용자의 69.7%가 진입하고 34.0%가 시작했지만, 완료까지 도달한 비율은 1.6%에 그친다. 특히 시작 이후 완료 단계에서 이용자가 크게 줄어든 만큼 완료 조건과 난이도, 진행 안내 등 우선 검토할 범위를 좁힐 수 있다.
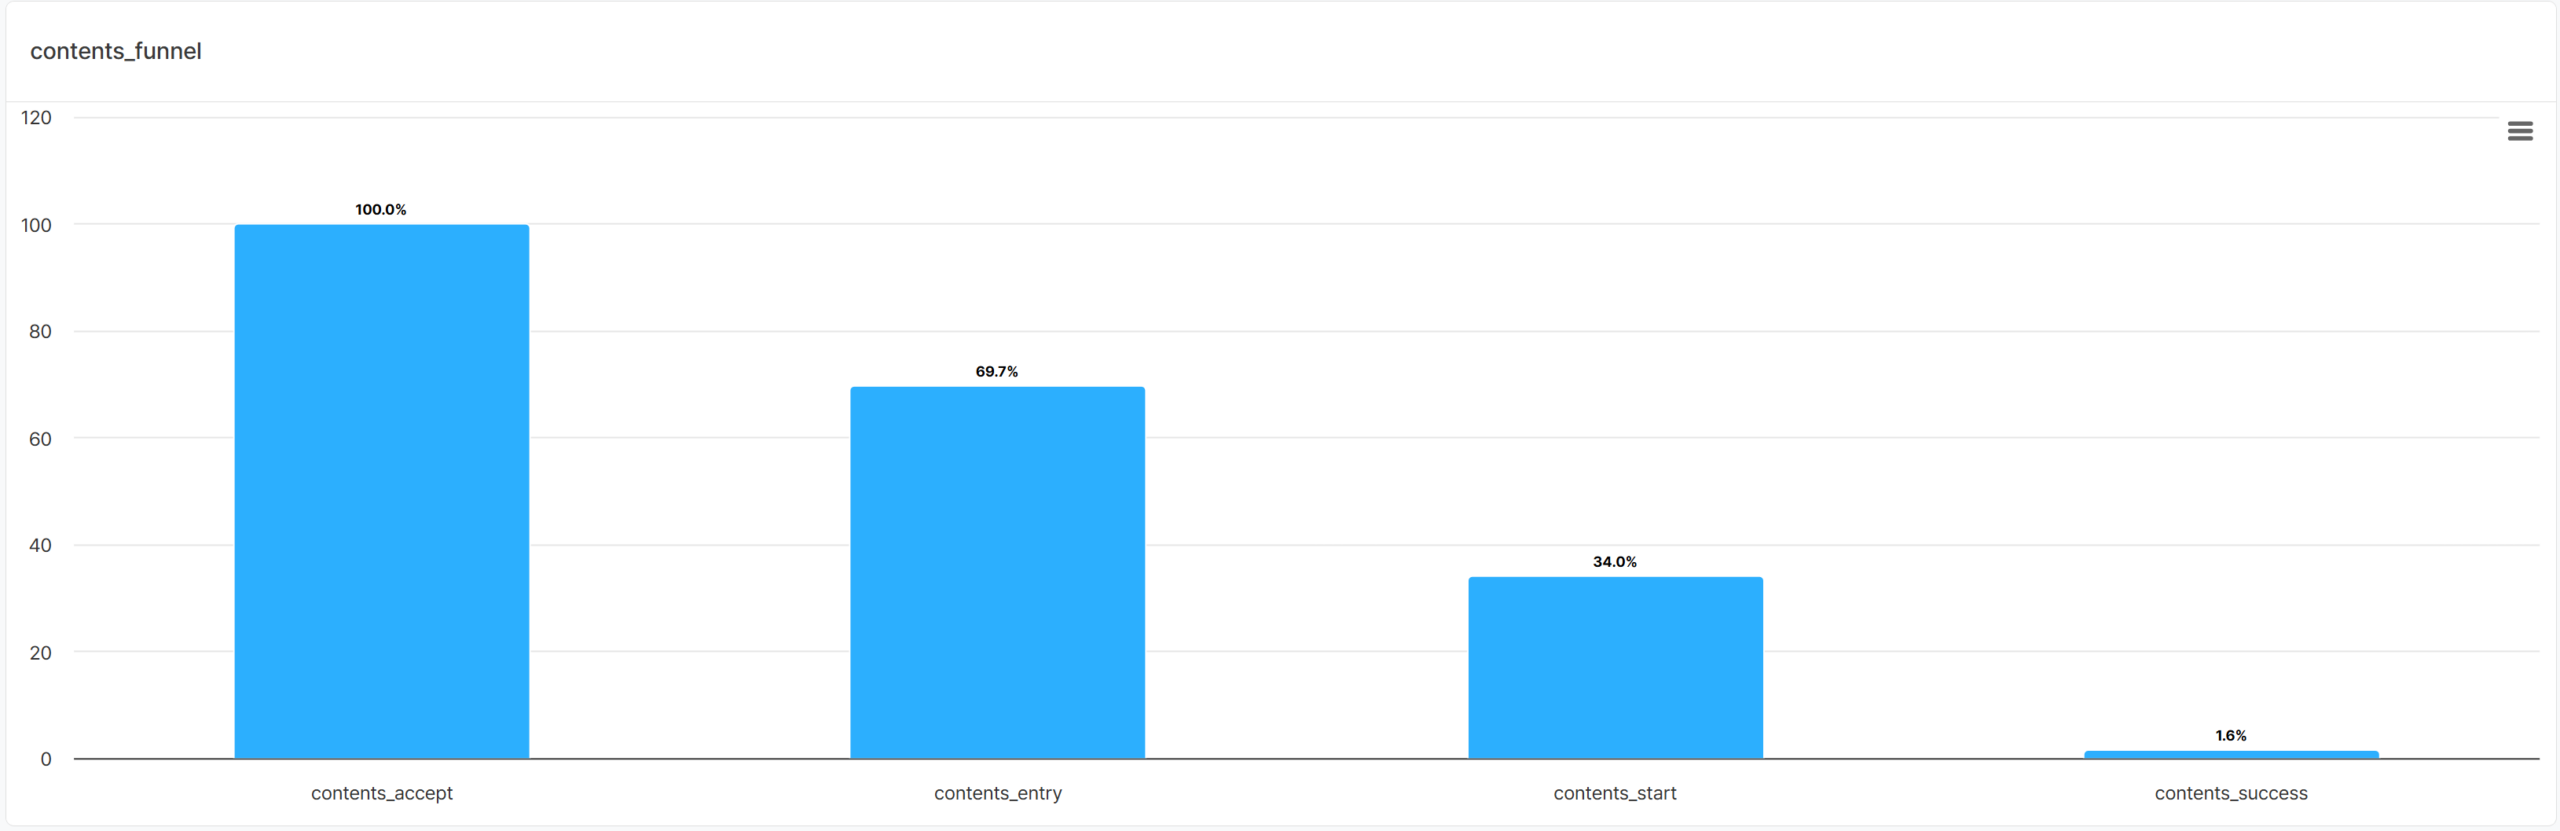
차트와 퍼널의 결과만으로 이탈 원인을 단정하기보다, 콘텐츠 유형이나 난이도, 이용자 레벨 등의 조건을 함께 비교해 차이가 두드러진 범위를 찾는 근거로 활용할 수 있다.
개선 이후 전환 변화 확인
완료 조건이나 난이도 등을 조정한 뒤 동일한 단계와 필터로 퍼널을 다시 확인하면 개선 전후의 변화를 비교할 수 있다. 예시 화면에서는 수락, 진입, 시작 단계의 도달률은 이전과 비슷하지만 완료 비율은 1.6%에서 30.9%로 높아졌다. 이를 통해 변경 이후 완료 단계의 이탈이 줄었는지 살펴보고, 추가로 보완할 구간을 판단할 수 있다.
Hive 애널리틱스 시작해보기
먼저 분석하려는 콘텐츠의 수락, 진행과 완료를 나타내는 이벤트가 수집되고 있는지 점검한다. 사전 정의된 콘텐츠 이벤트는 스키마에 맞춰 전송하고, 게임별로 추가 확인이 필요한 행동은 커스텀 이벤트와 속성으로 확장한다.
Hive 애널리틱스는 Hive SDK를 통해 커스텀 이벤트를 자유롭게 보낼 수 있고, 차트와 퍼널을 활용해 콘텐츠 수락부터 완료까지의 이용 흐름과 단계별 전환·이탈을 바로 분석할 수 있는 게임 전문 애널리틱스 솔루션이다. 지금 Hive 애널리틱스를 통해 콘텐츠 이용 규모와 단계별 흐름을 살펴보고, 기획 의도와 실제 이용 행동의 차이를 개선 판단에 활용해보자.
컴투스의 신작 MMORPG ‘제우스: 오만의 신’이 8월 26일 낮 12시 정식 서비스를 시작했다.
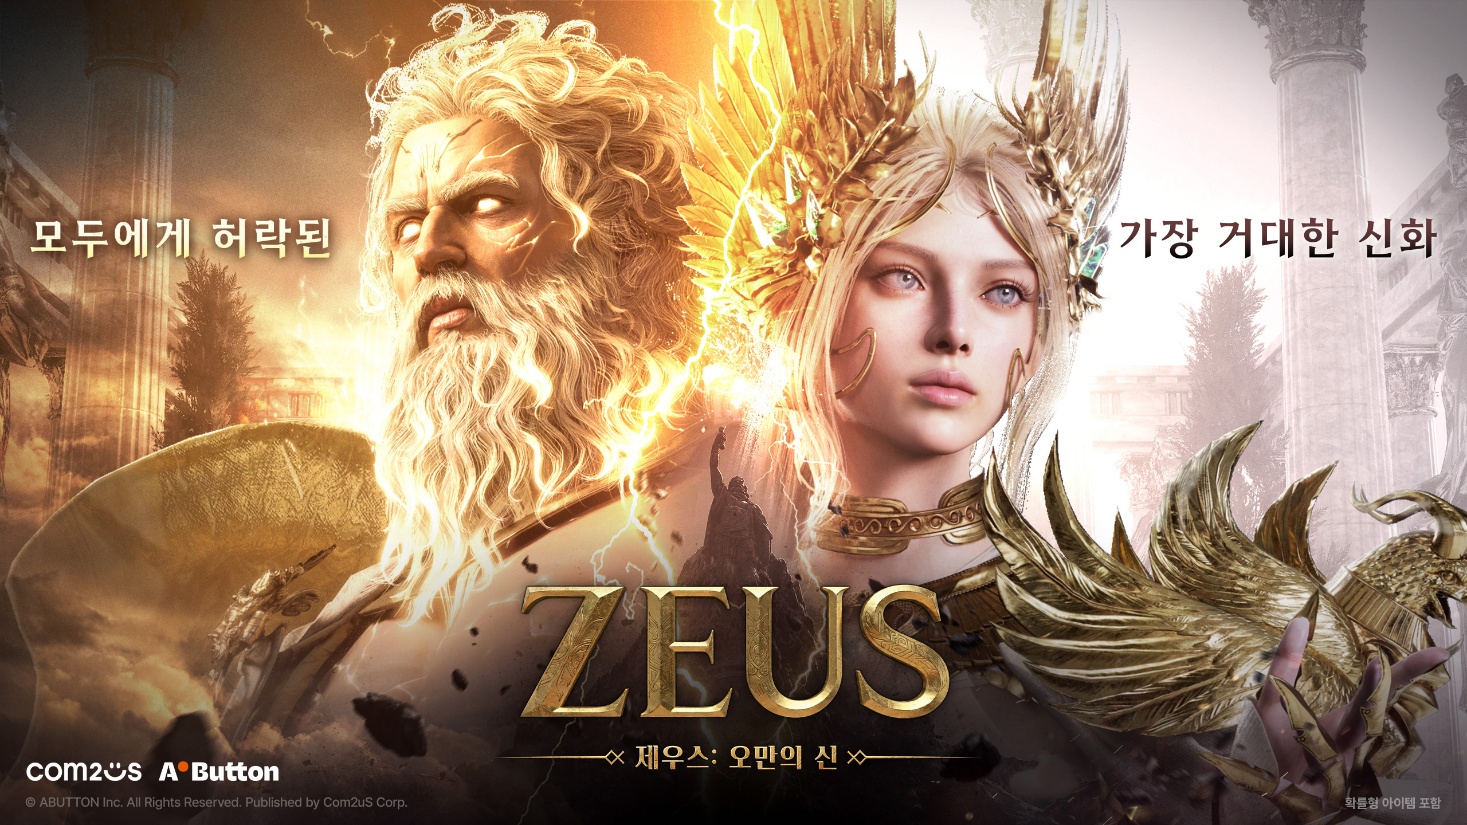
컴투스가 퍼블리싱하고 에이버튼이 개발한 ‘제우스: 오만의 신’은 PC와 모바일 플랫폼을 통해 국내 유저들과 만나고 있다. 아테나·아레스·제우스 등 그리스 신들의 이름을 딴 10개 서버 그룹, 총 30개 서버도 함께 운영 중이다.
출시 전부터 이어진 유저들의 관심은 정식 서비스 이후에도 뜨거운 반응으로 이어졌다. 지난 8월 24일 사전 다운로드를 시작한 뒤 국내 양대 마켓 인기 게임 순위 1위에 오른 데 이어, 26일 낮 12시 정식 출시 후 18시간 만에 애플 앱스토어와 구글 플레이 스토어 매출 순위에서도 모두 1위를 차지했다. 앞서 진행한 캐릭터명 선점 이벤트 역시 높은 참여 속에 전 회차가 빠르게 마감되는 등 출시 전부터 높은 기대감을 입증했다.
경쟁형 MMORPG의 새로운 방향을 제시하다
“모두가 재미있게 즐길 수 있는 경쟁형 MMORPG를 만들 수는 없을까.”
‘제우스: 오만의 신’은 이 질문에서 출발했다. 상위 유저 중심의 경쟁 구조와 누적된 성장 격차로 인해 경쟁의 재미가 일부 유저에게 집중되는 흐름에서 벗어나, 더 많은 유저가 각자의 방식으로 경쟁에 참여하고 성취감을 느낄 수 있도록 게임 전반을 설계했다.
이를 위해 경쟁 콘텐츠뿐만 아니라 클래스와 성장, 편의 기능, 경제 시스템에도 다양한 선택지를 마련했다. 유저는 직접 전투에 참여하거나 생산과 거래를 통해 게임 세계에 기여할 수 있으며, 자신의 성장 단계와 플레이 성향에 맞는 경쟁 방식을 선택할 수 있다.
그리스 신화를 재구성한 세계 ‘테이아’
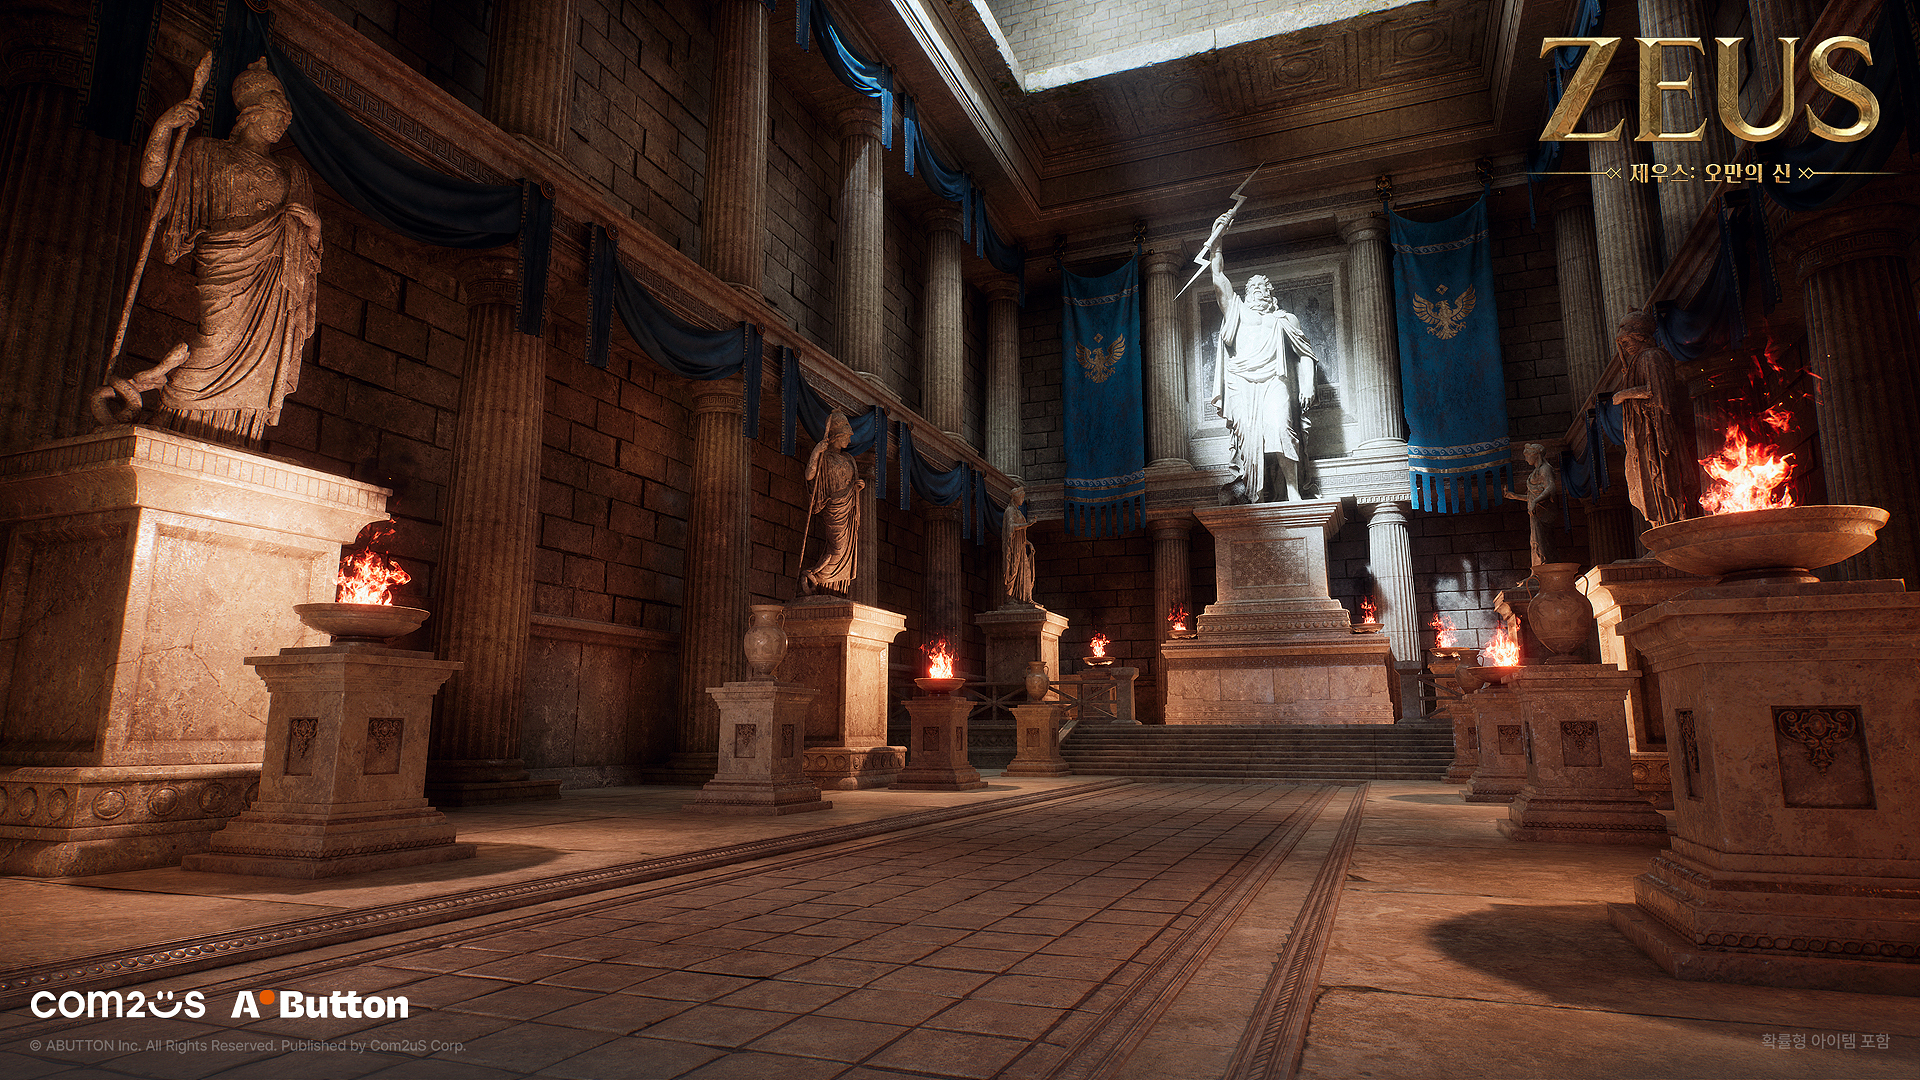
게임의 무대는 그리스 신화를 새롭게 재구성한 세계 ‘테이아’다. 신과 반신, 인간과 괴물이 공존하는 이곳에서 올림포스의 신들은 크로노스와 티탄과의 전쟁에서 승리하지만, 이들을 완전히 없애지 못한 채 봉인한다.
제우스의 절대적인 권력과 오만으로 세계에 균열이 일어나자, 유저는 신의 힘을 나누어 받은 존재로 혼돈에 맞선다. 여러 시련을 거쳐 가장 강한 ‘신의 그릇’으로 성장하는 것이 여정의 핵심이다.
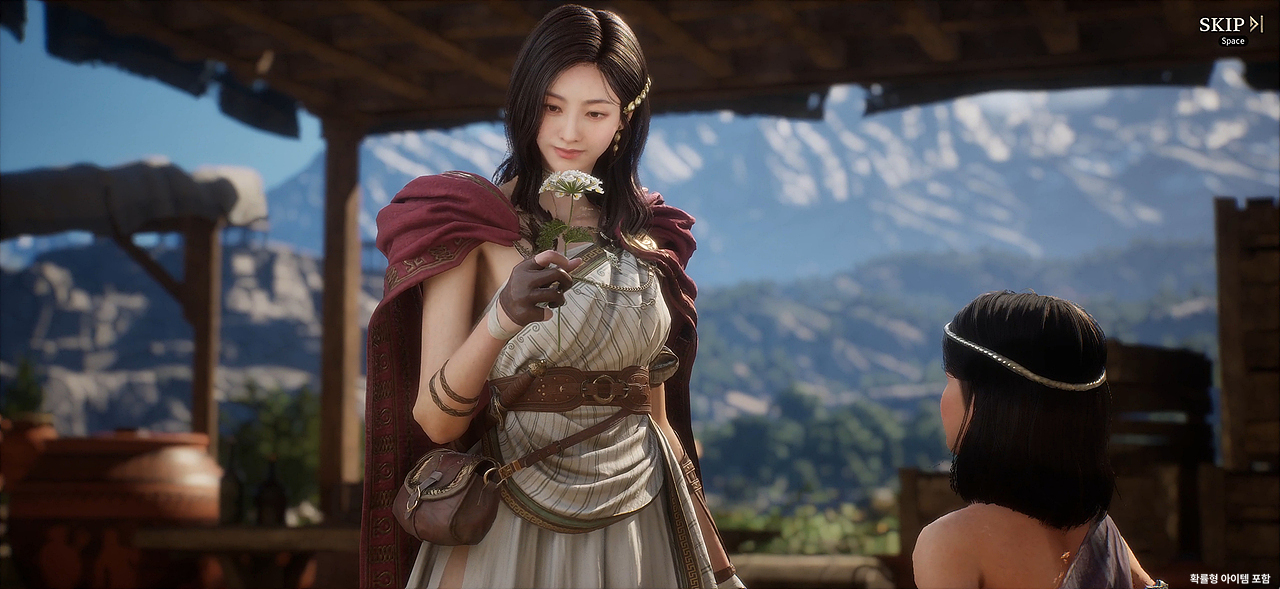
서사의 중심에는 핵심 NPC ‘판도라’가 있다. 판도라는 유저를 주요 사건으로 이끌고 신들과 연결하는 인물이다. 배우 박지현이 캐릭터 제작에 참여했으며, 페이셜 스캐닝과 음성 녹음을 통해 배우의 외형과 연기를 게임 속에 구현했다. 전령의 신 ‘헤르메스’도 유저의 여정을 안내하며 신들의 뜻을 전한다.
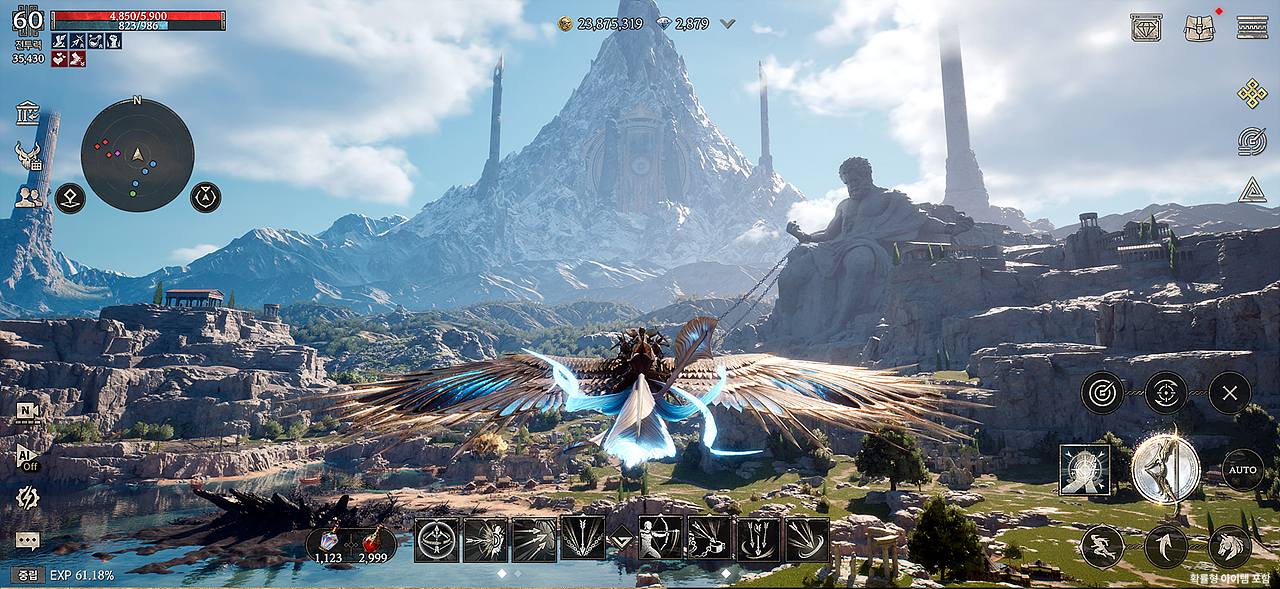
신화적 설정은 클래스와 전투에도 이어진다. 각 클래스는 특정 신의 가호와 연결되며, 주요 스킬과 액션에도 신들의 개성과 권능을 담았다. 테베와 테살리아, 자하브 등 주요 지역은 지중해 풍경과 곡창지대, 사막과 오아시스처럼 서로 다른 환경으로 구성됐다. 언리얼 엔진 5를 기반으로 각 지역의 특성과 웅장한 신화적 세계를 시각적으로 구현한 점도 특징이다.
각자의 방식으로 참여하는 경쟁 콘텐츠
‘제우스: 오만의 신’은 경쟁의 참여 범위를 넓히는 동시에 상위 유저가 느끼는 성취와 경쟁의 가치도 유지하도록 구성했다. 모든 유저가 같은 방식으로 맞붙는 대신, 성장 수준과 플레이 성향에 따라 경쟁 콘텐츠를 선택할 수 있다.
대표 콘텐츠인 ‘오디세이아’는 개인부터 길드 단위까지 PvE와 PvP를 폭넓게 아우른다. ‘콜로세움’에서는 유저의 외형과 전투 능력을 반영한 AI 개체 ‘페르소나’를 상대로 1대1 대결을 펼친다. 상대가 접속하지 않은 상태에서도 원하는 시간에 겨룰 수 있어 실시간 대전의 부담을 낮췄다.
길드 콘텐츠 ‘아카디아 제전’도 페르소나를 활용한 다대다 경쟁으로 진행된다. 시즌 동안 사냥을 비롯한 다양한 활동을 통해 전용 효과와 길드 스킬을 확보하고 이를 전투에 활용할 수 있어, 실제 대결뿐만 아니라 성장과 준비 과정도 경쟁의 일부가 된다.
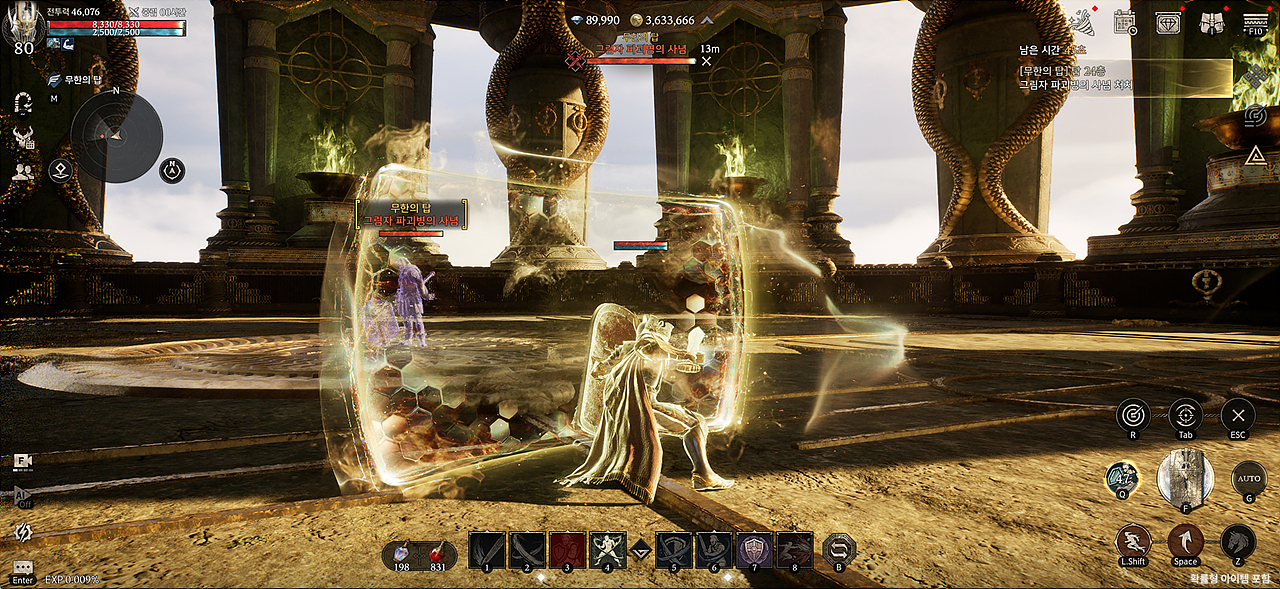
직접 경쟁 콘텐츠로는 필드 보스와 인터 서버 전장, 거점 점령을 비롯해 점령전·요새전·공성전으로 이어지는 대규모 전투를 마련했다. 간접 경쟁과 직접 경쟁을 함께 구성해 유저가 자신의 성향과 성장 단계에 맞는 콘텐츠를 선택할 수 있도록 했다.
신의 가호를 받은 8개 클래스
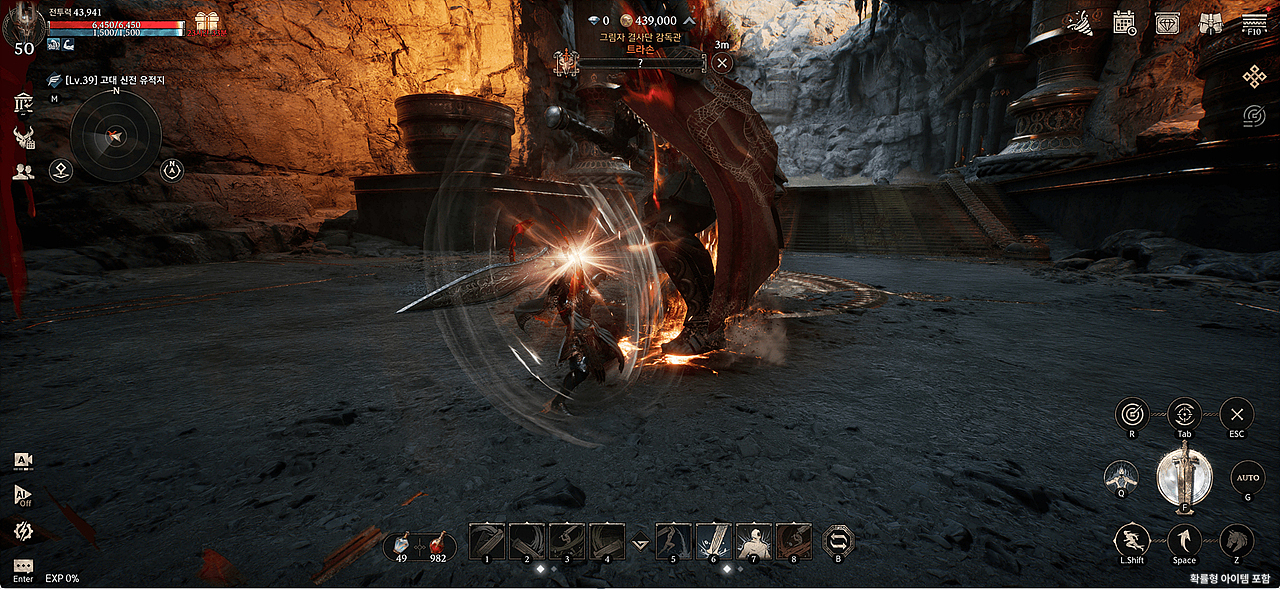
클래스는 워리어, 로그, 메이지, 파라곤 등 4개 기본 클래스에서 전직을 거쳐 총 8개로 확장된다.
아폴론의 가호를 받는 워리어는 ‘나이트’와 ‘버서커’, 아르테미스의 민첩함을 이어받은 로그는 ‘어쌔신’과 ‘레인저’로 나뉜다. 아테나의 가호를 받는 메이지는 ‘엘리멘탈리스트’와 ‘오라클’, 헤파이스토스의 가호를 받는 파라곤은 ‘블레스드’와 ‘아티산’으로 전직한다.
각 클래스는 공격 방식뿐만 아니라 전투와 게임 안에서 담당하는 역할에도 차이가 있다. 특히 아티산은 전용 제작 스킬을 성장시키며 다른 유저에게 필요한 재료와 아이템을 생산하고 거래소에 공급하는 경제 특화 클래스다. 유저는 직접 전투에 나서는 것 외에도 생산과 거래를 통해 게임 세계에서 자신의 역할을 만들 수 있다.
비접속 중에도 성장을 이어가는 ‘AI 모드’
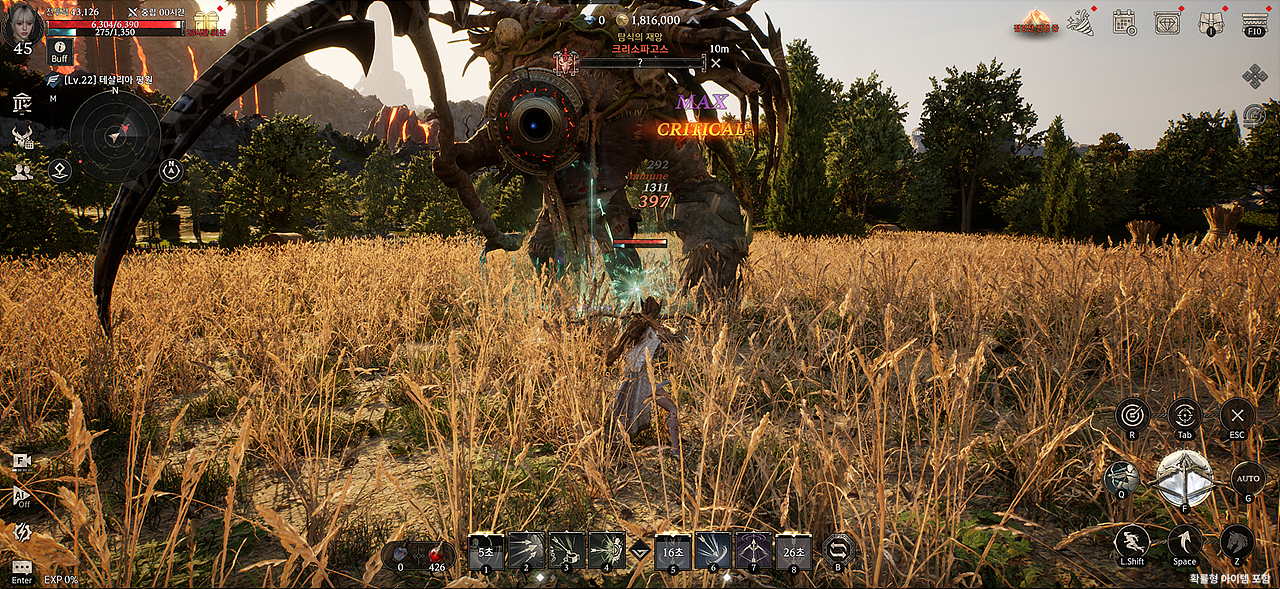
‘AI 모드’는 직접 접속하지 않은 시간에도 설정한 방식에 따라 사냥과 성장을 이어갈 수 있는 기능이다. 한 번의 조작으로 실행할 수 있으며, 클라이언트를 종료하거나 서버 점검이 진행된 이후에도 미리 설정한 스케줄에 따라 자동으로 다시 동작한다.
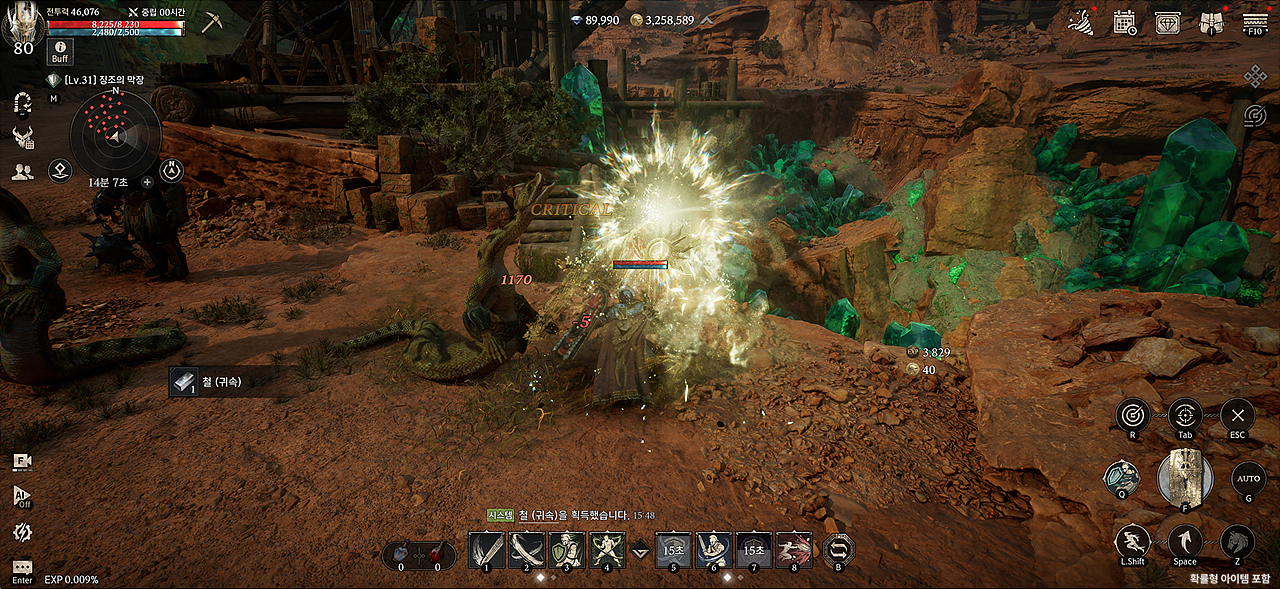
AI 모드가 작동하는 동안에도 캐릭터의 움직임을 화면으로 확인할 수 있다. 상점과 거래소 이용, 아이템 관리, 스킬 설정 등 필요한 조작도 가능하며, 시간대별 사냥터와 세부 위치를 지정해 플레이 계획을 세울 수도 있다.
‘징집’ 기능을 활용하면 AI 모드로 성장 중인 길드원의 캐릭터를 길드 콘텐츠에 투입할 수 있다. 반복적인 성장 구간의 부담은 줄이면서도 협력과 전투가 중요한 콘텐츠에서는 직접 조작의 의미를 유지하도록 구성했다.
생산과 거래가 다시 성장으로 이어지는 경제 구조
‘제우스: 오만의 신’은 플레이를 통해 획득한 아이템과 재화가 거래를 거쳐 다시 성장으로 이어지는 경제 구조를 갖췄다. 3개 서버를 하나로 연결한 ‘인터 서버 통합 거래소’를 통해 거래 범위도 넓혔다.
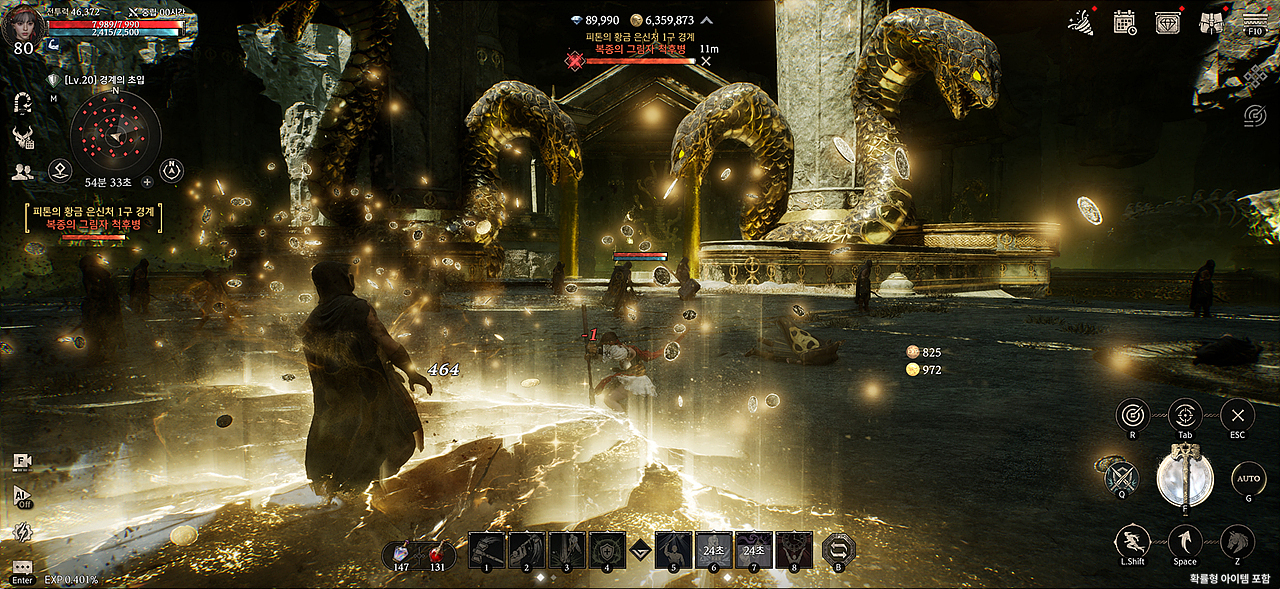
경제 특화 클래스 아티산은 성장 재료와 아이템을 제작해 거래소에 공급하며 경제 순환의 한 축을 담당한다. ‘미다스의 금고’에서는 특정 아이템을 시스템이 직접 매입하고 다이아를 지급한다. 아티산과 통합 거래소, 미다스의 금고를 중심으로 아이템의 획득과 제작, 거래, 소비가 다시 캐릭터 성장으로 연결된다.
PC와 모바일에서 시작되는 신화의 여정
‘제우스: 오만의 신’은 PC와 모바일 플랫폼을 모두 지원한다. PC 버전은 구글 플레이 게임즈를 통해 ‘제우스: 오만의 신’ PC 런처를 설치해 이용할 수 있으며, 모바일 버전은 구글 플레이 스토어와 애플 앱스토어에서 내려받을 수 있다.
정식 서비스 시작과 함께 유저들의 초기 성장을 지원하는 다양한 출시 기념 이벤트도 진행된다. 출석 이벤트와 게임의 주요 콘텐츠를 연계한 여러 이벤트를 통해 성장과 경쟁 구조를 폭넓게 경험할 수 있다.
출시와 함께 진행되는 인게임 이벤트는 ‘제우스: 오만의 신’ 공식 유튜브 채널에 공개된 ‘[제우스: 오만의 신] 론칭 이벤트 총정리 | 인게임 이벤트 편’ 영상에서도 확인할 수 있다. 게임 플레이에 도움이 되는 주요 보상과 이벤트 참여 방법을 한눈에 살펴볼 수 있다.
양대 마켓 인기 게임 순위 1위를 기록하며 정식 서비스를 시작한 ‘제우스: 오만의 신’에서 유저들은 이제 테이아의 세계를 무대로 전투와 협력, 생산과 거래를 경험하며 가장 강한 ‘신의 그릇’을 향한 여정을 시작한다.
게임 다운로드와 정식 출시 및 이벤트에 대한 자세한 내용은 공식 홈페이지와 공식 채널에서 확인할 수 있다.
ⓘ 확률형 아이템 포함
주의) 이 글은 eBPF 자체의 동작 원리나 쿠버네티스 자체의 동작 원리를 설명하는 글이 아니다.
Cilium은 쿠버네티스를 위한 eBPF 기반 네트워킹·보안·가시성(Observability) 플랫폼이다. 쿠버네티스에 배포된 파드는 저마다 IP를 가진 채로 죽고 다시 뜨기를 반복한다. 그때마다 IP가 바뀌고, 배포 한 번에 수십 개의 IP가 사라지고 새로 생기기 때문에 전통적인 제어 규칙인 IPTables는 그때마다 재작성이 필요하다. 이는 성능 저하로 이어질 수 있다. 더 큰 문제는 수시로 변하는 IP만으로는 “이 IP가 어떤 워크로드인가”를 정의하기 어렵다는 점이다.
Cilium은 이 문제를 IP 대신 Identity라는 개념으로 풀어낸다. Identity는 IP 주소가 아니라 파드(Pod)의 쿠버네티스 라벨(Label, 예: app=frontend)을 기반으로 부여되는 숫자 형식의 보안 식별자다. Cilium은 이 Identity 값을 기준으로 정책을 만들고 평가한다. 즉 파드가 100개로 늘어나도 정책 자체는 그대로 유지된다. 이를 정책으로 표현하면 다음과 같다. app=frontend Identity가 app=backend Identity와 통신 가능/불가능. 파드의 IP가 바뀌어도 라벨이 유지되면 같은 Identity를 사용하므로 정책을 수정할 필요가 없다. 이러한 Identity는 클러스터 내에서 전역으로 관리되는 값이다.
Identity 외에 추가로 알아야 할 개념이 Endpoint다. 컨테이너가 동일한 IP 주소를 공유하는 파드 단위를 Cilium에서는 Endpoint라고 부른다. Cilium은 클러스터 노드마다 개별 Endpoint ID를 할당하고 관리한다.
정리하면, 정책의 표현은 Identity 기준으로 만들고, 그 정책이 실제로 적용되는 대상은 Endpoint라고 설명할 수 있다. 예를 들어 아래와 같은 정책이 있다고 가정한다.
endpointSelector:
  matchLabels:
    app: netshoot
ingress:
- fromEndpoints:
    - matchLabels:
        app: backend
Cilium은 app: backend 라벨을 Identity로 변환한다. 즉 내부적으로는 Identity(12345, app=backend) -> Identity(6789, app=netshoot) 통신을 허용으로 처리하는 방식이다.
전통적인 쿠버네티스의 패킷 처리는 커널의 IPTables를 거친다. IPTables는 규칙 체인에 패킷이 도달하면 체인을 선형적으로 탐색해 판단하는데, 이는 대규모 서비스에서 병목이 될 수 있다. Cilium은 기존 IPTables 사용을 걷어내고 eBPF 프로그램을 커널의 특정 지점에 부착해 패킷을 처리한다. 이 부분은 뒤에서 다시 자세히 살펴본다. 내부 트래픽은 cgroup/connect를 후킹해서 처리하고, 외부 트래픽은 TC 혹은 TCX 계층을 후킹(eBPF 프로그램 부착)해서 처리한다. 그 결과 커널 네트워크 스택을 이른 시점에 종료시키고, IPTables처럼 선형적으로 탐색하는 구간도 사라져 속도 면에서 개선을 이뤘다. 즉 Cilium은 Pod to Pod 통신뿐 아니라 기존 kube-proxy가 제공하던 Service to Pod 기능까지 함께 수행한다.
앞으로 Cilium을 설명할 때 IP, Endpoint, Identity라는 세 가지 개념이 자주 등장하므로 헷갈리지 않도록 미리 정의하고 넘어간다.
Identity: 무엇인가(정체). 라벨에서 유도되며 클러스터 전역에서 같은 의미를 갖는다. 같은 라벨을 가진 파드 100개는 하나의 Identity를 공유한다.Endpoint: 이 노드 위의 워크로드 하나(노드 로컬 개념). 파드가 뜨면 그 노드에 Endpoint가 생기고 번호가 붙는다.IP: 어디에 있는가(위치). 파드마다 다르고 자주 바뀐다.
이번 Cilium 시리즈에서 쿠버네티스에 Cilium을 설치하는 과정 자체는 공식 문서에 잘 정리되어 있어 비교적 쉽게 따라갈 수 있다. 다만 설치를 마친 뒤 “datapath는 실제로 어떻게 동작하는가, 정책은 어떤 방식으로 적용되는가, 더 나아가 SNAT 모드와 DSR은 무엇이 다른가, 멀티클러스터는 어떻게 구성하는가”라는 질문 앞에서는 선뜻 답하기 어려운 경우가 많다.
이번 글에서는 Cilium의 DataPath가 어떻게 동작하는지 짚어보고, East-West 통신과 North-South 통신, Hubble을 거쳐 최종적으로는 ClusterMesh로 멀티클러스터 환경을 구축하는 것까지 실습을 통해 익히는 것을 목표로 한다.
이 실습 환경은 macOS를 기준으로 작성했지만 Linux에서도 동일하게 동작한다. 다만 본문에 등장하는 shell script는 환경에 따라 호환되지 않을 수 있다. 실습에 필요한 kind, docker 등은 이미 설치되어 있다고 가정한다.
환경 세팅
# kind-cilium.yaml
kind: Cluster
apiVersion: kind.x-k8s.io/v1alpha4
name: cilium-lab
networking:
  disableDefaultCNI: true # kindnet 끄기 -> Cilium이 CNI 담당
nodes:
  - role: control-plane
  - role: worker
  - role: worker
먼저 위와 같은 yaml을 만든다. disableDefaultCNI: true는 kind가 기본으로 쓰는 kindnet CNI를 끄겠다는 뜻이다. CNI는 이 자리에 Cilium을 설치해서 대신한다.
kind create cluster --config ./kind-cilium.yaml
이 명령어로 kind 쿠버네티스 클러스터를 만든다. 이어서 아래 명령어로 Node와 Pod의 상태를 확인한다.
# 노드 목록 불러오기
kubectl get nodes

NAME                       STATUS     ROLES           AGE   VERSION
cilium-lab-control-plane   NotReady   control-plane   14s   v1.34.0
cilium-lab-worker          NotReady   <none>          5s    v1.34.0
cilium-lab-worker2         NotReady   <none>          5s    v1.34.0

# 파드 목록 불러오기
kubectl get pods -A

NAMESPACE            NAME                                               READY   STATUS    RESTARTS   AGE
kube-system          coredns-66bc5c9577-699pt                           0/1     Pending   0          13s
kube-system          coredns-66bc5c9577-wlwmx                           0/1     Pending   0          13s
kube-system          etcd-cilium-lab-control-plane                      1/1     Running   0          19s
kube-system          kube-apiserver-cilium-lab-control-plane            1/1     Running   0          19s
kube-system          kube-controller-manager-cilium-lab-control-plane   1/1     Running   0          19s
kube-system          kube-proxy-5q4kw                                   1/1     Running   0          13s
kube-system          kube-proxy-ljps8                                   1/1     Running   0          12s
kube-system          kube-proxy-vprd4                                   1/1     Running   0          12s
kube-system          kube-scheduler-cilium-lab-control-plane            1/1     Running   0          19s
local-path-storage   local-path-provisioner-7b8c8ddbd6-6jwr7            0/1     Pending   0          13s
coredns 파드가 Pending 상태에 머물러 있어 노드 상태 역시 NotReady로 나타난다. 아래 명령어로 Cilium을 설치한다.
cilium install --version 1.19.5
cilium status --wait
다시 kubectl get nodes를 실행하면 노드 상태가 Ready로 바뀐 것을 확인할 수 있다. 이것으로 첫 번째 Cilium 설치를 마쳤다. 이제 무엇이 어떻게 설치됐는지 좀 더 자세히 들여다본다.
kubectl exec -n kube-system ds/cilium -- cilium status --verbose | head -50

KVStore:                Disabled
KubeProxyReplacement:   False
Cilium:                 Ok   1.19.5 (v1.19.5-20eaccfe)
NodeMonitor:            Listening for events on 8 CPUs with 64x4096 of shared memory
Cilium health daemon:   Ok
IPAM:                   IPv4: 5/254 allocated from 10.244.1.0/24,
Allocated addresses:
  10.244.1.152 (health)
  10.244.1.153 (kube-system/coredns-66bc5c9577-699pt)
  10.244.1.201 (local-path-storage/local-path-provisioner-7b8c8ddbd6-6jwr7)
  10.244.1.210 (router)
  10.244.1.65 (kube-system/coredns-66bc5c9577-wlwmx)
Routing:                Network: Tunnel [vxlan]   Host: Legacy
Attach Mode:            TCX
Device Mode:            veth
Masquerading:           IPTables [IPv4: Enabled, IPv6: Disabled]
KubeProxyReplacement: False— kube-proxy가 대체됐는지 여부다. 이 시리즈 뒤쪽에서 kube-proxy를 Cilium으로 대체하는 실습을 진행한다.Routing: Network: Tunnel [vxlan] Host: Legacy— 기본값인 Tunnel VXLAN 방식이다. worker 노드의 파드가 다른 노드의 파드로 패킷을 보내면 Cilium이 원본 패킷 전체를 VXLAN(UDP 8472)으로 감싸 노드 간에 전송하고, 목적지 노드에서 이를 다시 풀어낸다.Legacy는 host routing이 아직 eBPF 가속 모드가 아니라는 뜻이다.Attach Mode: TCX— eBPF 프로그램이 tcx 계층에 부착됐다는 뜻이다. 리눅스 커널 6.6 이상에서 도입된 새 Attach API이며, 레거시 방식은 tc다.Device Mode: veth— 파드 연결에 veth 쌍을 사용한다는 뜻이다(최신 Cilium은 netkit도 지원한다). 이후 등장하는lxcXXXXXX인터페이스가 이 veth의 호스트 쪽이다.Masquerading: IPTables [IPv4: Enabled]— 파드가 클러스터 밖으로 나갈 때 소스 IP를 노드 IP로 바꾸는 SNAT를 아직 IPTables가 담당하고 있다는 뜻이다. 이 부분도 뒤에서 eBPF로 바꾼다.
다음으로 넘어가기 전에 짚고 갈 개념이 하나 있다. CNI는 pod to pod 네트워크 자체를 만들어주는 역할을 한다. 파드가 뜰 때 veth 쌍을 만들고 IP를 할당하며 라우팅과 캡슐화를 세팅해, 파드 A가 파드 B의 IP로 직접 통신할 수 있게 하는 것이 CNI의 일이다. 반면 kube-proxy는 파드끼리 이미 통신 가능하다는 전제 위에서, Service라는 가상 IP 추상화를 실제 파드 IP로 변환하는 일만 담당한다. 지금 이 클러스터의 kube-proxy는 IPTables/IPVS 기반으로 DNAT를 수행하고 있다. 이 부분을 뒤에서 eBPF로 바꾸는 실습을 진행할 예정이므로, 지금 단계의 kube-proxy는 크게 신경 쓰지 않아도 된다.
여기서 끝내면 아쉬우니 실제로 Pod를 배포해 테스트까지 이어간다. 앞서 개론에서 “eBPF 프로그램을 커널 훅에 부착한다”고 언급했는데, 그 프로그램들이 실제로 어디에 붙어 있는지 확인해본다.
kubectl create deployment netshoot --image=nicolaka/netshoot -- sleep 3600
kubectl scale deployment netshoot --replicas=2

# 배포된 netshoot 확인
kubectl get pods -o wide
NAME                        READY   STATUS    RESTARTS   AGE     IP             NODE
netshoot-7b776d8bd4-f6qxd   1/1     Running   0          6m11s   10.244.1.182   cilium-lab-worker
netshoot-7b776d8bd4-hfwlp   1/1     Running   0          6m11s   10.244.2.42    cilium-lab-worker2
각종 네트워크 도구가 담긴 netshoot 디플로이먼트를 배포하고 replicas를 2로 설정해 파드 2개를 띄운다. 이어서 eBPF 프로그램이 실제로 어디에 붙어 있는지 확인한다.
# 커널 네트워크 서브시스템에 부착된 eBPF 프로그램 목록을 나열한다.
kubectl exec -n kube-system ds/cilium -- bpftool net show

xdp:

tc:
eth0(11) tcx/ingress cil_from_netdev prog_id 2851 link_id 207
cilium_net(12) tcx/ingress cil_to_host prog_id 2843 link_id 206
cilium_host(13) tcx/ingress cil_to_host prog_id 2838 link_id 204
cilium_host(13) tcx/egress cil_from_host prog_id 2840 link_id 205
cilium_vxlan(14) tcx/ingress cil_from_overlay prog_id 2796 link_id 202
cilium_vxlan(14) tcx/egress cil_to_overlay prog_id 2797 link_id 203
lxc_health(16) tcx/ingress cil_from_container prog_id 2900 link_id 209
lxc44e1332ddc99(18) tcx/ingress cil_from_container prog_id 3013 link_id 217
lxc7932f9158faa(20) tcx/ingress cil_from_container prog_id 3020 link_id 218
lxcdf38f3bd8367(22) tcx/ingress cil_from_container prog_id 3030 link_id 219
lxc16317f8e8c4a(24) tcx/ingress cil_from_container prog_id 3281 link_id 229

flow_dissector:

netfilter:
bpftool net show는 xdp, tc, flow_dissector, netfilter 각 계층에 어떤 eBPF 프로그램이 부착됐는지 보여준다. 여기서는 tc 계층의 각 네트워크 인터페이스에 부착된 프로그램을 확인할 수 있다.
eth0(11) tcx/ingress cil_from_netdev— 노드의 물리 NIC로, 노드 외부에서 들어오는 패킷의 첫 관문이다. NodePort 트래픽이나 다른 노드에서 온 VXLAN 패킷이 여기로 들어온다. 이름 그대로tcx계층에 부착돼 있다.cilium_net(12) tcx/ingress cil_to_host—cilium_host와cilium_net은 호스트 네임스페이스 자신을 위한 veth 쌍이다.cilium_host에는 노드 라우터 IP가 할당된다.cilium_vxlan(14) tcx/ingress cil_from_overlay—Routing: Tunnel [vxlan]의 실체다. 다른 노드에서 온 VXLAN 패킷을 풀어(디캡슐) 목적지 파드로 넘긴다.cilium_vxlan(14) tcx/egress cil_to_overlay— 마찬가지로Routing: Tunnel [vxlan]의 실체다. 다른 노드로 보낼 패킷을 VXLAN으로 캡슐화한다.lxc_health(16) tcx/ingress cil_from_container— endpoint list에서 identity 4번인reserved:health에 해당하며, 노드마다 있는 cilium-health endpoint의 veth다.lxc16317f8e8c4a(24) tcx/ingress cil_from_container— 파드 veth 중 호스트 쪽 인터페이스로, 파드에서 나온 패킷을 처리하는 eBPF 프로그램이 붙어 있다.
파드가 패킷을 보내는 datapath는 파드 → lxcXXXXXX(cil_from_container) → 같은 노드라면 목적지 lxcXXXXXX로, 다른 노드라면 cilium_vxlan(cil_to_overlay로 VXLAN 캡슐화) → eth0 밖으로 흐르는 순서다.
/* Attachment/entry point is ingress for veth.
 * It corresponds to packets leaving the container.
 */
__section_entry
int cil_from_container(struct __ctx_buff *ctx)
반대로 파드가 패킷을 받는 datapath는 eth0(cil_from_netdev) → cilium_vxlan(cil_from_overlay, VXLAN 디캡슐) → 목적지 lxcXXXXXX → 파드 순서로 동작한다.
lxc16317f8e8c4a 인터페이스가 어느 파드의 것인지 직접 확인해본다.
# cilium-smx67은 worker2에 배포된 pod다.
kubectl exec -n kube-system cilium-smx67 -- cilium endpoint list | grep netshoot

ENDPOINT   POLICY (ingress)   POLICY (egress)   IDENTITY   LABELS (source:key[=value])
847        Disabled           Disabled          15160      k8s:app=netshoot

# cilium-mxrsz는 worker에 배포된 pod다.
kubectl exec -n kube-system cilium-mxrsz -- cilium endpoint list | grep netshoot
ENDPOINT   POLICY (ingress)   POLICY (egress)   IDENTITY   LABELS (source:key[=value])
1487       Disabled           Disabled          15160      k8s:app=netshoot
netshoot 워크로드는 각각 847, 1487 Endpoint를 갖지만 Identity는 둘 다 15160으로 같다. 워크로드는 Identity를 공유할 수 있어도 Endpoint는 워크로드마다 개별로 부여된다는 점을 확인할 수 있다.
kubectl -n kube-system exec cilium-mxrsz -- cilium endpoint get 1487 | grep interface

"container-interface-name": "eth0",
"interface-index": 24,
"interface-name": "lxc16317f8e8c4a",
이 명령어는 cilium-mxrsz 파드가 배포된 노드에서 endpoint 1487의 interface 정보를 조회한다. 결과를 보면 컨테이너 내부 interface는 eth0이고, veth pair로 호스트에 만들어진 interface는 lxc16317f8e8c4a이며 index는 24다. 즉 파드에서 패킷이 나가면 파드 내부의 eth0을 거쳐 veth pair인 lxc16317f8e8c4a로 주입되고, 이 시점에 cil_from_container eBPF 프로그램이 트리거된다.
eBPF Program & MAP
eBPF 프로그램이 어느 지점에 붙어 있는지는 확인했다. 이 프로그램들은 패킷이 흐를 때 트리거되어 정해진 기준에 따라 패킷을 처리하는데, 그 기준이 되는 정보는 eBPF 맵에 저장된다.
eBPF 프로그램은 이벤트로 트리거되는 코드일 뿐 상태를 직접 저장하지 않는다. 대신 eBPF 맵(Map)이라는 커널 자료구조를 읽고 쓴다. 이 맵은 커널 스페이스와 유저 스페이스 양쪽에서 접근할 수 있다. Identity, 서비스 및 백엔드 목록, 연결 상태 같은 데이터가 여기에 기록되고, 커널에 부착된 eBPF 프로그램은 패킷을 처리할 때 이 맵을 참조한다.
cilium_ipcache: 모든 IP → Identity 매핑cilium_lb4_services: 서비스 로드밸런싱 테이블(kube-proxy 대체)cilium_lb4_backends: 백엔드 파드 로드밸런싱 테이블(kube-proxy 대체)cilium_ct4: 커넥션 트랙 테이블
이 밖에도 다양한 맵이 존재하며 cilium 명령어로 직접 조회할 수 있다.
# ipcache eBPF 맵 조회
kubectl exec -n kube-system ds/cilium -- cilium bpf ipcache list

IP PREFIX/ADDRESS   IDENTITY
10.244.2.0/24       identity=2 encryptkey=0 tunnelendpoint=172.18.0.4 flags=hastunnel
0.0.0.0/0           identity=2 encryptkey=0 tunnelendpoint=0.0.0.0 flags=<none>
10.244.1.210/32     identity=1 encryptkey=0 tunnelendpoint=0.0.0.0 flags=<none>
10.244.2.42/32      identity=15160 encryptkey=0 tunnelendpoint=172.18.0.4 flags=hastunnel
10.244.1.182/32     identity=15160 encryptkey=0 tunnelendpoint=0.0.0.0 flags=<none>
앞서 확인한 netshoot 파드의 IP가 ipcache에서도 동일하게 확인된다. 여기서 매핑된 Identity도 함께 볼 수 있는데, 이 명령어로 “이 파드는 어느 노드로 캡슐화해서 보내야 하는가”라는 라우팅 정보를 확인할 수 있다.
# identity 목록 조회
kubectl exec -n kube-system ds/cilium -- cilium identity list

ID      LABELS
1       reserved:host
2       reserved:world
4       reserved:health
6       reserved:remote-node
15160   k8s:app=netshoot
이 Identity가 어떤 라벨로 설정돼 있는지는 cilium identity list 명령어로 확인할 수 있다. 앞서 배포한 netshoot은 15160 k8s:app=netshoot Identity를 가지며, 그 밖에도 여러 예약어 Identity가 존재한다.
reserved:host: 노드 자신reserved:world: 클러스터 외부 전체(정책에서는 외부 인터넷을 가리킴)reserved:remote-node: 다른 노드들reserved:health: 노드별 cilium-health endpoint
10.244.1.182와 10.244.2.42는 서로 다른 노드의 파드지만 Identity는 둘 다 15160으로 동일하다. 개론에서 설명한 “같은 라벨의 파드는 하나의 Identity를 공유한다”는 원리를 맵에서 직접 확인한 셈이다.
worker 노드에 배포된 netshoot-7b776d8bd4-f6qxd에서 worker2에 배포된 netshoot-7b776d8bd4-hfwlp로 ICMP PING을 보내는 과정을 모니터링해본다. 모니터링은 worker2에서 진행한다.
kubectl -n kube-system exec -it cilium-smx67 -- cilium monitor --related-to 847
이 명령어는 worker2의 cilium(cilium-smx67)에서 endpoint 847과 관련된 이벤트만 보는 중이다.
kubectl exec netshoot-7b776d8bd4-f6qxd -- ping -c 1 10.244.2.42
다른 터미널에서 netshoot-7b776d8bd4-hfwlp로 ping을 한 번 보낸다.
-> endpoint 847 flow 0x0 , identity 15160->15160 state new ifindex lxc6571eaf7f620 orig-ip 10.244.1.182: 10.244.1.182 -> 10.244.2.42 icmp EchoRequest

-> overlay flow 0x0 , identity 15160->15160 state reply ifindex cilium_vxlan orig-ip 0.0.0.0: 10.244.2.42 -> 10.244.1.182 icmp EchoReply
이 로그에서 눈여겨볼 정보는 identity 15160->15160(어떤 Identity 간의 통신인가), state new(새로운 연결), ifindex lxc6571eaf7f620(이 인터페이스에서 캡처됨), ifindex cilium_vxlan(곧 cil_to_overlay가 이를 VXLAN으로 캡슐화해 다른 노드로 넘길 예정)이다.
정리하면, worker 노드의 파드가 EchoRequest를 전송 → lxc16317f8e8c4a(cil_from_container) → 다른 노드로 가야 하므로 cil_to_overlay가 VXLAN으로 캡슐화 → eth0 → 물리망 → worker2 노드의 eth0 → cil_from_overlay가 VXLAN을 디캡슐 → worker2에 배포된 파드가 EchoReply를 생성해 전송하는 흐름이다.
Identity는 어떻게 전달되는가
monitor 로그를 보면 어떤 Identity에서 수신했고 어떤 Identity로 전송했는지 알 수 있다. 서로 다른 노드를 하나의 네트워크망으로 연결하는 방식에는 Underlay와 Overlay 두 가지가 있다. kindnet은 기본적으로 Underlay 방식을 쓰지만, 지금 배포한 Cilium CNI는 Overlay Network를 구성한다. 이 Overlay Network에서는 서로 다른 노드가 VXLAN 통신으로 패킷을 주고받으며, 이때 VXLAN의 VNI 필드에 Identity 값을 담아 전송한다. 이 내용을 직접 확인해본다.
docker exec cilium-lab-worker2 bash -c "apt update && apt install tcpdump net-tools -y"

docker exec cilium-lab-worker2 tcpdump -i eth0 -n -v udp port 8472 -c 4 -X
worker2 노드에 tcpdump와 net-tools를 설치하고 VXLAN 패킷을 캡처한다. 새 터미널을 열어 worker2에 배포된 파드로 패킷을 보낸다.
kubectl exec netshoot-7b776d8bd4-f6qxd -- ping -c 1 10.244.2.42
tcpdump: listening on eth0, link-type EN10MB (Ethernet), snapshot length 262144 bytes
13:24:02.898286 IP (tos 0x0, ttl 64, id 47173, offset 0, flags [none], proto UDP (17), length 134)
    172.18.0.3.53143 > 172.18.0.4.8472: OTV, flags [I] (0x08), overlay 0, instance 15160
IP (tos 0x0, ttl 64, id 17056, offset 0, flags [DF], proto ICMP (1), length 84)
    10.244.1.182 > 10.244.2.42: ICMP echo request, id 3, seq 1, length 64
    0x0000:  4500 0086 b845 0000 4011 69f6 ac12 0003  E....E..@.i.....
    0x0010:  ac12 0004 cf97 2118 0072 0000 0800 0000  ......!..r......
    0x0020:  003b 3800 562e 4db8 a408 9263 a177 d84d  .;8.V.M....c.w.M
    0x0030:  0800 4500 0054 42a0 4000 4001 de41 0af4  ..E..TB.@.@..A..
    0x0040:  01b6 0af4 022a 0800 155d 0003 0001 72ad  .....*...]....r.
    0x0050:  686a 0000 0000 3bb4 0d00 0000 0000 1011  hj....;.........
    0x0060:  1213 1415 1617 1819 1a1b 1c1d 1e1f 2021  ...............!
    0x0070:  2223 2425 2627 2829 2a2b 2c2d 2e2f 3031  "#$%&'()*+,-./01
    0x0080:  3233 3435 3637                           234567

13:24:02.898448 IP (tos 0x0, ttl 64, id 18887, offset 0, flags [none], proto UDP (17), length 134)
    172.18.0.4.53143 > 172.18.0.3.8472: OTV, flags [I] (0x08), overlay 0, instance 15160
IP (tos 0x0, ttl 64, id 12604, offset 0, flags [none], proto ICMP (1), length 84)
    10.244.2.42 > 10.244.1.182: ICMP echo reply, id 3, seq 1, length 64
    0x0000:  4500 0086 49c7 0000 4011 d874 ac12 0004  E...I...@..t....
    0x0010:  ac12 0003 cf97 2118 0072 0000 0800 0000  ......!..r......
    0x0020:  003b 3800 526f 9d02 2317 4e36 b785 b744  .;8.Ro..#.N6...D
    0x0030:  0800 4500 0054 313c 0000 4001 2fa6 0af4  ..E..T1<..@./...
    0x0040:  022a 0af4 01b6 0000 1d5d 0003 0001 72ad  .*.......]....r.
    0x0050:  686a 0000 0000 3bb4 0d00 0000 0000 1011  hj....;.........
    0x0060:  1213 1415 1617 1819 1a1b 1c1d 1e1f 2021  ...............!
    0x0070:  2223 2425 2627 2829 2a2b 2c2d 2e2f 3031  "#$%&'()*+,-./01
    0x0080:  3233 3435 3637                           23456
이렇게 패킷을 캡처해서 볼 수 있다. 바깥 헤더는 172.18.0.3 → 172.18.0.4(노드 IP 간 통신)이고, 그 안에 10.244.1.182 → 10.244.2.42가 캡슐화돼 들어 있다. tcpdump가 이 패킷을 VXLAN이 아니라 OTV 프로토콜로 해석한 이유는, 표준 VXLAN 포트가 4789인 데 반해 Cilium은 8472를 사용하기 때문이다. VXLAN의 VNI 필드 위치인 0x0020: 003b 38 부분에 Identity 값이 실려 있는 것도 확인할 수 있다.
VXLAN의 구조는 바깥 IP 헤더(20바이트) + UDP 헤더(8바이트) + VXLAN 헤더(8바이트)로 이뤄진다. 즉 노드 간 VXLAN 통신으로 패킷이 전달되는 과정을 직접 캡처로 확인한 사례다.
Tip) Overlay Network는 UDP인데도 패킷이 손실되어도 괜찮은 이유가 있다. VXLAN을 주고받는 노드들은 실질적으로 End to End에서 패킷을 주고받는 구조가 아니기 때문에, 유실이 발생해도 처음 패킷을 보낸 종단에서 재전송을 담당한다. 다만 이는 TCP에 한정된 이야기다.
IP Address Management (IPAM)
IP 주소 관리(IPAM)는 Cilium이 관리하는 네트워크 엔드포인트(컨테이너 등)에 IP 주소를 할당하고 관리하는 역할을 한다. 대표적으로 Kubernetes Host Scope, Cluster Scope, Multi-Pool 세 가지 모드가 있으며, 관리 주체나 범위에 차이가 있을 뿐 공통적으로 IP 할당 방식을 설정한다는 목적은 같다.
Cluster Scope
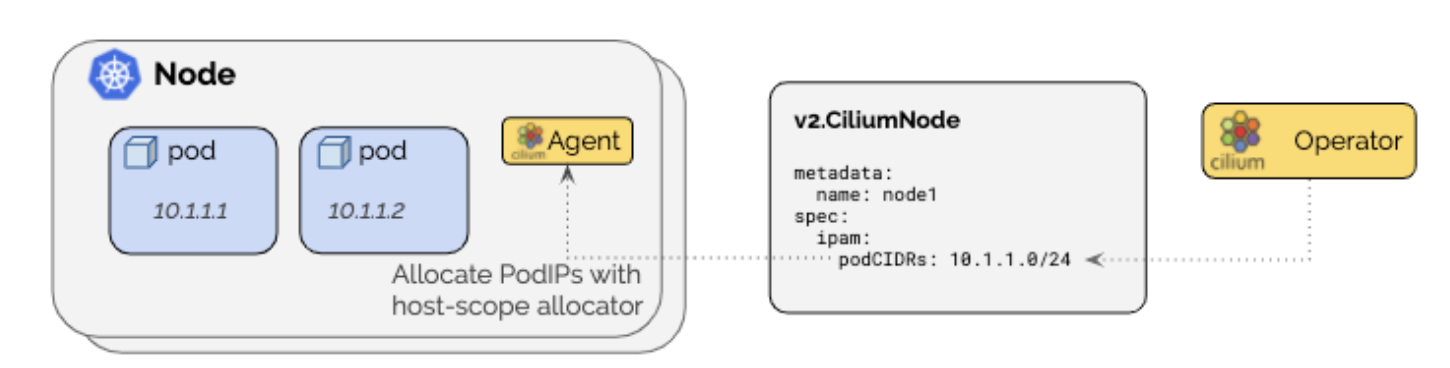
클러스터 범위 IPAM 모드는 각 노드에 노드별 PodCIDR을 할당하고, 각 노드에서 호스트 범위 할당자로 IP를 나눠준다. 쿠버네티스 리소스로 노드별 PodCIDR을 할당하는 Kubernetes Host Scope와 달리, 이 모드에서는 Cilium 오퍼레이터가 리소스를 통해 노드별 PodCIDR을 직접 관리한다. 즉 Cilium-Operator가 전체 IP 풀을 들고 있다가 노드마다 /24씩 떼어주는 방식이며, 할당 주체는 Cilium이다.
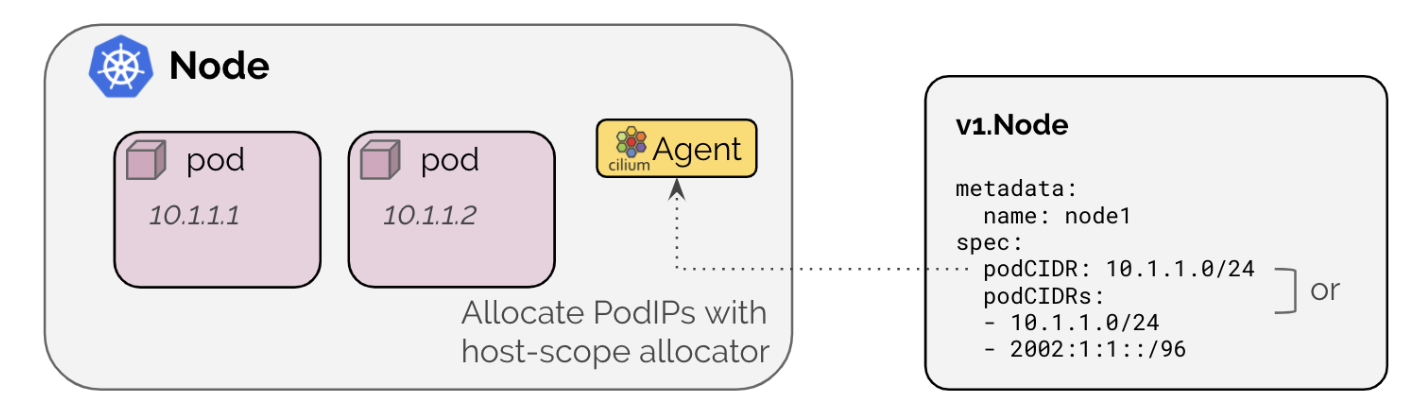
Kubernetes Host Scope
클러스터의 각 노드에 개별적으로 주소 할당이 위임된다. IP 주소는 쿠버네티스가 각 노드에 부여한 범위 안에서 할당된다. 즉 쿠버네티스 자체가 노드별 CIDR을 정하는 방식으로, 구체적으로는 kube-controller-manager의 --allocate-node-cidrs 옵션이 각 노드 오브젝트의 .spec.PodCIDR에 /24를 기록하면 cilium-agent가 이 값을 읽어 자기 노드의 파드 IP를 나눠준다. 할당 주체는 쿠버네티스다.
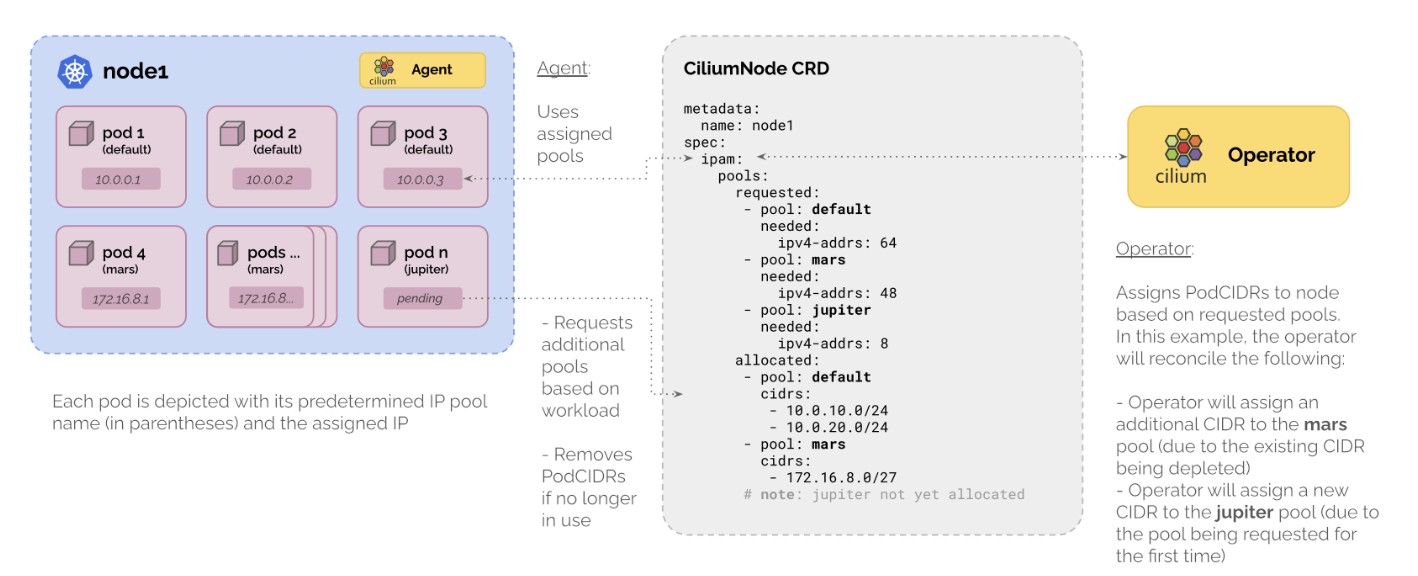
Multi-Pool
멀티풀 IPAM 모드는 사용자가 정의한 워크로드 주석과 노드 레이블에 따라 여러 개의 서로 다른 IPAM 풀에서 PodCIDR을 할당할 수 있도록 지원한다.
# 각 노드에 할당된 pod CIDR 확인
kubectl get ciliumnode -o custom-columns='NODE:.metadata.name,POD_CIDRS:.spec.ipam.podCIDRs,NODE_IP:.spec.addresses'

NODE                       POD_CIDRS         NODE_IP
cilium-lab-control-plane   [10.244.0.0/24]   [map[ip:172.18.0.2 type:InternalIP] map[ip:10.244.0.133 type:CiliumInternalIP]]
cilium-lab-worker          [10.244.1.0/24]   [map[ip:172.18.0.3 type:InternalIP] map[ip:10.244.1.210 type:CiliumInternalIP]]
cilium-lab-worker2         [10.244.2.0/24]   [map[ip:172.18.0.4 type:InternalIP] map[ip:10.244.2.243 type:CiliumInternalIP]]
각 노드의 POD_CIDRS를 보면 control-plane은 10.244.0.0/24, cilium-lab-worker는 10.244.1.0/24, cilium-lab-worker2는 10.244.2.0/24를 사용하고 있다.
kubectl get ciliumnode cilium-lab-worker -o yaml | grep -A 30 "spec:"
이 명령어로 cilium-lab-worker의 IPAM 정보를 좀 더 상세히 확인할 수 있다.
spec:
  addresses:
  - ip: 172.18.0.3
    type: InternalIP
  - ip: 10.244.1.210
    type: CiliumInternalIP
  alibaba-cloud: {}
  azure: {}
  bootid: c37ca258-6783-4afa-ba89-58a71d8a6e0c
  encryption: {}
  eni: {}
  health:
    ipv4: 10.244.1.152
  ingress: {}
  ipam:
    podCIDRs:
    - 10.244.1.0/24
    pools: {}
kubectl -n kube-system get cm cilium-config -o yaml | grep -iE "^  ipam|cluster-pool"

ipam: kubernetes
ipam-cilium-node-update-rate: 15s
이 명령어로 현재 클러스터가 어떤 IPAM 모드를 쓰는지 확인할 수 있다. 지금은 ipam: kubernetes인데, 이를 Cluster Scope 모드로 바꾸려면 공식 문서에서도 마이그레이션보다는 클러스터를 다시 만드는 방법을 권장하고 있다.
# IPAM을 Cluster Scope 모드로 설치
cilium install --version 1.19.5 \
  --set ipam.mode=cluster-pool \
  --set ipam.operator.clusterPoolIPv4PodCIDRList='{10.244.0.0/16}' \
  --set ipam.operator.clusterPoolIPv4MaskSize=24
실습을 위해 기존 클러스터를 삭제하고 다시 만든다.
kind delete cluster -n cilium-lab
kind create cluster --config ./kind/kind-cilium.yaml

# IPAM을 Cluster Scope 모드로 설치
cilium install --version 1.19.5 \
  --set ipam.mode=cluster-pool \
  --set ipam.operator.clusterPoolIPv4PodCIDRList='{10.244.0.0/16}' \
  --set ipam.operator.clusterPoolIPv4MaskSize=24

# 정상 상태까지 대기
cilium status --wait
kubectl -n kube-system get cm cilium-config -o yaml | grep -iE "^  ipam|cluster-pool"

cluster-pool-ipv4-cidr: 10.244.0.0/16
cluster-pool-ipv4-mask-size: "24"
ipam: cluster-pool
ipam-cilium-node-update-rate: 15s
이것으로 IPAM 모드를 Cluster Scope, 즉 cluster-pool 모드로 전환했다.
cluster-pool-ipv4-cidr: 전체 IP 풀이다.cluster-pool-ipv4-mask-size: 노드당 잘라줄 서브넷 크기다(기본값 24, 노드당 254개 파드 IP를 보유할 수 있다). 값을 바꾸면 노드당 254개 이상의 파드 IP를 할당할 수도 있다.
IPAM spec을 좀 더 상세히 확인해본다.
kubectl get ciliumnode cilium-lab-worker -o yaml | grep -A 30 "spec:"
spec:
  addresses:
  - ip: 172.18.0.2
    type: InternalIP
  - ip: 10.244.0.152
    type: CiliumInternalIP
  alibaba-cloud: {}
  azure: {}
  bootid: c37ca258-6783-4afa-ba89-58a71d8a6e0c
  encryption: {}
  eni: {}
  health:
    ipv4: 10.244.0.163
  ingress: {}
  ipam:
    podCIDRs:
    - 10.244.0.0/24
    pools: {}
status:
  alibaba-cloud: {}
  azure: {}
  eni: {}
  ipam:
    operator-status: {}
이번 실습에서는 다루지 않지만, multi-pool 모드까지 운용해보고 싶다면 아래 명령어로 설치할 수 있다.
cilium install --version 1.19.5 \
  --set ipam.mode=multi-pool \
  --set kubeProxyReplacement=true \
  --set bpf.masquerade=true \
  --set ipam.operator.autoCreateCiliumPodIPPools.default.ipv4.cidrs='{10.100.0.0/16}' \
  --set ipam.operator.autoCreateCiliumPodIPPools.default.ipv4.maskSize=24
이렇게 설치하면 아래처럼 풀 구조를 확인할 수 있다.
kubectl get ciliumnode -o yaml | grep -A12 "ipam:"

ipam:
  pools:
    allocated:
    - cidrs:
      - 10.100.0.0/24
      pool: default
    requested:
    - needed:
        ipv4-addrs: 16
      pool: default
- apiVersion: cilium.io/v2
kind: CiliumNode
metadata:
--
ipam:
  pools:
    allocated:
    - cidrs:
      - 10.100.1.0/24
      pool: default
    requested:
    - needed:
        ipv4-addrs: 16
      pool: default
multi-pool은 왜 존재하는가 — 왜 IP 풀을 여러 개 두고 싶은가
이름 붙은 풀을 여러 개 두고, 파드나 네임스페이스별로 “너는 이 풀에서 IP를 받아라”라고 지정할 수 있다는 것이 핵심이다. pools.allocated를 보면 노드가 어느 풀에서 무엇을 할당받았는지 추적할 수 있다. 특정 네임스페이스에 ipam.cilium.io/ip-pools=mars 같은 Annotation을 달아 풀을 지정하는 방식이다.
이 방식을 쓰면 특정 워크로드에만 외부 라우팅을 허용하는 식의 구성도 가능해진다. 다만 multi-pool 방식은 기존 IPTables 방식과 완전히 호환되지는 않기 때문에, eBPF masquerade를 쓰거나 egressMasqueradeInterfaces 설정을 추가로 해줘야 한다.
Network Policy
지금까지는 주로 Identity와 Endpoint 같은 개념을 익혔다. 이제는 실제로 Identity 기반 네트워크 정책으로 트래픽을 제어하는 실습을 진행한다.
클러스터를 재생성하면서 지워졌던 netshoot deployment를 다시 배포한다.
# netshoot pod 배포
kubectl create deployment netshoot --image=nicolaka/netshoot -- sleep infinity

# ds replicas 2로 설정
kubectl scale deployment netshoot --replicas=2
kubectl get pods -o wide

NAME                        READY   STATUS    RESTARTS   AGE   IP             NODE
netshoot-6b9fb7848f-42wlq   1/1     Running   0          54s   10.244.2.194   cilium-lab-worker2
netshoot-6b9fb7848f-6r25s   1/1     Running   0          54s   10.244.0.71    cilium-lab-worker
배포한 파드 정보를 확인하고, 각각의 endpoint와 identity도 확인한다.
# worker에 배포된 cilium-xrxqf
kubectl exec -n kube-system cilium-xrxqf -- cilium endpoint list

ENDPOINT   POLICY (ingress)   POLICY (egress)   IDENTITY   LABELS (source:key[=value])
1324       Disabled           Disabled          64347      k8s:app=netshoot

# worker2에 배포된 cilium-wghmx
kubectl exec -n kube-system cilium-wghmx -- cilium endpoint list

ENDPOINT   POLICY (ingress)   POLICY (egress)   IDENTITY   LABELS (source:key[=value])
162        Disabled           Disabled          64347      k8s:app=netshoot
각각 endpoint는 1324, 162이고 Identity는 둘 다 64347이다.
# deny.yaml
apiVersion: cilium.io/v2
kind: CiliumNetworkPolicy
metadata:
  name: netshoot-deny-ingress
spec:
  endpointSelector:
    matchLabels:
      app: netshoot # identity 64347을 만드는 라벨
  ingress:
    - fromEndpoints:
      - matchLabels:
          app: nothing
위와 같은 형식으로 CiliumNetworkPolicy를 만든다. endpointSelector.matchLabels에 해당하는 Endpoint는 ingress.fromEndpoints.matchLabels에 해당하는 Identity로부터만 트래픽을 받을 수 있다는 뜻이다. 이를 deny.yaml로 저장하고 적용한다.
kubectl apply -f deny.yaml

# 적용된 CiliumNetworkPolicy 확인
kubectl get cnp -o wide

NAME                    AGE   VALID
netshoot-deny-ingress   11s   True
정책이 정상적으로 적용된 것을 확인했다. 이제 worker 노드의 파드에서 worker2 노드의 파드로 PING을 보내면 어떻게 되는지 확인해본다.
# worker2의 파드로 전송
kubectl exec netshoot-6b9fb7848f-6r25s -- ping -c 1 10.244.2.194
# worker2의 cilium-wghmx에서 monitor 명령어 실행. 162는 해당 노드에 배포된 파드(netshoot)의 endpoint
kubectl exec -n kube-system cilium-wghmx -- cilium monitor --related-to 162
이번에도 cilium monitor 명령어로 DROP 관련 이벤트를 확인해본다.
time=2026-07-29T12:45:25.885653625Z level=info msg="Initializing dissection cache..."
Policy verdict log: flow 0x0 local EP ID 162, remote ID 64347, proto 1, ingress, action deny, auth: disabled, match none, 10.244.0.71 -> 10.244.2.194 icmp EchoRequest

xx drop (Policy denied) flow 0x0 to endpoint 162, ifindex 14, file bpf_lxc.c:2405, , identity 64347->64347: 10.244.0.71 -> 10.244.2.194 icmp EchoRequest
로그를 풀어보면 “remote ID 64347 Identity로부터 ingress 요청이 왔지만 action deny로 거절했다. 그 결과 xx drop (Policy denied) to endpoint 162, 즉 정책에 의해 드롭됐고 이 트래픽은 endpoint 162로 향하던 것이었다”는 내용이다. bpf policy map을 조회하면 실제로 어떤 정책 맵을 참조했는지도 확인할 수 있다.
# endpoint 162에 대한 policy eBPF 맵 참조
kubectl exec -n kube-system cilium-wghmx -- cilium bpf policy get 162

POLICY   DIRECTION   LABELS (source:key[=value])   PORT/PROTO   PROXY PORT   AUTH TYPE
Allow    Ingress     reserved:host                 ANY          NONE         disabled
Allow    Egress      ANY                           ANY          NONE         disabled
ingress 허용 목록을 보면 ANY는 없고 오직 reserved:host만 허용돼 있다. 즉 자신이 속한 호스트로부터 오는 트래픽만 받겠다는 뜻이다. 반면 밖으로 나가는 egress 트래픽에는 별도의 제한이 없다.
# CiliumNetworkPolicy로 등록한 리소스 삭제
kubectl delete cnp netshoot-deny-ingress
실습이 끝나면 정책을 삭제한다. 여기까지가 Identity 기반 네트워크 정책 실습이다.
Kube-Proxy Replacement & Load Balancing
지금까지는 비교적 가벼운 내용을 다뤘다면, 이번 챕터는 조금 더 무거운 내용을 다룬다. 지금까지의 실습에서는 Cilium을 쓰면서도 kube-proxy를 그대로 두고 IPTables를 함께 사용해왔다. 이 구조에서는 Service(ClusterIP)라는 가상 IP, 예를 들어 10.96.X.X 같은 주소를 사용한다. 이 가상 IP를 실제 백엔드 IP로 바꾸는 작업을 IPTables가 담당하는데, 이는 여러 체인으로 구성돼 있고 탐색 방식이 선형적이다. 그래서 체인이 늘어날수록(서비스가 많아질수록) 성능이 떨어진다. Cilium은 이 부분을 cilium-agent와 eBPF로 대체한다. 먼저 기존 kube-proxy와 IPTables가 어떻게 동작하는지부터 확인해본다.
앞서 설명한 대로 kube-proxy는 가상 IP를 파드 IP로 바꿀 때 아래와 같은 IPTables 규칙 체인을 사용한다.
KUBE-SERVICES: 목적지가 ClusterIP인 패킷만 잡아내는 체인이다.KUBE-SVC-XXXX(서비스별 체인) : 백엔드 중 하나를 확률적으로 고른다. (-m statistic --mode random --probability 0.333...)KUBE-SEP-XXXX(엔드포인트별 체인) : 실제 파드 IP로DNAT한다.
netshoot deployment용 Service를 만들고 실제 노드에서 IPTables를 확인해본다.
# netshoot을 가리키는 ClusterIP 서비스 생성
kubectl expose deployment netshoot --port=80 --target-port=80 --name=netshoot-svc

# 방금 만든 서비스 검색
kubectl get svc

NAME           TYPE        CLUSTER-IP     EXTERNAL-IP   PORT(S)   AGE
kubernetes     ClusterIP   10.96.0.1      <none>        443/TCP   23h
netshoot-svc   ClusterIP   10.96.190.56   <none>        80/TCP    9s
가상 IP 10.96.190.56을 가진 서비스가 만들어졌다.
docker exec cilium-lab-worker iptables-save -t nat 2>/dev/null | grep -iE "10.96.190.56|netshoot-svc" | head -20

-A KUBE-SEP-B2XTYZ3IMZ7Q3U3U -s 10.244.2.194/32 -m comment --comment "default/netshoot-svc" -j KUBE-MARK-MASQ
-A KUBE-SEP-B2XTYZ3IMZ7Q3U3U -p tcp -m comment --comment "default/netshoot-svc" -m tcp -j DNAT --to-destination 10.244.2.194:80
-A KUBE-SEP-IB7LRUT54SL5PMFQ -s 10.244.0.71/32 -m comment --comment "default/netshoot-svc" -j KUBE-MARK-MASQ
-A KUBE-SEP-IB7LRUT54SL5PMFQ -p tcp -m comment --comment "default/netshoot-svc" -m tcp -j DNAT --to-destination 10.244.0.71:80
-A KUBE-SERVICES -d 10.96.190.56/32 -p tcp -m comment --comment "default/netshoot-svc cluster IP" -m tcp --dport 80 -j KUBE-SVC-RCAXWRJ4Y75BAX5N
-A KUBE-SVC-RCAXWRJ4Y75BAX5N ! -s 10.244.0.0/16 -d 10.96.190.56/32 -p tcp -m comment --comment "default/netshoot-svc cluster IP" -m tcp --dport 80 -j KUBE-MARK-MASQ
-A KUBE-SVC-RCAXWRJ4Y75BAX5N -m comment --comment "default/netshoot-svc -> 10.244.0.71:80" -m statistic --mode random --probability 0.50000000000 -j KUBE-SEP-IB7LRUT54SL5PMFQ
-A KUBE-SVC-RCAXWRJ4Y75BAX5N -m comment --comment "default/netshoot-svc -> 10.244.2.194:80" -j KUBE-SEP-B2XTYZ3IMZ7Q3U3U
생성된 서비스 IP를 기준으로 관련 IPTables를 뽑아보면 위와 같은 체인이 형성된다. 패킷이 ClusterIP 10.96.190.56에 도착했을 때를 가정하고 하나씩 짚어본다.
1단계
-A KUBE-SERVICES -d 10.96.190.56/32 -p tcp -m comment --comment "default/netshoot-svc cluster IP" -m tcp --dport 80 -j KUBE-SVC-RCAXWRJ4Y75BAX5N
목적지가 ClusterIP(10.96.190.56):80인 패킷을 잡아 서비스 전용 체인(KUBE-SVC-RCAX...)으로 보낸다. 서비스 하나당 이런 진입 규칙이 하나씩 생긴다.
2단계
-A KUBE-SVC-RCAXWRJ4Y75BAX5N -m comment --comment "default/netshoot-svc -> 10.244.0.71:80" -m statistic --mode random --probability 0.50000000000 -j KUBE-SEP-IB7LRUT54SL5PMFQ

-A KUBE-SVC-RCAXWRJ4Y75BAX5N -m comment --comment "default/netshoot-svc -> 10.244.2.194:80" -j KUBE-SEP-B2XTYZ3IMZ7Q3U3U
statistic 모드는 매 연결(또는 새 요청)마다 백엔드를 독립적으로 랜덤 선택하기 때문에 backend affinity가 약하다. 반면 Cilium의 Maglev는 Consistent hashing 기반으로 백엔드를 선택해, 백엔드가 추가되거나 삭제되더라도 대부분의 flow가 기존과 같은 백엔드로 매핑되도록 재매핑을 최소화한다. 다만 첫 번째 패킷은 IPTables 규칙을 거쳐 DNAT되고, 이후 같은 연결의 패킷은 conntrack 정보로 처리된다.
3단계
-A KUBE-SEP-B2XTYZ3IMZ7Q3U3U -s 10.244.2.194/32 -m comment --comment "default/netshoot-svc" -j KUBE-MARK-MASQ

-A KUBE-SEP-B2XTYZ3IMZ7Q3U3U -p tcp -m comment --comment "default/netshoot-svc" -m tcp -j DNAT --to-destination 10.244.2.194:80
가상의 Cluster IP를 실제 파드 IP(10.244.2.194/32)로 바꾸는 DNAT 과정이다. 즉 서비스(IP)가 백엔드 IP로 변환되는 단계다. 흥미로운 부분은 KUBE-MARK-MASQ로 자기 자신에 대한 규칙이 별도로 존재한다는 점인데, 이는 서비스에 연결한 자신이 다시 자기 자신에게 선택되는 hairpin 상황을 정상적으로 처리하기 위한 것이다. 결국 IPTables는 커널 netfilter가 KUBE-SERVICES → KUBE-SVC → KUBE-SEP → DNAT 순서로 패킷을 처리하는 구조이고, 이 작업이 선형적이기 때문에 시간복잡도는 O(n)이다. cilium-agent와 eBPF는 이를 Socket LB로 대체한다.
kube-proxy 대체하기
앞서 설명한 대로 현재 클러스터에는 여전히 kube-proxy가 설치돼 있다. 이를 제거하고 cilium-agent와 eBPF로 대체한다.
# 쿠버네티스 API 서버 확인
kubectl -n kube-system get cm kubeadm-config -o yaml 2>/dev/null | grep -i "controlPlaneEndpoint"

# cilium helm repo 추가
helm repo add cilium https://helm.cilium.io/ 2>/dev/null; helm repo update

# replacement + eBPF masquerade로 업그레이드
helm upgrade cilium cilium/cilium --version 1.19.5 \
  --namespace kube-system \
  --reuse-values \
  --set kubeProxyReplacement=true \
  --set bpf.masquerade=true \
  --set k8sServiceHost=cilium-lab-control-plane \
  --set k8sServicePort=6443

# cilium 재시작 대기
kubectl -n kube-system rollout restart ds/cilium
kubectl -n kube-system rollout status ds/cilium --timeout=120s

# kube-proxy 제거
kubectl -n kube-system delete ds kube-proxy
kubectl -n kube-system delete cm kube-proxy

# 기존 kube-proxy iptables 규칙 청소 (각 노드에서)
for node in $(kubectl get nodes -o jsonpath='{.items[*].metadata.name}'); do
  echo "=== cleaning $node ==="
  docker exec $node iptables-save 2>/dev/null | grep -v KUBE | docker exec -i $node iptables-restore 2>/dev/null || echo "  (수동 청소 필요할 수 있음)"
done
이 과정으로 cilium을 helm으로 재설치하고, kube-proxy를 제거한 뒤 남아있는 기존 규칙까지 정리할 수 있다. 이제 상태를 다시 확인해본다.
kubectl -n kube-system exec ds/cilium -- cilium status --verbose | grep -iE "KubeProxyReplacement|Routing|Masquerading"

KubeProxyReplacement:   True   [eth0    172.18.0.4 fc00:f853:ccd:e793::4 fe80::e4db:6aff:fe0f:c6a9 (Direct Routing)]
Routing:                Network: Tunnel [vxlan]   Host: BPF
Masquerading:           BPF   [eth0]   10.244.2.0/24  [IPv4: Enabled, IPv6: Disabled]
KubeProxyReplacement Details:
  Devices:              eth0    172.18.0.4 fc00:f853:ccd:e793::4 fe80::e4db:6aff:fe0f:c6a9 (Direct Routing)
  IPv4 masquerading agent       16384
  IPv6 masquerading agent       16384
KubeProxyReplacement: True와 Routing: Network: Tunnel [vxlan] Host: BPF를 통해 cilium-agent와 eBPF로 kube-proxy를 완전히 대체한 것을 확인할 수 있다. (Direct Routing)은 Cilium이 노드 NIC(eth0)에 직접 LB 프로그램을 붙여 NodePort와 외부 트래픽을 처리한다는 뜻이고, Masquerading: BPF [eth0] 10.244.0.0/24는 SNAT 대상 대역까지 eBPF가 알고 있다는 뜻이다.
kubectl exec netshoot-6b9fb7848f-6r25s -- ping -c 1 10.244.2.194

PING 10.244.2.194 (10.244.2.194) 56(84) bytes of data.
64 bytes from 10.244.2.194: icmp_seq=1 ttl=63 time=1.38 ms

--- 10.244.2.194 ping statistics ---
1 packets transmitted, 1 received, 0% packet loss, time 0ms
rtt min/avg/max/mdev = 1.376/1.376/1.376/0.000 ms
통신도 정상적으로 동작한다. 이렇게 기존 클러스터에서 업그레이드하는 방식도 가능하지만, 처음부터 kube-proxy를 아예 없애고 시작하려면 아래처럼 클러스터를 구성해야 한다.
# kind-ebpf.yaml
kind: Cluster
apiVersion: kind.x-k8s.io/v1alpha4
name: cilium-lab
networking:
  disableDefaultCNI: true
  kubeProxyMode: none     # kube-proxy 삭제
nodes:
  - role: control-plane
  - role: worker
  - role: worker
kind delete cluster -n cilium-lab
kind create cluster --config ./kind-ebpf.yaml
위 yaml로 클러스터를 다시 만든다.
# helm으로 cilium 배포
helm upgrade --install cilium cilium/cilium --version 1.19.5 \
  --namespace kube-system \
  --set kubeProxyReplacement=true \
  --set bpf.masquerade=true \
  --set k8sServiceHost=cilium-lab-control-plane \
  --set k8sServicePort=6443

# 정상설치까지 대기
cilium status --wait

# netshoot 디플로이먼트 및 서비스 배포
kubectl create deployment netshoot --image=nicolaka/netshoot -- sleep 3600
kubectl scale deployment netshoot --replicas=2
kubectl expose deployment netshoot --port=80 --target-port=80 --name=netshoot-svc
helm으로 cilium을 배포하고 netshoot도 앞서와 동일하게 배포한다.
Cilium은 kube-proxy가 안고 있던 문제를 앞서 설명한 대로 eBPF로 풀어낸다. Cilium은 이를 Socket-Based Loadbalancing이라 부른다. 원리는 비교적 단순하다.
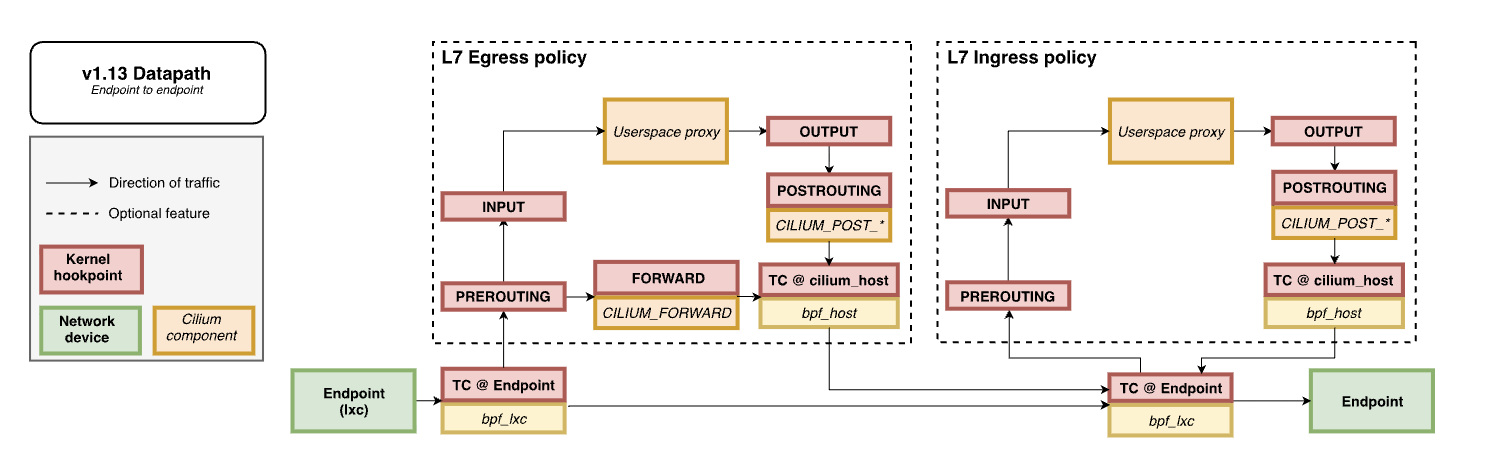
파드 A가 서비스 IP로 connect 함수를 호출하면, cgroup/connect에 부착된 eBPF 프로그램이 이 호출을 가로챈다. 이 프로그램은 서비스맵과 백엔드맵을 조회해서 연결하려는 서비스 IP가 어떤 백엔드 IP와 연결돼 있는지 확인한 뒤 그 백엔드 IP를 돌려준다. 즉 connect를 호출한 시점에 돌려받은 백엔드 IP로 곧바로 연결할 수 있게 된다.
connect(Service IP)를 요청하면 내부에서 후킹된 eBPF 프로그램이 이를 connect(Backend IP)로 바꿔 실제 백엔드 파드로 연결 요청을 보낸다. 이는 TCP의 사례이고, UDP라면 recvmsg와 sendmsg를 후킹해 처리한다. 그렇다면 getpeername을 호출하면 백엔드 IP가 그대로 나올까. 그렇지 않다. 이때도 후킹된 eBPF 프로그램이 맵을 참조해 처음 연결하려던 서비스 IP를 그대로 돌려준다. 즉 중간에 IPTables를 거치지 않고도 파드에서 파드로 직접 연결되는 구조가 완성된다.
앞서 언급한 서비스맵을 직접 확인해본다.
# Cilium의 서비스 LB 테이블 (kube-proxy iptables의 eBPF 대체물)
kubectl -n kube-system exec ds/cilium -- cilium service list

ID   Frontend              Service Type   Backend
1    10.96.66.12:443/TCP   ClusterIP      1 => 172.18.0.4:4244/TCP (active)
6    10.96.57.113:80/TCP   ClusterIP      1 => 10.0.0.203:80/TCP (active)
                                          2 => 10.0.2.143:80/TCP (active)
Frontend는 서비스 IP, Backend는 연결된 파드 IP를 의미한다. 좀 더 raw하게 실제 eBPF 맵을 보고 싶다면 아래 명령어로 확인할 수 있다.
SERVICE ADDRESS           BACKEND ADDRESS (REVNAT_ID) (SLOT)
10.96.57.113:0/ANY (0)    0.0.0.0:0 (0) (0) [ClusterIP, non-routable]
10.96.57.113:80/TCP (1)   10.0.0.203:80/TCP (6) (1)
10.96.57.113:80/TCP (2)   10.0.2.143:80/TCP (6) (2)
여기서 (0)은 마스터 엔트리로 이 서비스에 백엔드가 몇 개 있는지를 나타낸다. (6)은 REVNAT_ID로 서비스 고유 ID다. 다만 이 값이 실제로 쓰이는 경우는 socket LB가 아니라 tc 계층에서 DNAT가 발생하는 경로다. socket LB는 패킷 주소 자체를 바꾸지 않으므로 되돌릴 것이 없고, 실제로 이 경로의 conntrack 엔트리는 RevNAT=0이다. REVNAT_ID는 다음 편에서 다룰 NodePort나 외부 트래픽에서 응답 소스를 프론트엔드로 복원할 때 사용된다.
정리하면, 파드 안에서 curl http://10.96.57.113을 실행하면 서비스맵과 백엔드맵을 조회해 커널에 아래처럼 요청하는 구조다.
connect(소켓, 목적지 = 10.0.0.203:80)
이 시점에 커널은 소켓 구조체를 만든다.
TCPDUMP로 검증하기
지금까지는 socket LB에 대한 이론적인 설명이었다. 실제로도 그렇게 동작하는지 tcpdump로 패킷을 캡처해서 검증해본다.
kubectl get pod -o wide

NAME                        READY   STATUS    RESTARTS   AGE   IP           NODE
netshoot-7b776d8bd4-nrh8b   1/1     Running   0          55m   10.0.2.143   cilium-lab-worker
netshoot-7b776d8bd4-wlsk9   1/1     Running   0          55m   10.0.0.203   cilium-lab-worker2

kubectl get svc

NAME           TYPE        CLUSTER-IP     EXTERNAL-IP   PORT(S)   AGE
kubernetes     ClusterIP   10.96.0.1      <none>        443/TCP   71m
netshoot-svc   ClusterIP   10.96.57.113   <none>        80/TCP    58m
cilium-lab-worker에 배포된 netshoot-7b776d8bd4-nrh8b에서 서비스 IP로 접근해 cilium-lab-worker2에 배포된 netshoot-7b776d8bd4-wlsk9로 패킷이 가는 과정을 확인한다. cilium-lab-worker2에서는 tcpdump로 패킷을 캡처한다.
먼저 양쪽 파드에 80번 포트로 열리는 웹서버를 띄운다.
for p in $(kubectl get pod -l app=netshoot -o jsonpath='{.items[*].metadata.name}'); do
  kubectl exec $p -- sh -c "nohup python3 -m http.server 80 >/dev/null 2>&1 &"
done
sleep 2
kubectl exec netshoot-7b776d8bd4-nrh8b -- curl netshoot-svc:80
kubectl exec netshoot-7b776d8bd4-wlsk9 -- tcpdump -i eth0 -n "tcp port 80"

# 패킷 캡처 결과
tcpdump: verbose output suppressed, use -v[v]... for full protocol decode
listening on eth0, link-type EN10MB (Ethernet), snapshot length 262144 bytes
15:38:03.867911 IP 10.0.2.143.40988 > 10.0.0.203.80: Flags [S], seq 2127037688, win 65430, options [mss 65430,sackOK,TS val 4145815494 ecr 0,nop,wscale 7], length 0
15:38:03.868799 IP 10.0.0.203.80 > 10.0.2.143.40988: Flags [S.], seq 656770761, ack 2127037689, win 65418, options [mss 65430,sackOK,TS val 3620275175 ecr 4145815494,nop,wscale 7], length 0
15:38:03.868823 IP 10.0.2.143.40988 > 10.0.0.203.80: Flags [.], ack 1, win 512, options [nop,nop,TS val 4145815495 ecr 3620275175], length 0
15:38:03.869493 IP 10.0.2.143.40988 > 10.0.0.203.80: Flags [P.], seq 1:77, ack 1, win 512, options [nop,nop,TS val 4145815496 ecr 3620275175], length 76: HTTP: GET / HTTP/1.1
15:38:03.869661 IP 10.0.0.203.80 > 10.0.2.143.40988: Flags [.], ack 77, win 511, options [nop,nop,TS val 3620275176 ecr 4145815496], length 0
15:38:03.878526 IP 10.0.0.203.80 > 10.0.2.143.40988: Flags [P.], seq 1:156, ack 77, win 512, options [nop,nop,TS val 3620275185 ecr 4145815496], length 155: HTTP: HTTP/1.0 200 OK
15:38:03.878550 IP 10.0.2.143.40988 > 10.0.0.203.80: Flags [.], ack 156, win 511, options [nop,nop,TS val 4145815505 ecr 3620275185], length 0
15:38:03.878742 IP 10.0.0.203.80 > 10.0.2.143.40988: Flags [
worker1 노드에서는 분명 서비스 IP(10.96.57.113)로 curl을 실행했지만, 캡처된 패킷에는 10.0.2.143.40988 > 10.0.0.203.80처럼 서비스 IP가 등장하지 않고 백엔드 IP만 보인다. 이는 앞서 설명한 cgroup/connect 후킹 단계에서 이미 서비스 IP가 백엔드 IP로 대체됐다는 것을 패킷으로 직접 보여주는 결과다. 정리하면 Cilium socket LB는 다음과 같은 순서로 동작한다.
connect(10.96.57.113:80)— 애플리케이션이 요청한다.- cgroup에 붙은 eBPF가 이
connect()시스템콜을 가로챈다. - eBPF 맵을 조회한다:
10.96.57.113:80의 백엔드는 무엇인가. - 답을 받는다:
10.0.0.203:80. - 소켓에 기록될 목적지를 아예 바꿔치기한다:
10.0.0.203:80. - 커널이 소켓에 “목적지 = 10.0.0.203:80″을 기록한다.
- 패킷이 처음부터 백엔드를 향해 생성된다(출발:
10.0.2.143.40988 > 10.0.0.203.80). - 별도의 DNAT 과정이 없다.
Socket LB eBPF 소스코드 확인
tcpdump로 패킷을 캡처해 실제 동작을 확인했다면, 이번에는 cilium의 eBPF 소스코드를 기준으로 분석해본다.
버전은 1.19.5를 기준으로 진행한다.
/* bpf_sock.c */
__section("cgroup/connect4")
int cil_sock4_connect(struct bpf_sock_addr *ctx)
{
[...]
    err = __sock4_xlate_fwd(ctx, ctx, false, true);
[...]
}
cil_sock4_connect 프로그램은 cgroup/connect4 syscall을 후킹해서 eBPF 프로그램을 붙인다. 이때 실제로 트리거되는 함수는 __sock4_xlate_fwd다. 이 함수는 크기가 제법 크기 때문에 중요한 부분만 나눠서 살펴본다.
static __always_inline int __sock4_xlate_fwd(struct bpf_sock_addr *ctx,
                         struct bpf_sock_addr *ctx_full,
                         const bool udp_only,
                         const bool is_connect)
{
    const bool in_hostns = ctx_in_hostns(ctx_full, &id.client_cookie);
    const struct lb4_backend *backend;
    const struct lb4_service *svc;
    __u16 dst_port = ctx_dst_port(ctx);
    __u8 protocol = ctx_protocol(ctx);
    __u32 dst_ip = ctx->user_ip4;
    struct lb4_key key = {
        .address    = dst_ip,
        .dport      = dst_port,
        .proto      = protocol,
    }, orig_key = key;

  [...]
}
__sock4_xlate_fwd 함수는 요청된 서비스 IP를 기준으로 백엔드 IP를 고르는 실질적인 함수다. ctx_dst_port(ctx)는 목적지 포트(예: 80), ctx_protocol은 프로토콜(예: TCP), ctx->user_ip4는 목적지 ClusterIP(예: 10.96.193.104)에 해당한다. orig_key = key는 socknat 기록용으로, 원본 값을 저장해두고 앱이 요청한 목적지를 읽어 LB 키를 만드는 역할을 한다.
svc = lb4_lookup_service(&key, true);
static __always_inline const struct lb4_service *
__lb4_lookup_service(struct lb4_key *key)
{
    return map_lookup_elem(&cilium_lb4_services_v2, key);
}
cilium bpf lb list로 덤프했던 그 맵을 조회하는 지점이다. 앞서 만든 key로 서비스를 꺼내오며, 이때 사용하는 맵이 cilium_lb4_services_v2다. 이 맵도 cilium 명령어로 직접 확인할 수 있다.
kubectl -n kube-system exec cilium-rnqsj -- cilium map get cilium_lb4_services_v2

Key                       Value                   State   Error
10.96.57.113:80/TCP (1)   9 0[0] (6) [0x0 0x0]
10.96.57.113:80/TCP (2)   10 0[0] (6) [0x0 0x0]
10.96.57.113:80/TCP (0)   0 2[0] (6) [0x0 0x0]
각 엔트리를 보면 0번은 마스터 엔트리이고 1번과 2번이 실제 백엔드 슬롯 엔트리다. Value 값은 뒤이어 확인할 cilium_lb4_backends_v3 맵에서 사용하는 key다.
key.backend_slot = (sock_select_slot(ctx_full) % svc->count) + 1;
backend_slot = __lb4_lookup_backend_slot(&key);

backend_id = backend_slot->backend_id;
backend = __lb4_lookup_backend(backend_id);
sock_select_slot으로 앞서 본 서비스맵에서 백엔드 슬롯을 꺼내온다. 마스터 엔트리는 사용하지 않으므로 +1을 더한다. __lb4_lookup_backend_slot 역시 lb4_backends_v3 맵을 조회한다.
static __always_inline const struct lb4_backend *
__lb4_lookup_backend(__u32 backend_id)
{
    return map_lookup_elem(&cilium_lb4_backends_v3, &backend_id);
}
이 맵도 cilium 커맨드로 조회할 수 있다.
kubectl -n kube-system exec cilium-rnqsj -- cilium map get cilium_lb4_backends_v3

Key   Value              State   Error
10    TCP://10.0.2.143
9     TCP://10.0.0.203
sock4_update_revnat(ctx_full, backend, &orig_key, svc->rev_nat_index)
static __always_inline int sock4_update_revnat(struct bpf_sock_addr *ctx,
                           const struct lb4_backend *backend,
                           const struct lb4_key *orig_key,
                           __u16 rev_nat_id)
{
    key.cookie = sock_local_cookie(ctx);
    key.address = backend->address;
    key.port = backend->port;

    val.address = orig_key->address;
    val.port = orig_key->dport;
    val.rev_nat_index = rev_nat_id;

    tmp = map_lookup_elem(&cilium_lb4_reverse_sk, &key);
    if (!tmp || memcmp(tmp, &val, sizeof(val)))
        ret = map_update_elem(&cilium_lb4_reverse_sk, &key,
                      &val, 0);
    return ret;
}
sock4_update_revnat 함수는 원래 ClusterIP를 키로 RevNAT을 세팅한다. sock_local_cookie 함수로 소켓 고유 식별자(쿠키)를 뽑아 백엔드 IP·포트와 결합해 키를 만들고, 값으로는 클러스터 IP(원래 목적지)를 저장한다. getpeername이나 SNAT에서 ClusterIP를 다시 꺼내와야 할 때 이 값이 쓰인다. rev_nat_index를 함께 저장하는 이유는 이 소켓이 어느 Service(REVNAT ID X)를 거쳤는지 추적하기 위해서다.
kubectl -n kube-system exec -it cilium-rnqsj -- cilium map get cilium_lb4_reverse_sk

[10.0.0.228]:13568, 198569   [10.96.0.10]:13568, 1024
[10.0.0.228]:13568, 198555   [10.96.0.10]:13568, 1024
[10.0.0.141]:13568, 218742   [10.96.0.10]:13568, 1024
[10.0.0.228]:13568, 222857   [10.96.0.10]:13568, 1024
[10.0.0.228]:13568, 198559   [10.96.0.10]:13568, 1024
[10.0.0.228]:13568, 218733   [10.96.0.10]:13568, 1024
[10.0.0.141]:13568, 206550   [10.96.0.10]:13568, 1024
[10.0.0.228]:13568, 202473   [10.96.0.10]:13568, 1024
[10.0.0.228]:13568, 214689   [10.96.0.10]:13568, 1024
socknat 맵이 필요한 이유는, “이 소켓은 원래 ClusterIP X로 연결하려 했다”는 정보를 기억해뒀다가 getpeername() 같은 호출에서 되돌려주기 위해서다. IP:PORT 조합으로는 connect 시점에 소스 포트가 아직 정해지지 않아 부족하고, 프로세스 ID로는 한 프로세스가 여러 소켓을 열 수 있는 데다 파일 디스크립터도 프로세스마다 독립적이라 유일성을 보장할 수 없다. 그래서 64비트 정수인 소켓 쿠키가 유일한 식별값으로 쓰인다.
여기까지가 Cilium의 기본적인 동작 원리다. 가장 중요했던 지점은 내부 통신(East-West)에서 Cilium이 IPTables 없이 어떻게 서비스 IP를 파드 IP로 바꾸는가였는데, 이를 Socket-Based LoadBalancer, 즉 eBPF로 풀어냈다는 것을 확인했다.
이번 글에서는 내부 인클러스터 통신인 East-West 통신뿐 아니라 외부 클라이언트 트래픽을 처리하는 North-South 통신(SNAT vs DSR), Cilium Hubble을 통한 관측 가능성 확인, 멀티클러스터 통신 구축까지 다루는 것을 목표로 삼았지만, 글이 길어져 이 내용은 다음 편으로 넘긴다. Cilium은 IPTables 같은 기존 구조에서 벗어나 eBPF로 다양한 시도를 이어가고 있는 오픈소스다. 그 가운데는 XDP를 활용해 로드밸런서까지 구축할 수 있을 만큼 강력하면서도 자유로운 확장성을 가진 영역도 있다.
참조문서
컴투스인들의 일하는 방식 이해하기
일과 삶의 균형은 단순히 쉬는 시간을 늘리는 것만을 의미하지 않는다. 자신의 업무 리듬에 맞춰 시간을 효율적으로 활용하고, 몰입이 필요한 순간에는 업무에 집중할 수 있는 환경 역시 중요한 요소다.
컴투스는 다양한 근무 제도를 통해 구성원들이 업무와 일상의 균형을 조율하며 보다 효율적으로 일할 수 있도록 지원하고 있다. 이를 뒷받침하는 대표적인 제도가 비포괄임금제와 선택적 근로시간제다.
비포괄임금제는 연장근로, 휴일근로, 야간근로 등에 대한 수당을 급여에 미리 포함하는 방식이 아니라 실제 근무시간과 근무 형태를 기준으로 수당을 산정하는 구조다. 일한 시간이 그대로 기록에 남고 이에 맞춰 수당이 반영되기 때문에, 근무시간과 보상이 보다 명확하게 연결된다.
선택적 근로시간제 역시 컴투스의 근무 문화를 보여주는 주요 제도 중 하나다. 정해진 범위 안에서 출퇴근 시간을 조정할 수 있어 개인의 일정과 업무 특성에 따라 하루의 근무시간을 설계할 수 있다. 단순히 늦게 출근하거나 일찍 퇴근하는 데 목적이 있는 것은 아니다. 개인과 팀의 업무 리듬을 고려해 주어진 시간을 보다 효율적으로 활용하는 방식에 가깝다.
출퇴근 시간, 유연하게 설계하기
컴투스는 기본적으로 오전 9시부터 10시 30분 사이에 출근 시간을 선택할 수 있는 유연 근무제를 운영하고 있다. 모두가 같은 시간에 출근하는 것이 아니라 개인의 일정이나 업무 특성에 맞춰 출근 시간을 조정할 수 있다.
예를 들어 오전에 집중해야 할 업무가 많은 날에는 평소보다 일찍 출근할 수 있다. 반대로 일정에 여유가 있는 날에는 출근 시간을 조정해 교통이 혼잡한 시간대를 피하는 것도 가능하다.
퇴근 시간 역시 하루의 일정에 따라 달라질 수 있다. 은행이나 관공서처럼 평일에 처리해야 하는 개인 일정이 있다면 업무시간을 조정해 조금 일찍 퇴근할 수 있고, 반대로 업무가 집중되는 날에는 필요한 만큼 근무시간을 늘려 쓸 수도 있다.
월 단위로 근무시간을 관리하는 구조이기 때문에 하루하루의 출퇴근 시간은 비교적 유연하게 운영된다. 월별 필수 근무시간은 그달의 평일 수에 따라 조금씩 달라지는데, 결국 평일 하루 평균 8시간을 기준으로 월 근무시간을 맞추는 방식이다. 어느 날 근무시간이 짧았다면 다른 날 업무 상황에 맞춰 시간을 채우면 된다.
정해진 시간표에 하루를 맞추기보다 업무 상황과 개인 일정을 고려해 시간을 배분하면서, 몰입이 필요한 날에는 업무에 집중하고 여유가 있는 날에는 시간을 조율할 수 있다는 점이 선택적 근로시간제의 장점이다.
자율적인 근무를 위한 기준, 코어타임
근무시간을 조율할 수 있지만, 협업을 위해 모두가 함께 지켜야 하는 기준도 있다. 바로 코어타임이다.
회사의 업무는 개인의 일만으로 완성되지 않는다. 회의와 의사결정, 유관 부서와의 소통까지 다양한 협업이 이어지는 만큼 구성원들이 함께 근무하는 공통 시간대가 필요하다.
컴투스는 이를 위해 오전 10시 30분부터 오후 3시까지를 코어타임으로 운영한다. 이 시간에는 회의와 협업, 커뮤니케이션이 원활하게 이루어질 수 있도록 구성원들이 함께 근무한다. 출퇴근 시간을 각자 조정하더라도 공통으로 근무하는 시간대를 두어 개인의 업무 리듬과 조직의 협업을 함께 유지하는 방식이다.
다만 업무 상황 등에 따라 예외적으로 코어타임 면제가 필요한 경우에는 사내 기준에 따라 별도의 신청 절차를 거칠 수 있다.
즉 근무시간을 조정할 수 있더라도 기본적으로는 코어타임을 중심으로 함께 협업하는 구조다. 스스로 근무시간을 관리하는 만큼 자신의 업무 일정과 마감을 책임지는 것 역시 제도를 활용하는 데 필요한 부분이다.
코어타임이 끝나는 오후 3시 이후로는 그날 채워야 할 근무시간을 이미 채웠다면 바로 퇴근할 수도 있다. 여기에 1시간 단위로 사용할 수 있는 시간연차를 더하면 활용도는 한층 넓어진다. 예를 들어 월 근무시간에 여유가 있다면, 시간연차 1시간을 써서 코어타임 종료 전인 오후 2시에 퇴근하는 것도 가능하다. 하루 연차를 모두 쓰지 않고도 개인 일정에 맞춰 필요한 만큼 시간을 활용할 수 있는 셈이다.
일한 만큼 보상받는 구조
비포괄임금제의 핵심은 실제 근무시간을 기준으로 보상이 결정된다는 점이다. 컴투스에서는 기준 근로시간을 초과해 근무한 시간이 1분 단위로 산정돼 수당에 반영된다. 근무 형태에 따라서도 기준이 구분된다. 정해진 근무시간을 넘어 일한 경우뿐만 아니라 휴일이나 야간에 근무한 경우에도 각각의 근무 형태에 맞춰 수당이 반영된다.
게임업계에서는 라이브 서비스 일정이나 업데이트, 점검 등 특정 시기에 업무가 집중되기도 한다. 서비스 상황에 따라 야간이나 휴일에 업무가 필요한 경우도 있는데, 이럴 때도 일한 시간과 형태가 빠짐없이 기록되고 그에 맞춰 보상으로 이어진다는 점은 비포괄임금제의 장점을 직접 체감하게 하는 부분이다.
몰입해야 할 때는 시간을 온전히 쓰되, 그 과정에서 추가로 투입한 시간은 명확하게 기록하고 보상받을 수 있다. 결국 비포괄임금제를 가장 간단하게 표현하면 ‘일한 만큼 보상받는 구조’라고 할 수 있다.
직접 경험해본 컴투스의 근무 제도
이런 제도를 실제로 이용하며 느낀 것은, 흔히 말하는 워라밸의 의미와는 조금 달랐다. 사람들은 보통 워라밸을 근무시간이 짧거나 퇴근이 빠른 회사로 떠올리곤 하지만, 필자에게 중요했던 것은 단순히 일하는 시간을 줄이는 것이 아니라 내가 일하는 시간을 스스로 선택하고 조율하면서 업무에 집중할 수 있는 환경이었다.
업무에 집중해야 하는 날에는 필요한 만큼 시간을 쓰고, 비교적 여유가 있는 날에는 개인 일정에 맞춰 근무시간을 조율한다. 추가 근무가 필요한 상황에서는 그 시간이 그대로 기록되고 보상으로 이어진다는 점도 일과 삶의 균형을 유지하는 데 도움이 된다.
물론 출퇴근 시간을 스스로 조정할 수 있다고 해서 해야 할 일이 줄어드는 것은 아니다. 오히려 업무 일정과 시간을 직접 관리해야 하는 만큼 책임도 함께 따라온다. 그럼에도 정해진 시간에 나를 맞추는 대신 각자의 상황에 맞춰 업무와 일상을 조율할 수 있다는 점은 제도를 직접 이용하며 체감한 장점이다.
이러한 근무 구조는 매달 두 번째 금요일 출근 의무를 면제하는 ‘리커버리데이’ 제도로도 이어진다. 선택적 근로시간제를 기반으로 하루의 근무를 면제받으면서도 월 단위 근무시간은 그대로 맞출 수 있어, 일과 휴식을 함께 설계할 수 있는 여지가 넓다.
결국 컴투스의 근무 제도는 자율과 책임을 함께 묻는 구조다. 스스로 시간을 설계할 자유를 주는 만큼 그 시간에 대한 책임도 함께 지게 하며, 그 균형 위에서 일하는 방식 자체를 조금씩 더 건강하게 만들어가고 있다.
지난 1탄에서는 신규 소환사로 처음 천공의 섬에 발을 들이고, 튜토리얼과 첫 소환, 12주년 이벤트를 경험해봤다.
무엇보다 첫 소환을 통해 다양한 몬스터를 만나면서 ‘내 몬스터가 생겼다’는 즐거움을 확실히 느낄 수 있었다. 하지만 첫날의 설렘이 지나고 나니 새로운 고민이 생겼다.
몬스터는 많아졌지만, 무엇을 기준으로 성장시켜야 할지는 아직 알 수 없었다. 1탄에서 던전과 성장 콘텐츠를 살펴보겠다고 예고했지만, 실제 플레이에서는 소환사의 길을 따라 몬스터를 키우고 전투와 성장 시스템에 익숙해지는 과정이 먼저였다.
이번에는 던전 공략보다 그 전에 자연스럽게 거치게 되는 강화와 진화, 룬, 시나리오 전투를 중심으로 플레이해봤다.
첫 소환 이후, 무엇부터 해야 할까?
1탄에서 여러 차례 소환을 진행한 덕분에 천공의 섬은 금세 몬스터들로 북적이기 시작했다. 하지만 막상 전투를 이어가려니 어떤 몬스터를 먼저 키워야 할지 고민이 됐다.
이때 가장 먼저 눈에 들어온 것이 소환사의 길이었다. 소환사의 길은 신규 소환사가 어떤 콘텐츠를 먼저 진행하면 좋을지 단계별로 알려주는 가이드처럼 느껴졌다. 성장 과제와 도전 과제가 나뉘어 있었고, 몬스터 강화, 전투 진행, 아레나 도전 등 초반에 필요한 목표가 하나씩 제시됐다.
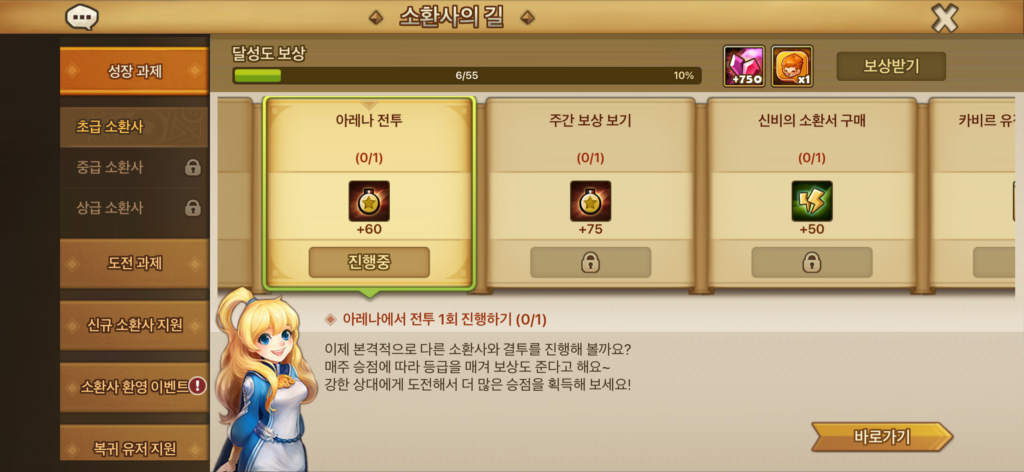
처음에는 메뉴가 많아 어디서부터 눌러야 할지 헷갈렸지만, 소환사의 길을 따라가니 해야 할 일이 조금씩 정리되는 느낌이었다. 초보자 공략에서 흔히 “초반에는 소환사의 길을 따라가라”는 말이 왜 나오는지 이해가 됐다. 직접 해보니 정말 그 길이 초반 성장의 기준점이 되어줬기 때문이다.
든든한 보상과 함께 이어가는 성장
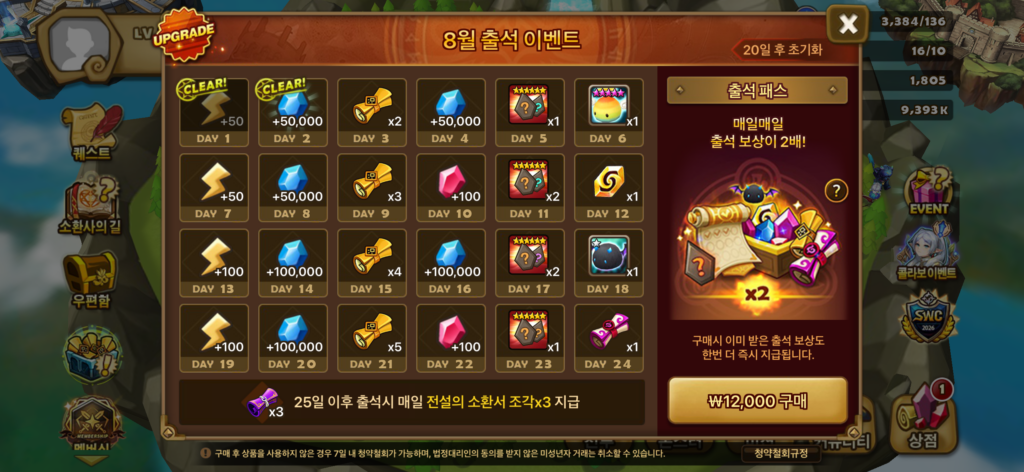
첫 소환을 마치고 다시 천공의 섬에 접속하자, 8월 출석 보상과 다양한 이벤트 보상도 함께 확인할 수 있었다.
1탄에서는 소환서, 에너지, 경험치 부스터, 마나석 같은 재화가 한꺼번에 등장해 다소 낯설게 느껴졌다면, 이번에는 그 보상들이 실제 성장 과정에서 어떻게 쓰이는지 조금씩 체감할 수 있었다.
몬스터를 강화하고, 룬을 바꾸고, 전투를 반복하다 보니 마나석과 에너지의 필요성이 금방 느껴졌다. 처음에는 ‘많이 주는 보상’ 정도로만 보였던 재화들이 이제는 몬스터를 키우고 다음 전투로 나아가기 위한 준비물처럼 느껴지기 시작했다.
물론 초반부터 모든 재화를 효율적으로 사용하는 것은 쉽지 않았다. 하지만 소환사의 길을 따라가며 필요한 순간에 보상을 사용하다 보니, 자연스럽게 서머너즈 워의 성장 구조를 조금씩 익힐 수 있었다.
누구를 먼저 키워야 할까?
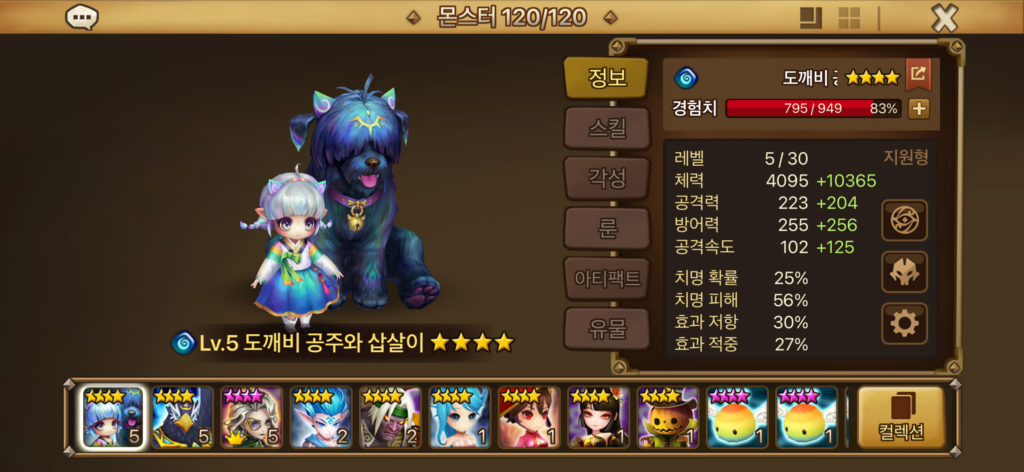
첫 소환 이후 가장 먼저 마주한 고민은 역시 몬스터 선택이었다. 보관함에는 여러 속성과 등급의 몬스터가 있었고, 각 몬스터마다 역할과 능력치가 달랐다.
처음에는 별 개수가 높은 몬스터부터 키우면 되는 줄 알았으나 정보를 열어보니 공격형, 지원형 등 타입이 나뉘어 있었고, 스킬 구성도 모두 달랐다. 어떤 몬스터가 좋은지 정확히 알 수는 없었지만, 일단 전투에서 자주 사용하는 몬스터와 눈에 들어오는 몬스터를 중심으로 키워보기로 했다.
특히 1탄에서 소환했던 샤샤는 자연스럽게 눈길이 갔다. 첫 소환에서 만난 몬스터를 직접 키워본다는 점에서, 단순히 강한 몬스터를 고르는 것과는 또 다른 애착이 생겼다.
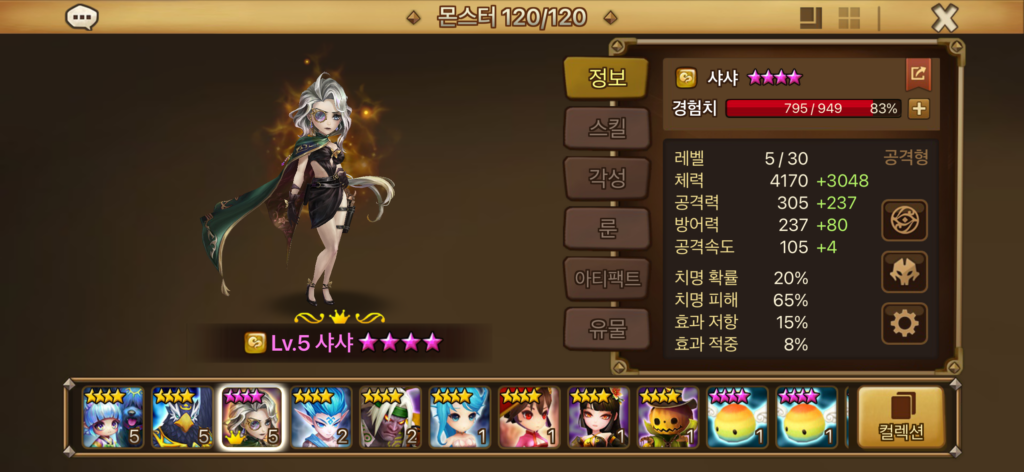
몬스터 정보를 확인하니 레벨, 체력, 공격력, 방어력, 공격속도 등 다양한 능력치가 표시됐다. 처음에는 숫자가 많아 복잡해 보였지만, 전투를 반복하고 성장시킬수록 이 수치들이 조금씩 올라간다는 점은 직관적으로 이해할 수 있었다.
직접 강화해보니 보이는 성장의 재미
소환사의 길을 따라 진행하다 보니 자연스럽게 몬스터 강화로 이어졌다. 강화 마법진에서는 보유한 몬스터나 재료를 사용해 선택한 몬스터의 경험치를 올릴 수 있었다.
처음에는 재료를 사용하는 것이 조금 조심스러웠다. 혹시 중요한 몬스터를 잘못 사용하면 어쩌나 하는 걱정도 있었다. 다행히 자동 선택 기능이 있어 초반에는 큰 부담 없이 강화 과정을 진행할 수 있었다.
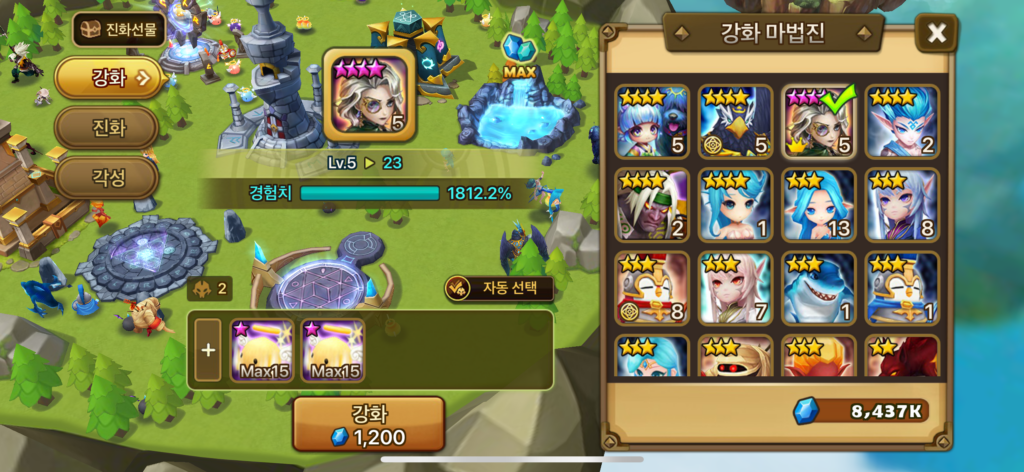
강화를 진행하자 레벨이 오르고 능력치가 상승했다. 숫자가 바뀌는 장면은 단순하지만 꽤 확실한 성취감을 줬다. 1탄에서 소환 결과 화면으로만 보던 몬스터가 이제는 직접 성장하는 모습을 보여주기 시작했다.
첫 진화 성공, 몬스터가 달라졌다
강화 다음으로 체험한 것은 진화였다. 진화는 몬스터의 별 등급을 올리고 최대 레벨을 확장하는 성장 방식이었다. 강화가 현재 몬스터의 레벨을 올리는 과정이라면, 진화는 몬스터가 더 높은 단계로 성장할 수 있도록 한계를 넓혀주는 과정처럼 느껴졌다. 재료 몬스터가 필요하다는 점에서 신중함도 필요했다.
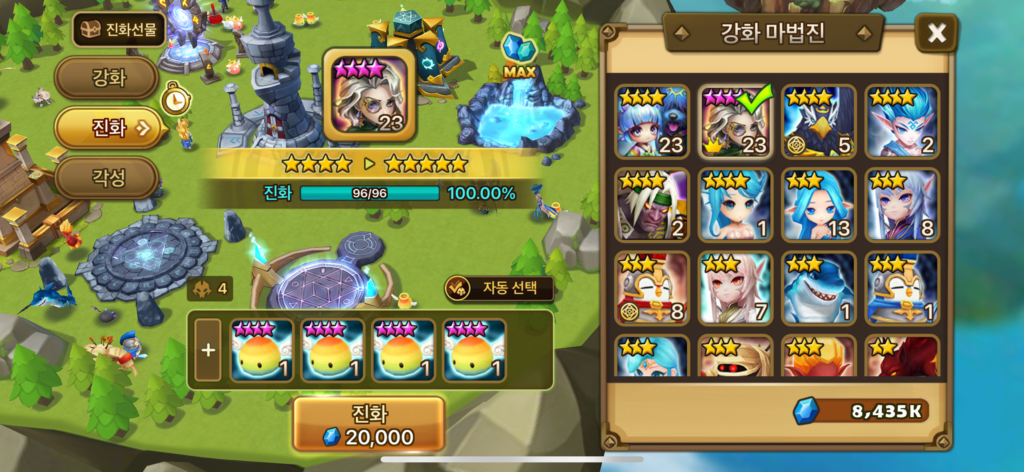
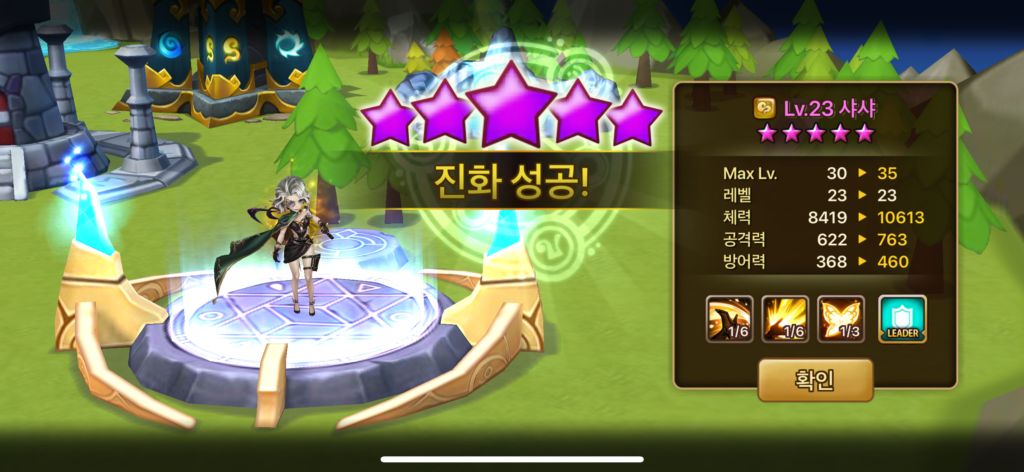
샤샤의 진화에 성공하자 화면 가득 별이 떠오르며 몬스터의 능력치가 크게 상승했다. 최대 레벨도 올라가고, 체력과 공격력, 방어력 수치가 함께 증가했다. 이 장면은 2탄 플레이 중 가장 확실하게 성장을 체감한 순간이었다.
스킬을 읽기 시작하니 전투가 조금 다르게 보였다
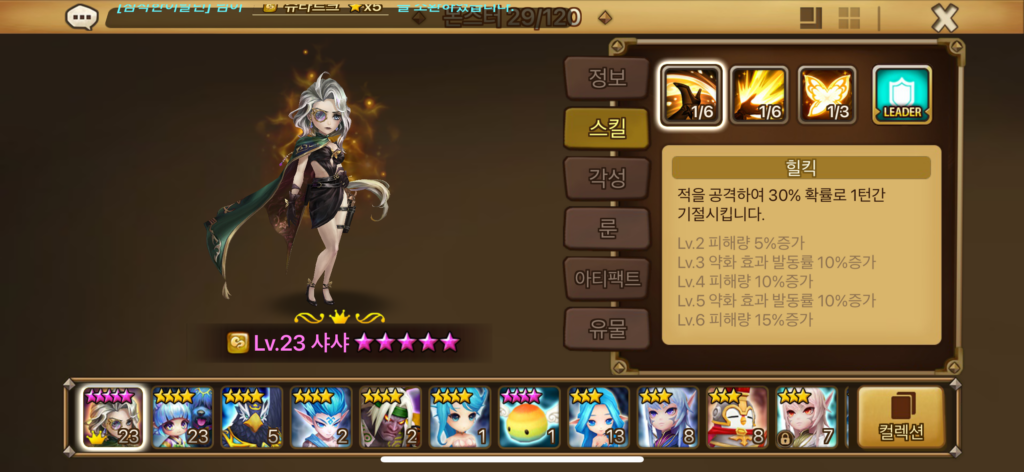
몬스터를 키우다 보니 자연스럽게 스킬에도 눈이 갔다. 처음에는 전투 화면에서 불이 들어오는 스킬 버튼을 누르는 데 집중했다면, 이제는 각 스킬이 어떤 효과를 가지고 있는지 궁금해졌다.
샤샤의 스킬을 확인해보니 적에게 기절을 걸거나, 강화 효과와 약화 효과에 따라 피해량이 달라지는 등 생각보다 다양한 조건이 있었다.
물론 뉴비 입장에서 모든 효과를 바로 이해하기는 어려웠다. 하지만 스킬 설명을 읽고 나니 전투에서 어떤 상황에 어떤 스킬을 쓰면 좋을지 조금씩 생각하게 됐다.
가장 어렵지만 중요한 첫 관문, 룬
2탄에서 가장 어렵게 느껴진 시스템은 역시 룬이었다. 슬롯은 1번부터 6번까지 나뉘어 있었고, 세트 효과와 주옵션, 부옵션까지 확인할 수 있었다. 처음에는 어떤 룬을 어떤 몬스터에게 장착해야 하는지 감이 오지 않았다. 하지만 룬을 장착한 몬스터와 그렇지 않은 몬스터의 능력치 차이는 분명히 보였다.
룬 관리 화면에서는 변경 전과 변경 후의 능력치를 비교할 수 있었다. 초보자 입장에서는 이 비교 화면이 꽤 도움이 됐다. 세부 옵션을 완벽히 이해하지 못하더라도, 어떤 수치가 오르고 어떤 수치가 달라지는지는 한눈에 확인할 수 있었기 때문이다.
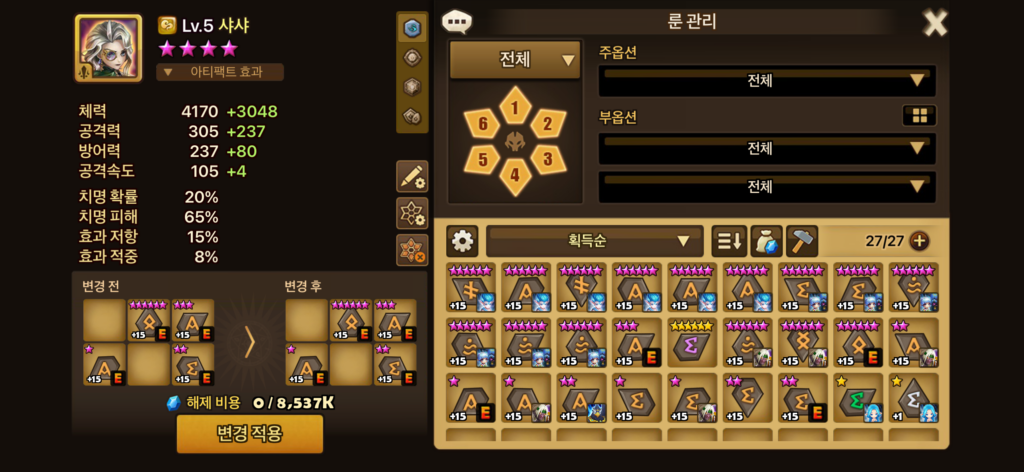
처음에는 추천이나 자동 각인 기능에 의존할 수밖에 없었다. 하지만 직접 장착하고 바꿔보니 룬이 왜 서머너즈 워에서 중요한 시스템인지 조금은 이해할 수 있었다. 같은 몬스터라도 어떤 룬을 장착하느냐에 따라 전투에서의 역할과 체감이 달라질 수 있다는 점이 인상적이었다.
소환만큼 중요한 몬스터 관리
1탄에서 가장 즐거웠던 순간은 역시 소환이었다. 2탄에서도 보상으로 얻은 소환서를 사용하며 새로운 몬스터를 만나고 싶었다. 하지만 소환을 계속 시도하다 보니 예상치 못한 문제가 생겼다.
바로 몬스터 보유량이었다.
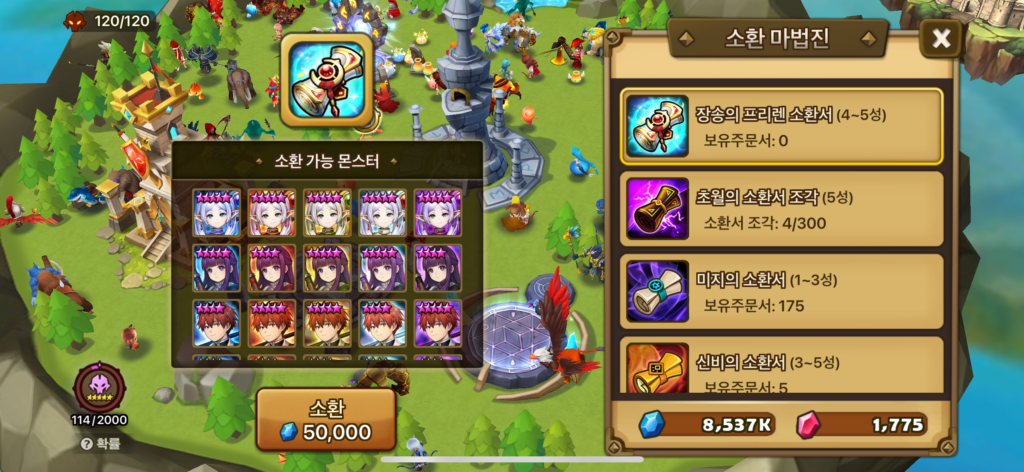
몬스터의 최대 보유량에 도달했다는 안내가 나오자, 소환형 RPG에서 수집만큼 중요한 것이 관리라는 점을 느꼈다. 새로운 몬스터를 얻는 것도 즐겁지만, 어떤 몬스터를 보관하고 어떤 몬스터를 재료로 사용할지 판단하는 것도 필요했다.
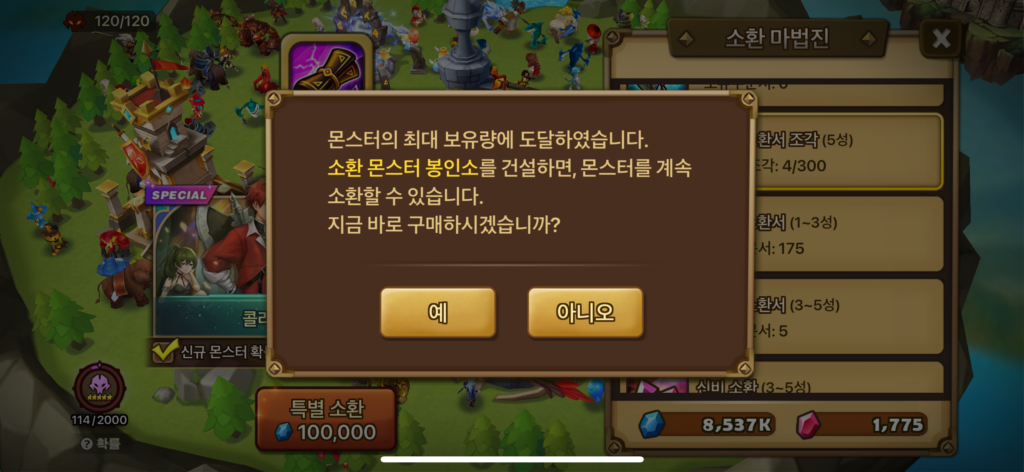
이때 소환 몬스터 봉인소를 통해 보유 공간을 늘릴 수 있다는 안내도 확인할 수 있었다. 처음에는 단순히 몬스터를 많이 모으는 것이 목표라고 생각했지만, 플레이를 이어갈수록 보관함 관리 역시 성장의 일부라는 것을 알게 됐다.
소환사의 길을 따라 첫 시나리오 전투로
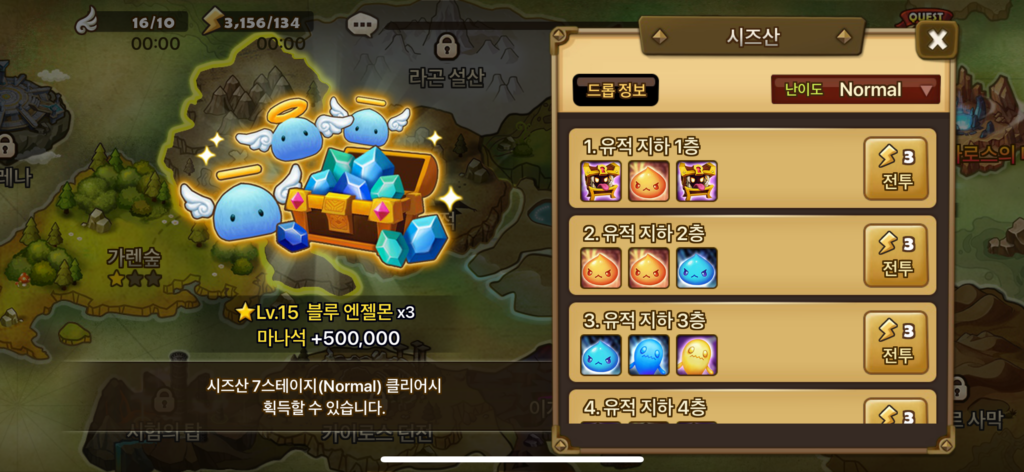
몬스터를 강화하고 룬을 확인한 뒤에는 본격적으로 전투를 이어갔다. 소환사의 길을 따라가다 보니 자연스럽게 시나리오 전투가 눈에 들어왔고, 이번에는 시즈산을 진행해봤다.
시나리오는 성장 목적이 뚜렷한 콘텐츠였다. 화면에는 스테이지별 적 몬스터와 획득 가능한 보상이 표시돼 있었고, 전투를 진행하면서 경험치와 보상을 얻을 수 있었다. 이를 다시 몬스터 성장에 활용하면서 전투와 성장이 자연스럽게 이어지는 흐름도 조금씩 이해할 수 있었다.
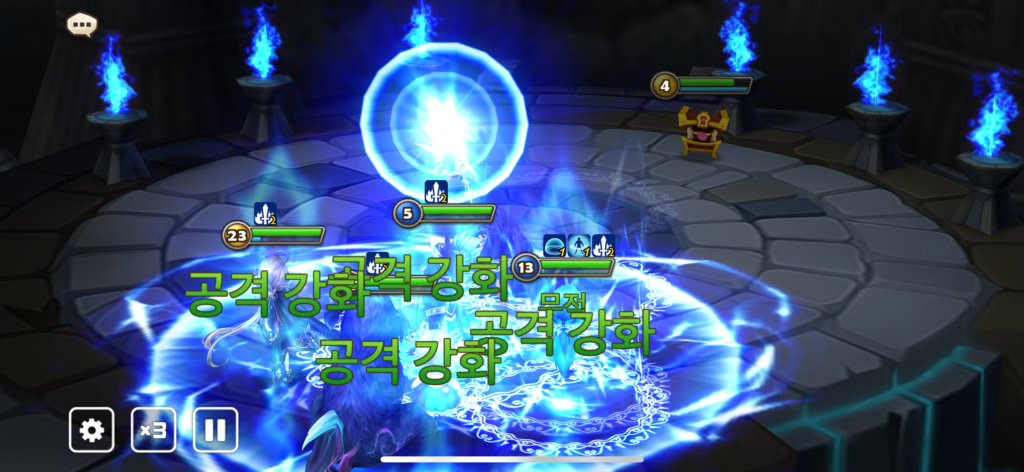
전투에 들어가자 이전보다 몬스터들이 조금 더 든든하게 느껴졌다. 샤샤의 레벨이 올라가고, 다른 몬스터들도 함께 성장하면서 초반보다 전투가 안정적으로 진행됐다.
자동전투와 배속 기능도 유용했다. 직접 스킬을 하나씩 누르지 않아도 전투가 이어졌고, 반복해서 전투를 진행할 때 부담을 줄여줬다. 다만 자동전투가 모든 것을 해결해주는 것은 아니었다. 편성이나 룬 세팅에 따라 전투의 흐름이 달라질 수 있기 때문에, 결국 기본적인 성장과 세팅이 중요하다는 점도 함께 느껴졌다.
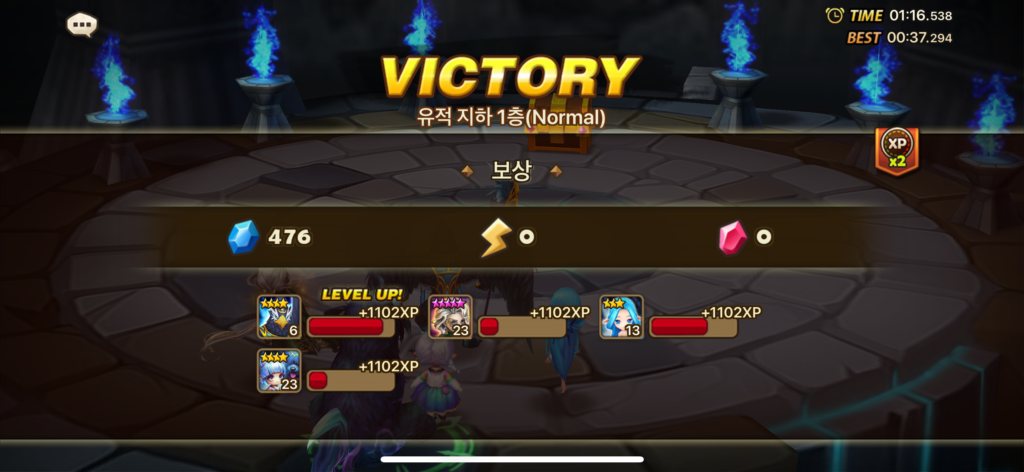
시나리오를 클리어하자 경험치와 보상이 지급됐다. 단순히 한 판을 이긴 것이 아니라, 전투를 통해 보상을 얻고 다시 몬스터 성장으로 이어가는 구조가 조금씩 보이기 시작했다.
1탄에서 소환의 재미를 느꼈다면, 2탄에서는 “왜 몬스터를 키워야 하는지”를 조금 알게 된 순간이었다.
리더 스킬과 편성, 아직 배울 것이 많다
시나리오를 진행하며 편성 화면도 자주 확인하게 됐다. 이때 눈에 들어온 것이 리더 스킬이었다.
화면에는 ‘리더 스킬: 버프 없음’이라는 표시가 나타났는데, 처음에는 무슨 의미인지 알 수 없었다. 몬스터 정보를 하나씩 살펴보면서 특정 몬스터가 가진 리더 스킬에 따라 전투에 도움이 되는 효과를 받을 수 있다는 점을 알게 됐다.
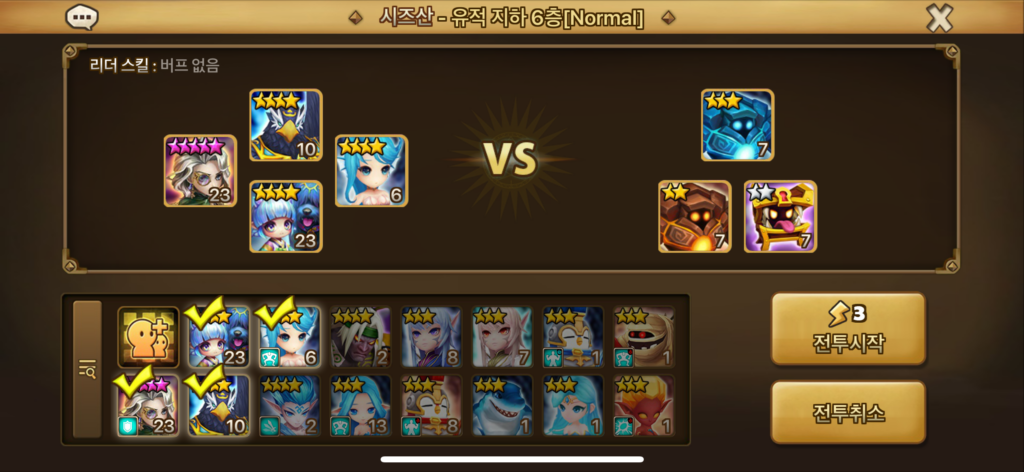
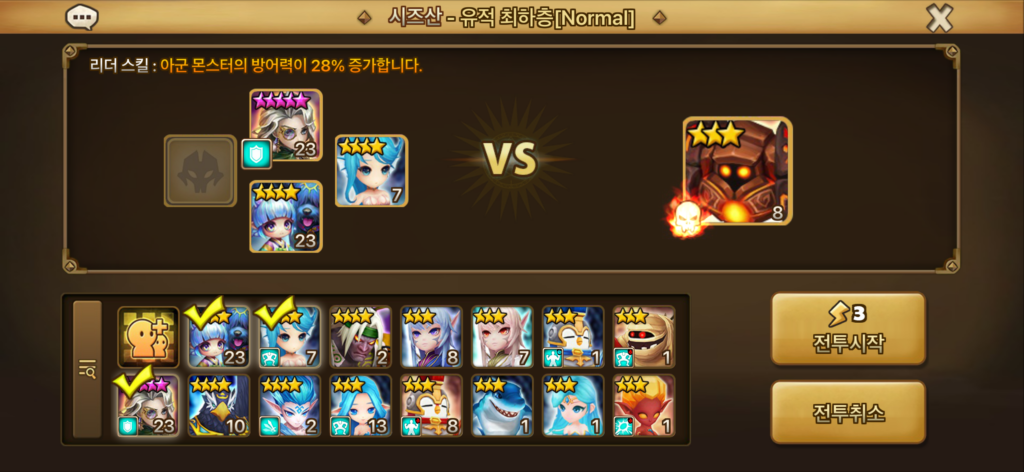
초반에는 크게 신경 쓰지 않아도 전투를 이어갈 수 있었지만, 앞으로 더 어려운 콘텐츠에 도전하려면 이런 요소도 살펴봐야 할 것 같았다.
단순히 강해 보이는 몬스터를 편성하는 데서 그치는 것이 아니라 누가 리더가 되는지, 각 몬스터가 어떤 스킬을 가지고 있는지, 어떤 룬을 장착하고 있는지까지 고려해야 했다. 몬스터가 많아질수록 선택지는 늘어나지만 그만큼 고민할 것도 많아지는 셈이다.
아레나까지 살짝 맛보다
소환사의 길을 진행하다 보니 아레나 전투도 자연스럽게 안내됐다.
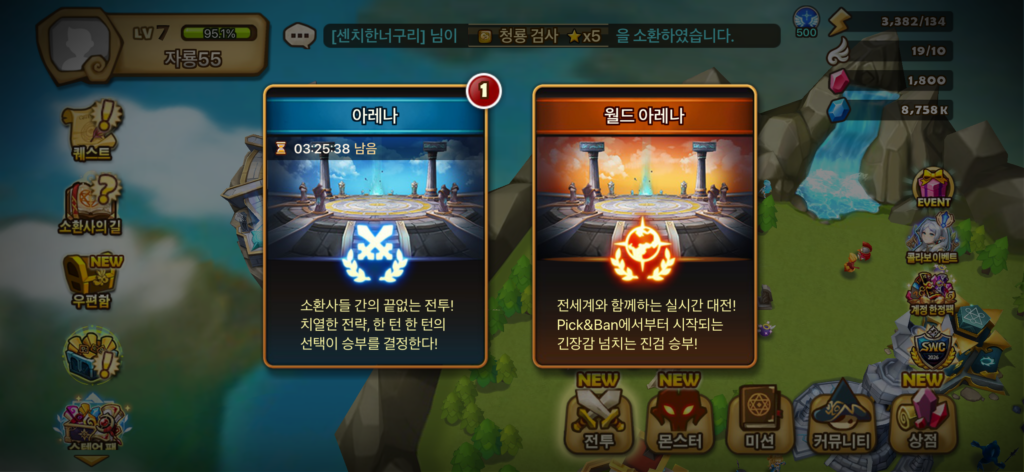
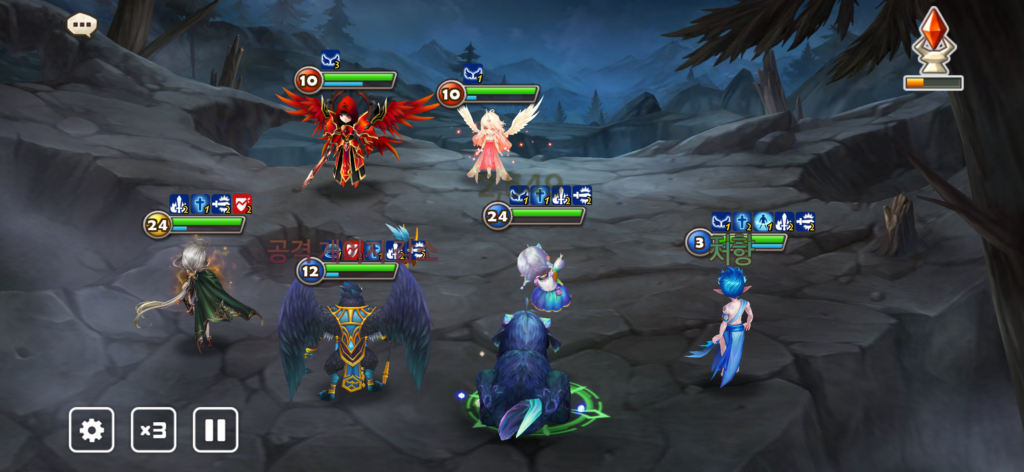
아레나는 다른 소환사가 구성한 방어덱을 상대로 전투를 펼칠 수 있는 콘텐츠다. 아직 다른 유저와의 전투가 부담스럽다면 아레나의 ‘라이벌’을 통해 NPC와 먼저 전투를 경험할 수도 있었다.
아직 본격적인 PvP 전략을 이해하기에는 이른 단계였지만, 내가 직접 키운 몬스터로 새로운 형태의 전투에 도전해볼 수 있다는 점은 또 다른 자극이 됐다.
시나리오를 진행하고 몬스터를 성장시키는 것에서 한발 더 나아가, 앞으로 몬스터를 더 강하게 키워야 할 또 하나의 이유가 생긴 셈이다.
뽑는 재미에서 키우는 재미로
2탄을 플레이하며 가장 크게 느낀 변화는 게임을 바라보는 시선이었다. 1탄에서는 좋은 몬스터를 얻는 것, 새로운 몬스터를 만나는 것 자체가 가장 큰 즐거움이었다. 하지만 이번에는 소환 이후의 과정이 더 눈에 들어왔다. 몬스터를 강화하고, 진화시키고, 룬을 장착하고, 시나리오에 도전하는 과정이 이어지면서 서머너즈 워의 재미가 조금 더 입체적으로 다가왔다.
처음에는 룬도 어렵고, 리더 스킬도 낯설고, 몬스터 관리도 복잡하게 느껴졌다. 하지만 소환사의 길을 따라가며 하나씩 경험해보니, 복잡해 보이던 시스템들이 조금씩 연결되기 시작했다. 아직 모든 시스템을 완벽히 이해한 것은 아니다. 어떤 룬이 가장 좋은지, 어떤 몬스터를 우선적으로 키워야 하는지, 시나리오는 어디까지 도전해야 하는지 배워야 할 것이 훨씬 많다. 첫날에는 “지금 시작해도 괜찮을까?”를 고민했다면, 이제는 “이 몬스터들을 어디까지 키워볼 수 있을까?”가 더 궁금해졌다.
이번 2탄에서는 소환사의 길을 따라 몬스터 강화와 진화, 룬, 시나리오 전투와 아레나까지 가볍게 경험해봤다. 던전 콘텐츠는 아직 본격적으로 다루지 못했지만, 이번 과정을 통해 던전에 도전하기 전 필요한 기본적인 성장 흐름을 먼저 익힐 수 있었다.
서머너즈 워를 처음 시작한 신규 소환사라면, 너무 많은 시스템을 한 번에 이해하려고 부담을 가질 필요는 없을 것 같다. 소환사의 길을 따라 한 걸음씩 직접 경험하다 보면, 어느새 새로운 몬스터를 뽑는 것만큼 이미 만난 몬스터를 성장시키는 재미에도 빠져들게 될 테니 말이다.
아직 천공의 섬에 발을 들이지 않았다면, 공식 유튜브 채널에서 서머너즈 워의 다양한 몬스터와 전투 콘텐츠를 먼저 만나보는 것도 좋다. 영상으로 세계관과 몬스터의 매력을 살펴본 뒤, 직접 천공의 섬으로 첫발을 내디뎌보는 건 어떨까?
ⓘ 확률형 아이템 포함
광복절의 의미를 되새기며 달리는 뜻깊은 여정에 컴투스가 올해도 함께했다.
컴투스는 지난 8월 15일 열린 ‘2026 815런’의 후원 기업으로 참여하며 독립유공자 후손을 위한 나눔에 힘을 보탰다. 컴투스는 이번 캠페인에 독립유공자 후손 주거 개선을 위한 기부금 815만 원을 전달했으며, 컴투스 임직원 30여 명도 서울 상암 월드컵공원에서 열린 오프라인런에 직접 참가해 함께 달리며 행사의 의미를 더했다.
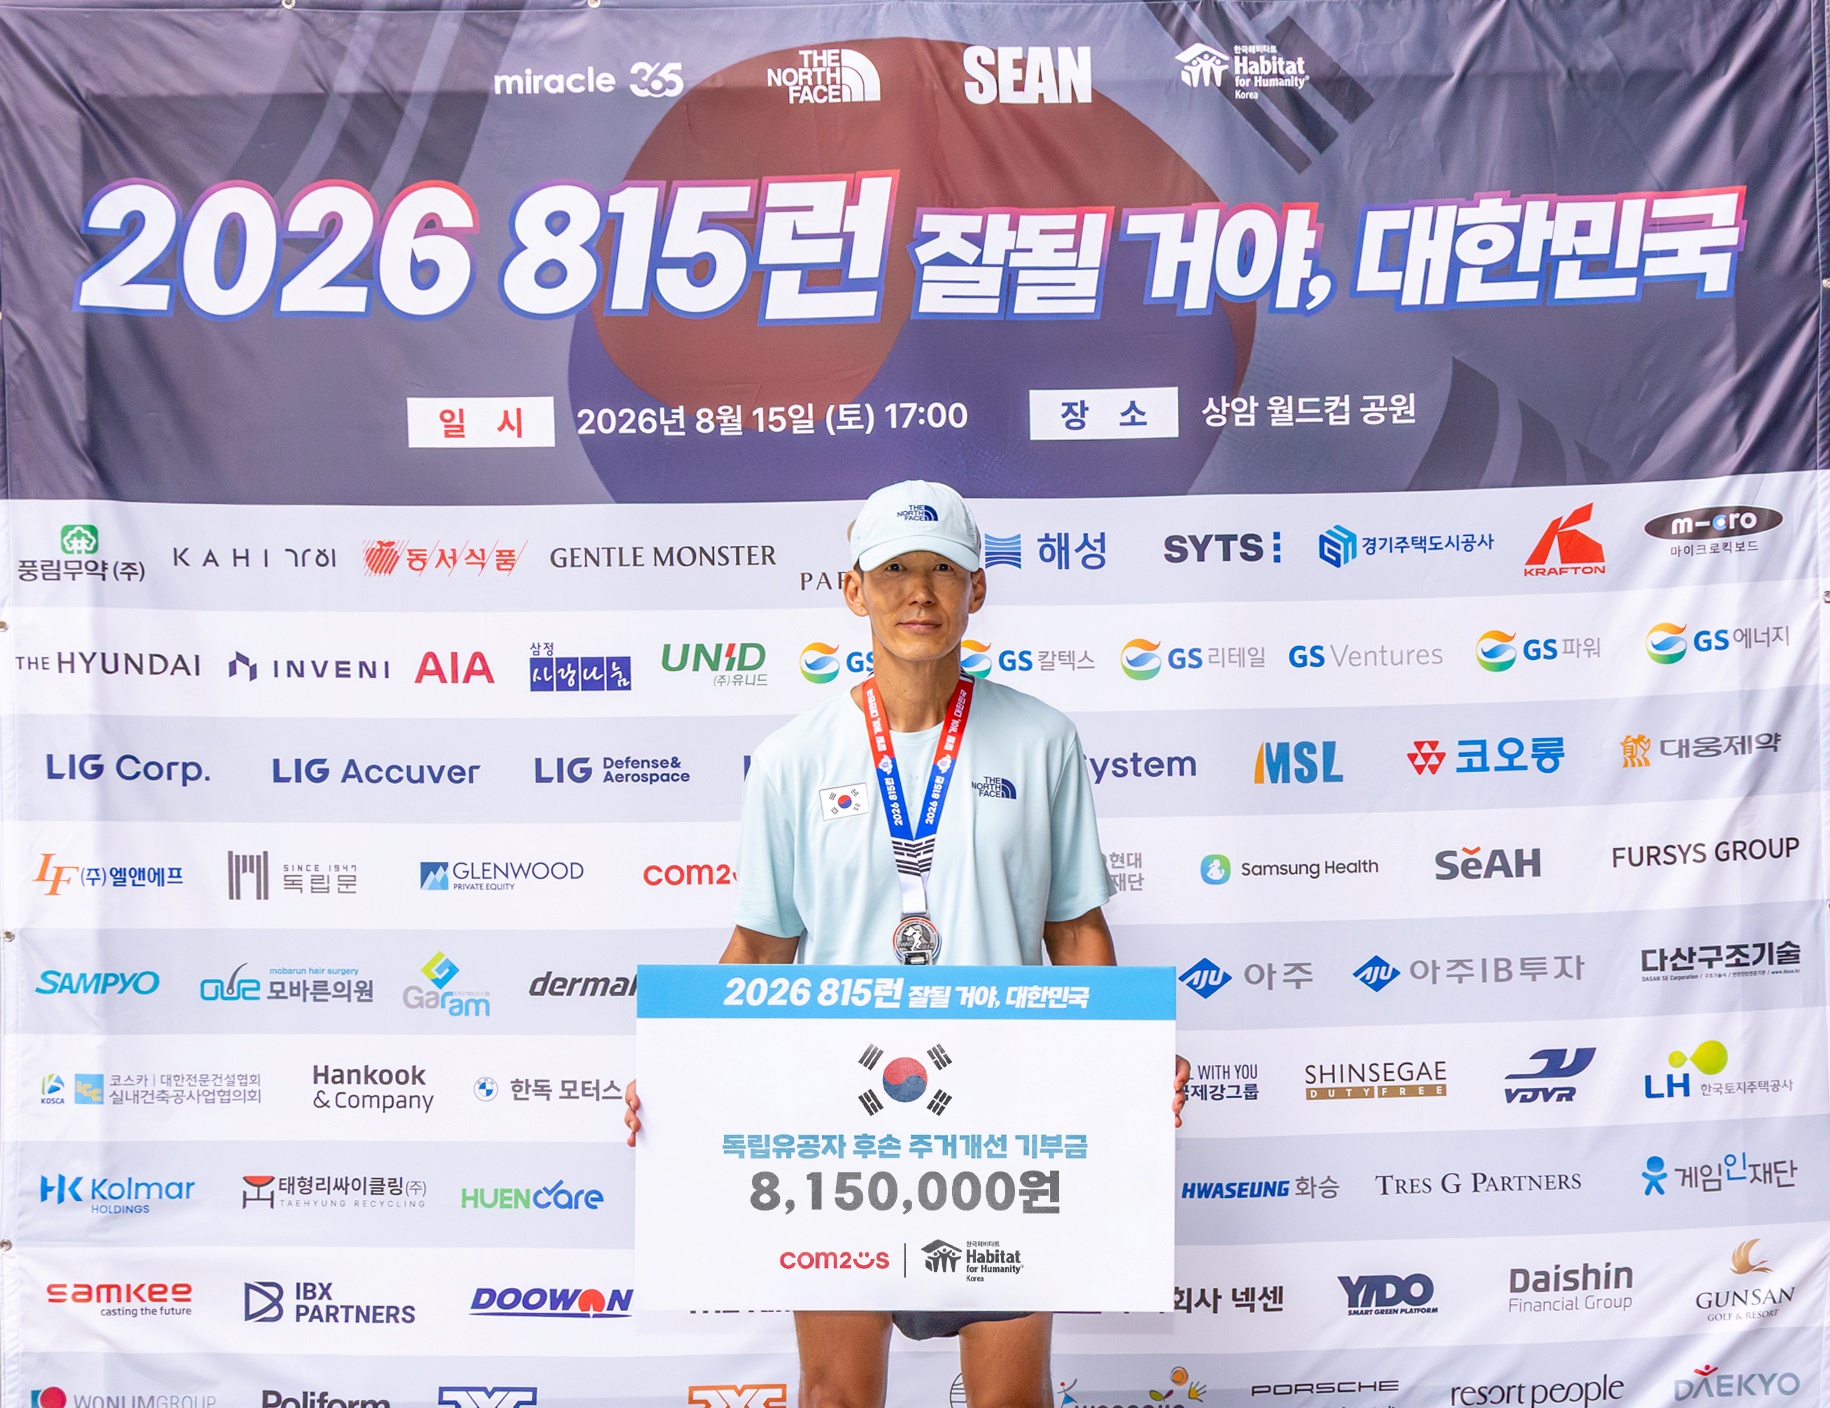
‘815런’은 광복절을 기념하고 나라를 위해 헌신한 독립유공자들에게 감사의 마음을 전하기 위해 마련된 기부 마라톤 캠페인이다. 참가비와 기업 후원금은 독립유공자 후손의 주거환경 개선 사업에 사용된다. 한국해비타트와 가수 션이 2020년부터 이어오고 있으며, 올해로 7회째를 맞았다.
역대 최다 7,000명 참가…26억 원 넘는 기부금 전달
올해도 가수 션은 광복절 새벽부터 81.5km를 달리는 도전에 나섰다. 45명의 페이서와 함께 달린 션은 8시간 20분 2초 만에 81.5km를 완주하며 광복절의 의미를 다시 한번 알렸다.
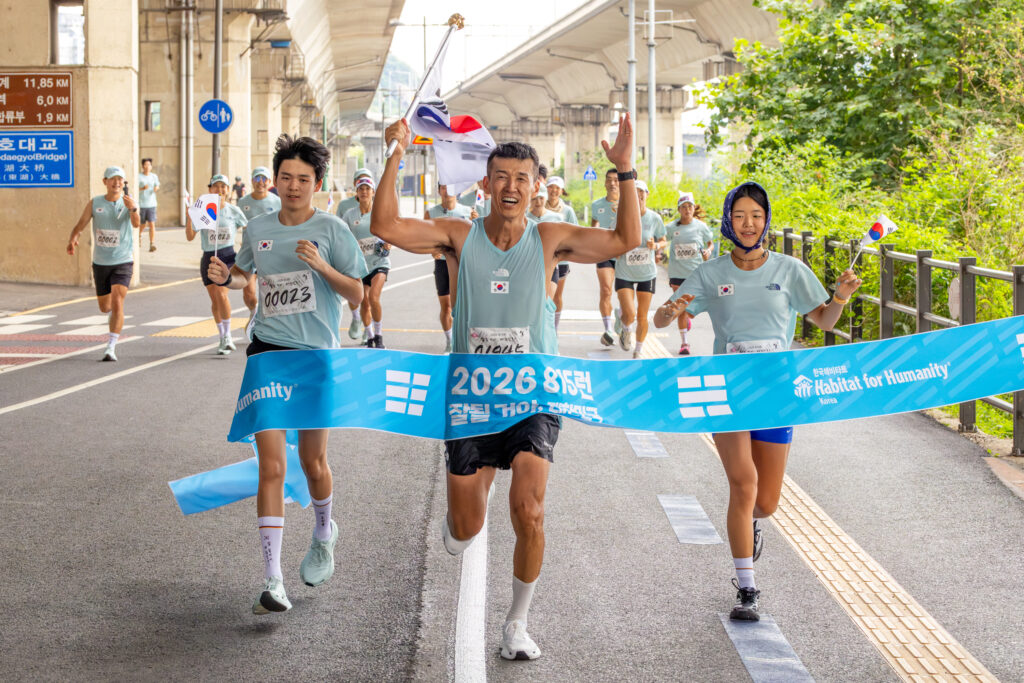
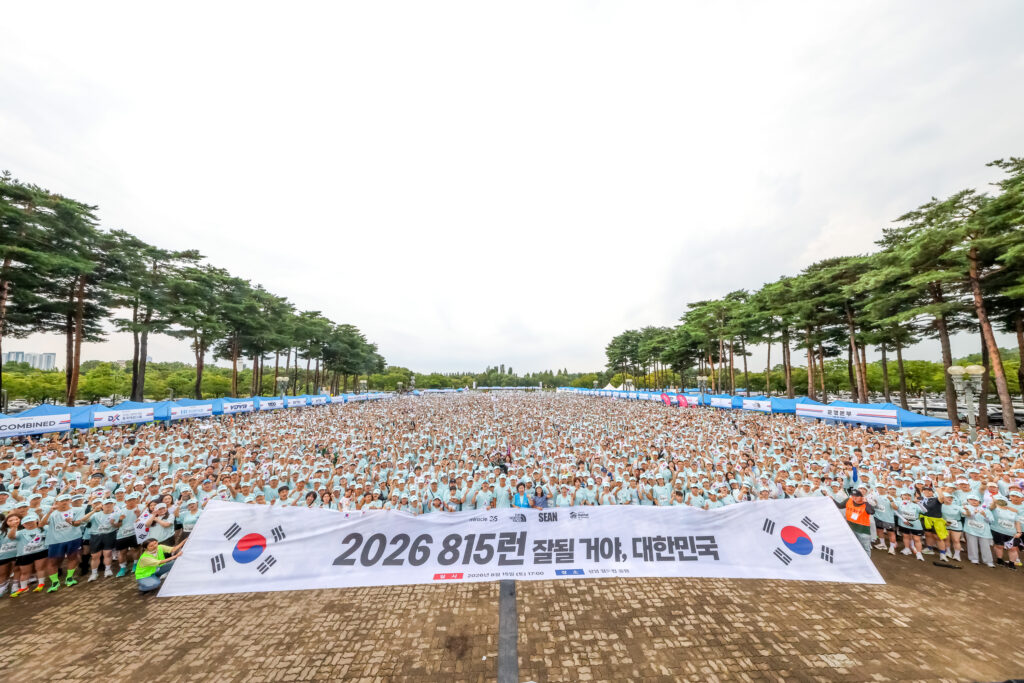
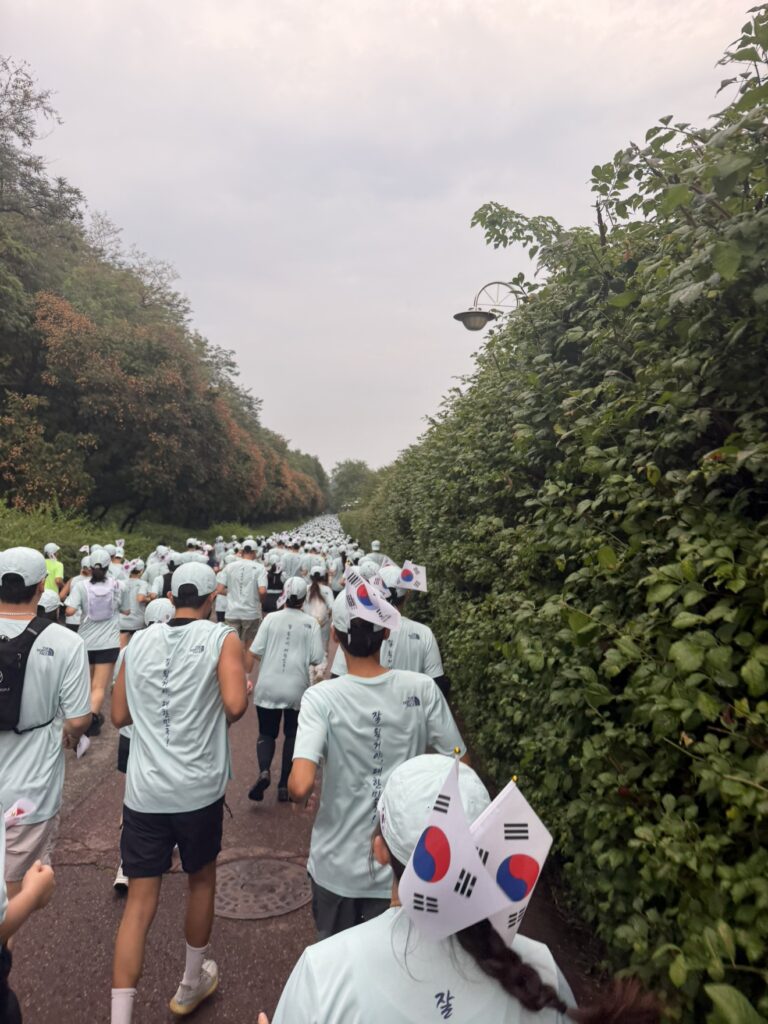
오후에는 서울 상암 월드컵공원에서 오프라인런이 이어졌다. 올해 오프라인 행사에는 역대 최다 규모인 7,000명이 참가해 8.15km를 함께 달렸다. 참가자들은 각자의 속도로 코스를 완주하며 독립유공자의 희생과 헌신을 기억하는 시간을 가졌다.
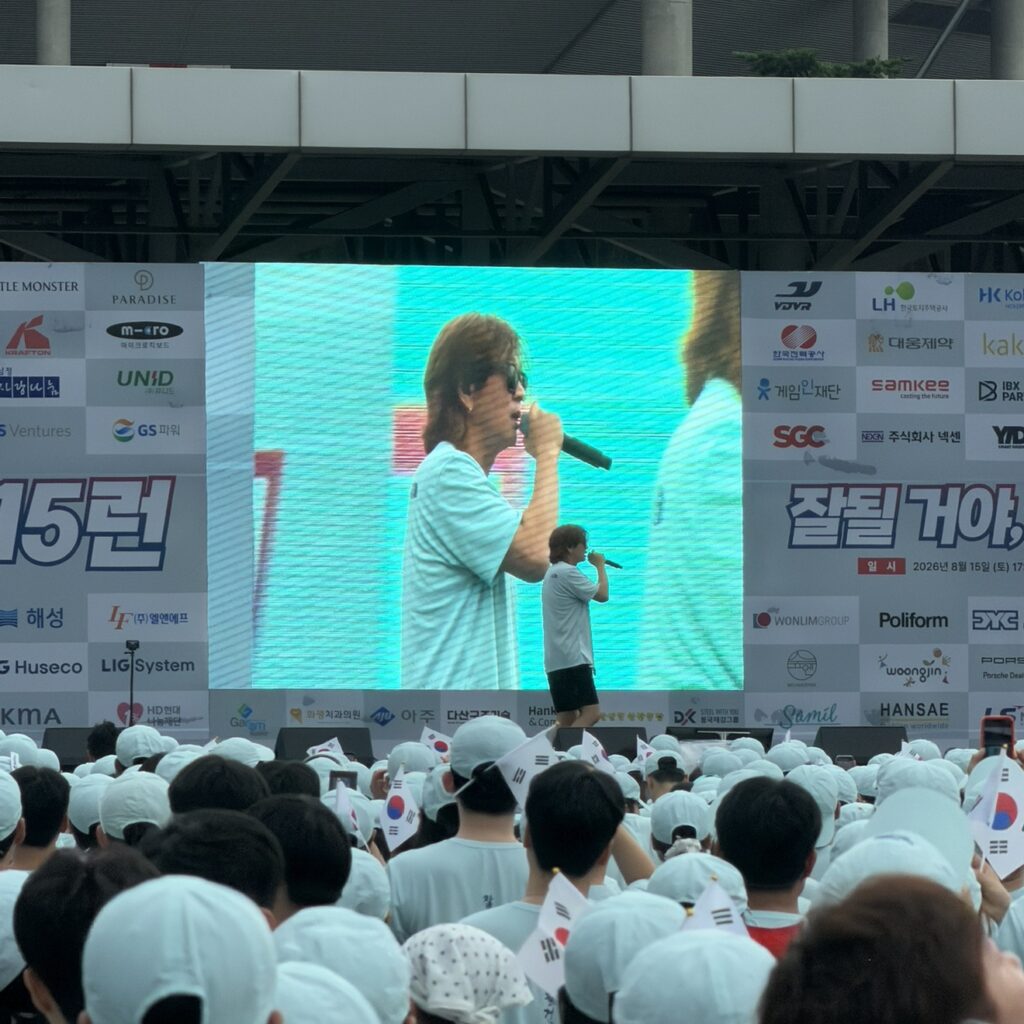
러닝 이후에도 행사의 열기는 계속됐다. 현장에서는 션과 가수 윤도현의 특별 공연이 펼쳐졌으며, 참가비와 기업 후원금 등을 통해 모인 총 26억 482만 1,750원의 기부금도 전달됐다. 기부금은 전액 독립유공자 후손 가정의 주거환경 개선 사업에 사용될 예정이다.
“애국가가 흐르는 메달”…현장을 채운 임직원들의 소감
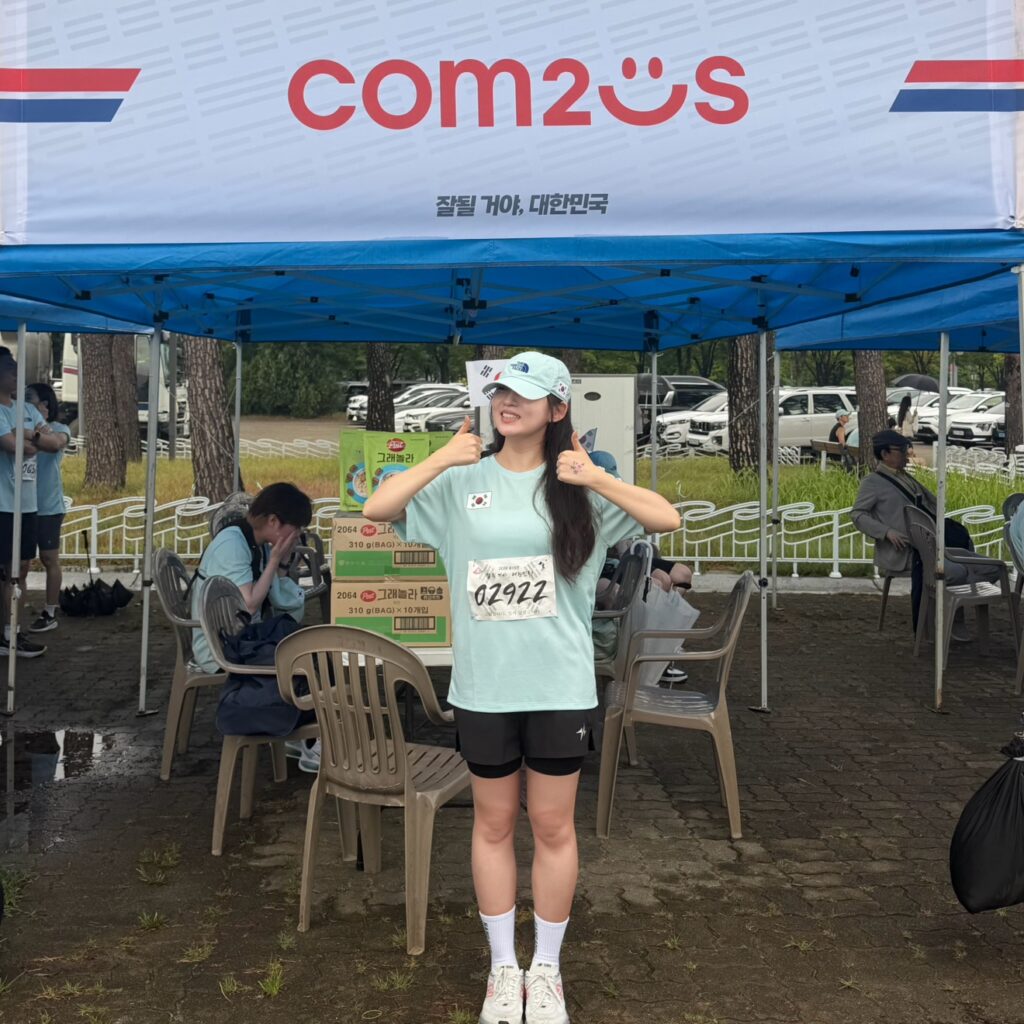
회사의 후원을 계기로 뜻깊은 현장을 직접 경험한 임직원의 소감도 전해졌다. 컴투스 현지화 담당자 홍○ 님은 “회사에서 815런을 후원한 덕분에 운 좋게 뜻깊은 행사에 참여할 수 있었다”며 “현장에는 정말 많은 분들이 함께하고 있었는데, 그만큼 많은 사람들이 독립유공자분들께 감사하는 마음을 간직하고 있다는 것이 느껴져 인상 깊었다”고 말했다. 이어 “축하 공연도 열정적이어서 전체적으로 축제 같은 분위기였고, 즐겁고 뭉클한 시간이었다”고 전했다.
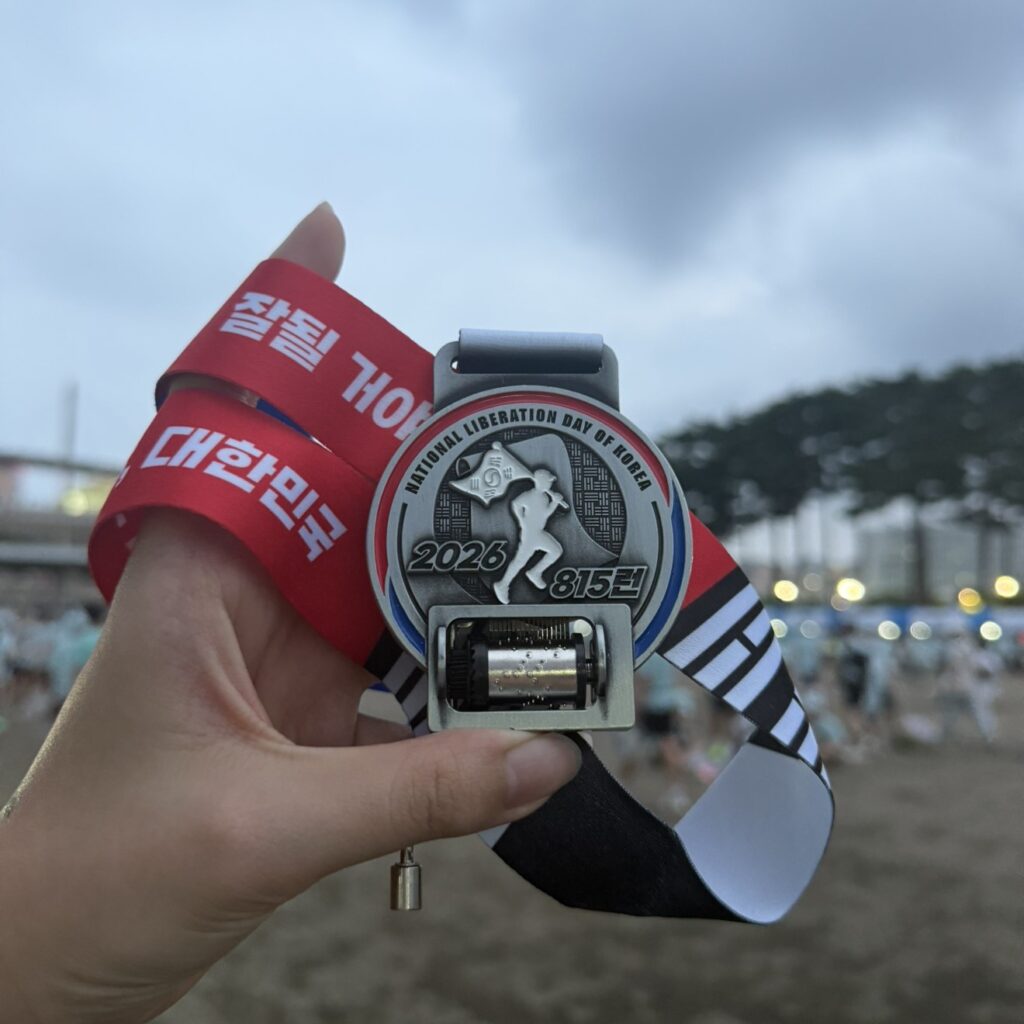
특히 완주 기념 메달이 깊은 인상을 남겼다. 그는 “메달이 기억에 남는다. 오르골 메달이라 돌리면 애국가가 나오는데, 디자인도 예쁘고 행사 취지와도 잘 어울려 더욱 의미 있게 느껴졌다”며 “단순한 완주 메달이 아니라 감사와 기억의 의미가 담긴 메달 같아 오래 간직하고 싶다”고 소감을 밝혔다.
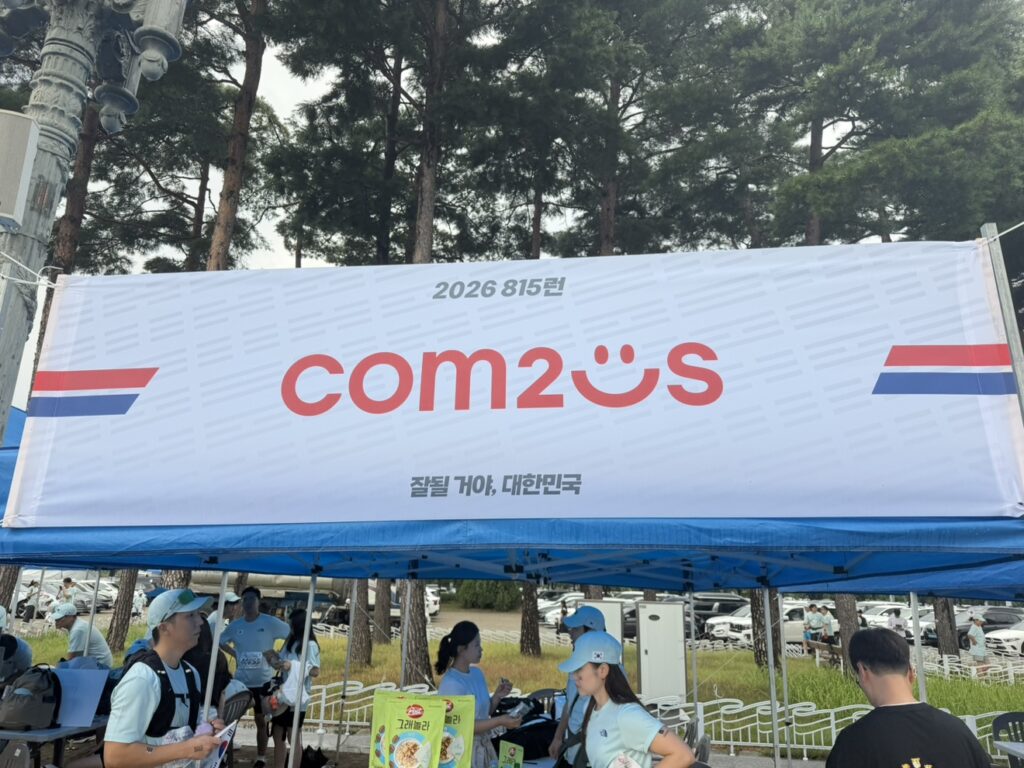
기업 후원에 그치지 않고 임직원들이 직접 현장에서 함께 달리며 광복절의 의미를 나눈 이번 ‘2026 815런’. 컴투스는 앞으로도 임직원과 함께하는 다양한 사회공헌 활동을 통해 나눔의 가치를 꾸준히 이어갈 예정이다.
내부 QA·직원 계정의 활동이 섞이면 매출, 로그인, 콘텐츠 참여 지표가 실제와 다르게 보인다. Hive 애널리틱스의 지표 제외 유저 관리에서 유저 ID 또는 디바이스 ID를 한 번 등록하면, 해당 유저의 이벤트 데이터가 모든 차트와 대시보드에 자동으로 제외된다. 계정이 많을 때는 파일로 한꺼번에 등록해 반복 설정 부담을 줄일 수 있다.
내부 활동이 섞인 지표
게임을 출시하거나 새로운 콘텐츠를 업데이트할 때는 내부 직원과 QA 담당자가 로그인, 구매, 보상 획득 등의 기능을 반복해서 점검한다. 이 과정에서 발생한 이벤트가 실제 유저 데이터와 함께 계산되면 접속자 수와 매출, 콘텐츠 참여 결과가 달라질 수 있다.
차트마다 테스트 계정을 필터로 지정할 수도 있지만 대상자가 많으면 설정을 반복해야 한다. 새 지표를 만들 때 일부 계정을 빠뜨리거나, 이미 사용 중인 여러 대시보드를 일일이 수정해야 하는 문제도 발생한다.
실제 유저 흐름을 확인해야 하는 게임 운영
운영 담당자는 라이브 이벤트와 업데이트 이후의 변화를 바탕으로 서비스 상태를 판단한다. 이때 점검을 위해 접속한 계정이나 테스트 결제 내역이 포함되면 실제 반응을 구분하기 어렵다.
특히 이벤트 시작 직후에는 내부에서 여러 기능을 확인하기 때문에 참여자 수나 구매 결과가 일시적으로 높아 보일 수 있다. 정확한 운영 판단을 위해서는 서비스 유저의 활동만 일관된 기준으로 살펴볼 필요가 있다.
Hive 애널리틱스의 지표 제외 유저 관리
Hive 애널리틱스의 지표 제외 유저 관리는 테스트 결제, QA 담당자와 내부 직원이 발생시킨 이벤트를 지표 수치에서 제외하는 기능이다. 프로젝트 단위로 계정을 한 번 등록하면 차트마다 같은 필터를 반복해서 추가하지 않아도 된다.
대상은 유저 ID 또는 디바이스 ID로 구분할 수 있으며, 계정이 많을 때는 파일로 한꺼번에 등록할 수 있다. 제외 대상으로 지정된 유저의 이벤트는 계속 수집되지만 수치에는 반영되지 않으며, 지표를 사용하는 차트와 대시보드에도 적용된다. 기존 분석 화면을 각각 수정하지 않고도 실제 서비스 유저를 중심으로 운영 현황을 확인할 수 있다.

실제 유저 기준으로 운영 상황 점검해보기
내부 계정을 제외한 지표는 매출과 로그인, 콘텐츠, 동시접속자처럼 운영 판단에 자주 사용하는 화면에 적용할 수 있다.
테스트 결제를 제외한 매출 흐름
상품 등록이나 결제 연동을 검증하는 과정에서 테스트 결제가 반복적으로 발생하면 매출, 구매 전환율, 유저당 평균 결제 금액(ARPU), 구매 유저의 유저당 평균 결제 금액(ARPPU) 등의 지표가 왜곡될 수 있다. 테스트에 사용된 계정을 제외하면 실제 유저 기준의 데이터를 바탕으로 반응을 정확하게 살펴볼 수 있다.

라이브 콘텐츠 참여 흐름
게임 시즌 이벤트 공개 전후에는 QA 담당자와 운영자가 로그인, 콘텐츠 상태를 반복해서 점검한다. 해당 활동을 분리하면 실제 참여 인원과 리텐션을 바탕으로 진행 상태를 판단할 수 있다.

업데이트 이후 동시접속자 추이
업데이트나 점검 직후에는 내부 인력이 먼저 접속해 주요 기능을 확인한다. 이 계정을 빼고 동시접속자 추이를 살펴보면 서비스 유저의 복귀 흐름과 운영 안정 여부를 더 명확하게 파악할 수 있다.

Hive 애널리틱스 시작해보기
Hive 애널리틱스 > 설정 > 메트릭 설정 > 지표 제외 유저 관리 메뉴에서 테스트를 위한 내부 계정과 QA 담당자의 유저 ID 또는 디바이스 ID를 지표 제외 대상으로 등록할 수 있다. 제외할 계정이 많은 경우 파일 업로드를 통해 간편한 등록이 가능하다. 제외 계정 목록을 정기적으로 업데이트해 분석 기준을 지속해서 관리할 수 있다.
Hive 애널리틱스는 Hive SDK에서 자동으로 수집되는 로그인·구매 등의 플랫폼 이벤트와 게임에서 전송한 커스텀 이벤트를 실제 유저 중심으로 확인할 수 있다.
지금 Hive 애널리틱스의 지표 제외 유저 관리로 테스트 활동을 분리하고, 게임 운영에 필요한 수치를 정확하게 살펴보자.
활성 사용자(AU), 매출처럼 자주 쓰는 지표도 계산 기준이 다르면 같은 기간을 조회해도 서로 다른 수치가 나온다. Hive 애널리틱스의 메트릭 기능을 사용하면 이벤트와 집계 방식, 계산식을 조합한 지표 정의를 하나로 저장해 여러 차트와 대시보드에서 재사용할 수 있다. 메트릭을 수정하면 이를 사용하는 모든 화면에 반영되므로, 조직 전체가 같은 기준으로 데이터를 보고 소통할 수 있다.
같은 이름, 다른 기준
AU, 매출, 구매 전환율처럼 자주 사용하는 지표는 이름이 같아도 계산 기준에 따라 결과가 달라질 수 있다. 어떤 이벤트를 사용했는지, 어떤 필터를 적용했는지, 어떤 필드를 기준으로 계산했는지에 따라 같은 기간을 조회해도 서로 다른 수치가 나타난다.
지표를 차트마다 개별적으로 설정하면 이러한 차이를 알아차리기 어렵다. 회의나 보고 과정에서 수치가 다르다는 사실을 발견하면 데이터의 변화를 해석하기 전에 각 지표의 계산 기준부터 다시 확인해야 한다.
따라서 조직이 데이터를 원활하게 활용하려면 반복해서 사용하는 지표의 정의와 계산 방식을 하나의 기준으로 관리할 필요가 있다.
공통 지표가 필요한 협업
여러 직무가 같은 지표를 함께 활용하려면 먼저 조직에서 공통으로 사용할 기준이 필요하다. 이를 메트릭으로 정의하면 운영·기획, 마케팅, 사업 담당자는 같은 수치를 각자의 업무에 활용할 수 있다.
특히 조직이 중요하게 보는 이용자 행동과 성과를 메트릭으로 관리하면, 여러 담당자가 같은 관점으로 데이터를 해석하고 논의할 수 있다.

운영·기획 담당자는 업데이트 이후의 변화를 점검하고, 마케팅 담당자는 유입 경로나 국가별 결과를 비교할 수 있다. 사업 담당자는 동일한 수치를 바탕으로 성과를 보고하고 다음 방향을 결정할 수 있다.
이와 달리 담당자마다 지표를 새로 만들면 이벤트와 집계 방식이 달라질 수 있다. 같은 이름의 지표가 여러 개 생성되거나 설명이 충분하지 않으면 어떤 수치를 기준으로 삼아야 하는지 판단하기 어려워진다.
정책이나 분석 목적이 바뀌어 계산식을 수정할 때도 관련 차트를 하나씩 변경하면 일부 화면이 누락될 수 있다. 기존 기준과 새로운 기준이 함께 사용되면 보고 자료와 대시보드 사이에도 수치 차이가 발생한다.
Hive 애널리틱스의 메트릭 관리
Hive 애널리틱스의 메트릭은 차트에서 자주 사용하는 지표 설정을 저장하고 재사용하는 기능이다. 기본적으로 이용자, 구매 등 자주 쓰이는 지표가 플랫폼 메트릭으로 제공되어 별도 설정 없이 바로 활용할 수 있다. 플랫폼 메트릭은 지표 기준의 통일성을 위해 수정이나 삭제가 불가능하다. 하지만 필요한 경우 조직이나 프로젝트의 특정 목적에 맞게 조건과 수식을 직접 조합하여 커스텀 메트릭으로 추가할 수 있다. SQL을 몰라도 UI에서 이벤트, 속성값, 집계 방식 및 수식을 자유롭게 조합할 수 있어, 데이터 분석가가 아니더라도 업무에 필요한 지표를 하나의 메트릭으로 쉽게 만들어 저장할 수 있다.
COUNT, COUNT DISTINCT, SUM, AVG 등을 활용해 이벤트 발생 횟수, 고유 이용자 수, 매출 합계, 평균값으로 정의할 수 있다. 제목과 설명에 계산 방식과 활용 목적을 기록하고, 이용자·매출·세션·게임 플레이 등의 카테고리로 분류한 뒤 여러 차트에서 반복해 활용할 수 있다.


메트릭의 계산 기준을 변경하면 해당 메트릭을 사용하는 모든 차트와 대시보드에 변경 내용이 반영된다. 여러 화면을 개별적으로 수정하지 않아도 같은 기준을 유지할 수 있지만, 수정과 동시에 관련 수치가 달라질 수 있으므로 변경 전에 영향 범위를 확인해야 한다.
공통 지표 기준 만들어보기
메트릭은 하나의 이벤트를 기준으로 만들거나, 두 개 이상의 이벤트와 수식을 조합해 정의할 수 있다. 필요한 조건은 이벤트 필터로 설정할 수 있어 다음과 같은 방식으로 공통 지표를 구성할 수 있다.
단일 이벤트로 메트릭 생성하기
하나의 이벤트에서 확인할 필드를 선택하고 계산 방식을 적용해 메트릭을 만들 수 있다. 예를 들어 로그인 이벤트의 기기 식별자를 고유 개수로 계산하면 일정 기간에 접속한 기기 수를 기준으로 AU를 정의할 수 있다.

두 개 이상의 이벤트와 수식으로 메트릭 생성하기
두 개 이상의 이벤트에서 필요한 값을 각각 계산한 뒤 사칙연산으로 하나의 메트릭을 만들 수 있다. 예를 들어 구매 이용자 수와 로그인 이용자 수를 조합하면 구매 전환율처럼 여러 데이터를 함께 계산하는 지표를 공통 기준으로 정의할 수 있다.

이벤트 필터를 적용해 메트릭 생성하기
메트릭에 사용할 이벤트를 선택할 때 필드를 기준으로 필터를 적용할 수 있다. 로그인 이벤트에서 KR 또는 US 국가를 조건으로 지정하는 것처럼 필요한 데이터만 포함해 목적에 맞는 메트릭을 만들 수 있다.

이렇게 설정한 메트릭은 차트와 대시보드에서 확인할 수 있다. 메트릭의 계산 기준을 수정하면 이를 사용하는 모든 화면에 변경 내용이 자동으로 반영되어 같은 기준을 유지할 수 있다.

Hive 애널리틱스 시작해보기
공통 지표는 조직이 데이터를 기반으로 소통하기 위한 기준이다. 같은 이름의 지표를 각자 만들기보다 반복해서 사용하는 계산 방식을 메트릭으로 관리하면 수치 차이를 줄이고 분석 기준을 명확하게 공유할 수 있다.
Hive 애널리틱스는 Hive SDK를 연동하면 60여 가지의 게임 표준 이벤트를 자동으로 수집하고, 게임에서 추가로 확인할 행동은 커스텀 이벤트로 자유롭게 정의해 전송할 수 있다. 이렇게 수집한 이벤트를 조합해 조직의 목적에 맞는 다양한 메트릭을 구성할 수 있다.
지금 Hive 애널리틱스의 메트릭으로 공통 지표를 관리하고, 같은 기준의 수치로 분석과 의사결정에 활용해보자.
출산과 육아는 한 사람의 삶에서 가장 큰 변화 중 하나다. 하지만 회사 생활과 함께 준비해야 하는 과정인 만큼 기대만큼이나 걱정도 따른다. 특히 임신 기간에는 병원 검진부터 컨디션 관리, 업무 조율까지 세심한 배려와 제도적 지원이 무엇보다 중요하다.
컴투스는 임신·출산·육아를 앞둔 구성원들이 보다 안정적으로 일과 가정을 함께 준비할 수 있도록 다양한 복지 제도를 운영하고 있다. 실제로 이를 경험한 구성원들은 어떤 도움을 받았고, 어떤 순간에 회사의 배려를 느꼈을까.
올해 9월 출산을 앞둔 서비스디자인실 ‘젤콩맘’을 만나 컴투스에서의 임신·출산 경험과 서비스디자이너로 일하는 이야기, 그리고 예비 엄마의 가방 속 필수 아이템까지 들어봤다.
PART 1. 컴투스에서의 임신·출산 경험

간단한 자기소개 부탁드립니다.
안녕하세요~ 야구 게임 마케팅·운영 디자인을 담당하고 있는 젤콩맘입니다. 저는 올해 9월 출산 예정인 예비 딸맘이에요~!
닉네임에 태명을 활용하셨다고요. 태명을 소개해주세요.
지금 아이 태명은 젤콩이인데요! 저희 남편이 젤리랑 만두를 섞어놓은 것처럼 생겨서 연애 때부터 젤리만두라고 연락처를 저장해뒀거든요! 그래서 아기도 젤리+콩=젤콩이로 정하게 되었어요! 특별한 이유는 없고 부를 때 귀여워서 이렇게 부르게 되었어요!
임신 소식을 처음 알았을 때 가장 먼저 들었던 생각은 무엇인가요?
막상 임신이 되었을 때 큰 변화가 있을 줄 알았는데, 임신 초반에는 특별한 증상이 없어서 오히려 실감이 잘 안 났고 내 배에 생명이 있다는 게 조금은 얼떨떨한 느낌이었어요. 지금은 태동도 느끼고 그러니까 이제야 정말 내가 엄마가 되었구나를 실감 중입니다.
임신 사실을 팀에 알렸을 때 팀원들의 첫 반응이 어땠나요?
팀원분들이 정말 자기 일처럼 기뻐해 주셨어요. 컴투스에 입사해서 연애도 하고, 결혼도 하고, 이제는 임신까지 인생의 중요한 순간들을 모두 함께하다 보니 더 진심으로 축하해주신 것 같습니다. 덕분에 “컴투스에서 좋은 일은 다 있었네?”라는 생각도 들었어요.
팀원들의 배려 중 특히 기억에 남는 에피소드가 있나요?
옆자리 대리님이 점점 불러오는 배를 보시고 가끔 “젤콩아, 잘 있니?” 하며 배에 인사를 건네주시곤 하는데요. 처음에는 민망하고 웃겼는데 그런 관심에서 따뜻한 마음이 느껴져서 정말 감사했습니다. 또 팀원분들도 마주칠 때마다 몸 상태는 어떤지, 태동은 느껴지는지 자연스럽게 안부를 물어봐 주셔서 임신 기간 동안 많은 응원과 관심을 받고 있다는 느낌을 받았습니다.
임신 기간 동안 컴투스의 제도 중 실질적으로 도움이 됐던 것이 있다면 소개해주세요.
여러 좋은 제도가 많았는데요! 그중에서 태아 검진 연차가 많이 도움된 것 같아요! 태아 검진 하러 갈 때 개인 연차를 사용하지 않아도 회사에서 검진 연차로 적용해주시는데요. 아무래도 검진을 매번 가다 보니까 개인 연차로 소진하게 되면 연차가 부족하기도 하고, 예약 시간도 병원 스케줄에 따라 다르다 보니 반차나 시간 연차로 사용하기 버거운 일정들이 많거든요. 검진 연차가 따로 있어서 부담 없이 편하게 병원을 다녀올 수 있어서 좋아요!
임신 중 업무를 이어가면서 가장 힘들었던 순간은 언제였나요? 어떻게 극복하셨나요?
임신 후반기에 접어든 지금이 가장 힘든 시기인 것 같아요. 아기가 커지면서 소화도 잘 안되고 허리가 아파서 장시간 앉아 있기가 쉽지 않더라고요. 그래서 식사 후에는 꼭 짧게라도 산책을 하고, 업무 중에도 스트레칭이나 가벼운 움직임으로 몸의 피로를 풀어주고 있습니다. 퇴근 후에는 충분히 쉬면서 좋은 컨디션을 가지려고 노력 중이에요!
회사를 다니면서 “여기서 아이를 낳아도 되겠다”는 확신이 생긴 순간이 있었나요?
가장 큰 순간은 육아휴직이 보장되는 문화였습니다. 육아휴직 기간이 길다 보니 신청을 앞두고 여러 걱정이 있었는데, 먼저 휴직을 다녀오신 분들과 팀원분들이 오히려 “걱정하지 말고 편하게 다녀오라”고 격려해주셨어요.
주변을 보면 아직도 육아휴직 사용에 눈치를 보거나 복직에 대한 부담을 느끼는 경우가 많은데, 컴투스에서는 그런 걱정보다 아이와 가족에게 집중할 수 있도록 응원해주는 분위기가 인상적이었습니다. 그 덕분에 “이곳이라면 안심하고 아이를 낳고 키울 수 있겠다”는 확신을 갖게 되었습니다.
컴투스의 임신·출산·육아 복지 중 자랑하고 싶은 것이 있다면요?
가장 자랑하고 싶은 복지는 임신 기간 내내 적용되는 단축근무 제도입니다. 임신 중에는 업무뿐 아니라 출퇴근 자체도 큰 부담이 될 수 있는데, 컴투스는 임신 기간 동안 지속적으로 근무시간을 조정할 수 있어 훨씬 안정적으로 일할 수 있었습니다. 실제로 비슷한 시기에 임신한 친구들과 비교해봐도 제도적인 지원 폭이 넓다는 것을 체감했습니다. 덕분에 건강을 잘 관리하면서도 업무를 이어갈 수 있었고, 회사의 세심한 배려를 가장 크게 느낄 수 있었던 복지였습니다.
곧 출산휴가에 들어가시는데, 복직 후에 대한 기대나 걱정이 있다면요?
아무래도 급변하는 AI 시대에 휴직하다 보니 복직 후에 얼마나 많은 것이 바뀌어있을까에 대한 두려움이 조금 있는 것 같아요! 그래도 복직해서 열심히 적응하고 노력하면 잘 해낼 수 있지 않을까 하는 마음도 있어서, 일단 휴직 동안에는 육아에 전념하고, 복직 후에는 일과 육아 열심히 해내보려고 합니다!
PART 2. 서비스디자이너 이야기

서비스디자인실은 어떤 역할을 하는 조직인가요?
서비스디자인실은 게임 서비스에 필요한 다양한 디자인 콘텐츠를 제작하는 조직입니다. 게임에 사용되는 운영 배너, 프로모션 페이지, SNS 콘텐츠, 마케팅 제작물 등 다양한 디자인 작업을 하고 있습니다. 그중 제가 속한 파트는 야구 게임들 디자인 업무를 주로 작업하고 있습니다.
서비스디자인 업무에 꼭 필요한 역량은 무엇인가요?
센스 있는 디자인 역량은 기본이고, 다양한 부서와 협업하는 만큼 원활한 커뮤니케이션 능력도 중요하다고 생각합니다. 또 업무 스케줄에 맞춰 계획을 세우고 정해진 일정 안에 결과물을 완성해야 하기 때문에 꼼꼼한 일정 관리 능력도 필요해요. 저도 원래는 즉흥적인 성향이 강한 편이었는데, 업무를 하면서 점점 계획적인 성향으로 바뀌게 됐습니다. 덕분에 업무를 관리하고 처리하는 데도 훨씬 익숙해지고 편해진 것 같아요. P도 사회적 J가 될 수 있답니다😊
야구 게임 디자인만의 매력이 있다면요?

야구 게임 디자인의 가장 큰 매력은 실제 프로야구 시즌과 함께 호흡할 수 있다는 점입니다. 시즌 이슈에 맞춰 다양한 이벤트와 콘텐츠를 기획하고, 때로는 구장이나 여러 매체에서 제가 작업한 디자인을 실제로 만나볼 수 있어요. 특히 주변 야구 팬들이 “이거 네가 만든 거 아니야?” 하면서 사진을 찍어 보내줄 때면 정말 뿌듯합니다.

또 야구 게임은 시즌마다 다양한 콜라보와 오프라인 행사도 많아서 작업 범위가 굉장히 넓은 편이에요. 덕분에 한 가지 디자인만 반복하는 것이 아니라 여러 매체와 콘셉트를 경험할 수 있다는 점도 큰 재미입니다. 야구도 보고, 디자인도 하고, 가끔은 제가 만든 결과물이 야구장까지 진출하는 게 이 직무만의 매력인 것 같아요! ⚾
실제로 야구를 좋아하시나요?
원래는 야구에 큰 관심이 없었어요^^.. 그러다가 야구 게임 디자인을 하다 보니 야구에 대해 관심을 가지려고 기본적인 경기 규칙이나 선수들에 대해 찾아보고, 야구를 좋아하는 남편 따라서 같이 직관도 가고 응원도 하면서 점점 재미를 느끼게 됐습니다.

결혼 후에는 집에서도 함께 경기를 보면서 룰과 선수들에 대해 더 많이 알게 됐어요. 그러다 보니 어느새 응원하는 팀도 생겼고, 지금은 당당한 기아 팬이 됐습니다. 야구 게임을 만들다 야구 팬까지 된 셈이네요. 기아 짱! 박재현 선수도 짱입니다! ⚾️💛❤️
디자인 작업을 할 때 가장 중요하게 생각하는 기준은 무엇인가요?
기획서에서 전달하고 싶은 메시지를 얼마나 쉽고 재밌게 풀어내는지가 중요한 것 같아요. 같은 내용이라도 어떻게 표현하느냐에 따라 전달력이 달라지니까요. 그래서 평소에도 다양한 디자인이나 콘텐츠를 많이 보면서 “이건 이렇게 표현했네?” 하고 아이디어를 모으려고 노력하는 편입니다. 결국 디자인도 센스와 경험이 쌓일수록 더 좋아지는 것 같아요!
팀 자랑을 한다면?
저희 실은 실장님과 팀장님들께서 구성원들의 성장과 교육에 늘 많은 관심을 가지고 지원해주시고, 팀원들끼리도 서로 도우며 협업하는 분위기가 잘 형성되어 있어요! 함께 일하는 동료를 넘어 서로를 진심으로 응원하고 챙겨주는 따뜻한 분위기예요! 최고최고! 이렇게 좋은 팀분들을 만날 수 있어 늘 감사한 마음입니다! 서디실 최고!
PART 3. In My Bag

출근 가방을 소개해주세요.
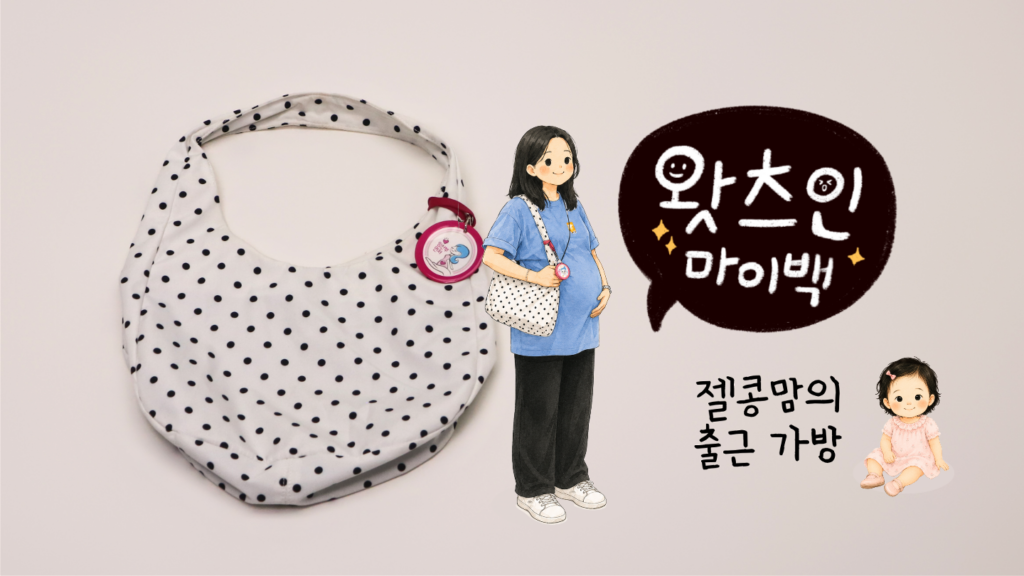
저의 여름 애착가방을 소개합니다..ㅎㅎ 나이 들수록 점점 짐이 많아지다 보니 가방은 무조건 가볍고 편한 걸로 찾게 되더라고요! 그래서 제가 에코백이 많은 편인데 이건 작년 여름에 샀던 가방이에요! 저는 지하철로 이동하다 보니 사람에 치이고, 어디서 뭐가 묻을지 몰라서 오염에도 마음이 안 아플 친구들로 가지고 다녀요 ㅋㅋ 더러워지면 쓱 빨면 되니까 편리하고, 가방 자체가 가볍고 어떤 옷에도 잘 어울려서 요즘 잘 들고 다니는 가방이에요!
출퇴근 루트가 어떻게 되세요? 임산부 배지를 차고 계신데, 실제로 자리 양보를 받아 앉아서 오시는 편인가요?
저는 집에서 회사까지 도어투도어로 약 1시간 20분 정도 걸리고, 지하철 1호선을 이용해 출퇴근하고 있습니다.
임신 초기에는 배가 많이 나오지 않은 시기라 임산부 배지를 착용하고 있어도 주변에서 임산부임을 알아보기 어려웠던 것 같아요. 그래서 임산부석을 이용할 때도 자리를 양보받기 쉽지 않은 경우가 많았어요 ㅜㅜ 그래서 비교적 혼잡도가 낮은 구로행 열차를 타거나 사람이 몰리는 시간을 피해 출퇴근하면서 나름의 생존 방식을 찾아서 다니고 있습니다!
임신 후 가방 속에 새롭게 추가된 아이템이 있다면요?
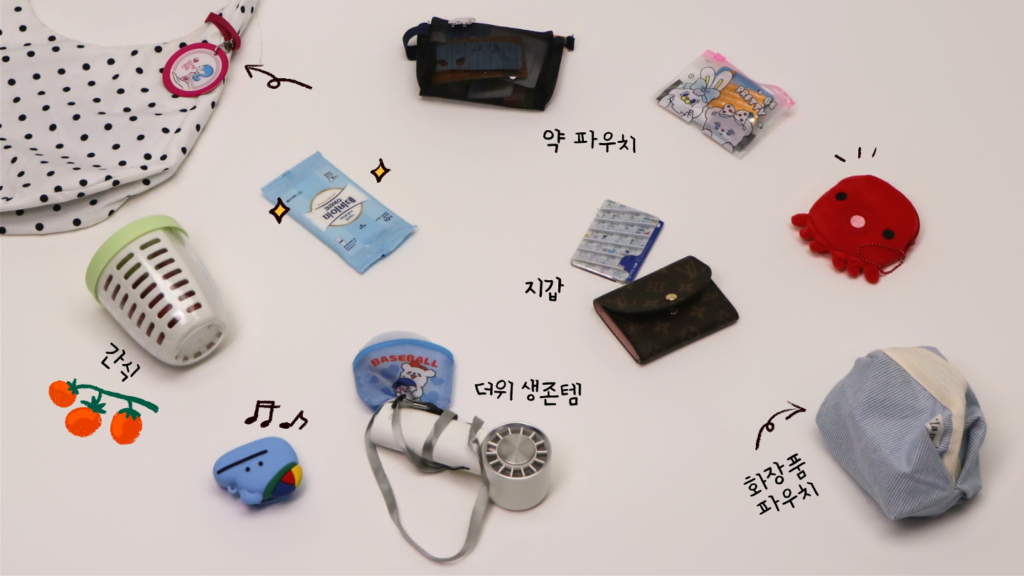
임신 후 제 가방은 거의 이동식 영양제 보관함이 됐어요. 원래도 영양제를 챙겨 먹는 편이었는데, 임신 후에는 시기별로 챙겨야 할 영양제가 많아져서 항상 파우치에 넣고 다니고 있습니다. 요즘은 오메가3, 비타민 D, 철분제가 고정 멤버예요! 그리고 빠질 수 없는 게 간식인데요. 출근하고 나면 생각보다 금방 배가 고파져서 과일이나 간단한 간식을 꼭 챙겨 다닙니다. 이제는 지갑보다 영양제랑 간식이 더 중요한 가방 속 필수품이 된 것 같아요.
약 파우치 속을 공개해주세요.
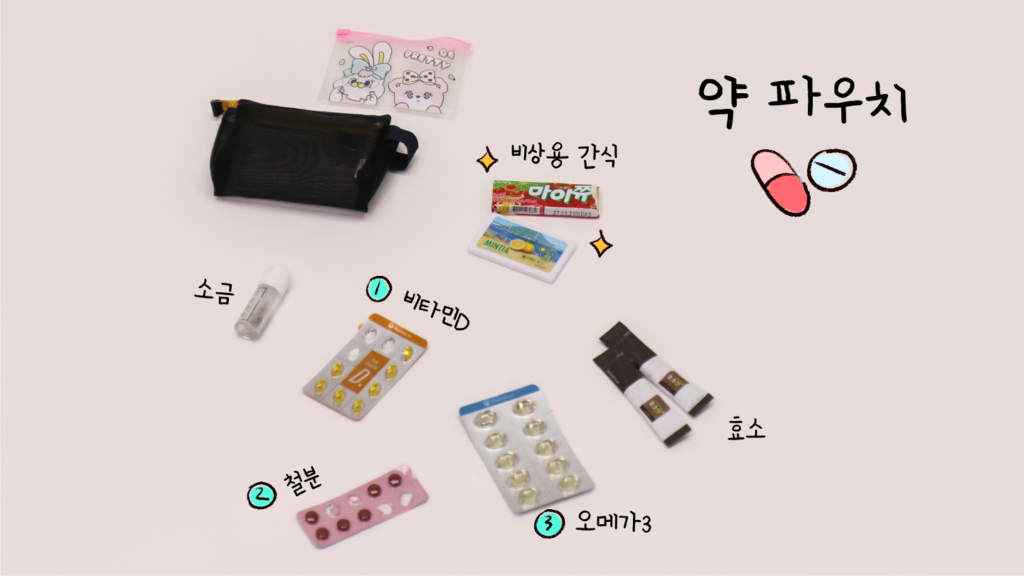
약 파우치 속 영양제들은 사실 제 의지보다 병원 선생님의 가이드에 더 충실한 결과물입니다. 임신 주차별로 필요한 영양제를 안내해주셔서 지금은 비타민 D, 철분, 오메가3를 열심히 챙겨 먹고 있어요.
브랜드는 이것저것 시도해보다가 저랑 잘 맞는 제품으로 정착했고요. 요즘은 워낙 좋은 제품이 많아서 ‘정답 찾기’보다는 ‘나랑 잘 맞는 제품 찾기’가 중요한 것 같습니다. 그래서 처음에는 한 달분 정도만 구매해서 테스트해보는 걸 추천드려요!
효소와 죽염은 각각 언제 드시나요?
효소는 원래도 소화기가 약한 편이라 임신 전부터 자주 챙겨 먹었는데요. 지금도 가끔 소화가 잘 안 되거나 더부룩할 때는 효소를 하나씩 먹고 있습니다.
죽염도 임신 전부터 챙겨 먹던 아이템인데요. 원래 잇몸이 약한 편이라 팀 대리님의 추천으로 먹기 시작했습니다. 임신 후에는 조금만 피곤하거나 컨디션이 떨어져도 잇몸이 예민해질 때가 있는데, 그럴 때마다 챙겨 먹으면 도움이 되는 것 같아요. 덕분에 지금까지도 가방 속 고정 멤버로 함께 다니고 있습니다.
비상용 간식도 꼭 챙겨 다니시나요?
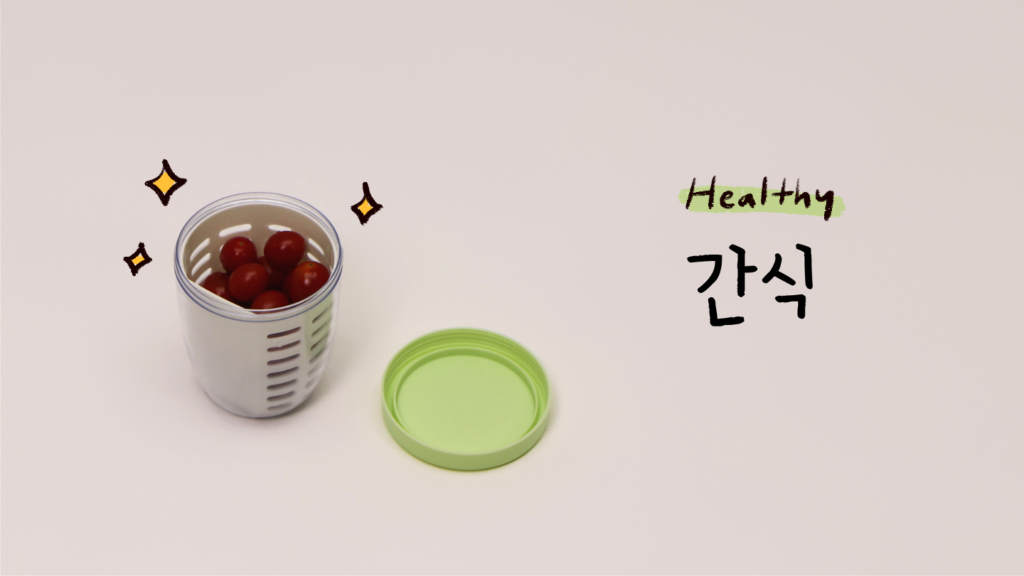
네, 비상용 간식은 꼭 챙겨 다니는 편입니다! 원래는 빵이나 과일, 고구마 같은 구황작물을 자주 챙겨 다녔는데요. 임당 검사 때 다행히 커트라인으로 통과하긴 했지만, 의사 선생님께서 탄수화물 섭취를 조금 조절하라고 하셔서 요즘은 방울토마토처럼 가볍게 먹을 수 있는 간식을 챙기고 있습니다.


임신하면 괜히 “이제 많이 먹어도 되겠지?” 생각하기 쉬운데, 막상 건강하게 관리하려면 더 신경 써야 하더라고요. 그래서 요즘은 배고픔도 달래고 건강도 챙길 수 있는 간식을 찾으려고 노력하고 있습니다.
화장품 파우치도 소개해주세요. 임신 후에도 화장을 자주 하시나요?
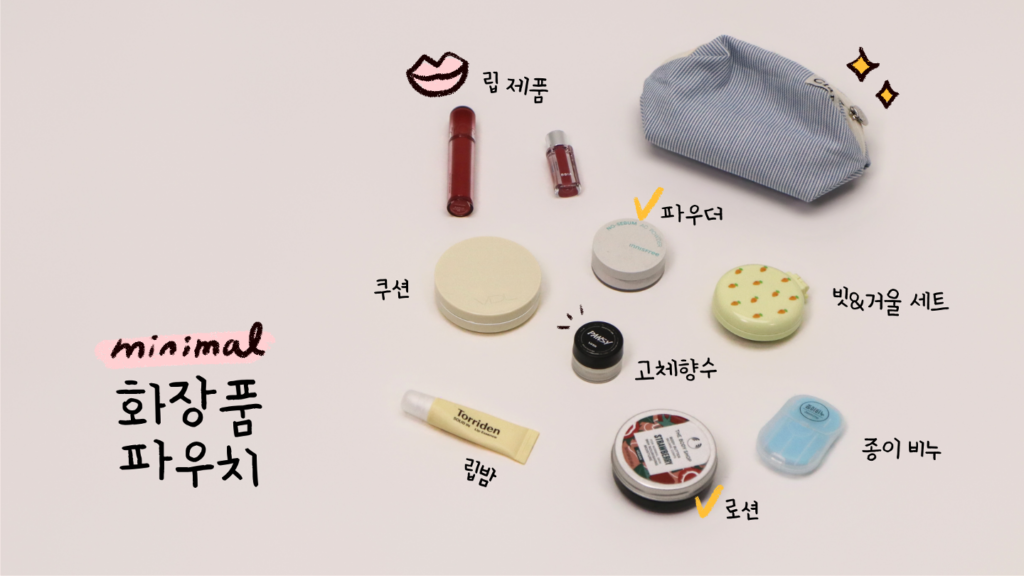
제 화장품 파우치는 굉장히 미니멀한 편입니다. 😂 평소 진한 화장을 하지 않아서 꼭 필요한 것들만 챙겨 다니는데요. 여름철 필수품인 파우더와 건조할 때 사용하는 로션 정도가 고정 멤버입니다. 특히 요즘은 입술이나 피부가 쉽게 건조해져서 로션을 자주 찾게 되더라고요. 개인적으로 좋은 향이 나면 기분이 좋아지는 편이라, 향이 은은하게 나는 제품을 선호하고 있습니다.
사실 임신 후에는 화장을 더 안 하게 된 것 같아요. 아침 출근 시간에는 화장보다 잠을 선택하는 날이 훨씬 많아요 😆 땀도 많이 나니 금방 지워지기도 해서 요즘은 기초 케어만 신경 쓰고, 몸과 손이 쉽게 건조해져서 보습 제품은 꼭 챙겨 다니고 있어요. 임신 중에도 늘 예쁘게 꾸미고 다니시는 분들을 보면 정말 대단하고 멋지다는 생각이 들어요!
라이너, 비데 등 위생용품도 보이네요. 임신 중에 이런 아이템이 필요한 이유를 모르는 분들을 위해 설명해주세요.
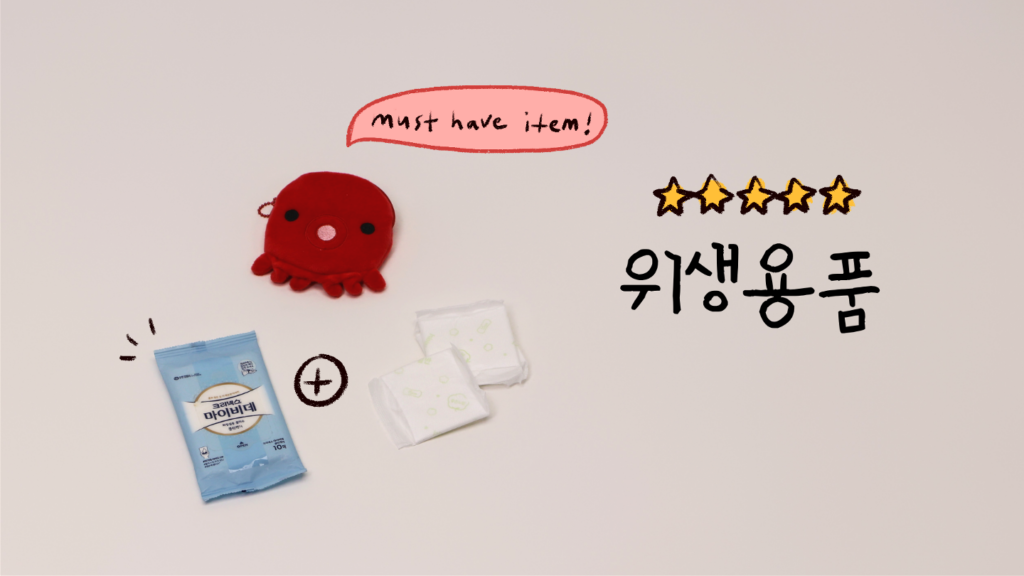
조금 민망한 이야기일 수 있지만, 임신 후에는 생각보다 위생용품이 필수템이 되더라고요. 😂 철분제를 꾸준히 먹다 보니 변비가 생기기도 하고, 또 몸에 변화가 생기면서 라이너도 빠질 수 없는 필수품이 됐습니다. 임신 전후로 가방 속 구성도 자연스럽게 달라진 것 같아요!
더위 생존템이 눈에 띄어요. 임신 전에도 더위를 많이 타셨나요?
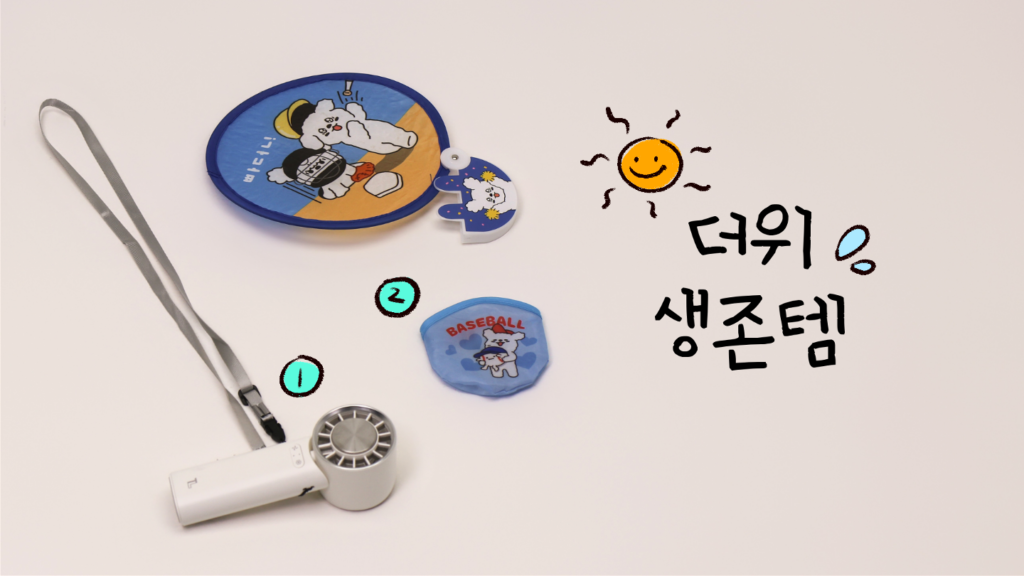
원래도 더위를 많이 타는 편이었는데, 임신 후에는 정말 체감상 두 배는 더 더워진 것 같아요. 보통 손선풍기는 한여름인 7~8월에 꺼내는 편이었는데, 올해는 5~6월부터 이미 에어컨과 선풍기 앞에서 생활하고 있습니다. 신기한 건 주변에서는 다들 괜찮다고 하는데 저만 유독 더워하는 경우가 많다는 거예요. 항상 몸에 열이 많은 느낌이라 조금만 움직여도 땀이 나고 금방 더워지더라고요ㅠㅠ
이 중에 출산 가방에 넣을 만한 아이템이 있다면요?
아직 출산 가방은 준비 전이라 뭘 넣어야 할지 열심히 찾아보고 있는 단계인데요. 그래도 지금 가방 속 아이템 중에서는 영양제 파우치와 위생용품은 꼭 챙길 것 같습니다. 특히 영양제는 이제 완전히 습관이 돼서 하루라도 안 먹으면 괜히 빠뜨린 것 같은 기분이 들더라고요. 출산하러 가는 날에도 자연스럽게 챙겨갈 것 같아요!
출산휴가를 앞둔 지금의 나에게 한마디를 남긴다면요?
건강하게 잘 순산하자! 😊 출산이 가까워질수록 기대도 되고 걱정도 되지만, 무엇보다 건강하게 젤콩이를 만나는 것이 가장 큰 목표입니다. 지금까지 잘 해온 것처럼 마지막까지 건강 잘 챙기고, 우리 둘 다 무사히 만나자. 화이팅!
언제 복직 예정이신가요?
저는 내후년 1월에 복직할 예정입니다! 새해 시작과 함께 새로운 마음으로 복직하고 싶어서 1월 1일에 맞춰 돌아오려고 해요. 그때는 육아와 일을 함께 해내는 워킹맘으로 새로운 도전을 시작하게 될 텐데요. 쉽지는 않겠지만, 젤콩이와 함께 한층 성장한 모습으로 잘 해내보겠습니다!
다시 출근할 미래의 나에게도 한마디 부탁드립니다.
미래의 나야!! 육아와 일을 병행하느라 바쁘지?! 하지만 분명 잘 해내고 있을 거야^^ 완벽하지 않아도 괜찮으니 건강하게 하루하루 즐겁게 살자~!! 행복은 가까이에!! 우리 가족 앞으로도 좋은 일만 가득하자~~ 화이팅!
게임 속에서 물은 보통 회복 아이템이나 하나의 속성 효과로 쓰이는 경우가 많다. ‘페이딩 에코(Fading Echo)’는 이 물이라는 소재를 전혀 다른 방식으로 풀어낸 작품이다.
이 게임에서 물은 주인공의 능력 그 자체다. 이동, 탐험, 기믹 해결, 전투까지 게임 전반을 관통하는 핵심 시스템으로 설계됐다. 주변 환경과 상호작용하며 다양한 원소를 조합해 문제를 해결해 나가는 과정이 페이딩 에코만의 가장 큰 매력이다.


페이딩 에코는 위기에 빠진 사막 행성 코렐(Corel)에서 자신의 과거를 찾고 미래를 지키기 위해 떠나는 주인공 ‘원(One)’의 여정을 그린다. 액션과 탐험, 다양한 환경 기믹을 하나로 엮으면서도 ‘물을 어떻게 활용할 것인가’라는 독특한 아이디어로 자신만의 색깔을 만들어낸 작품이다.


물, 능력이 되는 독특한 게임플레이

페이딩 에코에서 가장 눈에 띄는 부분은 역시 물을 활용한 플레이다.

주인공은 물로 변신하고 이를 자유자재로 다루는 특별한 능력을 사용한다. 적에게 물 속성 공격을 가하는 데 그치지 않고, 좁은 공간을 이동하거나 주변 환경을 바꾸는 등 다양한 방식으로 활용할 수 있다.
특히 흥미로운 지점은 같은 공간이라도 능력을 어떻게 쓰느냐에 따라 해결 방법이 달라진다는 점이다. 막힌 길 앞에서 새로운 길을 찾기보다, 지금 가진 물 능력을 어떻게 활용할지 고민하는 과정이 자연스럽게 이어진다. 직접 답을 찾아가는 탐험의 재미가 살아 있는 구조다.


원소 조합이 만들어내는 전략적인 전투
페이딩 에코는 물 하나만으로 완성되는 게임이 아니다.


게임 안에서는 물, 용암, 독성 물질 등 다양한 원소가 등장하고, 서로 다른 속성을 조합해 전투와 탐험 방식을 바꿀 수 있다. 적을 무작정 공격하기보다 상황에 맞는 능력을 고르고 주변 환경을 활용하는 것이 중요하다.


그 덕분에 전투 역시 공격 버튼을 반복하는 방식보다 “어떤 방법으로 풀어낼까” 고민하는 재미가 크다. 낙사, 석화, 화상 같은 환경 요소 효과를 조합하면 빠르고 화려한 전투가 가능하다. 원소 시스템은 전투뿐 아니라 탐험과 기믹 해결에도 연결돼 게임 전체를 하나의 흐름으로 이어주는데, 플레이에 적응할수록 손에 익은 스킬처럼 자연스럽게 활용하게 된다.
페이딩 에코만의 독특한 분위기의 세상
글리치를 연상시키는 분위기 역시 페이딩 에코가 가진 매력 중 하나다.


붕괴해가는 세계와 신비로운 구조물이 공존하는 배경은 독특한 분위기를 자아낸다. 공중에 떠 있는 섬과 개성 있는 지역 디자인은 지나치는 공간이 아니라 직접 탐험하고 싶은 장소라는 느낌을 준다.


페이딩 에코는 화려한 비주얼을 앞세우기보다 세계관과 게임 시스템이 자연스럽게 맞물리는 방향을 택했다. 새로운 지역을 탐험하며 세계의 비밀을 알아가고, 주인공이 가진 능력의 의미를 조금씩 발견해가는 과정이 이 게임의 또 다른 재미다.
페이딩 에코 속 디테일, 화려한 성우진
게임의 몰입감을 결정짓는 가장 강력한 요소 중 하나는 캐릭터에 생명력을 불어넣는 목소리다. 스피커 너머로 들려오는 페이딩 에코의 스토리텔링에서 시네마틱하다는 인상을 받았다.
아니나 다를까, ‘발더스 게이트 3’에서 깊이 있는 연기를 선보인 사만다 베어트(Samantha Béart), 재스민 불러(Jasmine Bhullar), ‘더 라스트 오브 어스 파트 II’의 로라 베일리(Laura Bailey), 크리티컬 롤로 잘 알려진 리암 오브라이언(Liam O’Brien) 등 묵직한 캐릭터를 연기해온 성우진이 대거 참여했다.
매 장면마다 시네마틱 영화를 보는 듯한 몰입감은 대사 텍스트 너머의 감정을 전달하는 이들의 연기와 맞물려 게임의 숨은 디테일을 완성한다.
인디 개발사의 아이디어에서 시작된 특별한 프로젝트
페이딩 에코는 프랑스의 퍼블리셔 뉴테일즈 산하의 개발 스튜디오 Emeteria의 독창적인 아이디어가 돋보이는 작품이다. 특히 ‘물을 활용한 액션 어드벤처’라는 콘셉트는 흔히 볼 수 있는 소재가 아니다. 이 아이디어를 하나의 설정에 머무르지 않고 이동, 기믹 해결, 전투까지 연결되는 핵심 시스템으로 발전시켰다는 점이 인상적이다.
흥미로운 부분은 페이딩 에코의 세계관이 처음부터 하나의 게임만을 위해 만들어진 것이 아니라는 점이다.초기에는 테이블 RPG 형태의 아이디어에서 출발했다. 작은 아이디어가 하나의 게임 세계로 확장되고, 실제 플레이 가능한 작품으로 완성되어 가는 과정은 인디 게임만이 보여줄 수 있는 매력이다.


스팀에서 만나는 페이딩 에코
페이딩 에코는 Emeteria의 독창적인 게임 디자인에 뉴테일즈(New Tales)와 컴투스홀딩스의 글로벌 퍼블리싱 경험이 더해진 게임이다. 컴투스홀딩스는 이번 퍼블리싱을 통해 더 많은 플레이어에게 새로운 액션 어드벤처 경험을 전하고 있다. 개성 있는 아이디어에 글로벌 서비스 경험이 더해져 스팀이라는 글로벌 플랫폼에서 어떤 가능성을 보여줄지 기대되는 지점이다.

페이딩 에코, 영상으로 만나기
페이딩 에코의 가장 큰 특징인 물 능력과 원소 조합 시스템은 글과 스크린샷만으로는 온전히 느끼기 어렵다. 이 느낌은 공식 런치 트레일러에서 영상으로 직접 확인할 수 있다.
게임 속 이동 방식과 전투 장면, 다양한 환경 요소와 분위기를 미리 살펴볼 수 있어 구매 전, 플레이 전 게임의 분위기를 엿보기 좋은 영상이다.
마무리
페이딩 에코는 익숙한 액션 어드벤처 장르에 ‘물’이라는 새로운 아이디어를 더한 작품이다. 물을 이용해 이동하고, 환경을 변화시키며, 전투와 다양한 기믹을 해결하는 과정이 하나의 시스템으로 자연스럽게 이어진다. 특히 새로운 게임 시스템을 경험하는 것을 좋아하거나 탐험과 환경을 활용하는 액션 게임을 선호한다면 만족도가 높을 것이다.
평범해 보이는 ‘물’이라는 소재를 새로운 방식으로 풀어낸 페이딩 에코(Fading Echo). 올여름 색다른 모험과 새로운 어드벤처 게임 플레이를 찾고 있다면, 페이딩 에코를 주목해보길 바란다.
ⓘ 확률형 아이템 포함
오픈AI(OpenAI)가 오는 8월 31일, 서울에서 개최하는 게임 개발 해커톤 ‘오픈AI 게임 빌더스 서울(OpenAI Game Builders Seoul)’에 참여할 한국 대표 게임 개발자 12인의 라인업을 공개했다.
‘바람의나라’, ‘리니지’, ‘메이플스토리’, ‘던전앤파이터’, ‘애니팡’, ‘쿠키런’ 등 한국 게임 산업의 흐름을 만들어 온 전설적인 게임 개발자들이 한자리에 모인다. 이들은 치열한 예선 경쟁을 뚫고 올라온 40팀과 만나 멘토로서 개발 경험과 조언을 들려줄 예정이다. 온라인게임과 MMORPG의 태동기부터 모바일게임의 대중화와 글로벌 시장 진출에 이르기까지 서로 다른 시대와 장르에서 경험을 쌓아온 개발자들이 각자의 노하우를 공유하고, AI 코딩 에이전트 ‘코덱스(Codex)’를 활용한 새로운 게임 제작 방식의 가능성도 함께 살펴볼 예정이다.
컴투스 역시 이번 행사에 힘을 보탠다. 게임 개발부터 실제 출시와 운영 단계까지 이어지는 과정을 지원할 수 있도록 컴투스플랫폼의 게임 백엔드 플랫폼 하이브(Hive) 기반 AI 플러그인을 제공하며, 컴투스 AX HUB를 이끄는 박상준 이사도 개발자 라인업에 이름을 올렸다.
한국 게임 산업을 이끌어 온 개발자 12인이 한자리에
이번에 공개된 12인 라인업에는 앞서 참여가 알려진 송재경 전 엑스엘게임즈 대표를 비롯해 강대현 넥슨코리아 공동대표, 김대훤 에이버튼 대표, 박범진 아쿠아트리 대표, 반승철 세컨드다이브 대표, 이정웅 전 선데이토즈 대표, 임현수 전 선데이토즈 최고기술책임자, 김동규 하이디어 창업자, 고정환 슈퍼빌런랩스 공동대표, 홍성진 전 데브시스터즈 최고기술책임자, 이준희 아르투(Artue) 최고기술책임자, 박상준 컴투스 AX HUB 이사 등이 이름을 올렸다.
송재경 개발자는 ‘바람의나라’, ‘리니지’, ‘아키에이지’ 개발을 주도한 한국 온라인게임 1세대 개발자다. 최근에는 생성형 AI를 활용한 1인 MMORPG 프로젝트 ‘오픈 MMO’에 도전하며 AI 시대의 새로운 게임 개발 방식을 직접 실험하고 있다.
강대현 넥슨코리아 공동대표는 ‘던전앤파이터’ 개발 조직을 비롯해 넥슨 라이브본부와 인텔리전스랩스를 거치며 게임 개발과 라이브 서비스, 데이터 기술 고도화를 이끌어 왔다. 현재는 메이플본부장을 겸하며 장기간 서비스되고 있는 게임의 지속적인 개발과 성장을 총괄하고 있다.
박범진 아쿠아트리 대표는 ‘리니지2 레볼루션’과 ‘제2의 나라: 크로스 월드’를 통해 대규모 MMORPG의 경험을 모바일 환경으로 확장했으며, 이후 언리얼 엔진 5 기반 MMORPG ‘아키텍트: 랜드 오브 엑자일’을 선보였다.
반승철 세컨드다이브 대표는 모바일 액션 RPG ‘다크어벤저’ 시리즈로 전 세계 누적 1억 다운로드를 기록하고, ‘아레스: 라이즈 오브 가디언즈’를 통해 액션 중심의 플레이 경험을 MMORPG로 확장했다. 이 중 ‘아레스’는 컴투스홀딩스가 글로벌 퍼블리싱을 맡아 올해 3분기 중 ‘아레스: 더 아이언 뱅가드’라는 이름으로 글로벌 지역 정식 출시를 앞두고 있다. 서구권 게이머들의 입맛에 맞게 PvP보다는 PvE 요소 등을 강화한 것이 특징이다.

모바일게임 시장의 대중화를 이끈 개발자들도 함께한다. 이정웅 전 선데이토즈 대표는 2012년 ‘애니팡’의 개발과 사업을 이끌며 국내 모바일 소셜게임 시장의 성장을 이끌었다. 임현수 전 선데이토즈 최고기술책임자는 ‘애니팡’의 클라이언트와 서버, 소셜 기술을 총괄하며 대규모 모바일게임 서비스를 위한 기술 기반 구축에 참여했다.
김동규 하이디어 창업자는 ‘언데드 슬레이어’, ‘인간 혹은 뱀파이어’, ‘고양이와 스프’ 등 개성 있는 게임을 지속적으로 선보이며 글로벌 시장에서 성과를 만들어 왔다. 고정환 슈퍼빌런랩스 공동대표는 ‘메이플스토리’와 ‘던전앤파이터’의 개발 및 라이브 서비스를 거쳐 모바일 액션 RPG ‘크로커스’를 총괄했으며, 현재 새로운 RPG 개발을 이끌고 있다.
홍성진 전 데브시스터즈 최고기술책임자는 ‘쿠키런 for Kakao’와 ‘LINE 쿠키런’의 서버 개발과 대규모 라이브 서비스의 기술 기반 구축을 이끌었다.
이준희 아르투 최고기술책임자는 엔터플라이를 창업하고 모바일게임 ‘에어펭귄’을 선보여 출시 나흘 만에 미국 앱스토어 유료게임 1위를 기록했다.
넥슨의 대형 프로젝트에서 창업까지, 김대훤 대표와 ‘제우스: 오만의 신’
김대훤 에이버튼 대표는 약 18년간 넥슨에서 다양한 게임 개발 조직을 이끌며 대형 프로젝트와 소규모 창의적 프로젝트를 함께 추진해 온 개발자 출신 경영자다. 넥슨 신규개발총괄 부사장으로서 MMORPG ‘프라시아 전기’ 개발을 이끄는 한편, 소규모 개발팀의 독창적인 게임 제작을 지원하는 브랜드 ‘민트로켓’을 출범시켜 ‘데이브 더 다이버’의 글로벌 성공을 이끌어낸 주역이기도 하다.

2024년 에이버튼을 설립한 김대훤 대표는 현재 컴투스가 퍼블리싱하는 신작 MMORPG ‘제우스: 오만의 신’ 개발을 총괄하고 있다. 그리스 신화 세계관을 배경으로 한 ‘제우스: 오만의 신’은 오는 8월 26일 정식 출시된다. 하드코어 경쟁에 지친 이용자를 위해 플레이 부담을 낮추면서도 경쟁의 재미를 함께 담아 ‘모두가 함께 즐기는 MMORPG’를 지향한다는 것이 개발진의 설명이다. 한국 온라인게임 산업의 굵직한 프로젝트들을 거쳐 온 김대훤 대표가 오픈AI 게임 빌더스 서울에서 어떤 아이디어와 경험을 공유할지도 관전 포인트다.
게임 개발 20년 경험에 AI를 더하다, 컴투스 박상준 AX HUB 이사 참여

컴투스에서는 박상준 AX HUB 이사가 12인의 개발자 가운데 한 명으로 참여한다. 박상준 실장은 캐릭터 원화가로 게임업계에 입문해 그래픽 팀장과 아트 디렉터, 프로젝트 디렉터(PD)를 거치며 20년 넘게 게임 그래픽과 아트 디렉션 현장을 경험해 왔다. NHN에서 그래픽 팀장과 PD를 맡아 대형 온라인게임의 시각적 완성도와 제작 체계를 구축했고, 2014년에는 펄사 크리에이티브를 공동창업해 모바일 RPG ‘프로젝트 린’ 개발을 이끌기도 했다.
컴투스 합류 이후에는 언리얼 엔진 5 기반 신작 ‘프로젝트 V’의 아트 디렉션을 맡는 한편, 생성형 AI를 게임 제작 현장에 적용하기 위한 인텔리전스 아트실을 이끌며 관련 연구와 실험을 이어왔다. 현재 컴투스는 AX HUB를 중심으로 아트와 기획, 개발 등 게임 제작 전반에 AI를 적용하기 위한 사례를 축적하고, 제작 환경 전반에서 AI를 활용할 수 있는 구조를 만들어가고 있다.
이번 오픈AI 게임 빌더스 서울에서도 오랜 게임 개발 경험과 AI 기술이 만났을 때 게임 제작 방식이 어떻게 달라질 수 있을지 다양한 개발자들과 경험을 나눌 예정이다.
코덱스로 아이디어를 실제 게임으로
‘오픈AI 게임 빌더스 서울’은 오픈AI가 코덱스를 활용한 게임 개발을 주제로 전 세계에서 처음 개최하는 행사다. 이번 행사는 AI 기술에 대한 설명을 듣기보다, 참가자가 코덱스를 직접 활용해 자신의 게임 아이디어를 실제 플레이 가능한 형태로 구현해보는 데 중점을 둔다. 코드를 작성하는 보조 도구로 AI를 쓰는 수준을 넘어, 아이디어를 빠르게 실험하고 수정하며 실제 작동하는 결과물까지 만들어보는 것이 핵심이다.
김경훈 오픈AI 코리아 총괄 대표는 “한국은 오랜 시간 세계적으로 경쟁력 있는 게임과 개발 문화를 만들어 온 곳으로, 이번 행사는 그 경험을 쌓아 온 개발자들과 새로운 세대가 만나 게임 개발의 다음 가능성을 함께 탐색하는 자리”라며 “코덱스가 개발자의 아이디어를 더 빠르게 실험하고 구현하는 데 실질적인 도구가 되고, 나아가 게임을 만드는 방식 자체를 확장하는 계기가 되기를 기대한다”고 말했다.
게임을 만드는 것에서 출시와 운영까지, 하이브가 잇는다
게임의 프로토타입을 완성했다고 해서 개발 과정이 끝나는 것은 아니다. 실제 게임을 서비스하려면 로그인과 인증부터 결제, 이용자 분석, 보안 등 다양한 기능이 필요하다.

컴투스는 참가자들이 게임 제작 이후의 단계까지 경험할 수 있도록 게임 백엔드 플랫폼 하이브(Hive) 기반 AI 플러그인을 제공한다.
참가자들은 이를 활용해 자신이 만든 게임에 로그인, 결제, 이용자 분석, 보안 등 실제 출시와 운영에 필요한 기능을 연동할 수 있다. 코덱스로 게임의 아이디어를 구현하고, 하이브를 통해 서비스에 필요한 기능까지 연결하면서 ‘아이디어 → 개발 → 출시 준비 → 운영’으로 이어지는 게임 제작의 흐름을 경험하는 셈이다.
AI와 함께 만드는 게임, 8월 31일 서울에서
한국 게임 산업은 PC 온라인게임과 MMORPG, 모바일게임을 거치며 끊임없이 새로운 개발 방식과 시장을 만들어 왔다. 이제 생성형 AI의 확산과 함께 게임을 만드는 과정에도 또 한 번 변화가 시작되고 있다.
‘오픈AI 게임 빌더스 서울’은 개발자가 AI를 활용해 자신의 아이디어를 얼마나 빠르게 실험하고 실제 게임으로 구현할 수 있는지를 직접 확인하는 기회가 될 예정이다.
여기에 한국 게임 산업의 여러 시대를 경험한 12인의 개발자가 함께하고, 컴투스는 AX HUB의 AI 전환 경험과 하이브 플랫폼을 통해 힘을 보탠다.
코덱스로 시작한 하나의 아이디어가 실제 플레이 가능한 게임으로 발전하고, 다시 출시와 운영을 위한 단계까지 연결되는 과정은 어떤 모습일까. 오는 8월 31일 서울에서 새로운 게임 제작 방식에 대한 실험이 펼쳐진다.
※ 참가 신청은 8월 26일까지 진행되며, 자세한 내용은 ‘오픈AI 게임 빌더스 서울’ 공식 사이트에서 확인할 수 있다.


