“일과 삶의 균형, 일상 속 행복으로 잇다” 컴투스 공간문화팀, ‘가족친화제도 이용 공모전’ 우수상
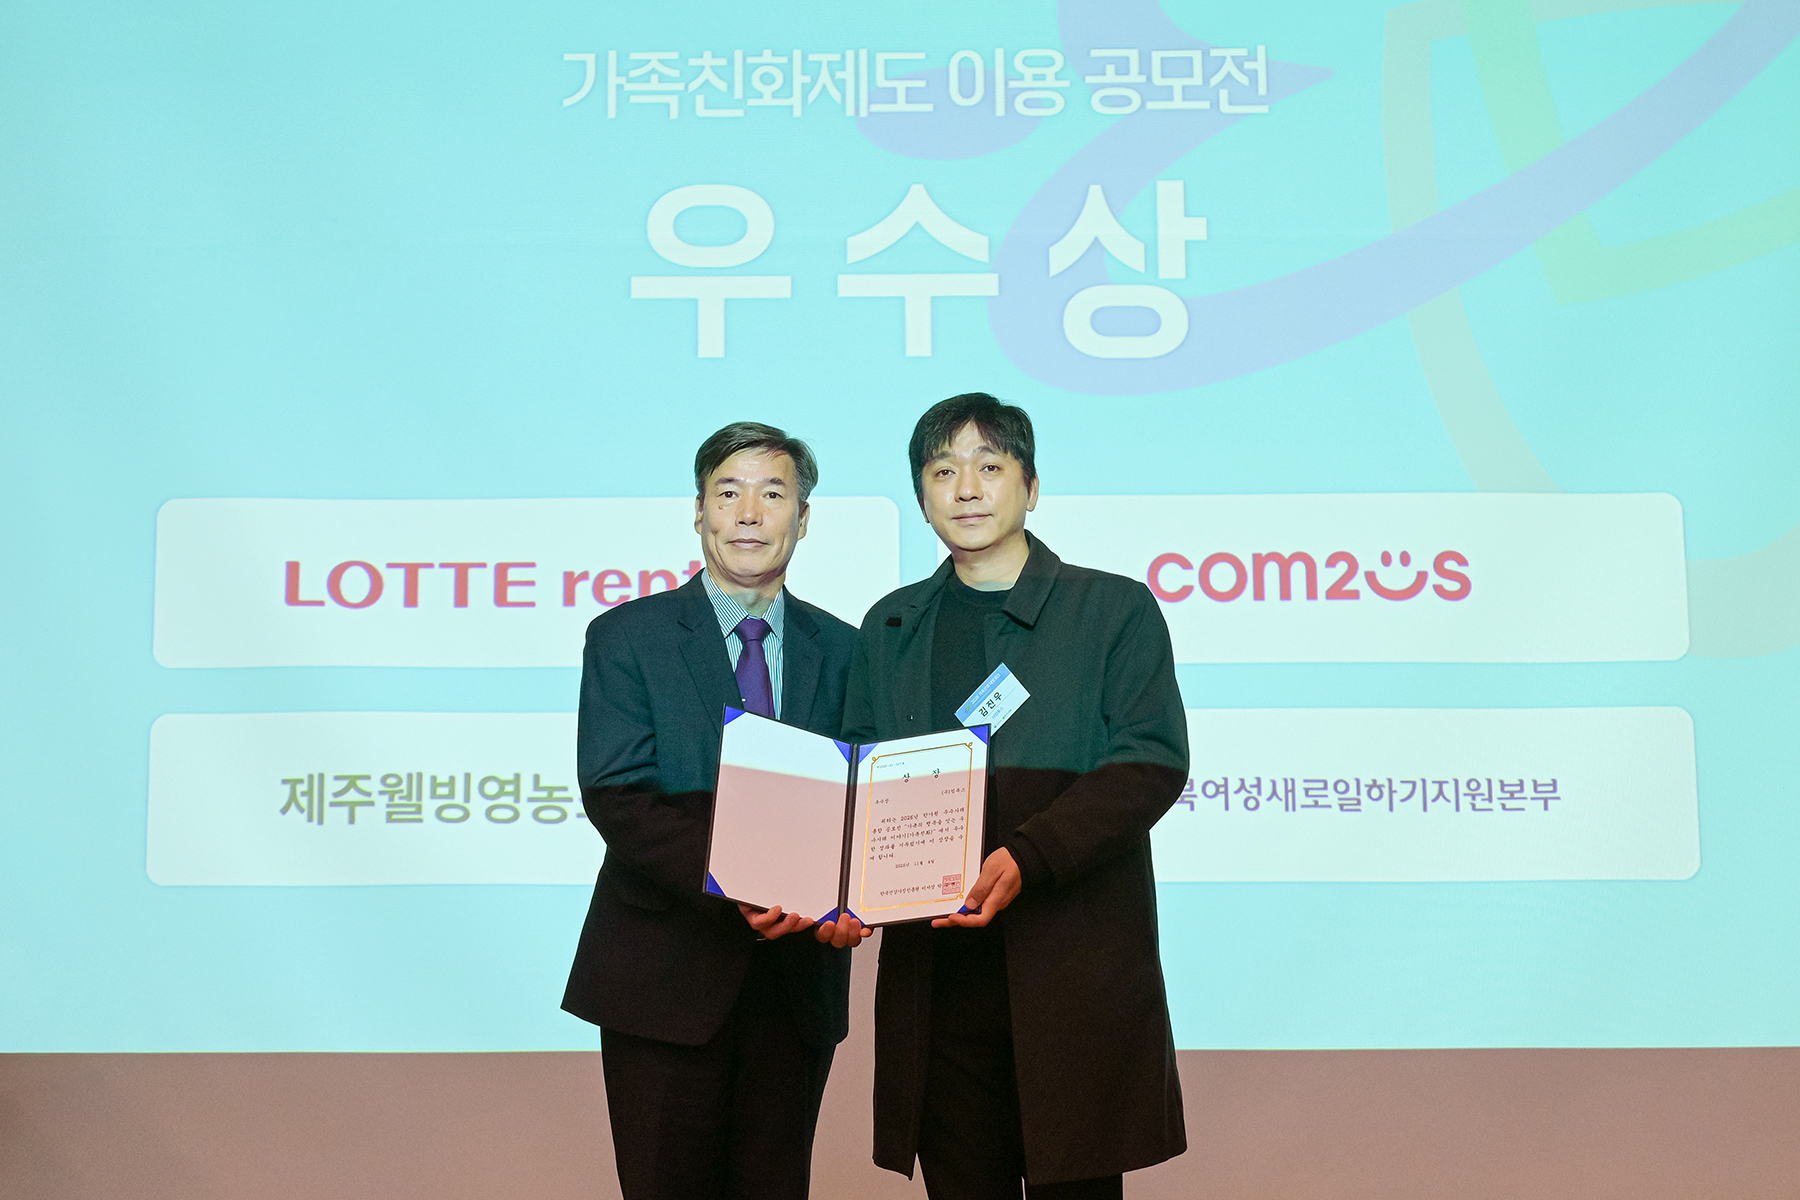
컴투스 업무지원실 공간문화팀이 성평등가족부 산하 한국건강가정진흥원의 ‘2026 가족의 행복을 잇는 우수사례 이야기’ 공모전 중 ‘가족친화제도 이용 공모전’ 부문에서 우수상을 받았다.
이번 공모전은 근로자의 일·생활 균형을 돕는 가족친화제도의 이용 경험을 발굴하고 널리 알리기 위해 마련됐다. 가족친화기업에 다니는 근로자들이 각자의 사례를 숏폼 영상으로 출품했고, 그중 대상 1편, 우수상 4편, 장려상 8편 등 13편이 수상작으로 뽑혔다. 공간문화팀의 작품은 우수상 4편 가운데 하나로 이름을 올렸다.
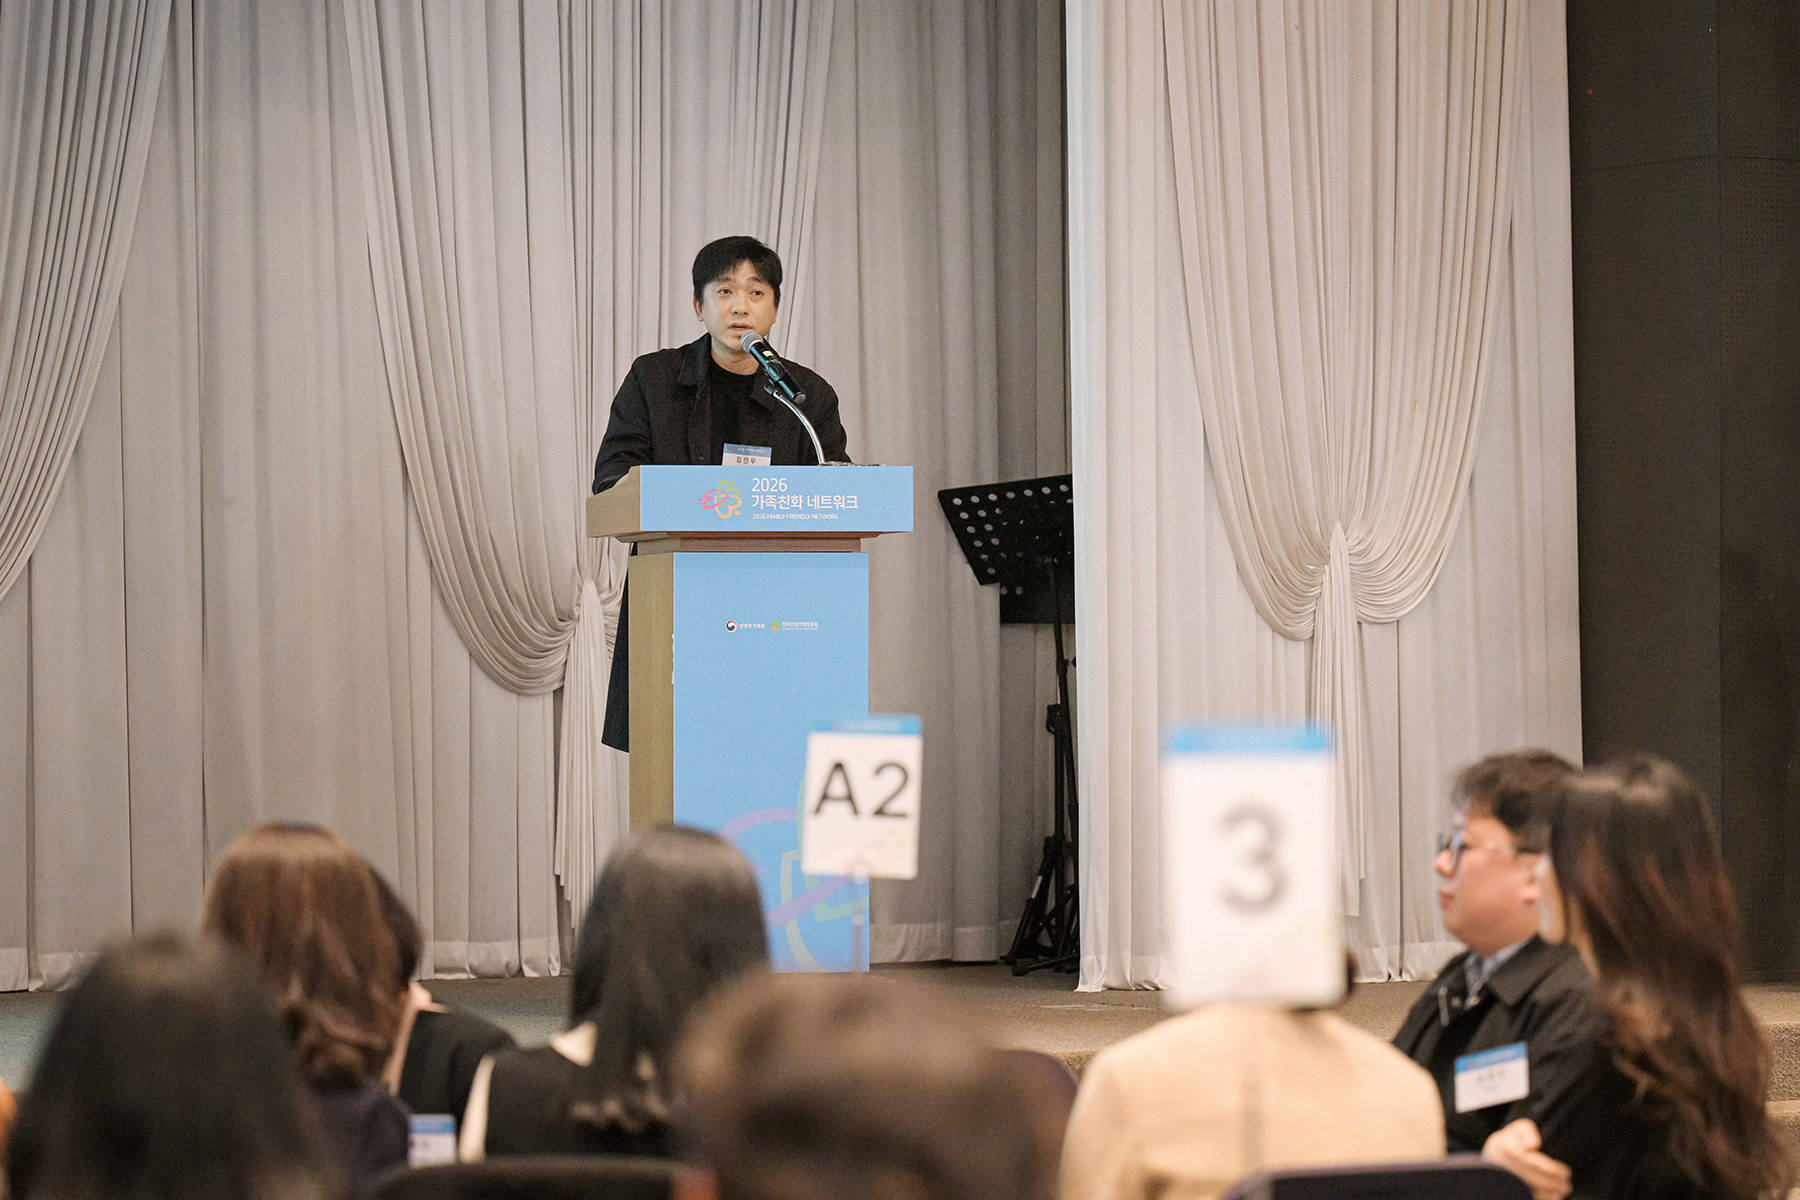
시상식은 ‘2026 가족친화 네트워크’ 행사에서 열렸고, 업무지원실 공간문화팀 김진우 실장(팀장 겸직)이 참석해 상을 받았다.
숏폼 영상으로 전한 일상, 공간문화팀의 출품 이야기
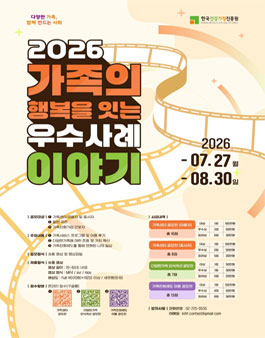 공모전 포스터 | 출품은 컴투스의 일하는 문화를 가꾸는 공간문화팀이 주도했다. 공간문화팀은 사내에 자리 잡은 제도와 그 제도로 달라진 구성원의 일상을 회사 밖에도 알리고자 공모전에 도전했다. 공모 주제는 ‘가족친화제도(유연근무, 시차출퇴근 등)를 활용하며 변화된 나의 일상’이었다. 공간문화팀은 제도를 하나하나 설명하는 대신, 제도를 쓰는 구성원의 하루를 15~60초 분량의 세로형 숏폼 영상에 담았다. |
수상작은 비버 가족 캐릭터를 주인공으로 한 애니메이션이다. 영상은 “우리 회사는 자율출퇴근제와 리커버리데이를 운영하고 있습니다”라는 소개로 시작해, 두 제도가 한 가족의 하루를 어떻게 바꿨는지 차례로 보여준다.
자율출퇴근제가 없던 시절, 주인공은 출근 시간에 맞추려고 오전 7시 20분에 아이를 어린이집에 데려다줘야 했다. 해가 막 떠오를 무렵 집을 나서야 하는 아침이었다. 지금은 오전 9시 20분, 아이 손을 잡고 천천히 등원길을 걷는다. 아침이 여유로워지면서 아이의 컨디션이 좋아졌고, 부모는 아이 걱정을 덜고 업무에 더 집중할 수 있게 됐다.
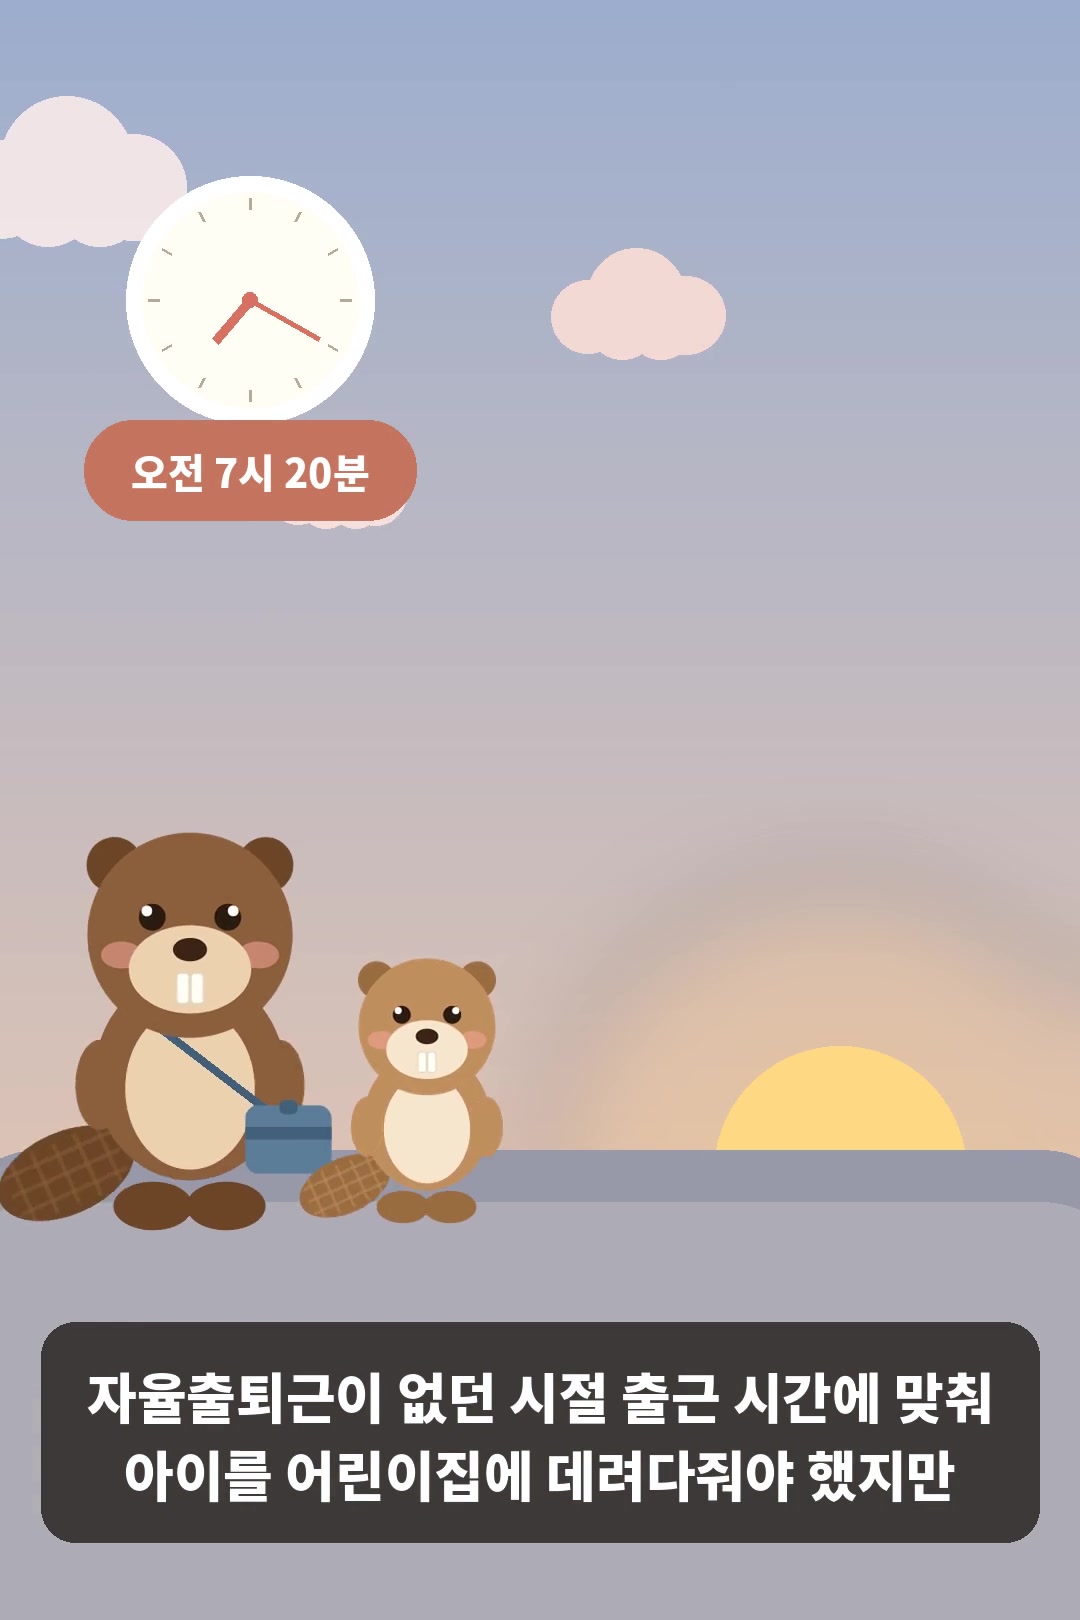 자율출퇴근제 전, 오전 7시 20분 등원 | 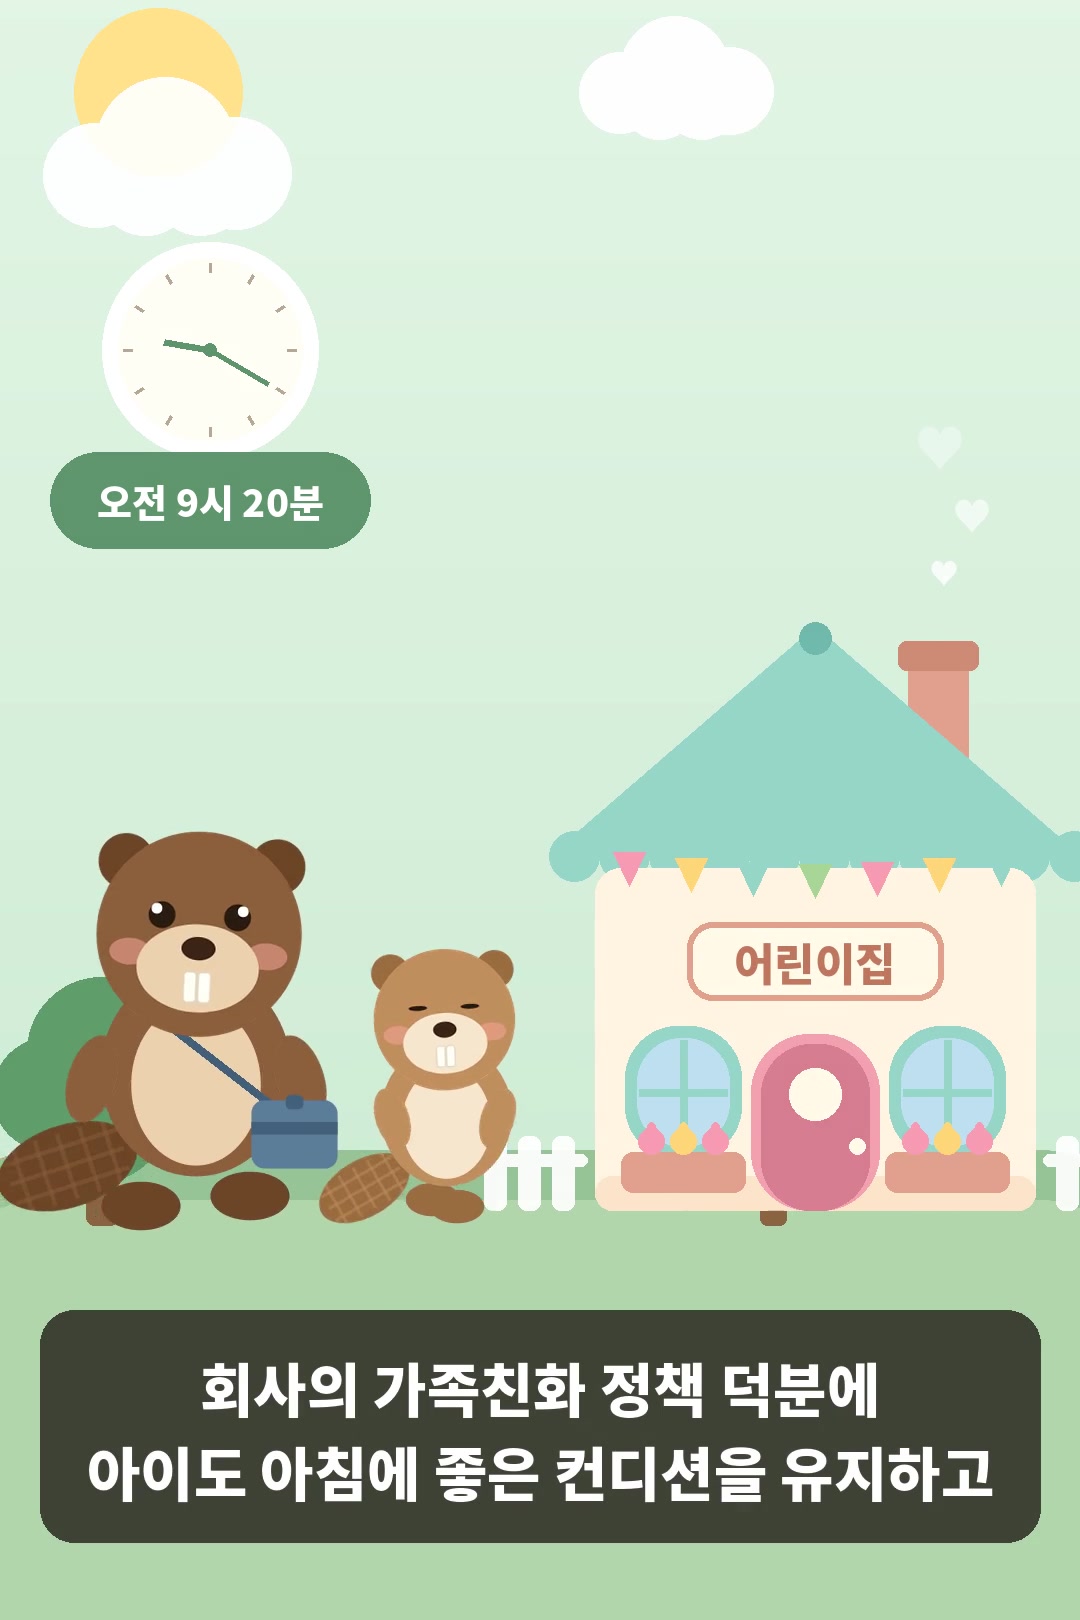 지금은 오전 9시 20분 등원 |
리커버리데이 덕분에 가족이 함께 보내는 시간도 늘었다. 주말 인파를 피해 평일에 가족과 아쿠아리움을 다녀온 장면이 대표적이다. 영상은 “아이와 함께 시작하는 평일 아침과 온전히 가족과 보낼 수 있는 시간”을 짚은 뒤, “우리 회사 가족친화복지 최고!”라는 한마디로 마무리된다.
공간문화팀은 “사우들이 일과 가정, 개인의 삶 사이에서 균형을 찾고 업무에 몰입할 수 있도록 마련된 제도들이 실제 일상에 어떤 행복한 변화를 가져왔는지 진솔하게 전달하고자 했다”라며 “사우들이 함께 체감하고 있는 컴투스만의 건강한 기업문화를 대외에 알리고 우수상이라는 뜻깊은 결실까지 얻게 되어 기쁘다”고 수상 소감을 전했다.
출근 시간부터 평일 휴식까지, 영상에 담긴 컴투스의 제도
영상에서 다룬 제도는 컴투스가 운영 중인 자율출퇴근제와 리커버리데이다. 컴투스는 구성원이 생활 패턴, 육아, 자기계발 등 각자의 상황에 맞춰 출퇴근 시간을 조율하고, 필요할 때 평일에 쉬어 갈 수 있도록 지원하고 있다.
자율출퇴근제
컴투스 구성원은 오전 9시부터 10시 30분 사이에 자유롭게 출근하고, 오후 3시 이후에는 눈치 보지 않고 퇴근할 수 있다. 통근 시간대를 조절해 이동 부담을 덜고, 집중이 잘되는 시간대에 맞춰 일할 수 있다. 등원·하원처럼 시간이 정해진 가족 일정에 맞춰 하루를 설계할 수 있다는 점도 자율출퇴근제의 장점이다.
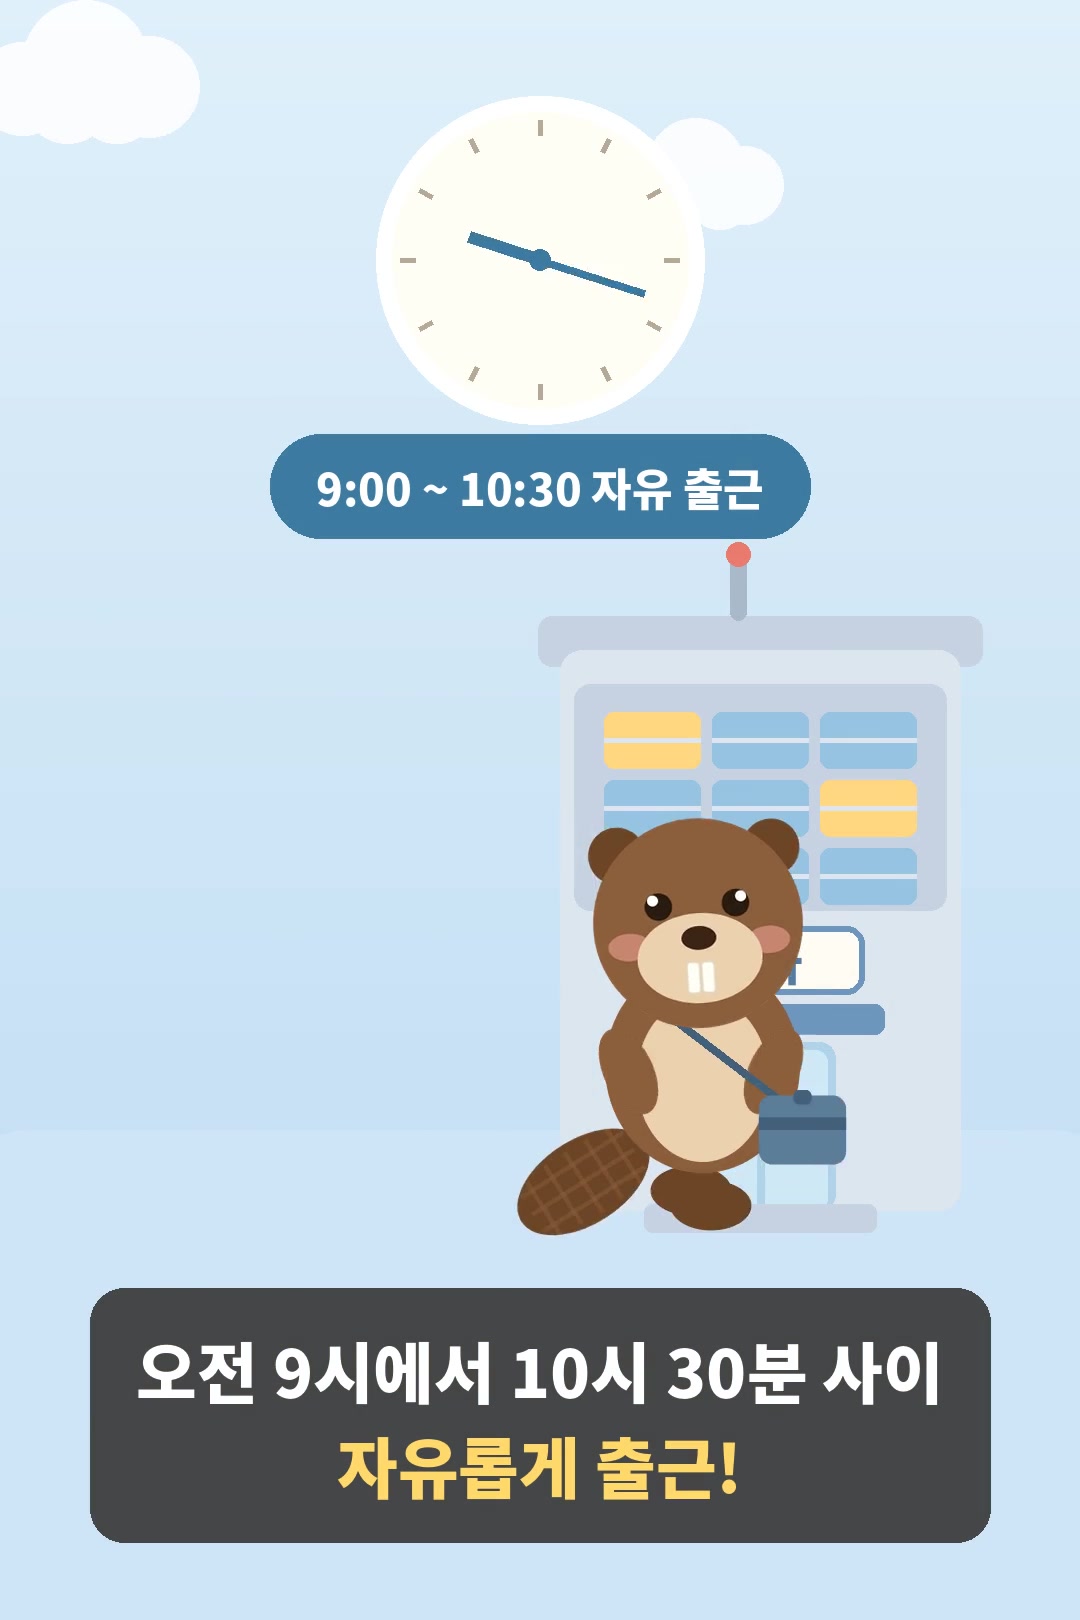
리커버리데이
리커버리데이는 한 달에 한 번, 평일에 쉴 수 있는 날이다. 별도 결재 없이 신청만 하면 자동으로 승인된다. 구성원은 붐비는 주말 대신 평일에 가족과 시간을 보내거나 온전히 재충전하는 데 이날을 쓸 수 있다.
두 제도가 사규 속 문구로만 남지 않은 데에는 사내 분위기도 한몫했다. 컴투스 구성원은 동료나 부서의 눈치를 보지 않고 각자 필요에 따라 제도를 쓴다.
지난해 ‘가족친화인증기업’ 선정에 이은 결실
이번 수상은 컴투스가 꾸준히 이어온 일·가정 양립 지원과도 맞닿아 있다. 컴투스는 2025년 12월 성평등가족부가 주관하는 ‘가족친화인증기업’에 선정됐다. 가족친화인증은 자녀 출산·양육 지원, 유연근무 등 가족친화제도를 모범적으로 운영하는 기업과 공공기관을 심사해 부여하는 제도다.
인증 당시 소개된 컴투스의 주요 가족친화제도는 다음과 같다.
· 근무 시간을 스스로 조율하는 유연근무제(선택적 근로시간제)
· 시간 단위로 쓸 수 있는 연차 제도
· 난임 치료 휴가 등 건강 지원 제도
· 장기근속 휴가 지원
· 임신 전 기간 근로시간 단축(법정 기준 초과), 단축 기간 급여 100% 보전
· 자녀가 만 12세가 될 때까지 최대 3년간 근로시간 단축
공간문화팀은 앞으로도 사우들이 일터에서는 성취와 몰입을, 일상에서는 가족 및 자신과의 소중한 시간을 온전히 누릴 수 있도록 가족친화제도를 지속적으로 고도화하고 발전시켜 나가는 데 일조할 계획이라고 밝혔다.
전체 지표에서 변화를 찾은 뒤에는 관련 이용자 집단을 분석 대상으로 고정하고, 그 집단의 재구매나 재방문이 기간에 따라 어떻게 이어지는지 확인해야 한다. ChatGPT에 Hive Axyl Plugin을 설치하면 이용자 조건을 자연어로 지정해 Hive 애널리틱스 세그먼트를 생성하고, 해당 세그먼트를 대상으로 리텐션을 이어서 구성할 수 있다. 저장 전에는 적용할 조건과 대상, 저장 위치를 먼저 보여주고 사용자가 승인한 뒤 생성하며, 이번 편에서는 미국·GO 결제 이용자 세그먼트의 구매 리텐션을 만들어본다.
이용자 집단의 반복 행동 확인하기
「자연어로 대시보드 핵심 변화 요약하기: Hive Axyl Plugin 활용 3편」에서는 대시보드의 핵심 변화와 기여 대상을 자연어로 요약했다. 이번 편에서는 분석 과정에서 찾은 이용자 조건을 자연어로 지정해 세그먼트를 생성하고, 해당 집단의 재구매 흐름을 리텐션으로 확인하는 방법을 알아본다.
데이터 분석 담당자는 전체 지표에서 의미 있는 변화를 확인한 뒤, 관련 이용자 집단의 후속 행동을 별도로 살펴봐야 한다. 세그먼트와 리텐션을 함께 활용하면 특정 조건의 이용자를 분석 대상으로 고정하고, 해당 집단의 재구매나 재방문이 기간에 따라 어떻게 이어지는지 확인할 수 있다.
이를 통해 전체 이용자 평균에 가려진 집단별 차이를 구분하고, 특정 국가와 마켓의 결제 이용자가 이후에도 지속적으로 구매하는지 같은 질문을 동일한 기준으로 비교할 수 있다.
Hive 애널리틱스의 자연어 기반 세그먼트와 리텐션 생성
ChatGPT에 Hive Axyl Plugin을 설치하면 이용자 조건을 자연어로 지정해 Hive 애널리틱스 세그먼트를 생성하고, 해당 세그먼트를 대상으로 리텐션을 이어서 구성할 수 있다. 리텐션의 기준 이벤트와 복귀 이벤트, 조회 기간과 표기 방식도 대화로 지정한다.
세그먼트와 리텐션을 저장하기 전에는 적용할 조건과 대상, 저장 위치를 먼저 보여준다. 사용자가 구성을 확인하고 승인한 뒤 각 콘텐츠를 생성한다.
- 세그먼트 조건 지정: 자연어로 분석할 이용자의 조건을 정한다.
- 세그먼트 생성: 조건과 예상 이용자 수를 확인하고 세그먼트와 스냅샷을 저장한다.
- 리텐션 구성: 생성한 세그먼트를 대상으로 기준·복귀 이벤트, 기간과 표시 단위를 정한다.
- 승인 및 저장: 리텐션의 구성과 중복 여부를 확인한 뒤 승인하고 결과 화면을 확인한다.
💡 Note
플러그인 설치와 조직의 MCP 멤버 설정 과정은 「자연어로 게임 지표를 조회하고 변화 확인하기: Hive Axyl Plugin 활용 1편」에서 확인할 수 있다.
미국·GO 결제 이용자의 구매 리텐션 생성해보기
3편의 대시보드 요약에서는 미국·GO 마켓의 매출과 ARPPU가 크게 변했고, 특정 상품의 고액 결제가 주요 확인 대상으로 나타났다. 해당 변화가 일시적인 결제에 그친 것인지 이후에도 구매가 이어지는지 확인하기 위해 미국·GO 결제 이용자를 세그먼트로 생성하고 구매 리텐션을 구성해본다.
분석할 세그먼트 생성하기
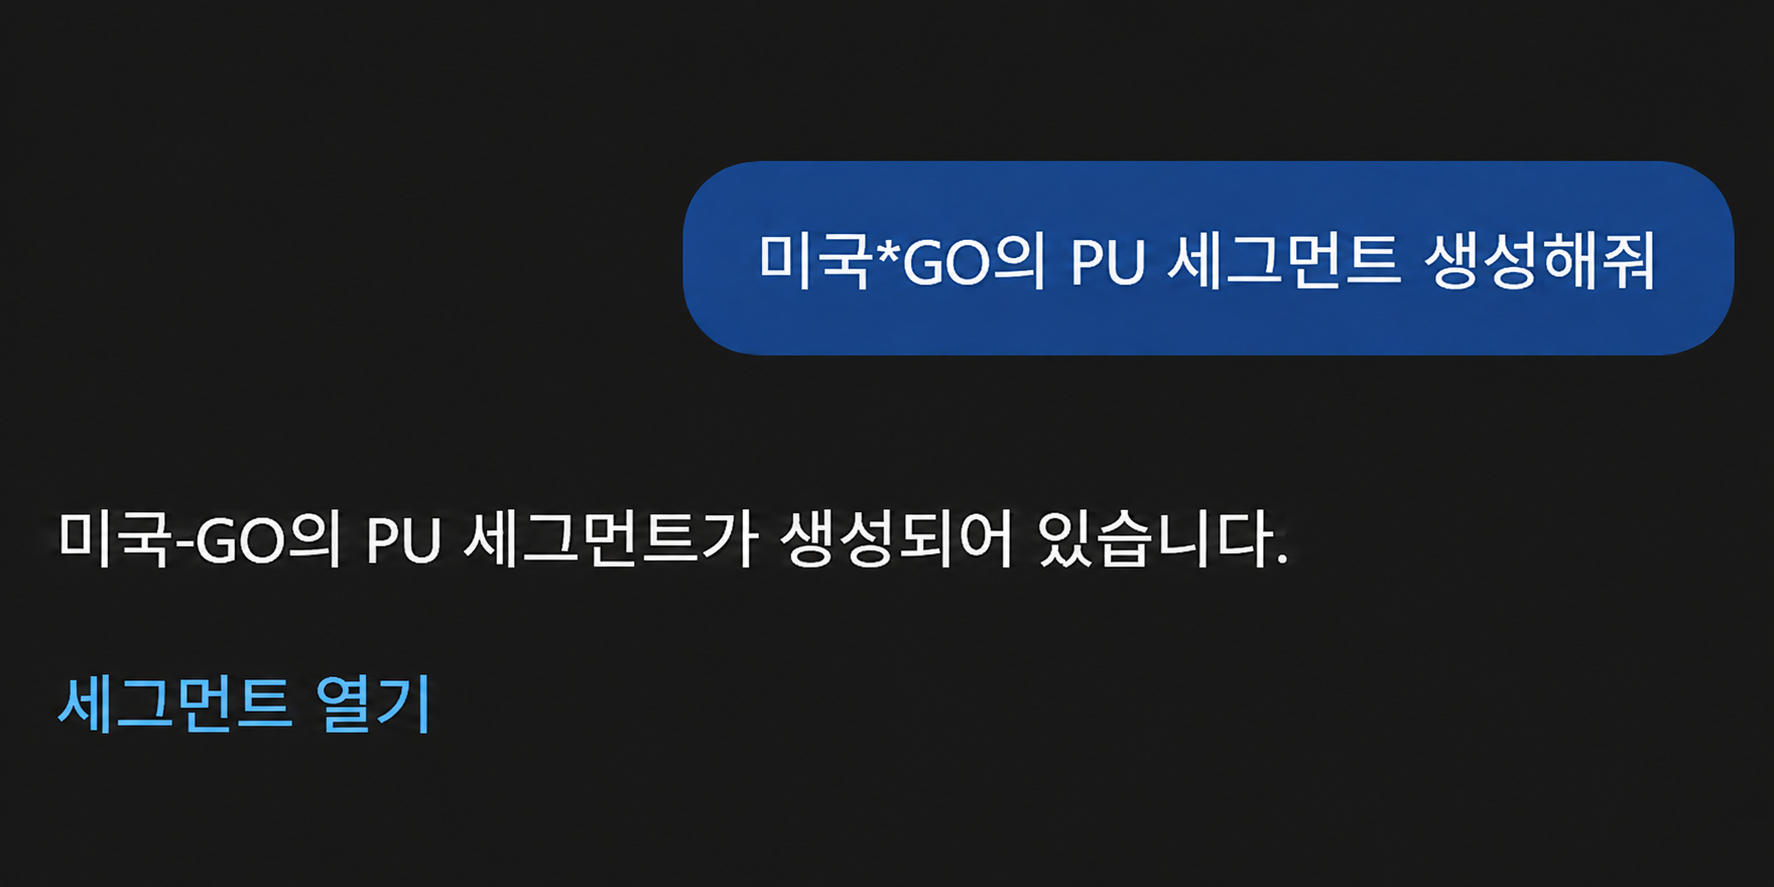
미국·GO의 PU 세그먼트 생성해줘.
요청한 국가와 마켓, 결제 여부를 조건으로 미국·GO 결제 이용자 세그먼트를 생성하고, 생성된 세그먼트 화면으로 이동할 수 있는 링크를 제공한다.
구매 리텐션 생성하기
해당 세그먼트를 추적할 수 있는 구매 리텐션 만들어줘.
생성한 세그먼트를 대상으로 기준 이벤트와 복귀 이벤트를 purchase로 설정하고, 최근 30일의 일별 재구매율을 확인하는 리텐션 구성을 제안한다. 이름과 기간, 대상 세그먼트, 표기 방식과 저장 위치를 확인하고 승인하면 리텐션을 저장한 뒤 결과 화면으로 이동할 수 있는 링크를 제공한다.
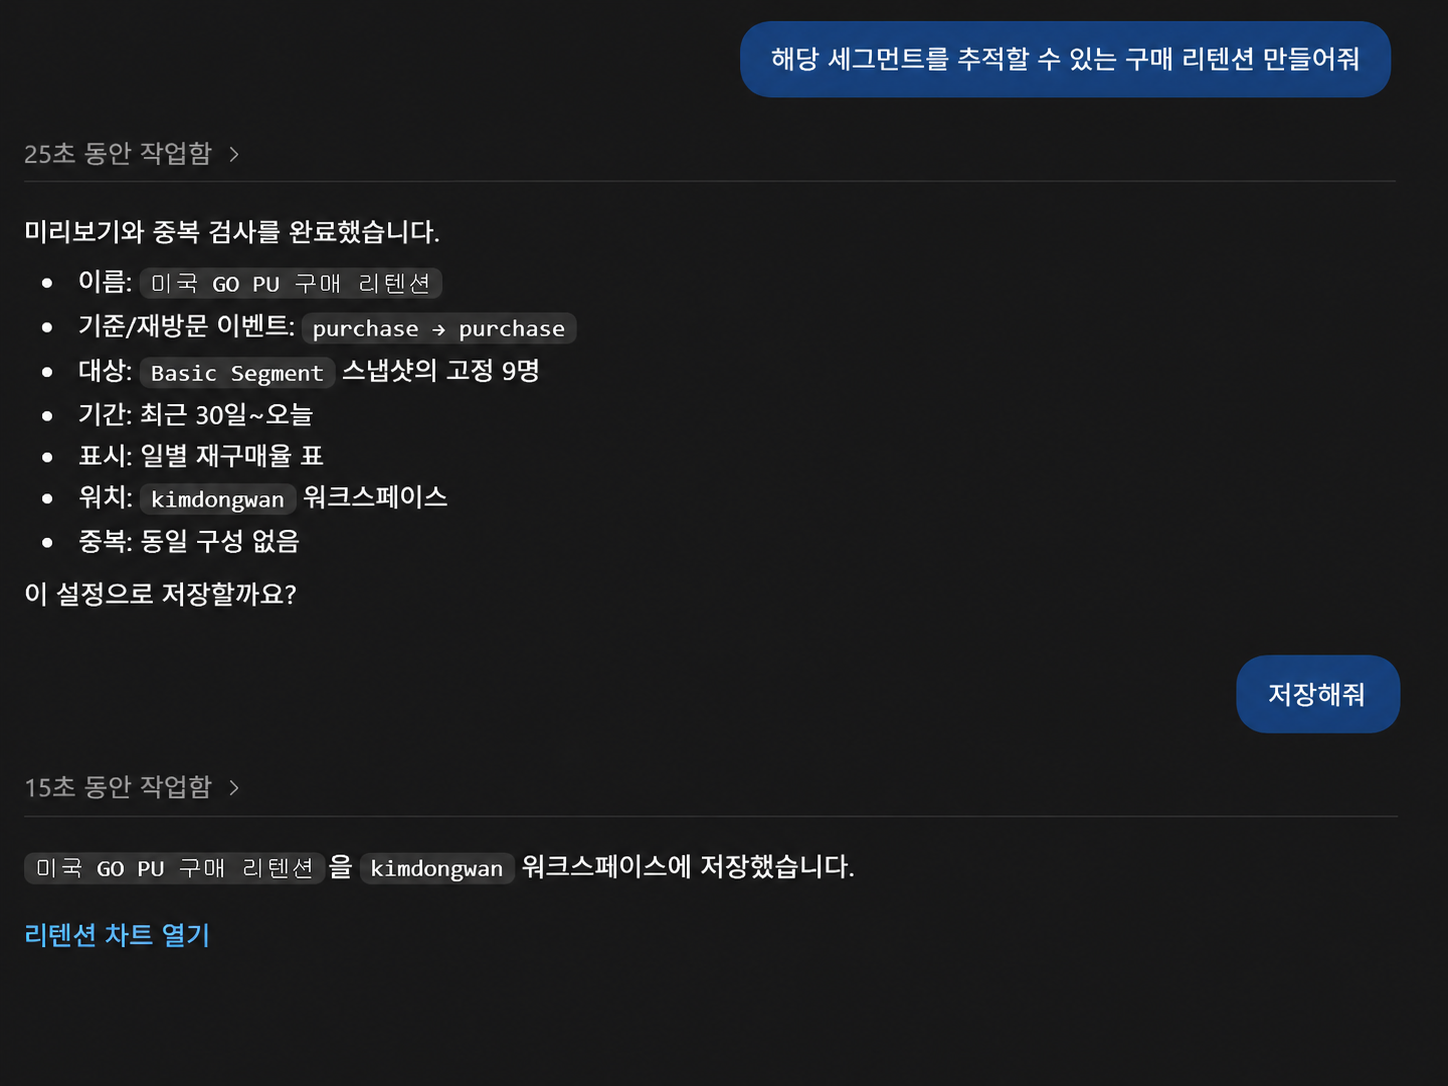
이렇게 생성한 리텐션을 정기적으로 확인하면 미국·GO 결제 이용자의 재구매 흐름과 변화 시점을 동일한 기준으로 지속해서 살펴볼 수 있다.
Hive 애널리틱스 시작해보기
Hive Axyl Plugin을 활용하면 분석에서 찾은 조건으로 이용자 세그먼트를 생성하고, 해당 집단의 구매와 재방문 같은 반복 행동을 확인할 리텐션까지 자연어로 구성할 수 있다.
Hive 애널리틱스는 Hive SDK를 통해 수집된 이벤트를 기반으로 이용자 집단을 나누고 반복 행동을 리텐션으로 분석할 수 있는 게임 전문 애널리틱스 솔루션이다. 지금 ChatGPT에 Hive Axyl Plugin을 설치해 Hive 애널리틱스에서 관심 있는 세그먼트의 구매 리텐션을 구성해보자.
ChatGPT에 Hive Axyl Plugin을 설치하면 Hive 애널리틱스에 저장된 대시보드를 자연어로 요약해 여러 차트의 핵심 변화와 주요 기여 대상을 한 번에 확인할 수 있다. 요약은 대시보드에 포함된 차트의 지표와 차원, 기간과 필터를 기준으로 하며, 국가·마켓·상품을 지정한 후속 질문으로 확인 범위를 좁힐 수 있다. 고액 결제처럼 특정 날짜에 집중된 변화는 기간을 넓혀 반복되는 패턴인지 추가로 확인한다.
여러 차트에서 핵심 변화를 빠르게 찾기
「자연어로 차트와 대시보드 구성하기: Hive Axyl Plugin 활용 2편」에서는 분석 조건을 차트로 저장하고 여러 차트를 하나의 대시보드로 구성했다. 이번 편에서는 저장한 대시보드를 자연어로 요약하고 중요한 변화를 빠르게 확인하는 방법을 알아본다.
대시보드에는 매출, 결제 이용자 수, 결제자당 평균 매출처럼 서로 연결된 지표와 국가·마켓·상품별 결과가 함께 표시된다. 각 차트의 기간과 필터를 기준으로 값을 비교하면 변화의 흐름을 자세히 살펴볼 수 있지만, 차트가 많아질수록 여러 결과를 종합해 중요한 변화와 주요 기여 대상을 찾는 데 시간이 걸린다.
이때 데이터 분석 담당자는 자연어로 대시보드 요약을 요청하여 여러 차트의 결과를 한 번에 비교하고, 우선 확인해야 할 지표와 주요 변화를 빠르게 파악할 수 있다. 대시보드의 여러 차트를 매번 직접 확인하고 해석하는 과정을 줄여 반복적인 모니터링 업무를 효율적으로 수행할 수 있다.
Hive 애널리틱스의 자연어 기반 대시보드 요약
ChatGPT에 Hive Axyl Plugin을 설치하면 Hive 애널리틱스에 저장된 대시보드를 선택하고, 포함된 차트의 지표와 차원, 기간과 필터를 기준으로 핵심 변화를 요약할 수 있다. 화면 이미지만 읽는 것이 아니라 각 차트에 설정된 분석 조건과 조회 결과를 바탕으로 비교한다.
- 대시보드 선택: 요약할 대시보드와 프로젝트를 지정한다.
- 분석 기준 확인: 조회 기간, 비교 기간, 필터와 통화를 확인한다.
- 핵심 변화 요약: 전체 지표와 국가·마켓·상품별 변화가 큰 구간을 정리한다.
- 후속 질문: 특정 국가나 상품 등 확인 범위를 좁혀 분석을 이어간다.
💡 Note
플러그인 설치와 조직의 MCP 멤버 설정 과정은 「자연어로 게임 지표를 조회하고 변화 확인하기: Hive Axyl Plugin 활용 1편」에서 확인할 수 있다.
미국·일본 상품 ARPPU 대시보드 요약해보기
2편에서 구성한 미국·일본 상품 ARPPU 감소 분석 대시보드를 대상으로, 설정된 기간과 필터를 기준으로 주요 지표와 국가·마켓·상품별 변화를 자연어로 요약해본다.
대시보드 요약 요청하기
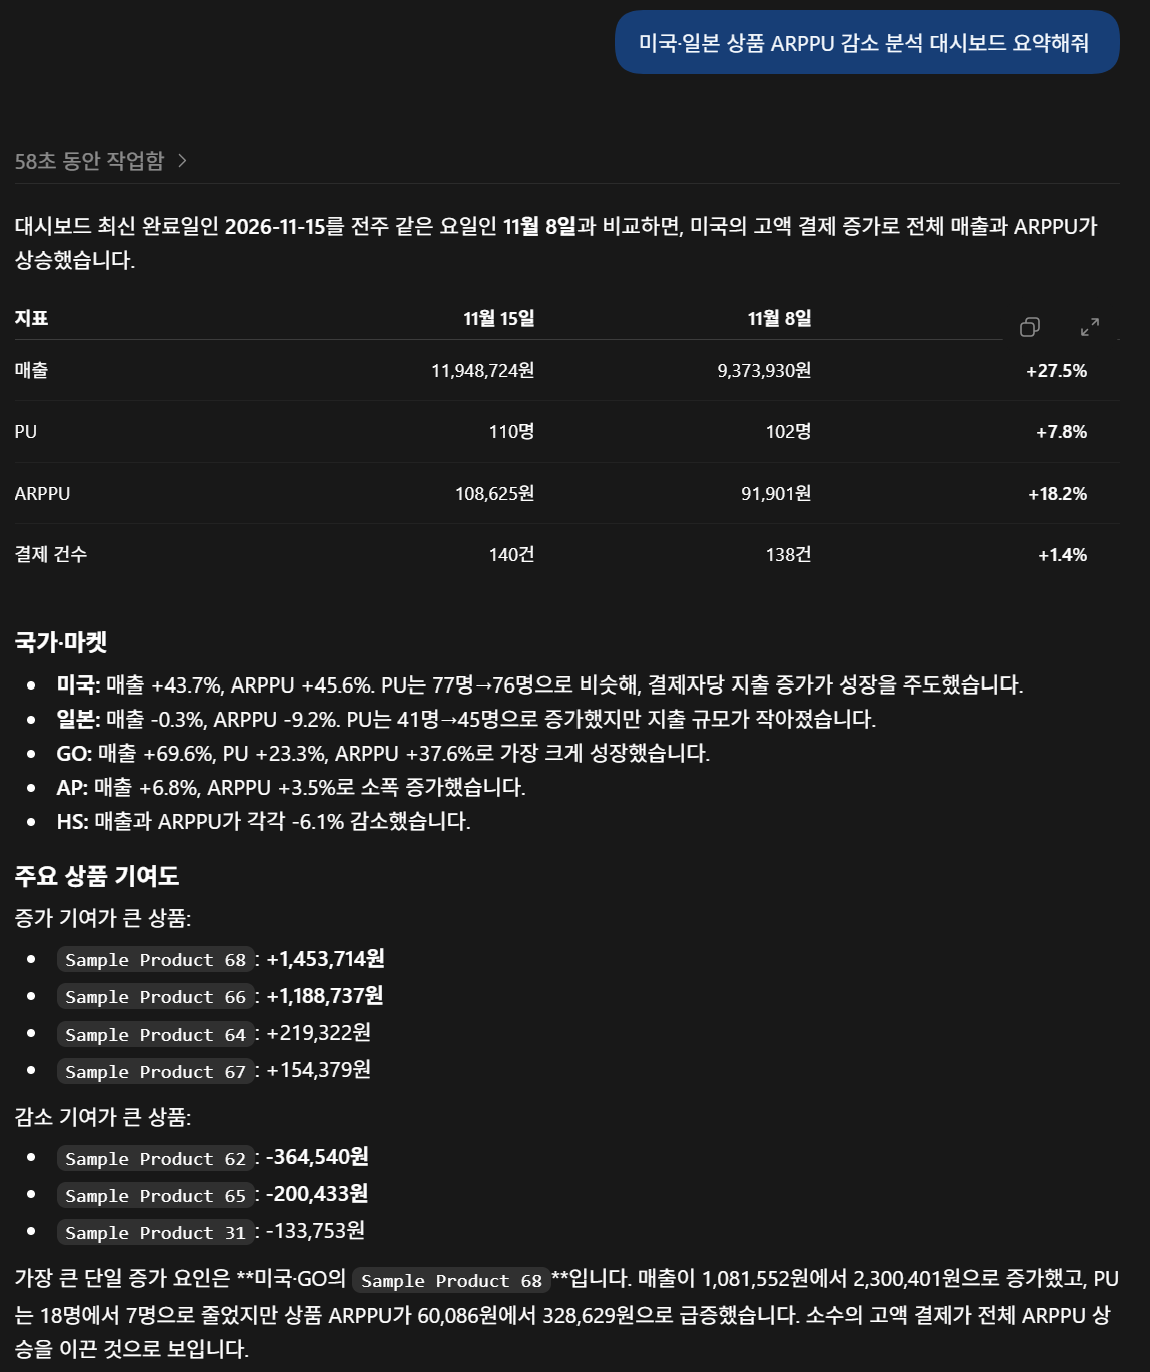
미국·일본 상품 ARPPU 감소 분석 대시보드 요약해줘.
요약 결과, 전주 같은 요일보다 매출은 27.5%, 결제 이용자 수는 7.8%, ARPPU는 18.2% 증가했다. 특히 미국과 GO 마켓의 성장 폭이 컸으며, 미국·GO의 Sample Product 68 고액 결제가 매출과 ARPPU 상승에 가장 크게 기여한 것으로 나타났다. 실제 분석에서는 요약에 적용된 기간과 필터를 확인하고 필요한 경우 국가·마켓·상품을 지정해 추가 질문한다.
미국·GO 매출의 최근 패턴 확인하기
전체 요약에서 미국과 GO 마켓이 주요 성장 대상으로 나타났다면, 후속 질문으로 최근 매출 흐름과 특정 요일에 반복되는 변화가 있는지 확인할 수 있다.
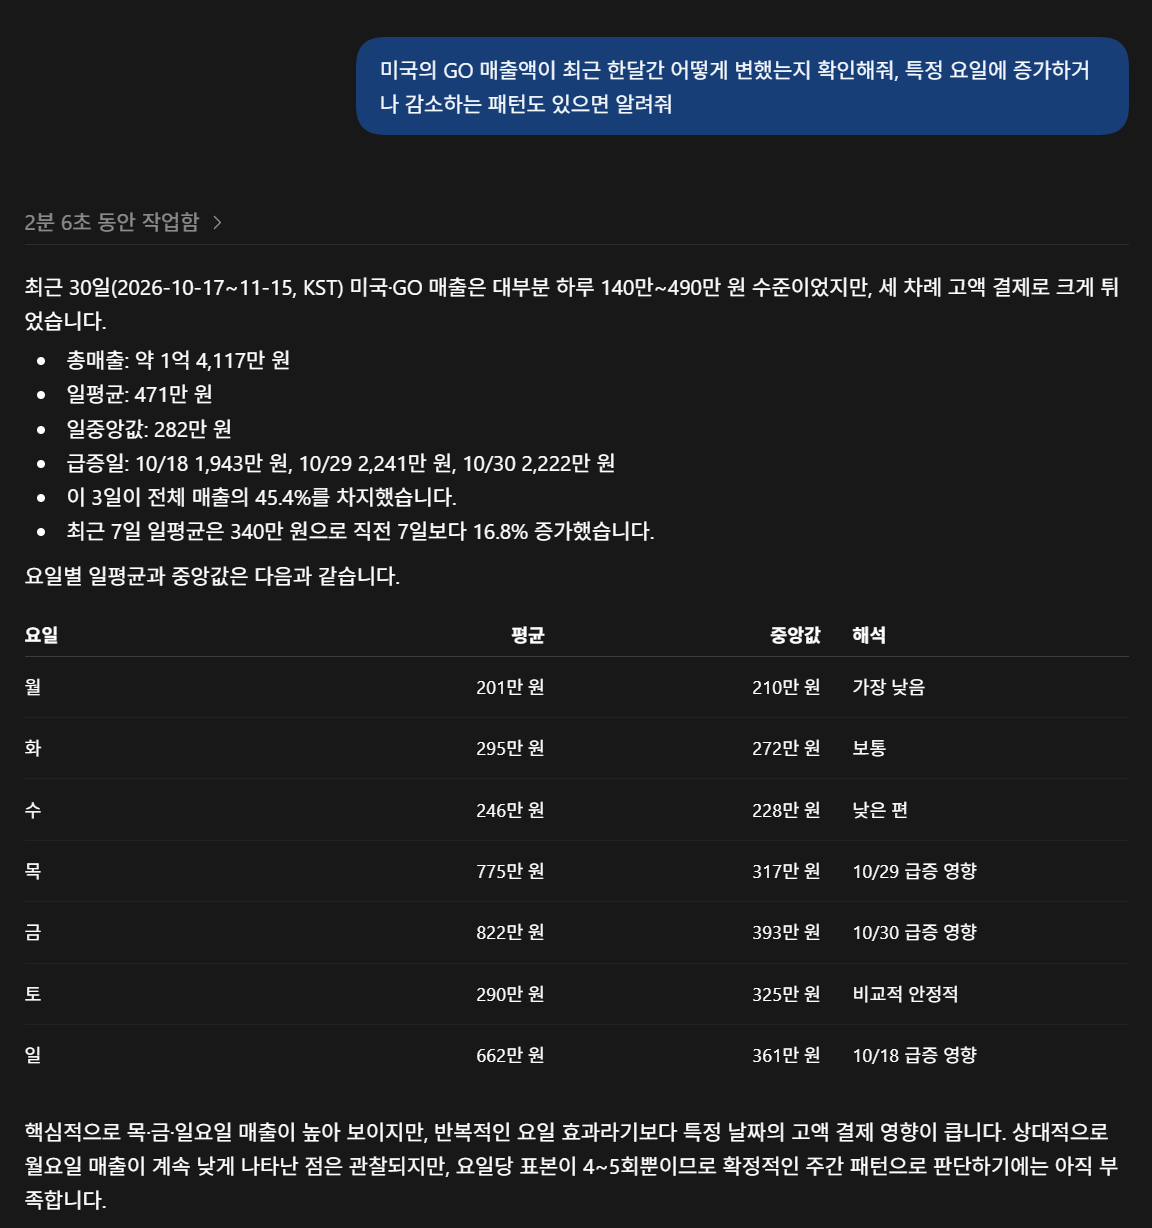
미국의 GO 매출액이 최근 한 달간 어떻게 변했는지 확인해줘. 특정 요일에 증가하거나 감소하는 패턴도 있으면 알려줘.
분석 결과, 최근 30일간 미국·GO 매출은 대부분 하루 140만~490만 원 수준이었으나 10월 18일과 29일, 30일에는 고액 결제로 크게 증가했다. 목·금·일요일의 평균 매출이 높게 나타났지만 특정 날짜의 영향이 커 반복적인 요일 패턴으로 판단하기에는 추가 관찰이 필요하다.
대시보드 요약에서 의미 있는 이용자 집단을 찾았다면 해당 집단의 반복 행동을 이어서 확인할 수 있다. 「자연어로 세그먼트의 구매 리텐션 확인하기: Hive Axyl Plugin 활용 4편」에서는 자연어로 세그먼트를 생성하고 구매 리텐션을 구성하는 과정을 살펴본다.
Hive 애널리틱스 시작해보기
Hive Axyl Plugin을 활용하면 여러 차트로 구성된 대시보드의 핵심 변화와 기여 대상을 자연어로 요약하고, 후속 질문을 통해 분석 범위를 구체화할 수 있다.
Hive 애널리틱스는 Hive SDK를 통해 수집된 이벤트를 기반으로 게임 지표를 분석하고, 대시보드의 변화를 자연어로 요약할 수 있는 게임 전문 애널리틱스 솔루션이다. 지금 ChatGPT에 Hive Axyl Plugin을 설치해 Hive 애널리틱스 대시보드의 핵심 변화를 빠르게 살펴보자.
현재 Hive 콘솔에서는 AI를 활용해 Playwright 테스트 스펙 파일과 테스트 실행·관리 도구를 만들고, 이를 통해 E2E 테스트를 자동화하고 있다. 스펙 파일은 사용자 동작과 기대 결과를 코드로 정의하고, 실행·관리 도구는 테스트 조건 설정부터 실행과 결과 확인까지 지원한다. 이 글에서는 두 가지를 구축한 과정과 실제 사용 중에 보완한 점, 앞으로의 확장 방향을 소개한다.
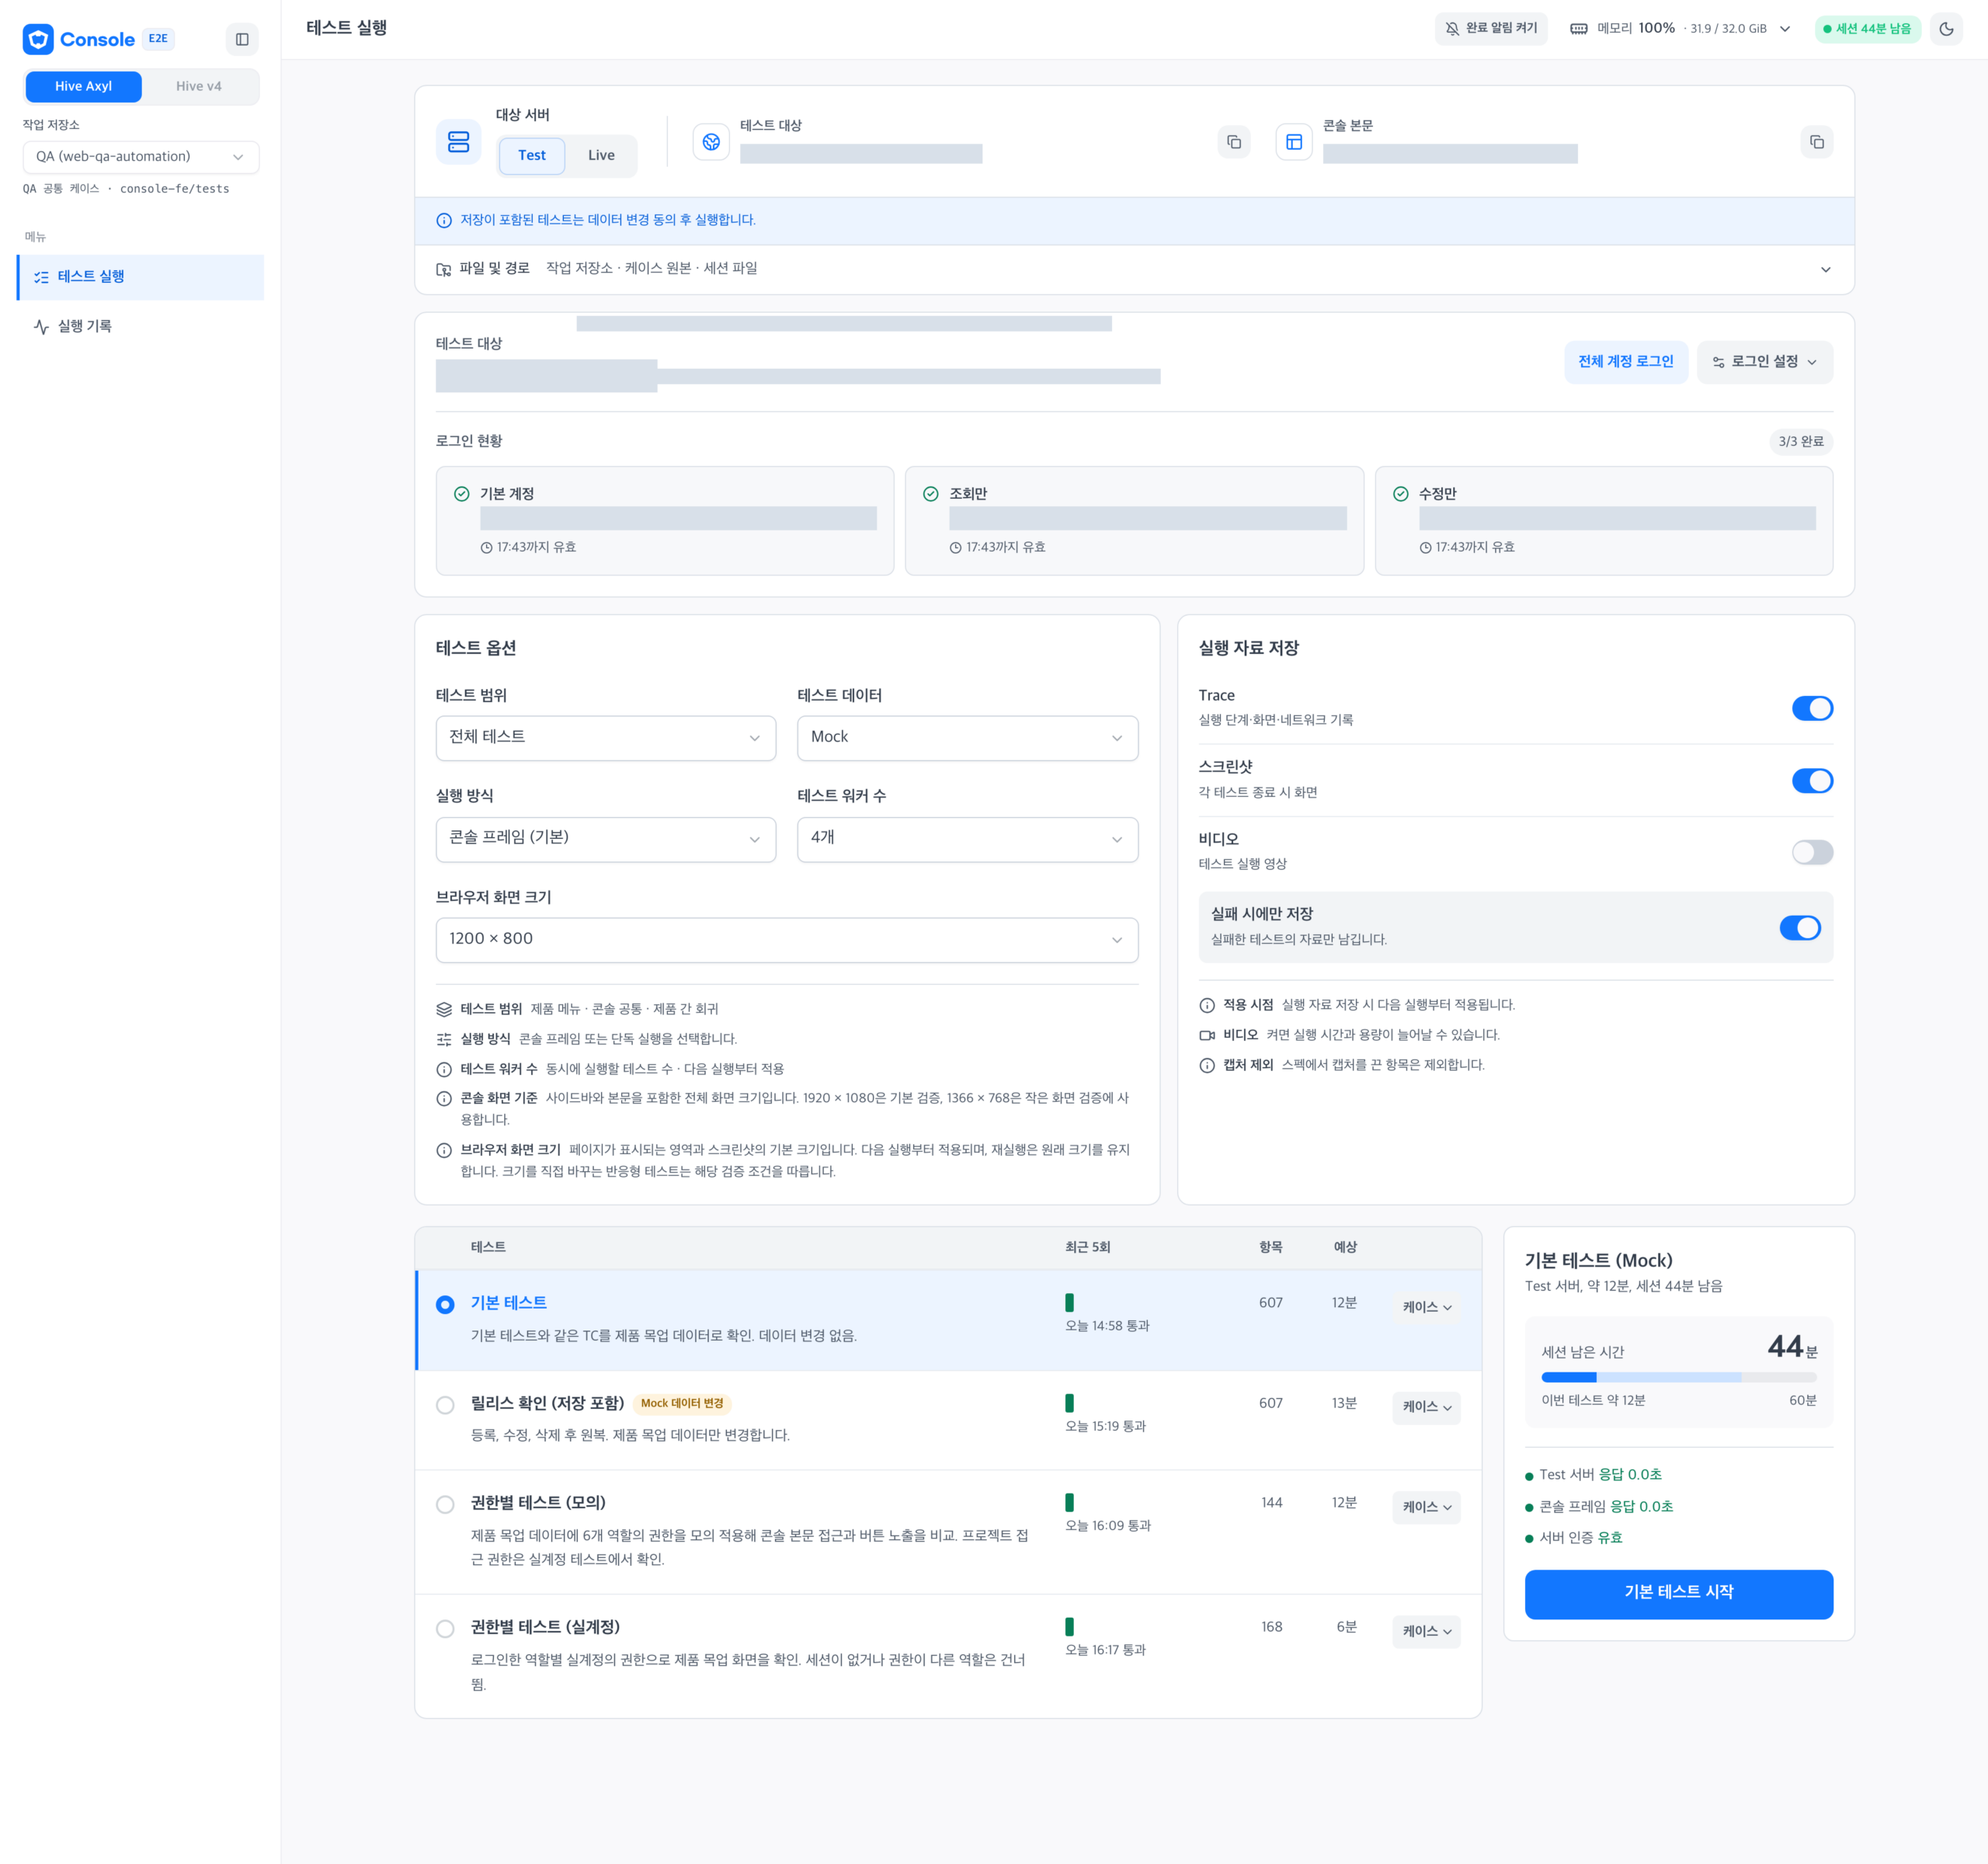
출발점은 기능을 수정할 때마다 반복하던 확인 작업이었다. 로그인하고 메뉴를 찾아가 값을 입력하는 흐름을 매번 손으로 되풀이하는 대신 코드로 옮겨 두면 같은 확인을 언제든 다시 돌릴 수 있다. 지금은 이렇게 만든 테스트를 돌리며 제품의 변경 사항과 테스트의 검증 기준을 함께 점검하고 있다. 그림 1은 지금 쓰고 있는 도구의 전체 화면이다.
💡 알아 두면 좋은 용어
- E2E(End-to-End) 테스트 사용자가 화면에 들어와 입력하고 결과를 확인하기까지의 흐름을 실제와 같은 환경에서 점검하는 테스트다. 단위 테스트가 함수 하나를 본다면, E2E 테스트는 여러 기능이 이어지는 구간을 본다.
- Playwright 마이크로소프트가 만든 오픈소스 브라우저 자동화 도구다. Chromium·Firefox·WebKit에서 같은 코드로 테스트를 실행할 수 있다.
- storageState 로그인한 뒤의 쿠키와 저장소 상태를 파일로 저장하는 Playwright 기능이다. 테스트마다 로그인을 반복하지 않아도 된다.
- MSW(Mock Service Worker) 브라우저의 네트워크 요청을 가로채 미리 정한 응답을 돌려주는 도구다. 서버 없이도 화면 동작을 확인할 수 있다.
- Trace Viewer 테스트 실행 과정을 단계별로 기록해 다시 보여 주는 Playwright 도구다.
- iframe 웹 페이지 안에 다른 웹 페이지를 끼워 넣어 보여 주는 HTML 요소다. 콘솔은 공통 화면 안에 각 제품 화면을 iframe으로 띄운다.
Playwright로 콘솔의 사용자 흐름 자동화하기
앱 서버 등록을 예로 들면 화면에 진입하고, 필수 항목을 비운 채 등록을 시도한 뒤, 오류 안내가 나타나는지 확인하는 흐름을 테스트한다. 버튼이나 함수 하나의 동작에 더해 화면 이동과 입력, 응답이 연결되는 구간을 점검하는 것이다.
이를 실행하는 도구로 Playwright를 사용했다. 실제 브라우저에서 클릭과 입력을 수행하고, 화면이 기대한 상태가 됐는지 코드로 검증할 수 있다. 테스트 케이스에 적힌 확인 내용과 기대 결과를 바탕으로 AI에게 Playwright 테스트 스펙 파일 작성을 맡겼다. 이 과정에서 로그인 상태나 데이터 조건처럼 실행에 필요한 전제도 함께 정리했다.
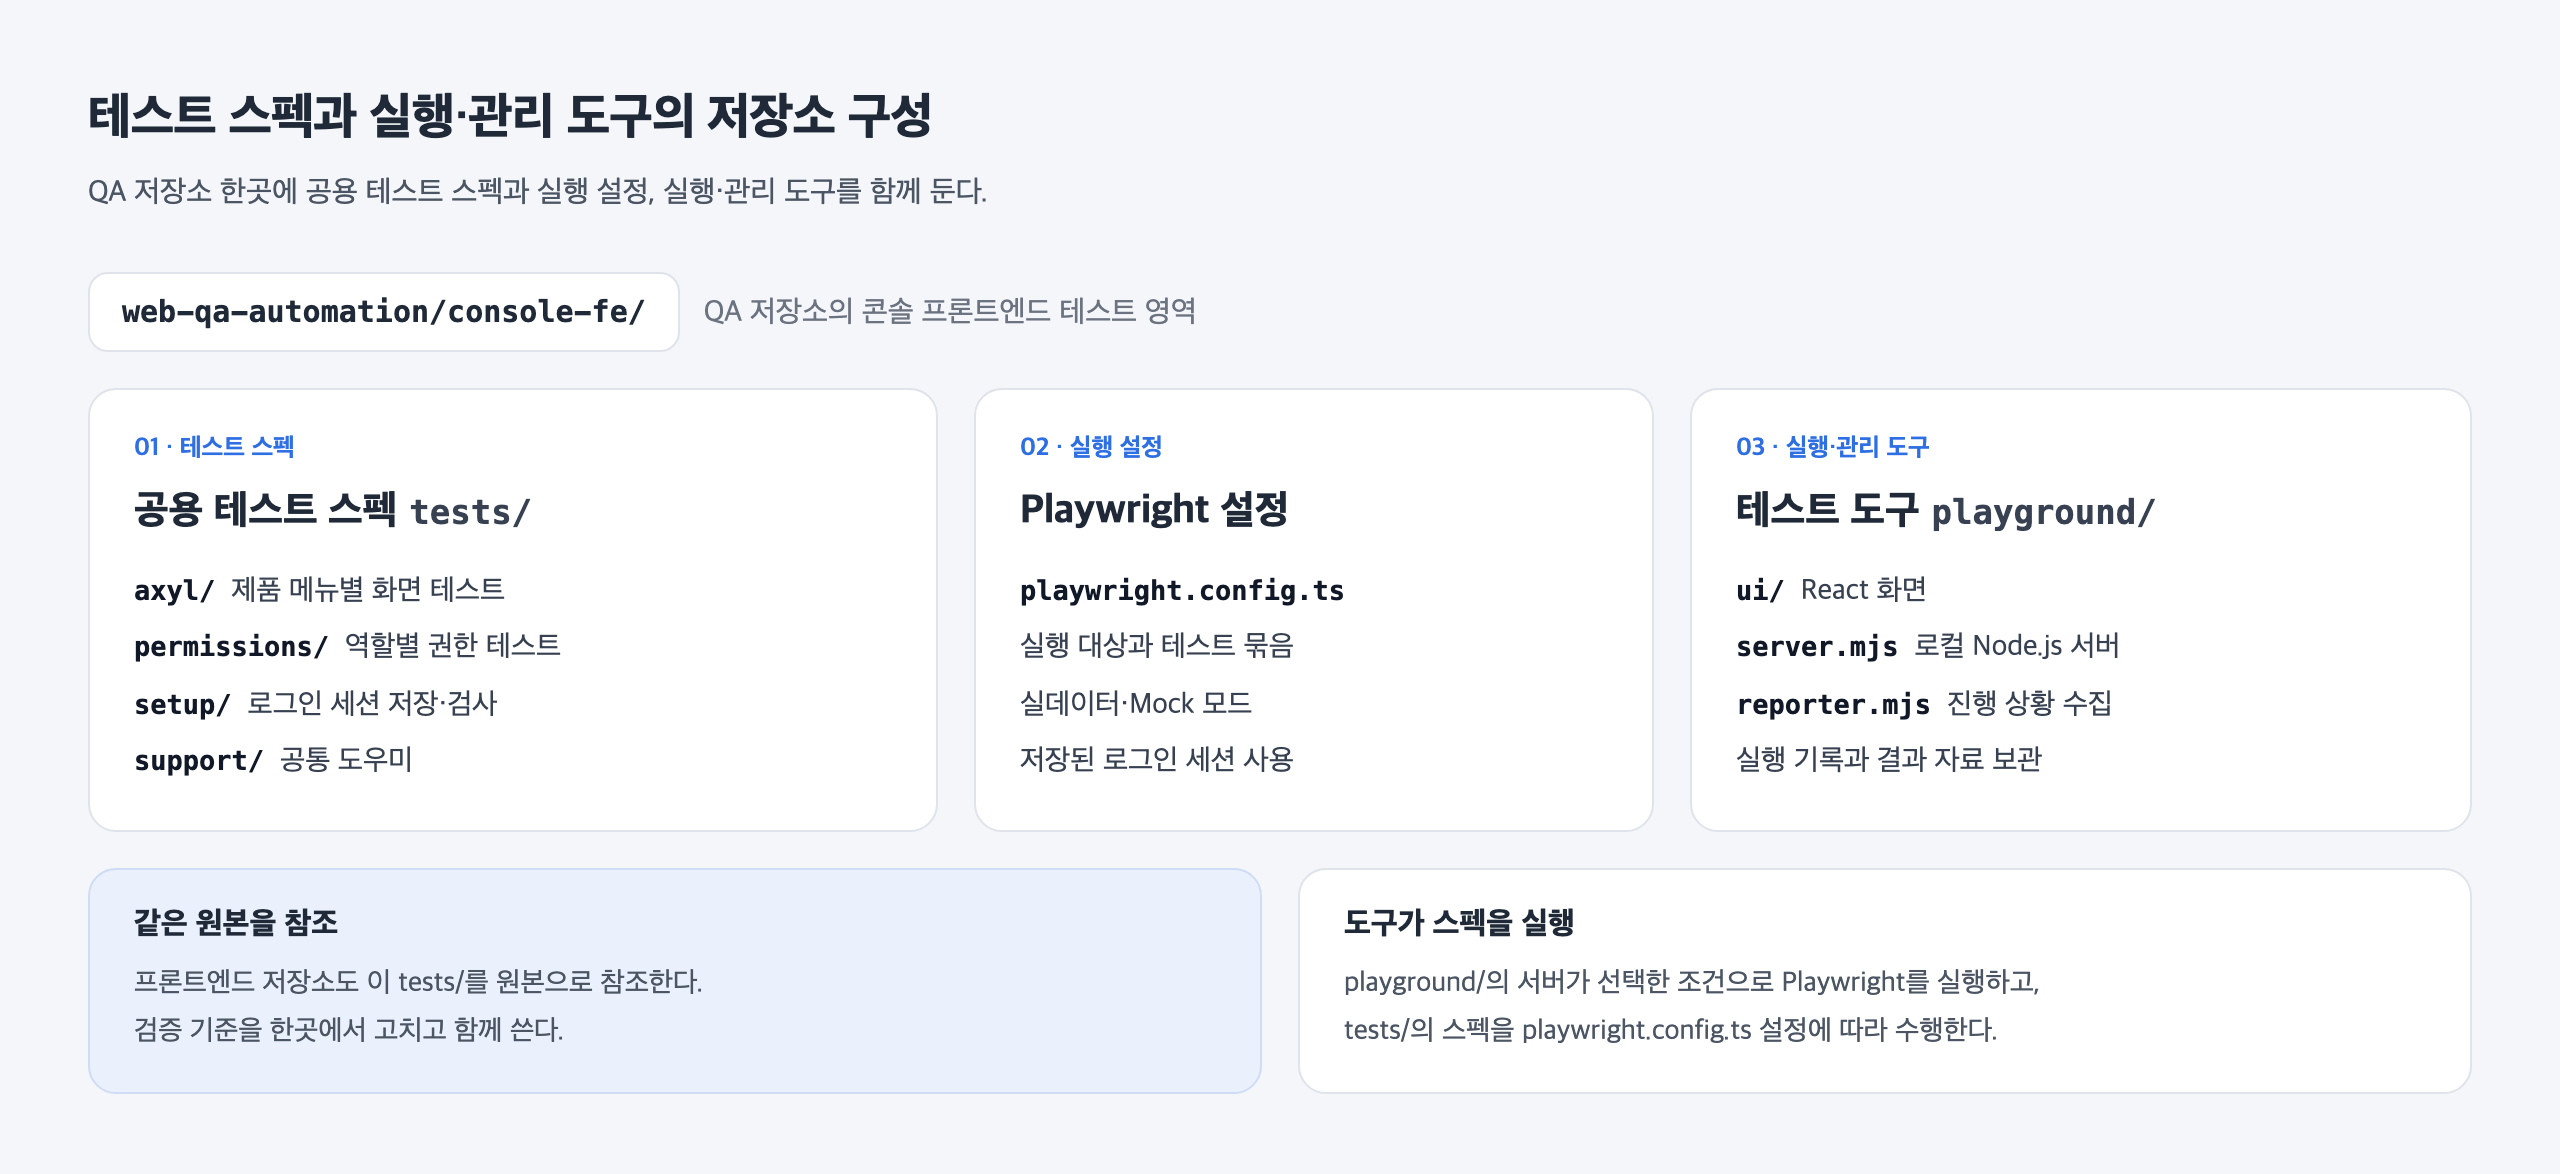
이렇게 작성한 테스트 스펙 파일의 원본은 QA 저장소에서 공용으로 관리하고, 프론트엔드 저장소에서도 같은 원본을 참조하도록 했다. 각자 다른 복사본을 수정하다 검증 기준이 어긋나는 일을 줄이기 위해서다. 제품이 바뀌면 테스트 케이스에 적힌 확인 내용·기대 결과와 구현을 대조하고, 필요한 테스트 코드를 같은 원본에서 보완할 수 있도록 구성했다. 그림 2는 이렇게 정리한 저장소의 구성이다.
MCP로 바로 확인하기와 스펙 파일로 반복 검증하기
AI에게 “이 화면을 테스트해 줘”라고 요청하면 Playwright MCP처럼 AI가 브라우저를 조작할 수 있게 해 주는 도구를 활용할 수 있다. AI가 화면 상태를 확인하며 클릭과 입력을 이어 가는 방식은 새로운 화면을 탐색하거나 특정 문제를 한 번 확인할 때 유용하다.
반복 검증할 흐름은 실행 절차와 기대 결과를 스펙 파일로 남겨 두면 재사용하기 쉽다. 예를 들어 ‘필수 항목을 비운 채 등록을 시도하면 오류 안내가 나타난다’는 조건을 코드로 저장하면, 다음 실행에서도 같은 검증 기준을 적용할 수 있다. 이번에 구축한 방식은 AI로 이 스펙 파일을 작성하고, 실행·관리 도구가 Playwright를 호출해 저장된 테스트를 수행하도록 한 것이다.
효율 측면에서는 매 실행마다 AI가 화면을 해석하고 다음 동작을 결정하는 호출을 줄일 수 있다는 장점이 있다. 저장된 스펙 자체는 실행 단계마다 AI의 추론을 요구하지 않으며, 필요한 테스트만 선택하거나 병렬로 실행할 수 있다. 따라서 같은 범위를 자주 검증할수록 반복적인 AI 호출과 대기 시간을 줄이는 데 유리할 수 있다. 다만 처음 스펙을 작성하고 검토하는 작업, 제품 변경에 맞춰 유지하는 작업은 필요하며 실제 절감 효과는 따로 측정해야 한다.
두 방식은 함께 활용할 수 있다. MCP로 탐색한 흐름을 검토해 스펙 파일로 남기거나, AI에게 기존 스펙을 실행하고 실패 원인을 분석하도록 요청할 수도 있다. 반복 검증에서는 실행 조건과 기대 결과를 코드로 관리하고, 계정·데이터·환경 조건도 함께 맞춰야 결과를 일관되게 비교할 수 있다.
콘솔의 인증 구조와 데이터 환경에 맞춰 구축하기
이번에 테스트한 콘솔 화면은 공통 화면인 셸 안에 제품 화면을 iframe으로 표시하는 구조다. 제품 화면만 바로 열면 실제 사용자가 로그인하고 메뉴로 들어가는 상황과 조건이 달라질 수 있다. 따라서 셸에서 메뉴를 선택해 제품 화면으로 진입하는 흐름을 기본으로 잡았다. 실제 콘솔의 진입 경로와 인증 조건 안에서 테스트가 동작하도록 만드는 과정이었다.
로그인한 상태는 Playwright의 storageState에 저장해 재사용한다. 조회만 가능한 계정과 수정 가능한 계정의 세션은 분리하고, 실행 전에는 서버가 인증을 받아들이는지도 확인한다. 테스트가 한꺼번에 실패했을 때 기능 오류와 로그인 문제를 구분하려면, 먼저 실행 조건이 유효한지 알 수 있어야 했다.
데이터는 실데이터와 Mock 두 가지 모드로 나눴다. 실데이터에서는 실제 서버와의 연동을 확인하고, Mock에서는 MSW가 제공하는 모의 응답으로 화면 동작을 반복 검증한다. 기본 테스트 코드는 공용으로 사용하되 검증 범위는 구분한다. 실제 데이터를 저장하거나 삭제하는 실행에는 확인 절차를 두고, 운영 환경에서는 해당 실행을 차단했다.
AI를 통해 구축한 도구로 테스트 실행과 결과 관리하기
테스트 스펙 파일을 작성하는 데 이어, 계정과 데이터 모드, 실행 범위 같은 조건을 한곳에서 설정하고 결과까지 확인할 수 있도록 AI와 함께 별도의 실행·관리 도구도 만들었다. 화면은 React와 TypeScript로 만들고, 로컬 Node.js 서버가 선택한 조건에 맞춰 Playwright를 실행하도록 구성했다. 진행 상황과 케이스별 결과가 화면에 반영되므로, 브라우저에서 테스트 실행과 결과 확인을 이어 갈 수 있다.
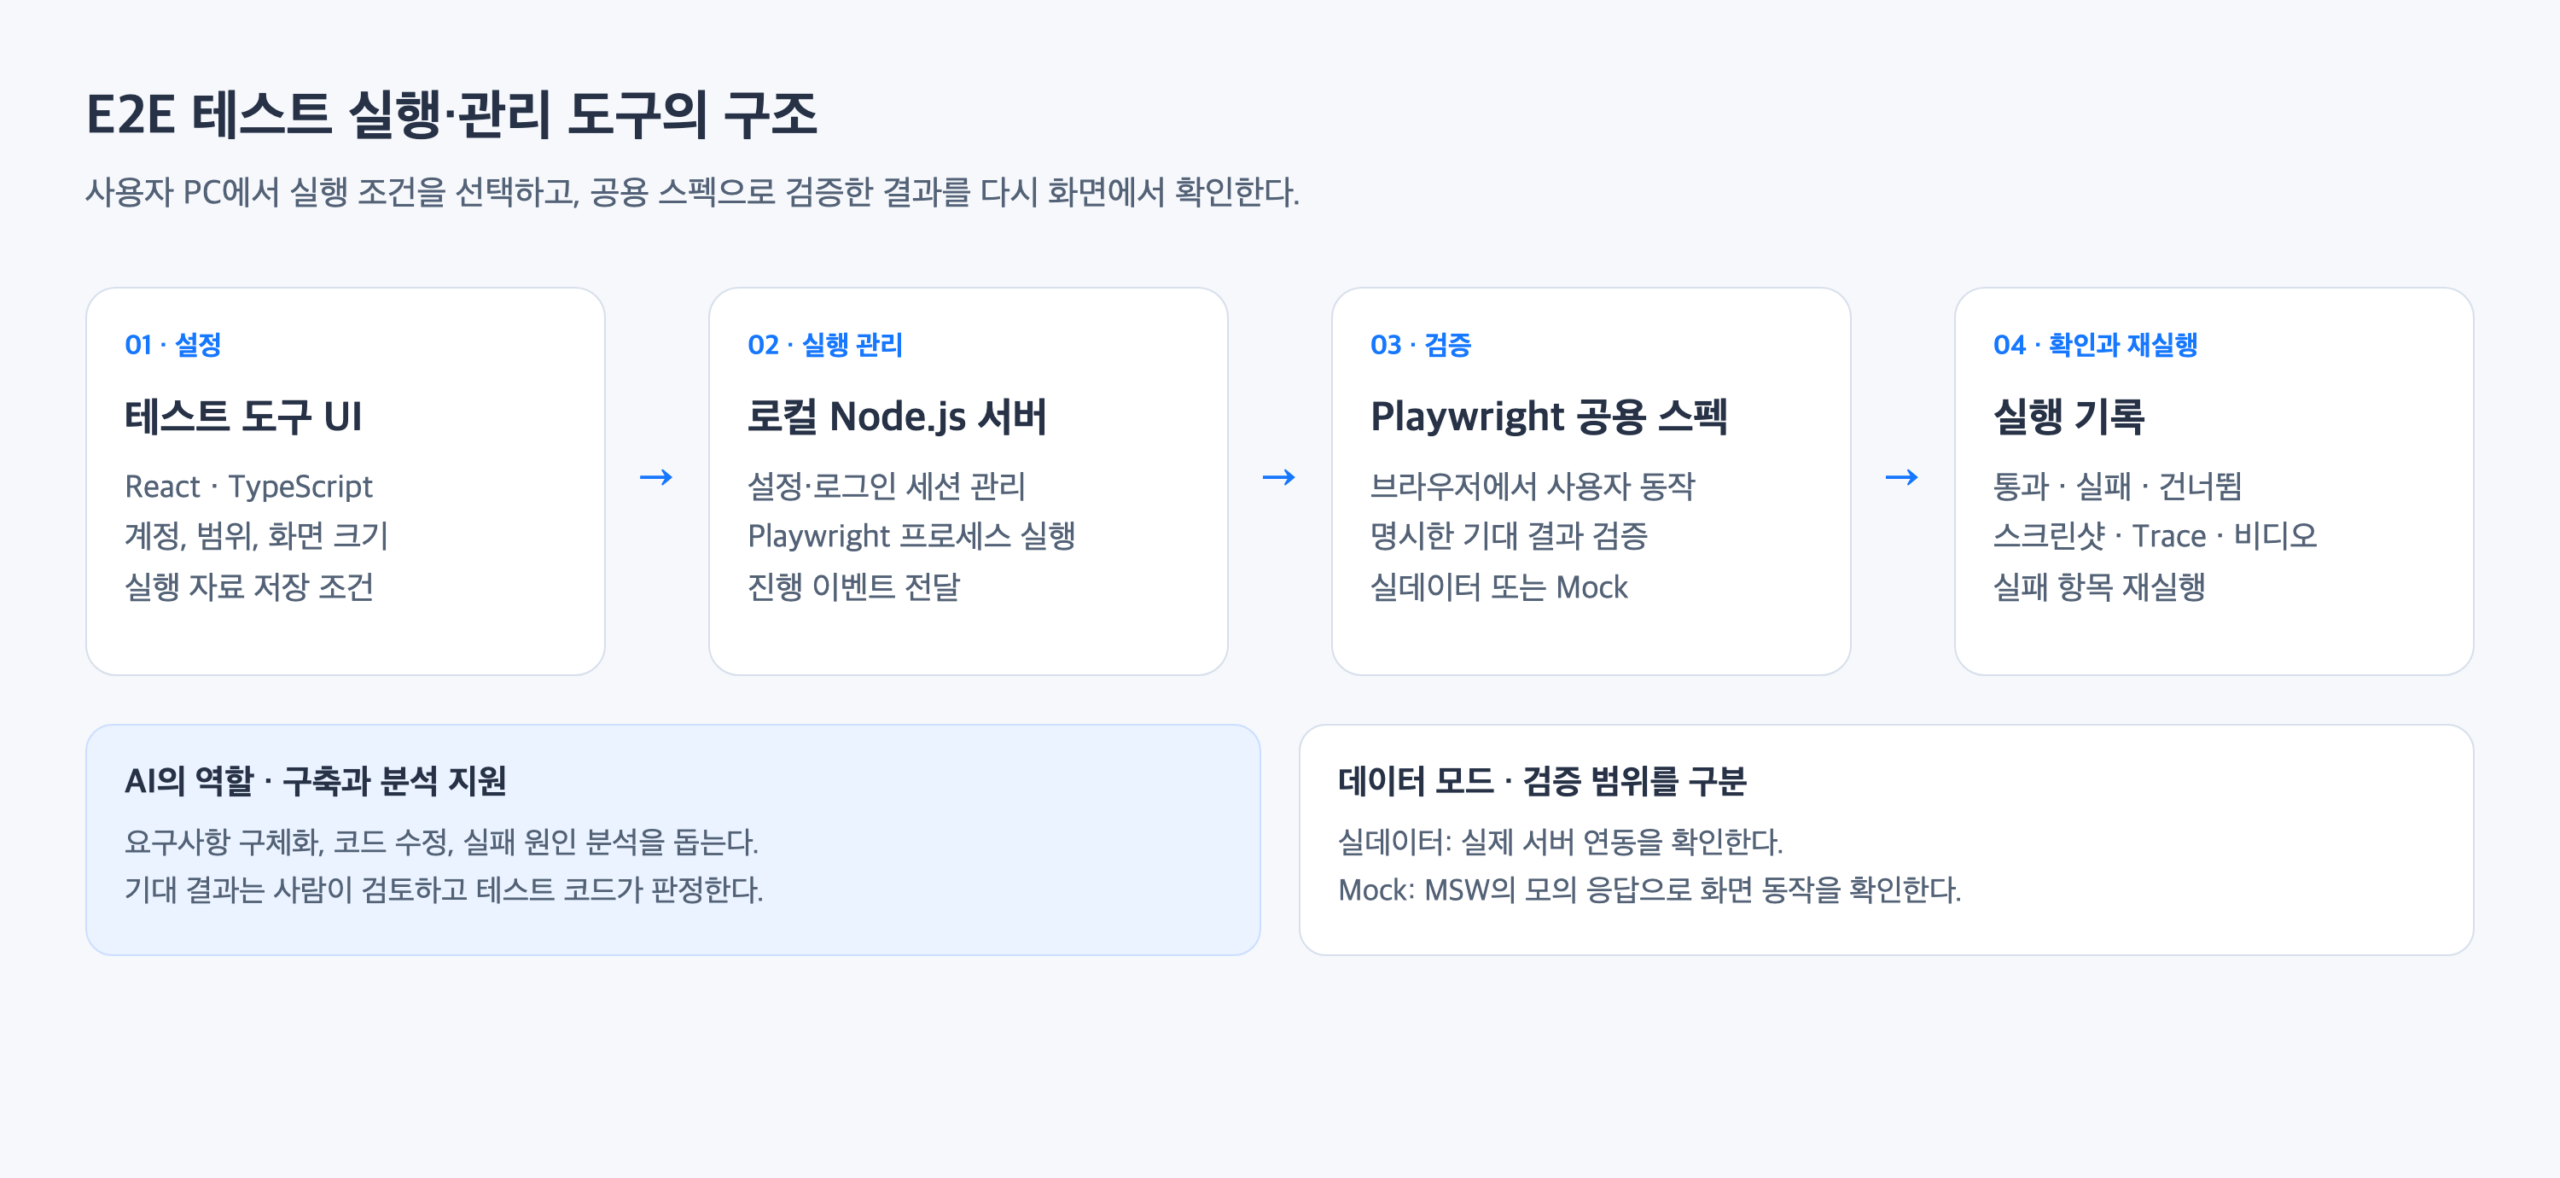
실제로 사용할 때는 권한별 계정과 로그인 상태를 확인한 뒤 실데이터 또는 Mock을 선택한다. 테스트 범위와 브라우저 크기, 동시 실행 수를 정해 실행하고, 완료 후에는 실행 기록에서 결과를 분석한다. 문제를 수정하면 필요한 항목만 다시 실행한다. 테스트는 네 가지로 나눠 두었다. 데이터를 바꾸지 않는 기본 테스트, 등록·수정·삭제 후 원복까지 하는 저장 포함 테스트, 권한 응답을 Mock으로 흉내 내 역할별 화면을 비교하는 권한별 테스트(모의), 역할별 실제 계정으로 로그인해 확인하는 권한별 테스트(실계정)다.
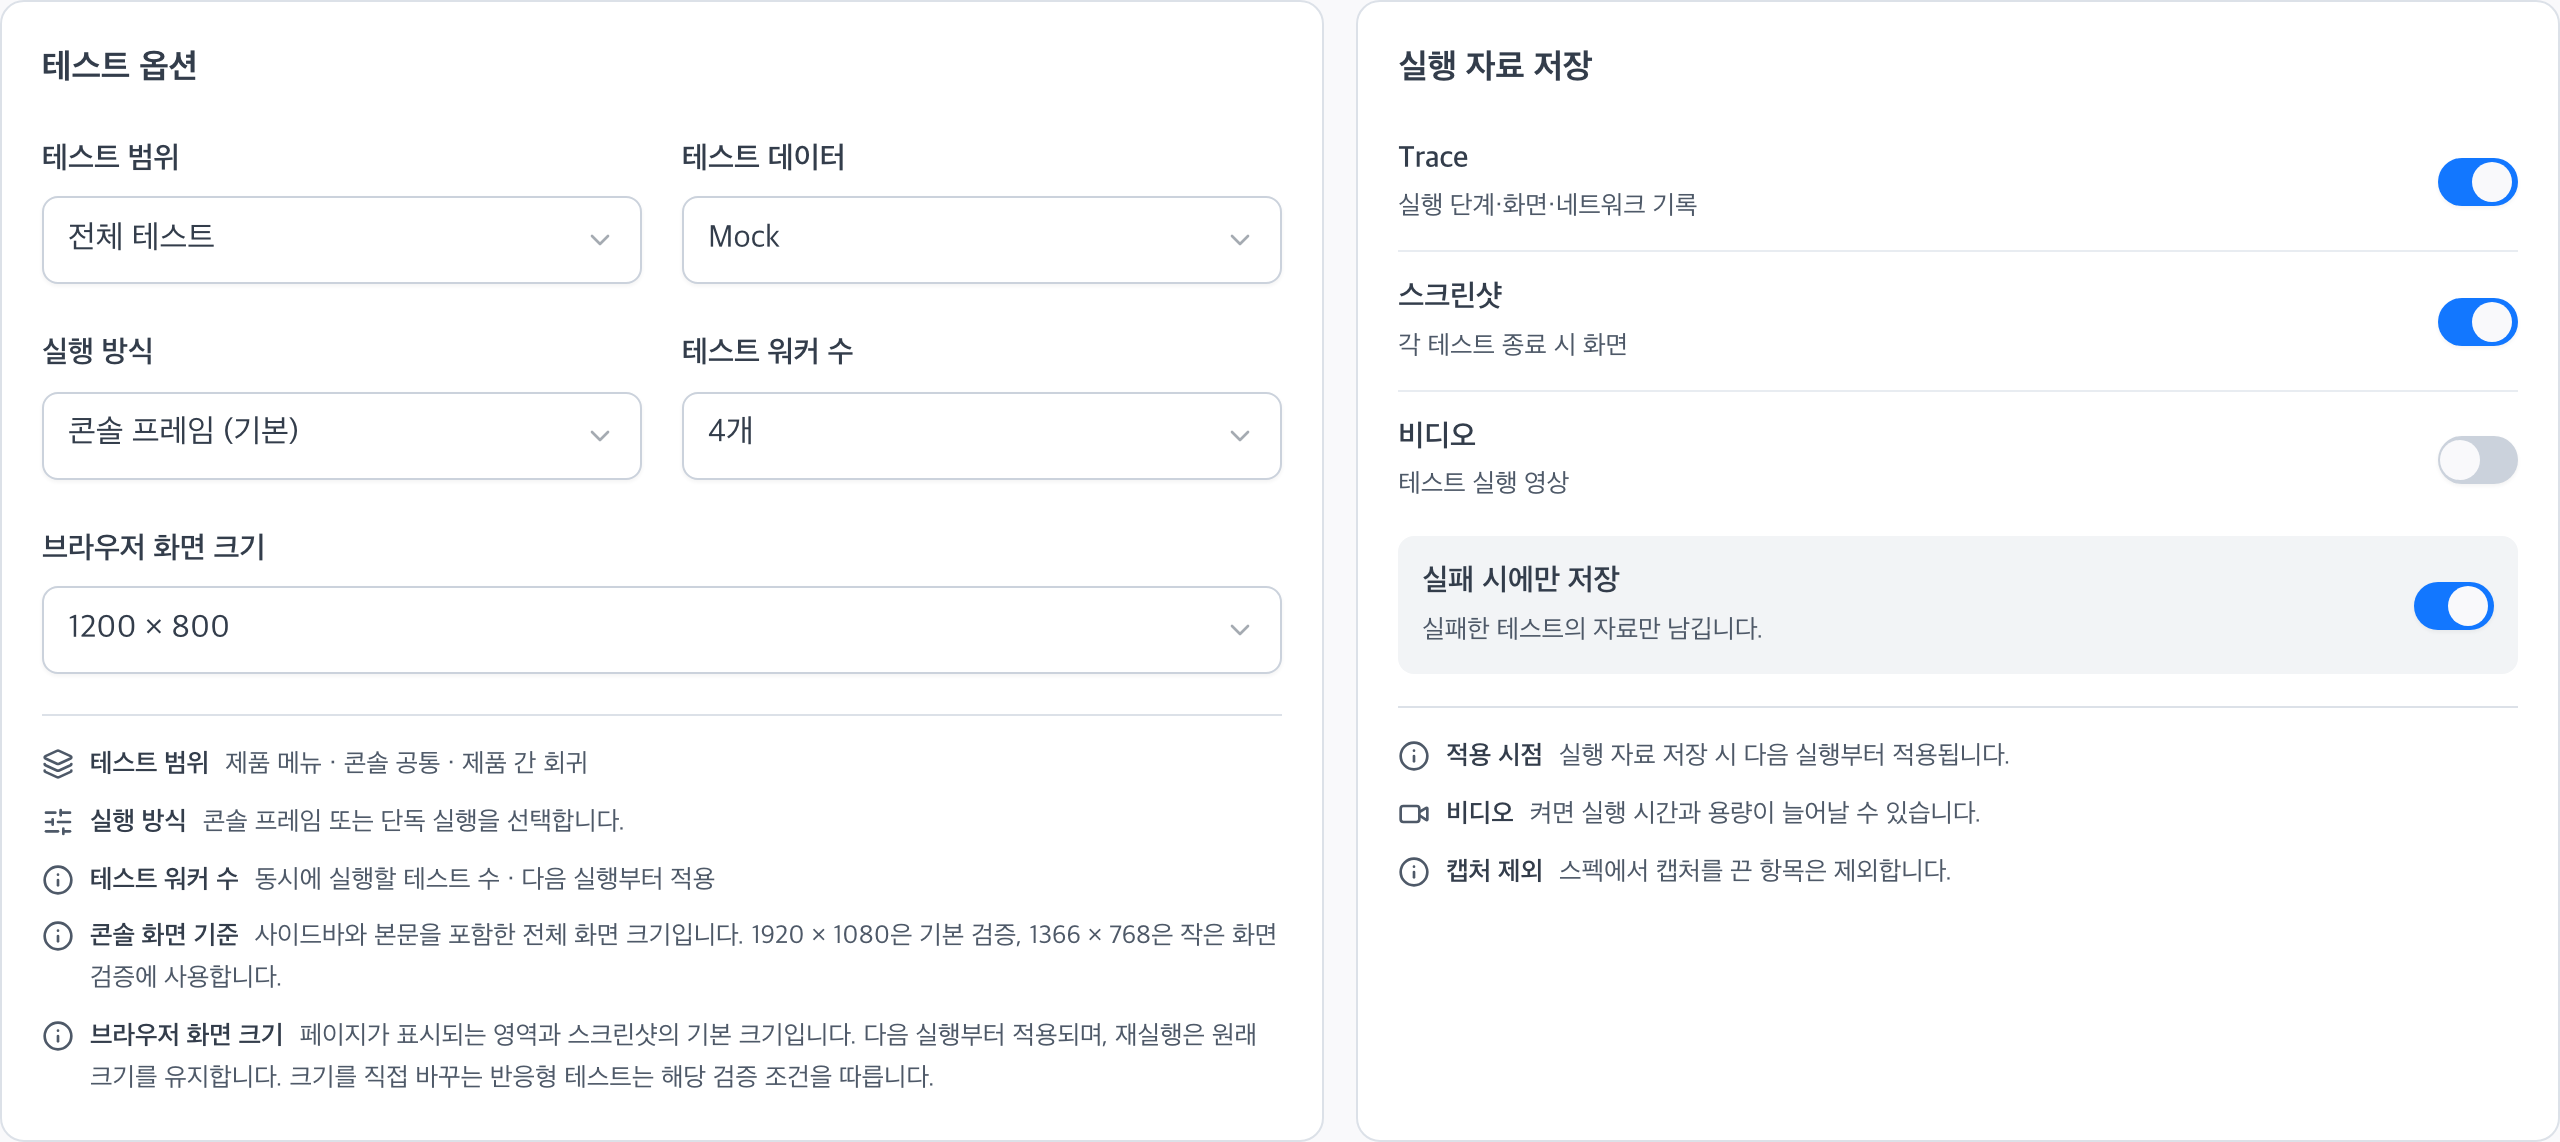
구축 과정에서는 필요한 기능을 구체적인 동작으로 정리해 AI에게 전달했다. “실패한 항목만 한 번에 다시 실행하고, 결과를 원래 기록에 포함해 달라”는 식이다. AI가 저장소를 읽고 코드를 수정하면 실제로 실행해 동작을 확인했다. 재실행 대상이 올바른지, 이전 결과와 새 결과가 제대로 연결되는지까지 살피며 수정과 검증을 반복했다.
이 과정을 거쳐 실패 항목의 일괄 재실행 결과를 원래 실행 기록에 연결했다. 특정 계정의 상태를 직접 확인할 수 있도록 계정별 브라우저 열기도 추가했다. 테스트를 돌리며 발견한 불편을 구현할 기능으로 정리하고, AI와 함께 수정한 뒤 실제 동작을 확인하는 방식이었다.
AI는 테스트 스펙 작성과 도구 구현, 결과 분석에 활용했다. AI가 작성한 테스트의 기대 결과는 제품 요구 사항과 원래 테스트 케이스를 기준으로 검토하고, 실제로 실행해 의도한 동작을 검증하는지 확인했다. 통과 여부는 Playwright 테스트 스펙에 작성한 검증 조건으로 판정한다.
직접 돌려 보며 실행 결과의 신뢰도 높이기
실제로 사용하면서 예상하지 못한 문제도 드러났다. 테스트는 통과했는데, 스크린샷에는 오른쪽 패널이 끝까지 열리지 않은 모습이 남아 있었다. 요소가 나타났다는 조건은 만족했지만 애니메이션은 아직 진행 중이었던 것이다. 패널과 안내 메시지의 표시가 안정된 뒤 캡처하도록 보완했다. 오류 안내가 나왔을 때 입력창과 삭제 버튼의 정렬이 유지되는지도 별도로 검증했다.
실행 기록에서는 확인 내용과 기대 결과뿐 아니라 저장된 스크린샷과 Trace도 바로 열어 볼 수 있다. 스크린샷은 도구 안에서 확대하고 앞뒤 케이스로 넘겨 보며 화면을 비교한다. ‘Trace 열기’를 누르면 Playwright Trace Viewer에서 클릭·입력 등의 실행 단계와 각 시점의 화면, 네트워크 요청을 확인할 수 있다. 이 기록으로 실패가 발생한 지점을 살핀 뒤 개별 항목이나 실패 항목 전체를 다시 실행한다.
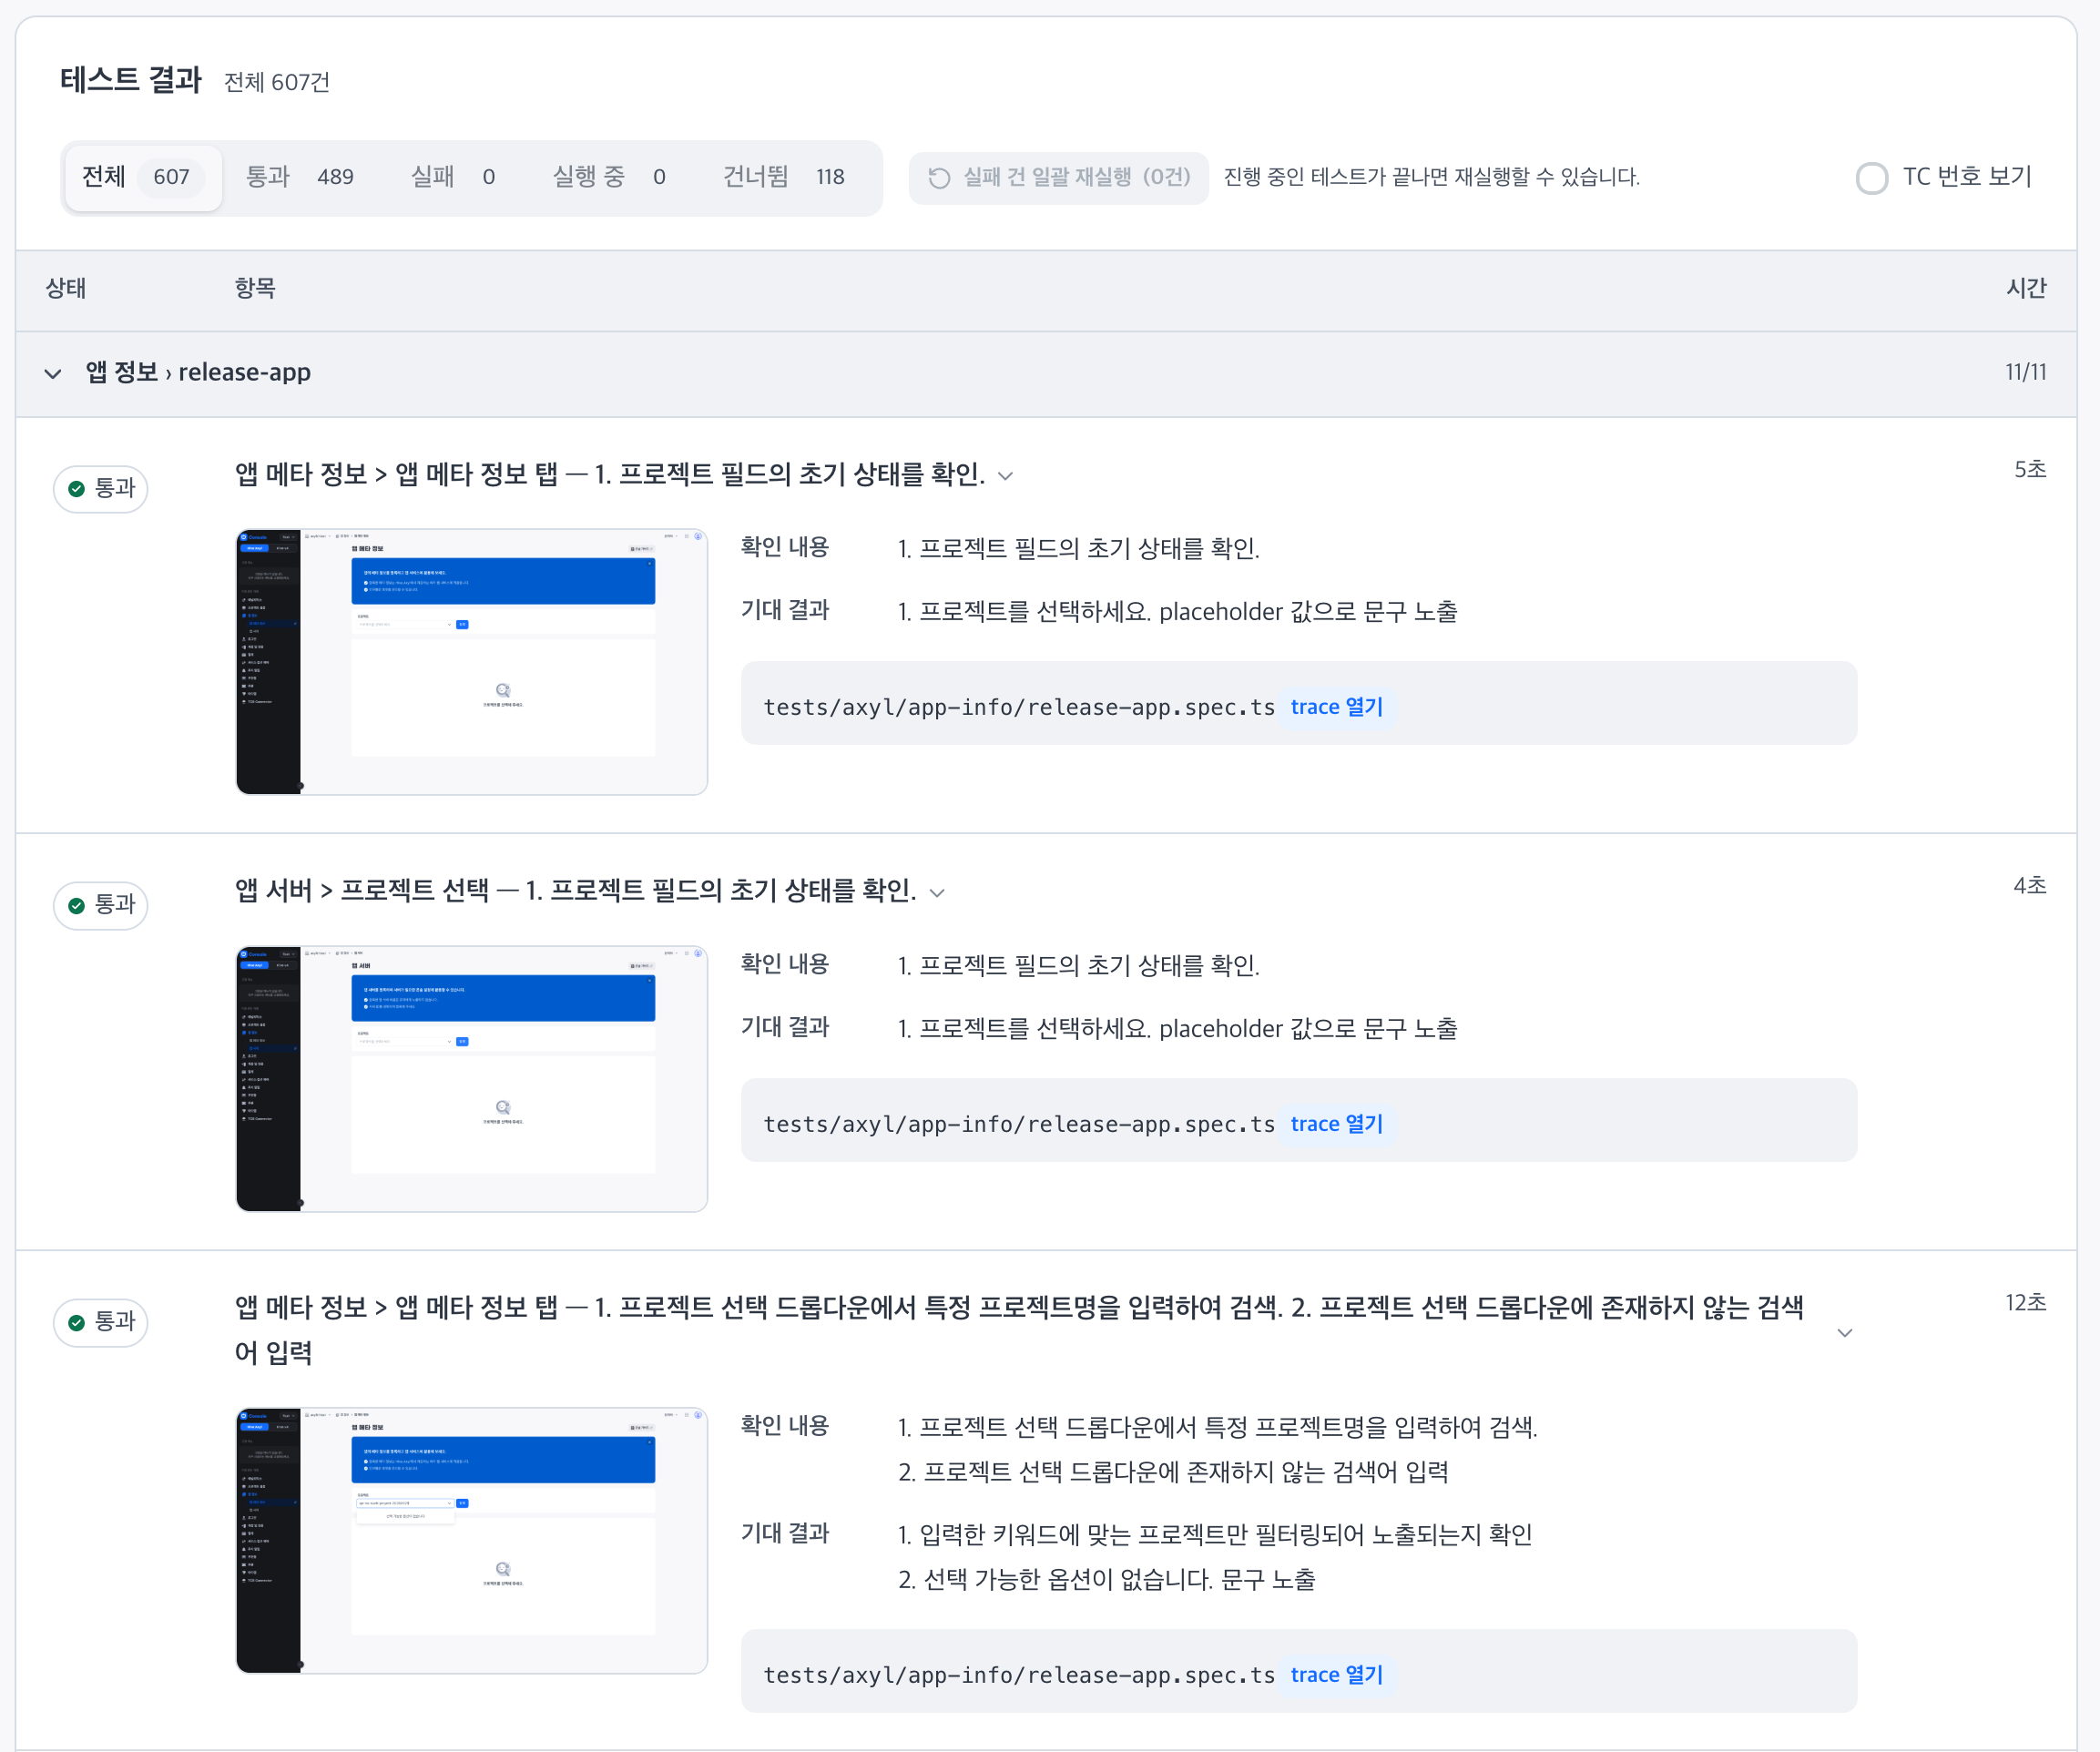
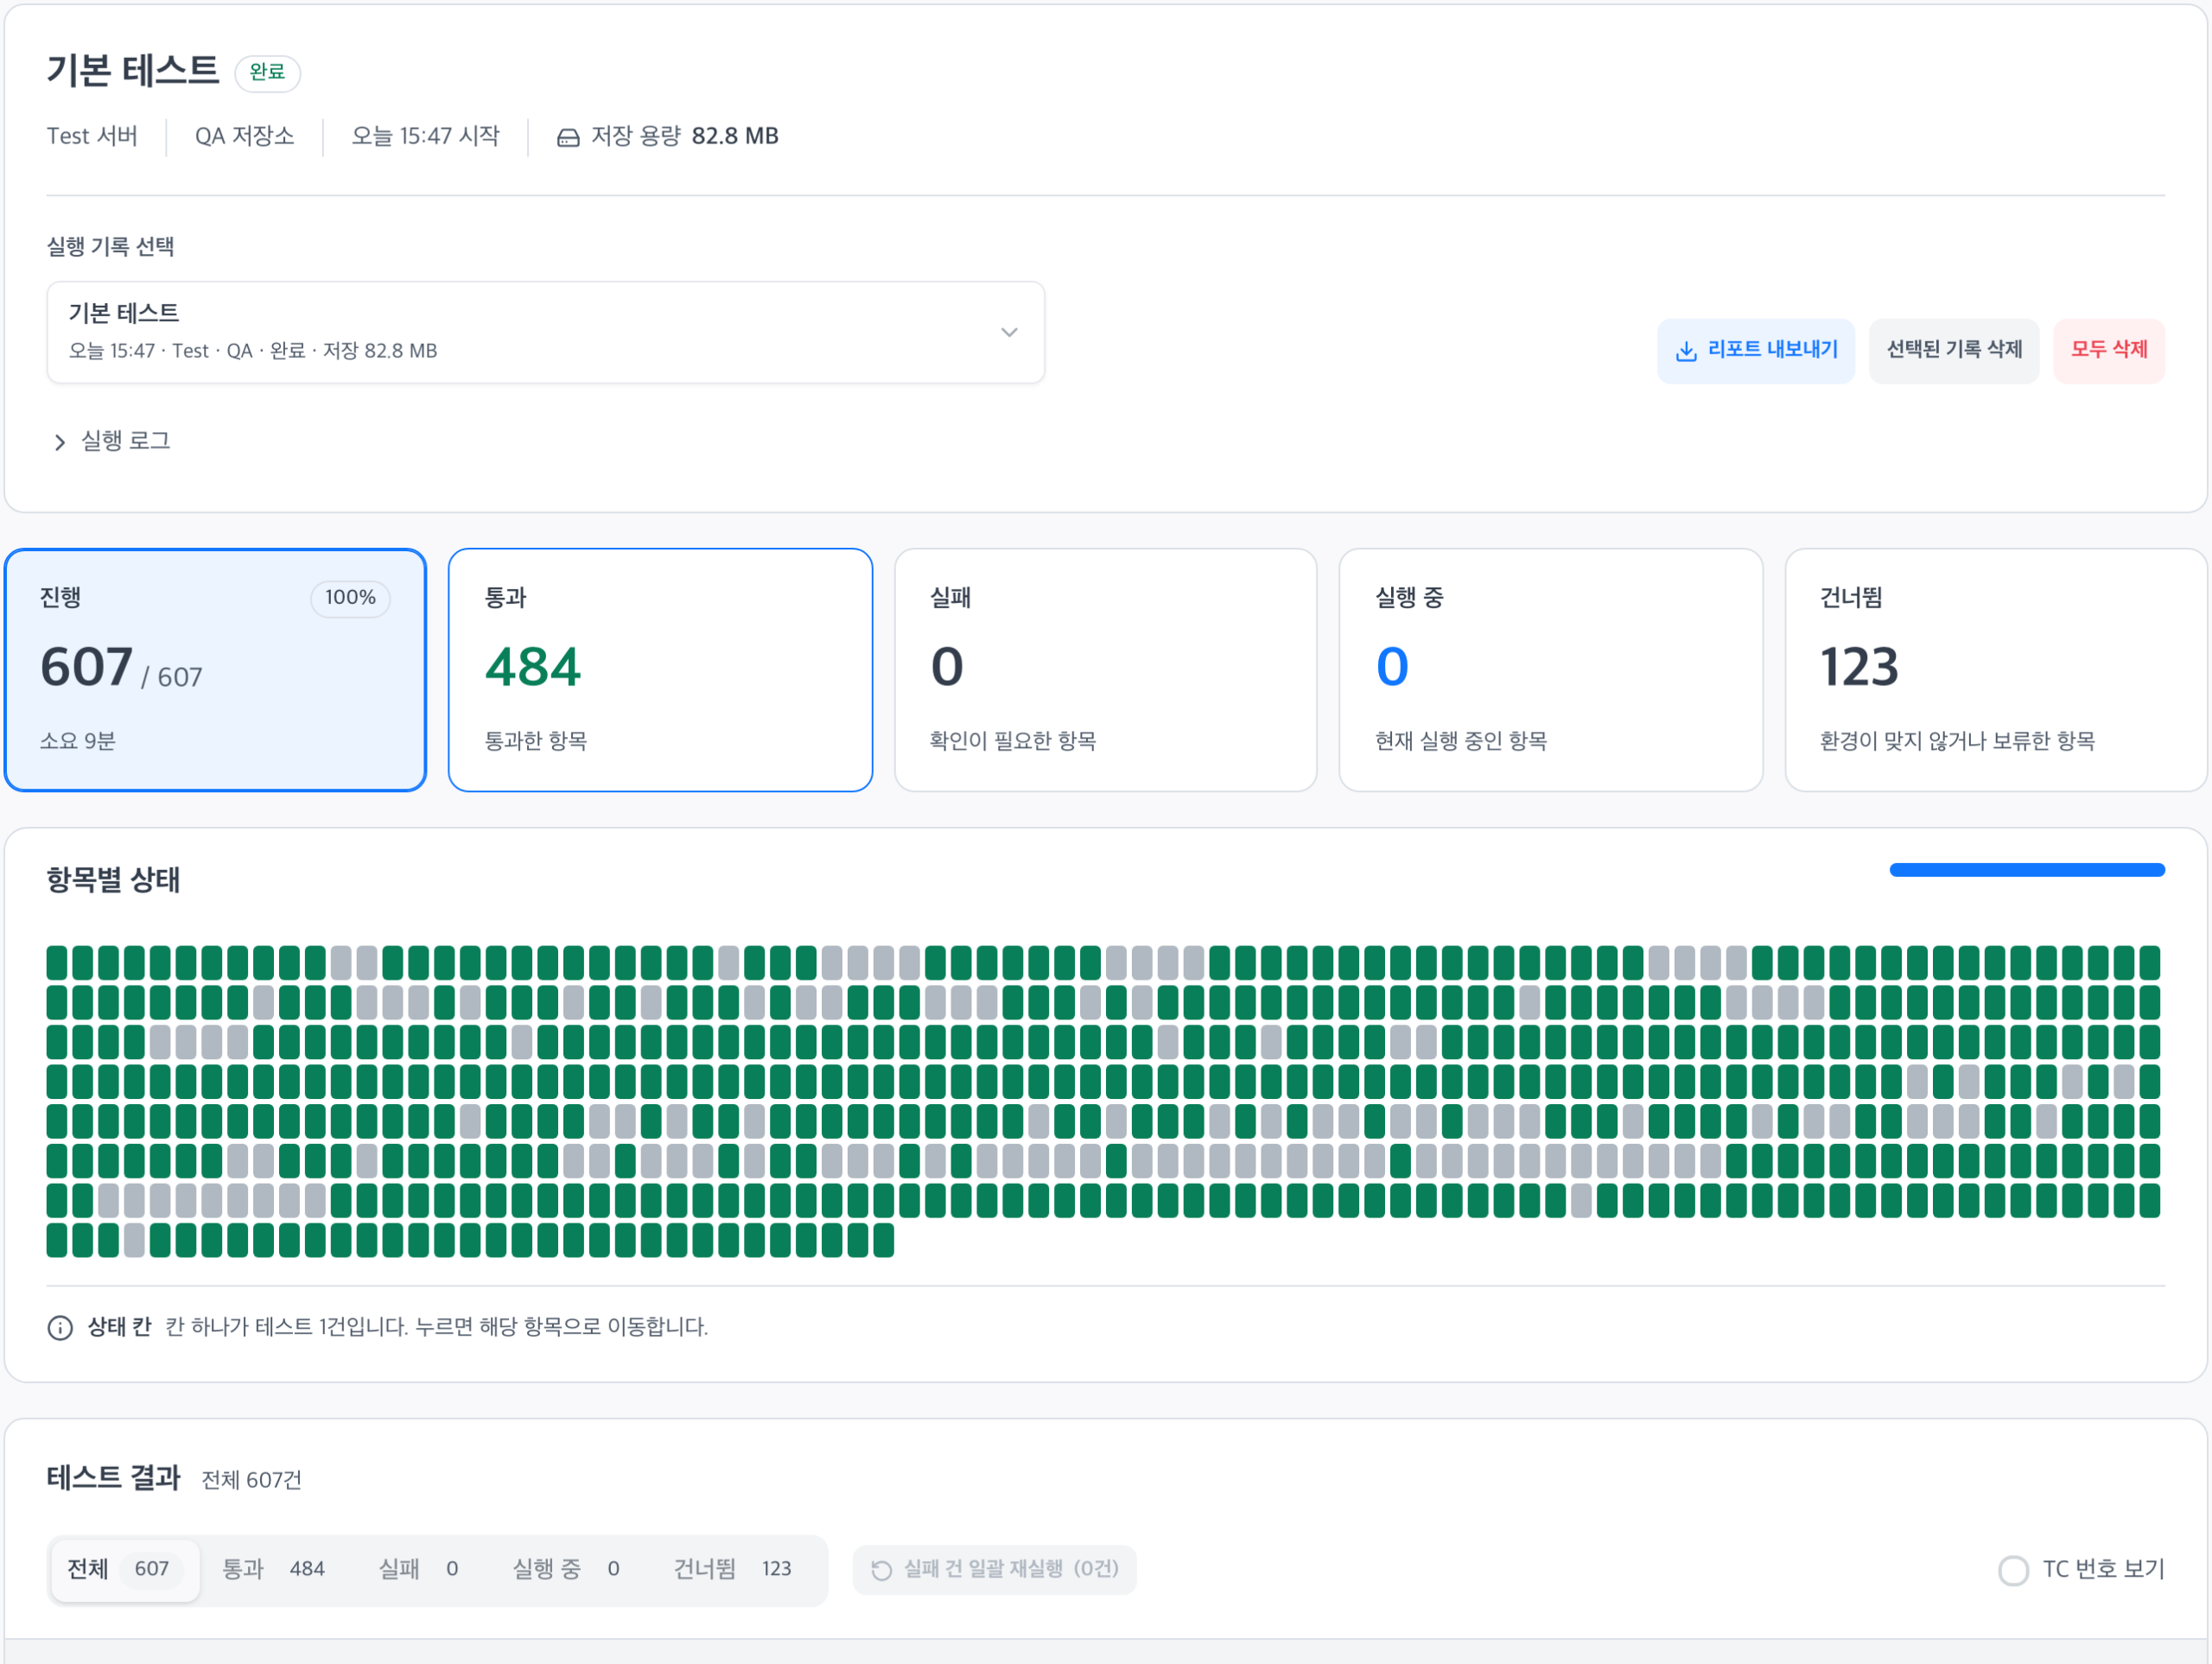
현재 결과 화면에서는 통과와 실패뿐 아니라 건너뜀도 구분한다. 그림 6의 2026년 10월 12일 기본 테스트 기록은 607건 중 484건 통과, 123건 건너뜀이었다. 607건을 모두 검증한 결과는 아니라는 뜻이다. 따라서 통과한 항목뿐 아니라 건너뛴 항목과 그 이유도 함께 확인해야 한다. 이 기록에서 건너뛴 항목의 절반가량은 전용 데이터나 프로젝트가 없어 실행 조건을 만들 수 없는 경우였고, 3분의 1가량은 저장·키 발급처럼 실제 데이터를 바꾸는 동작이라 기본 실행에서 제외한 경우였다. 나머지는 대부분 기획과 테스트 케이스의 기대 결과가 서로 달라, 확인될 때까지 일부러 보류한 항목이다.
이렇게 보류한 항목을 다시 살펴보니 제품 변경을 테스트에 반영해야 하는 경우도 있었다. 앱을 식별하는 App ID를 Mock 데이터로 만들 때 생기던 오류가 제품 쪽에서는 고쳐졌지만, 테스트에는 이전 오류를 이유로 보류한 항목이 남아 있었다. 제품 코드와 원래 테스트 케이스를 대조해 보류를 해제하고 입력 방식도 수정했다. 해당 두 항목은 다시 실행해 통과했다. 실행 중인 테스트만큼, 보류된 테스트가 여전히 보류돼야 하는지도 살펴봐야 했다.
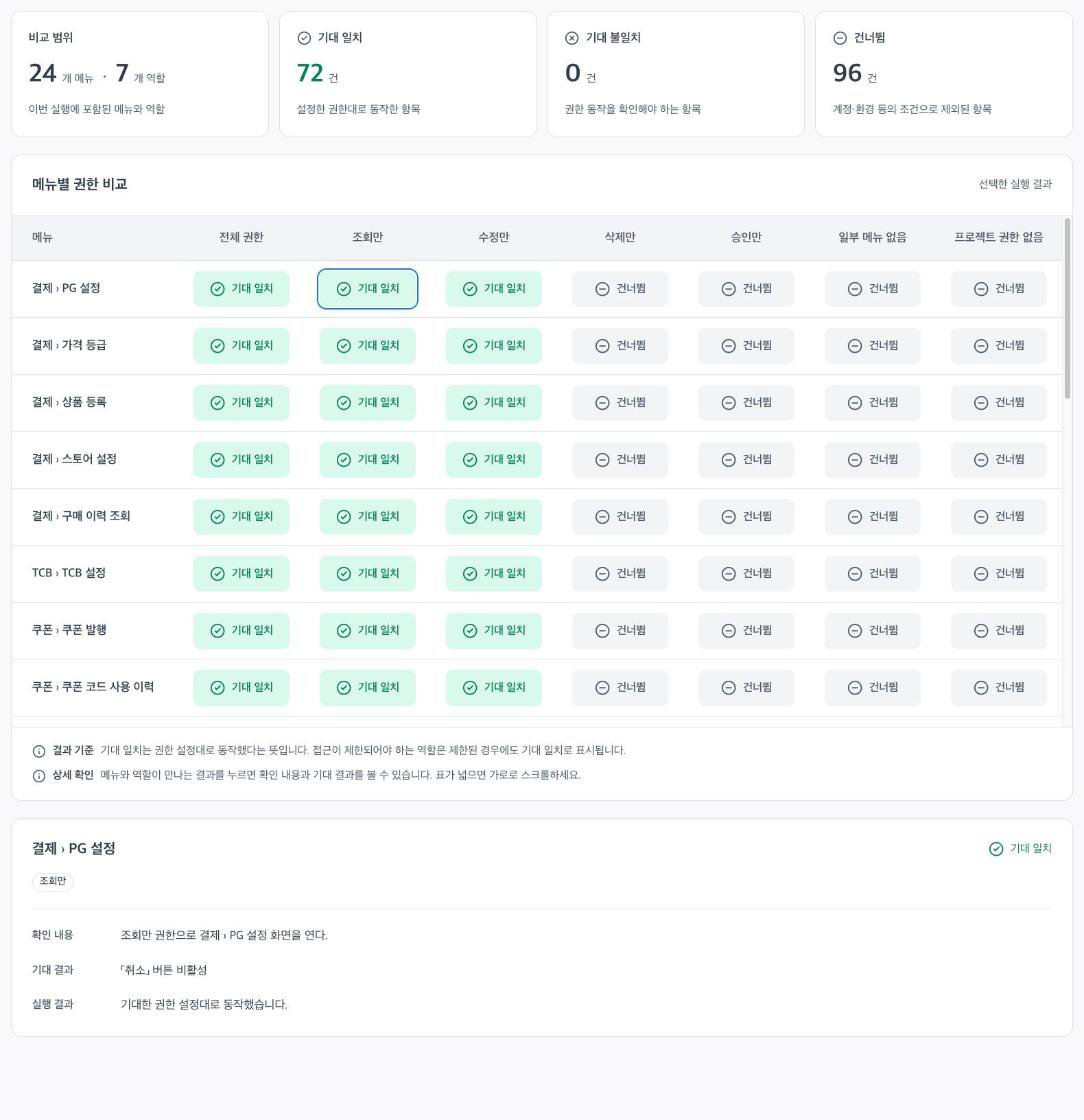
권한별 테스트 결과는 메뉴를 행, 역할을 열로 둔 권한 비교 표로 확인한다. 각 칸은 그 역할로 해당 메뉴를 열었을 때 권한 설정대로 동작했는지를 보여 준다. 접근이 막혀야 하는 역할이 실제로 막힌 경우도 ‘기대 일치’로 표시되고, 계정이 준비되지 않은 칸은 ‘건너뜀’으로 따로 표시한다. 권한 응답을 Mock으로 흉내 내 버튼 노출만 보는 모의 권한 확인과 실제 서버의 저장·삭제 권한 검증도 구분해서 해석한다. 그림 7의 10월 12일 실행에서는 전체 권한·조회만·수정만 세 역할만 실제로 실행됐고, 나머지 역할의 96건은 로그인 세션이 준비되지 않아 건너뛰었다.
정기 회귀 테스트와 비주얼 스크리닝으로 확장하기
지금은 준비된 계정으로 기본 테스트와 저장을 포함한 테스트, 권한별 테스트를 실행하며 결과를 확인하고 있다. 아직 계정이 준비되지 않아 검증하지 못하는 항목도 있다. 앞으로는 테스트의 사전 조건과 검증 범위를 더 명확히 정리하고, 권한별로 반복 실행할 수 있도록 전용 계정과 테스트 데이터를 보완하려 한다. 개발자와 품질 검증 담당자(QE)가 같은 조건으로 실행하고 같은 근거를 보며 결과를 논의할 수 있도록 하기 위해서다.
이후에는 변경한 메뉴에 필요한 테스트를 골라 실행하는 흐름을 정리하고, 안정적으로 반복 실행할 수 있는 항목부터 정기 회귀 테스트와 지속적 통합(CI) 환경에 연결할 계획이다. 이때도 결과 자료를 남겨 제품 결함과 테스트·환경 문제를 구분할 수 있도록 할 예정이다.
비주얼 스크리닝 기능도 추가할 계획이다. 현재는 저장된 스크린샷을 직접 살펴보며 화면 상태를 확인하지만, 앞으로는 기준 화면과 테스트 실행 화면을 비교해 레이아웃이나 요소 배치 등 시각적 변화를 자동으로 찾아낼 수 있도록 확장하려 한다. 앞서 패널이 완전히 열리지 않은 화면을 발견했던 경험을 바탕으로, 기능의 동작과 함께 화면의 시각적 변화도 점검하는 것이 목표다.
효과는 같은 범위의 확인 시간과 실패 분석 시간, 불안정한 테스트와 건너뜀의 변화를 기록해 살펴보려 한다. AI로 테스트 스펙과 실행·관리 도구를 만들고 사용 중 발견한 불편을 수정으로 이어 갈 수 있었지만, 검증 기준을 다듬는 일은 계속 필요하다. 반복 확인의 부담을 줄이고 개발자와 QE가 새로운 사용자 흐름에 집중할 수 있도록 확장해 나갈 계획이다.
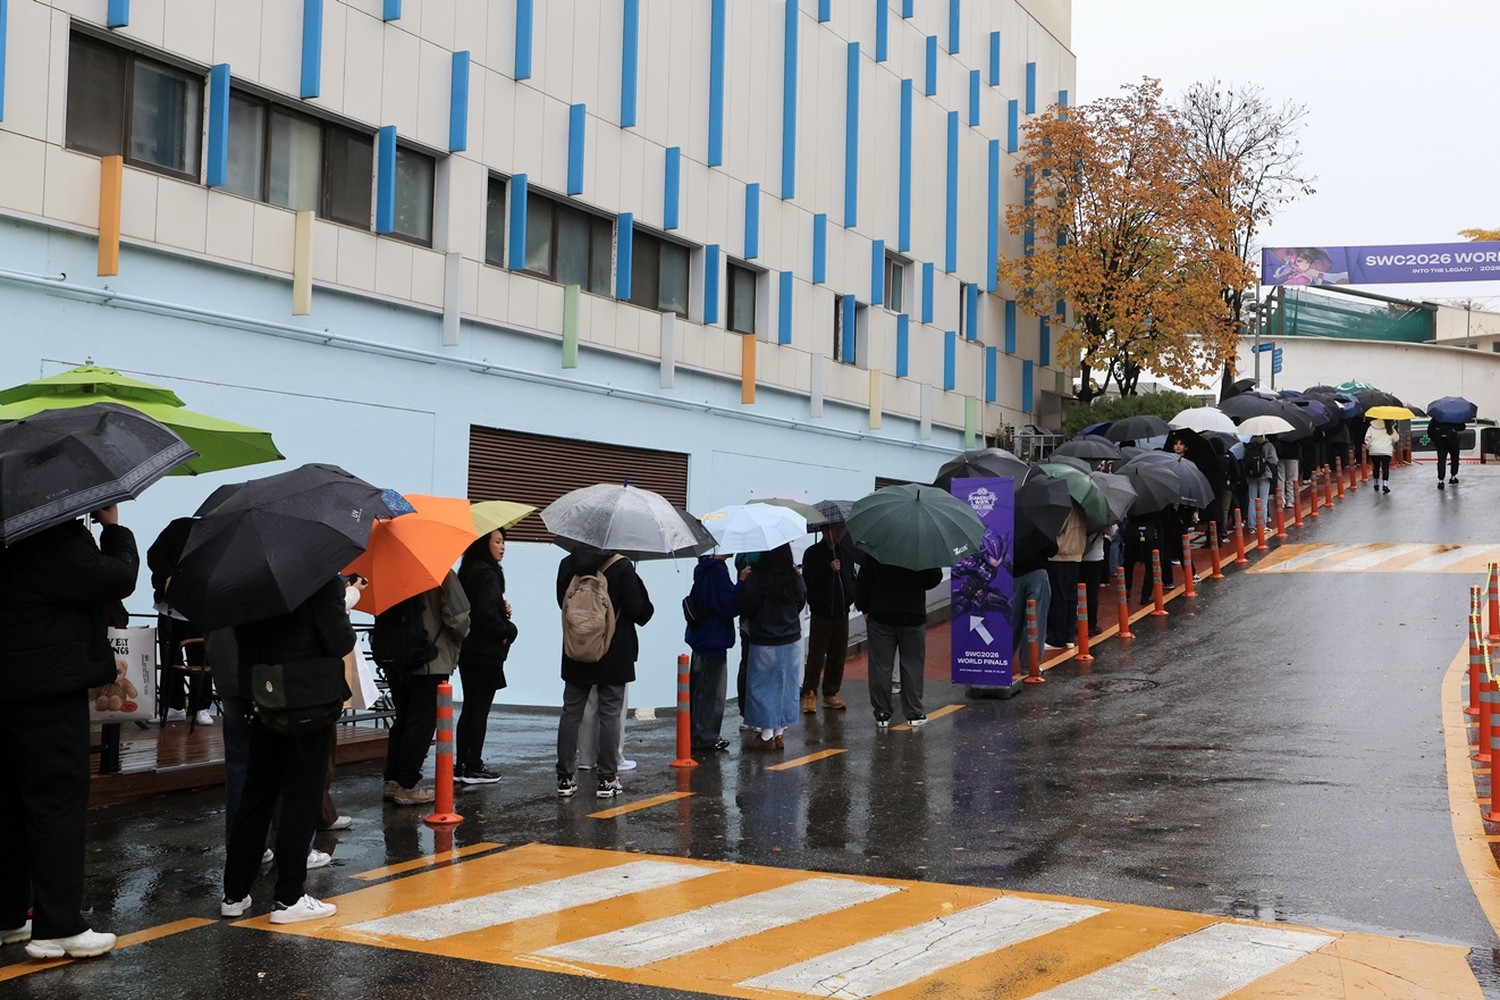
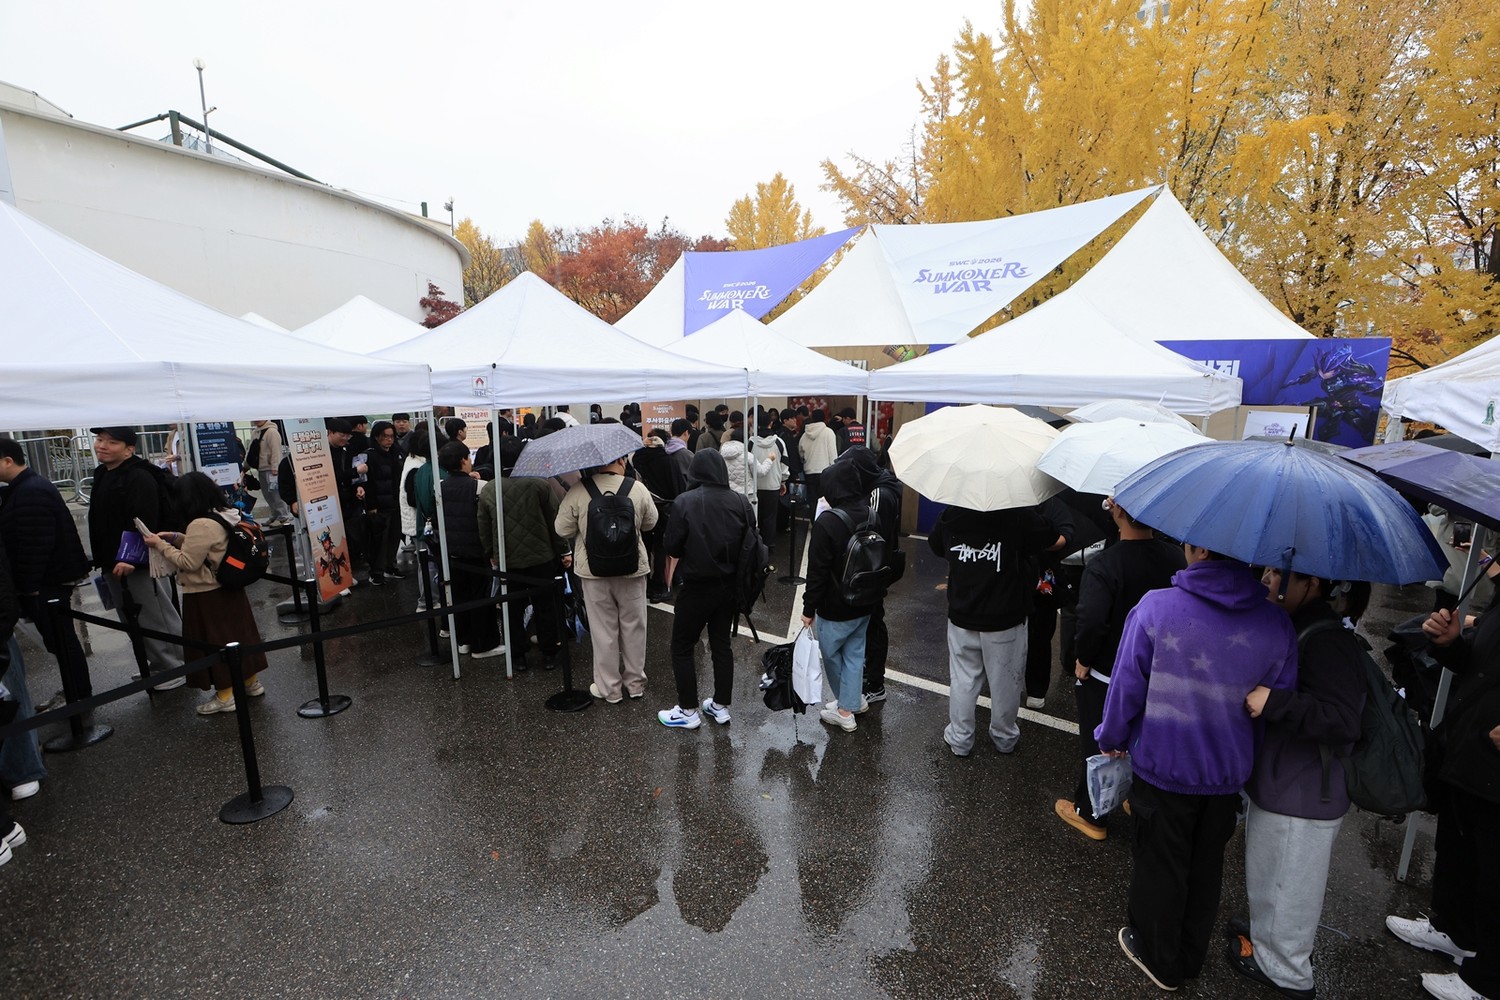
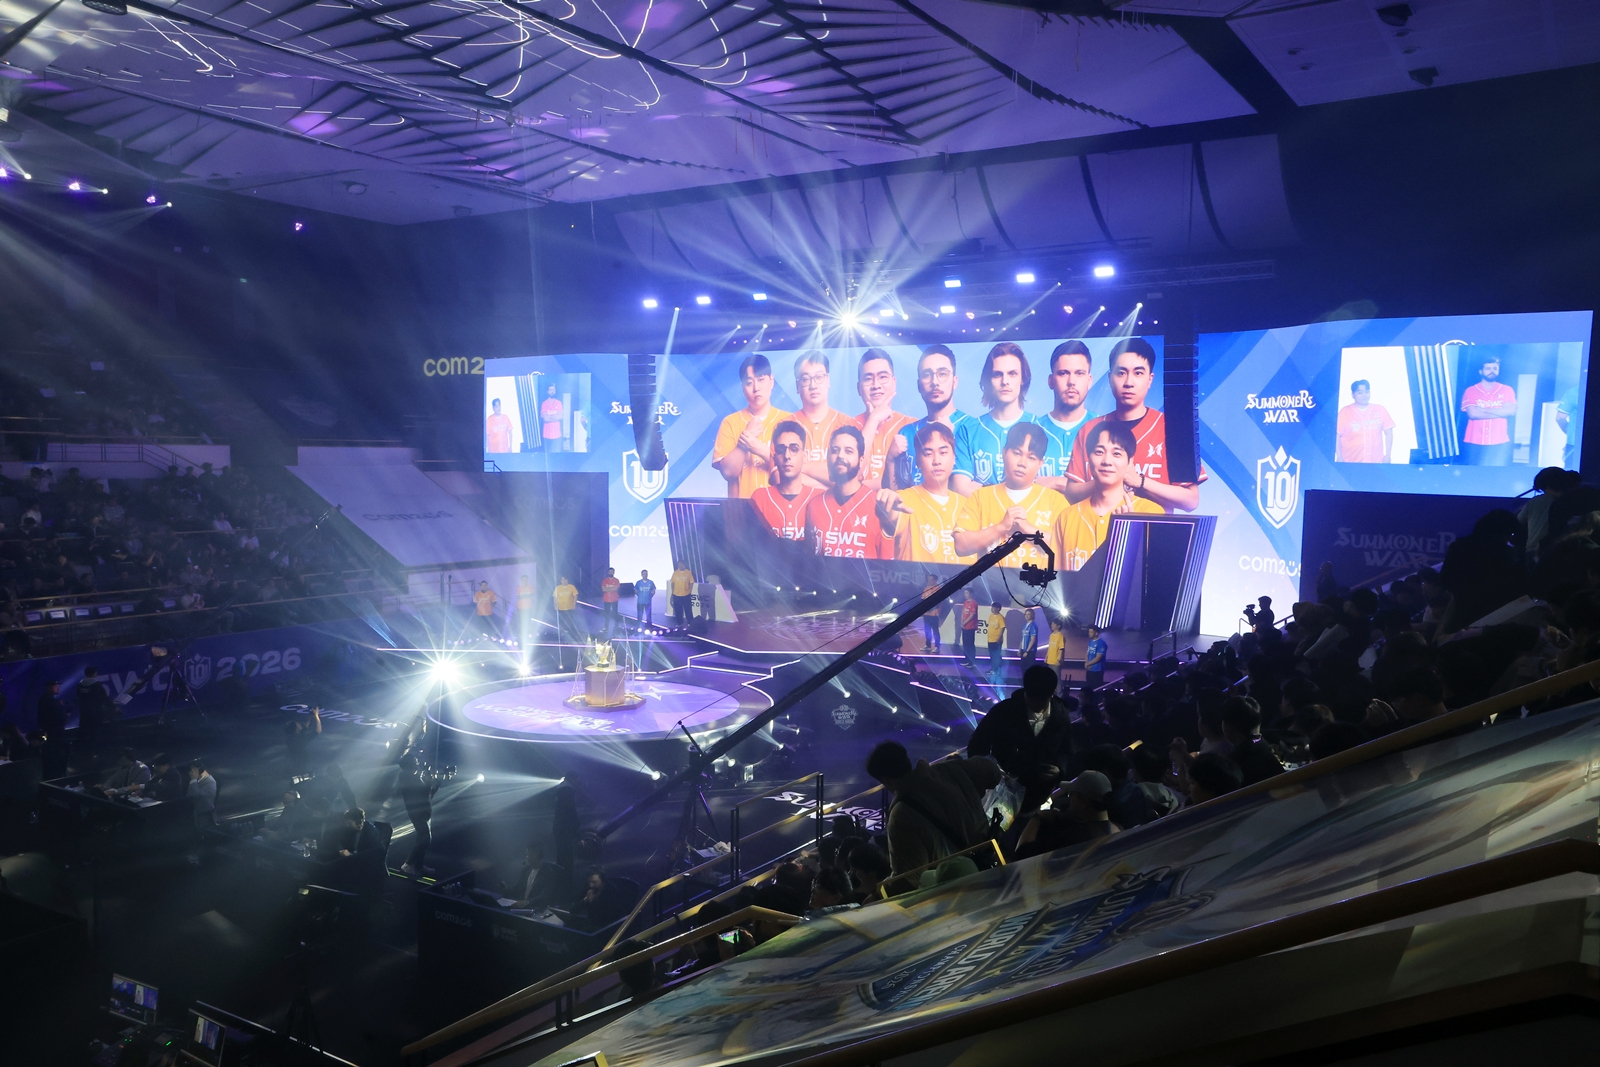
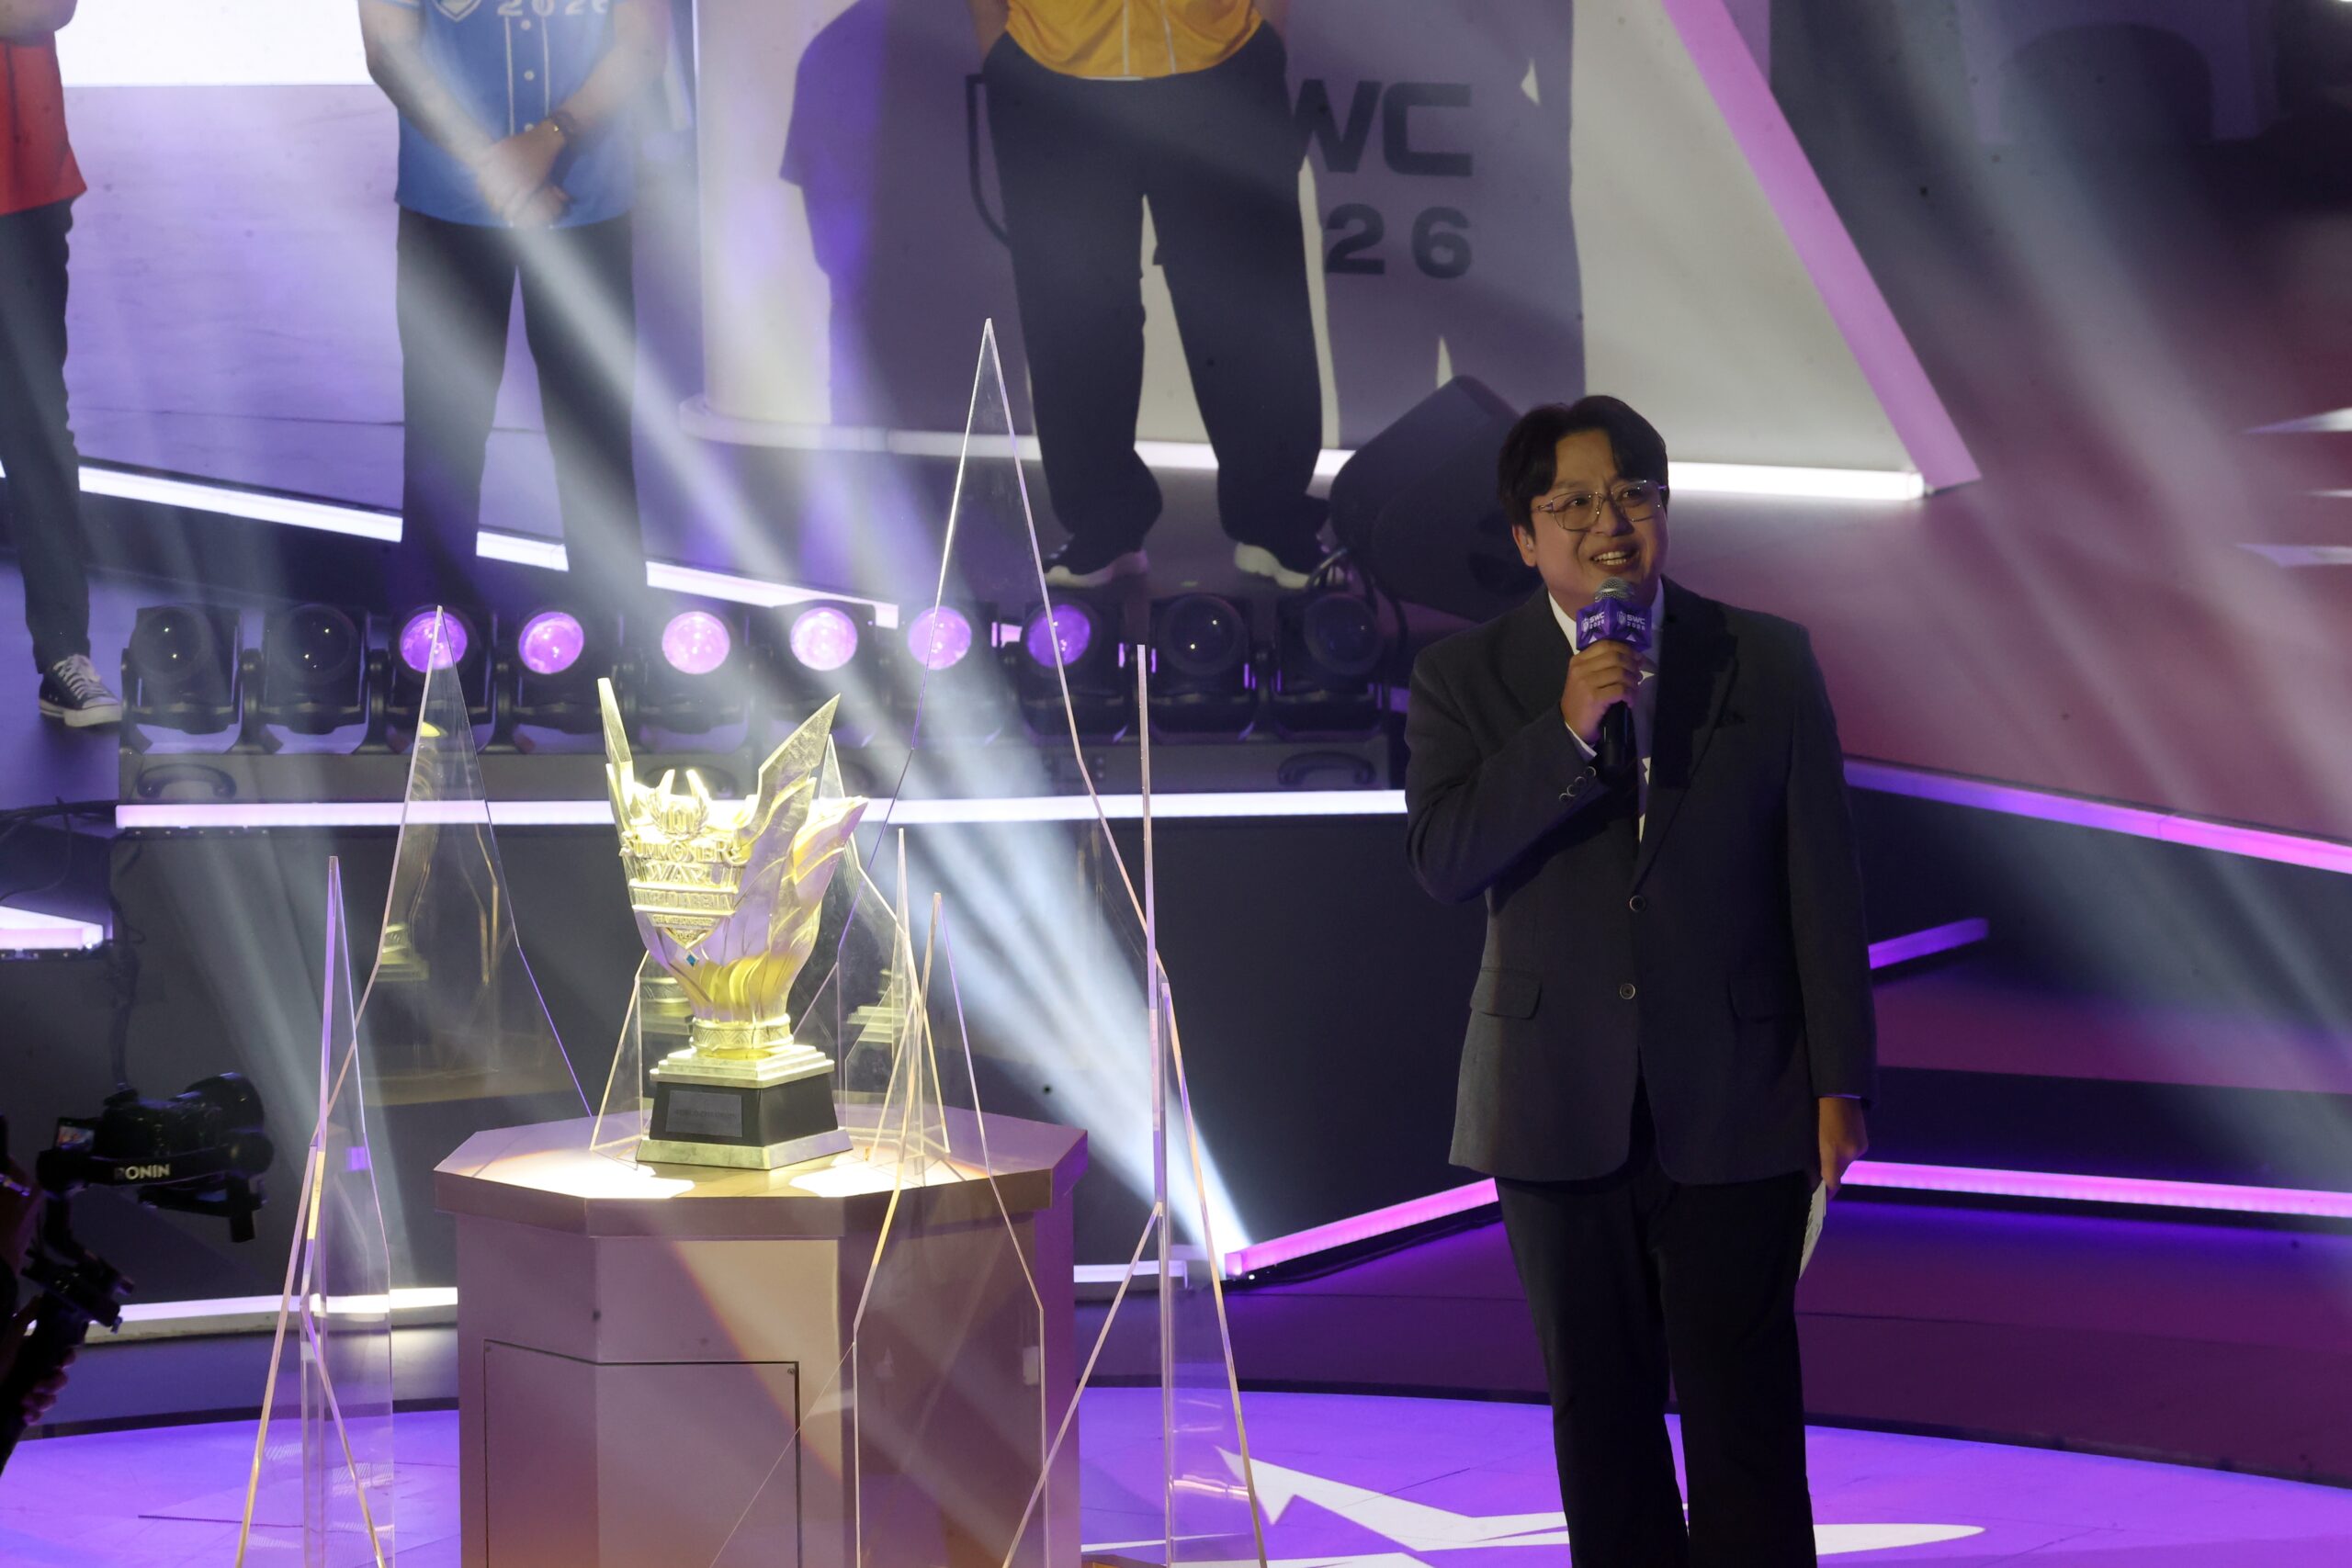
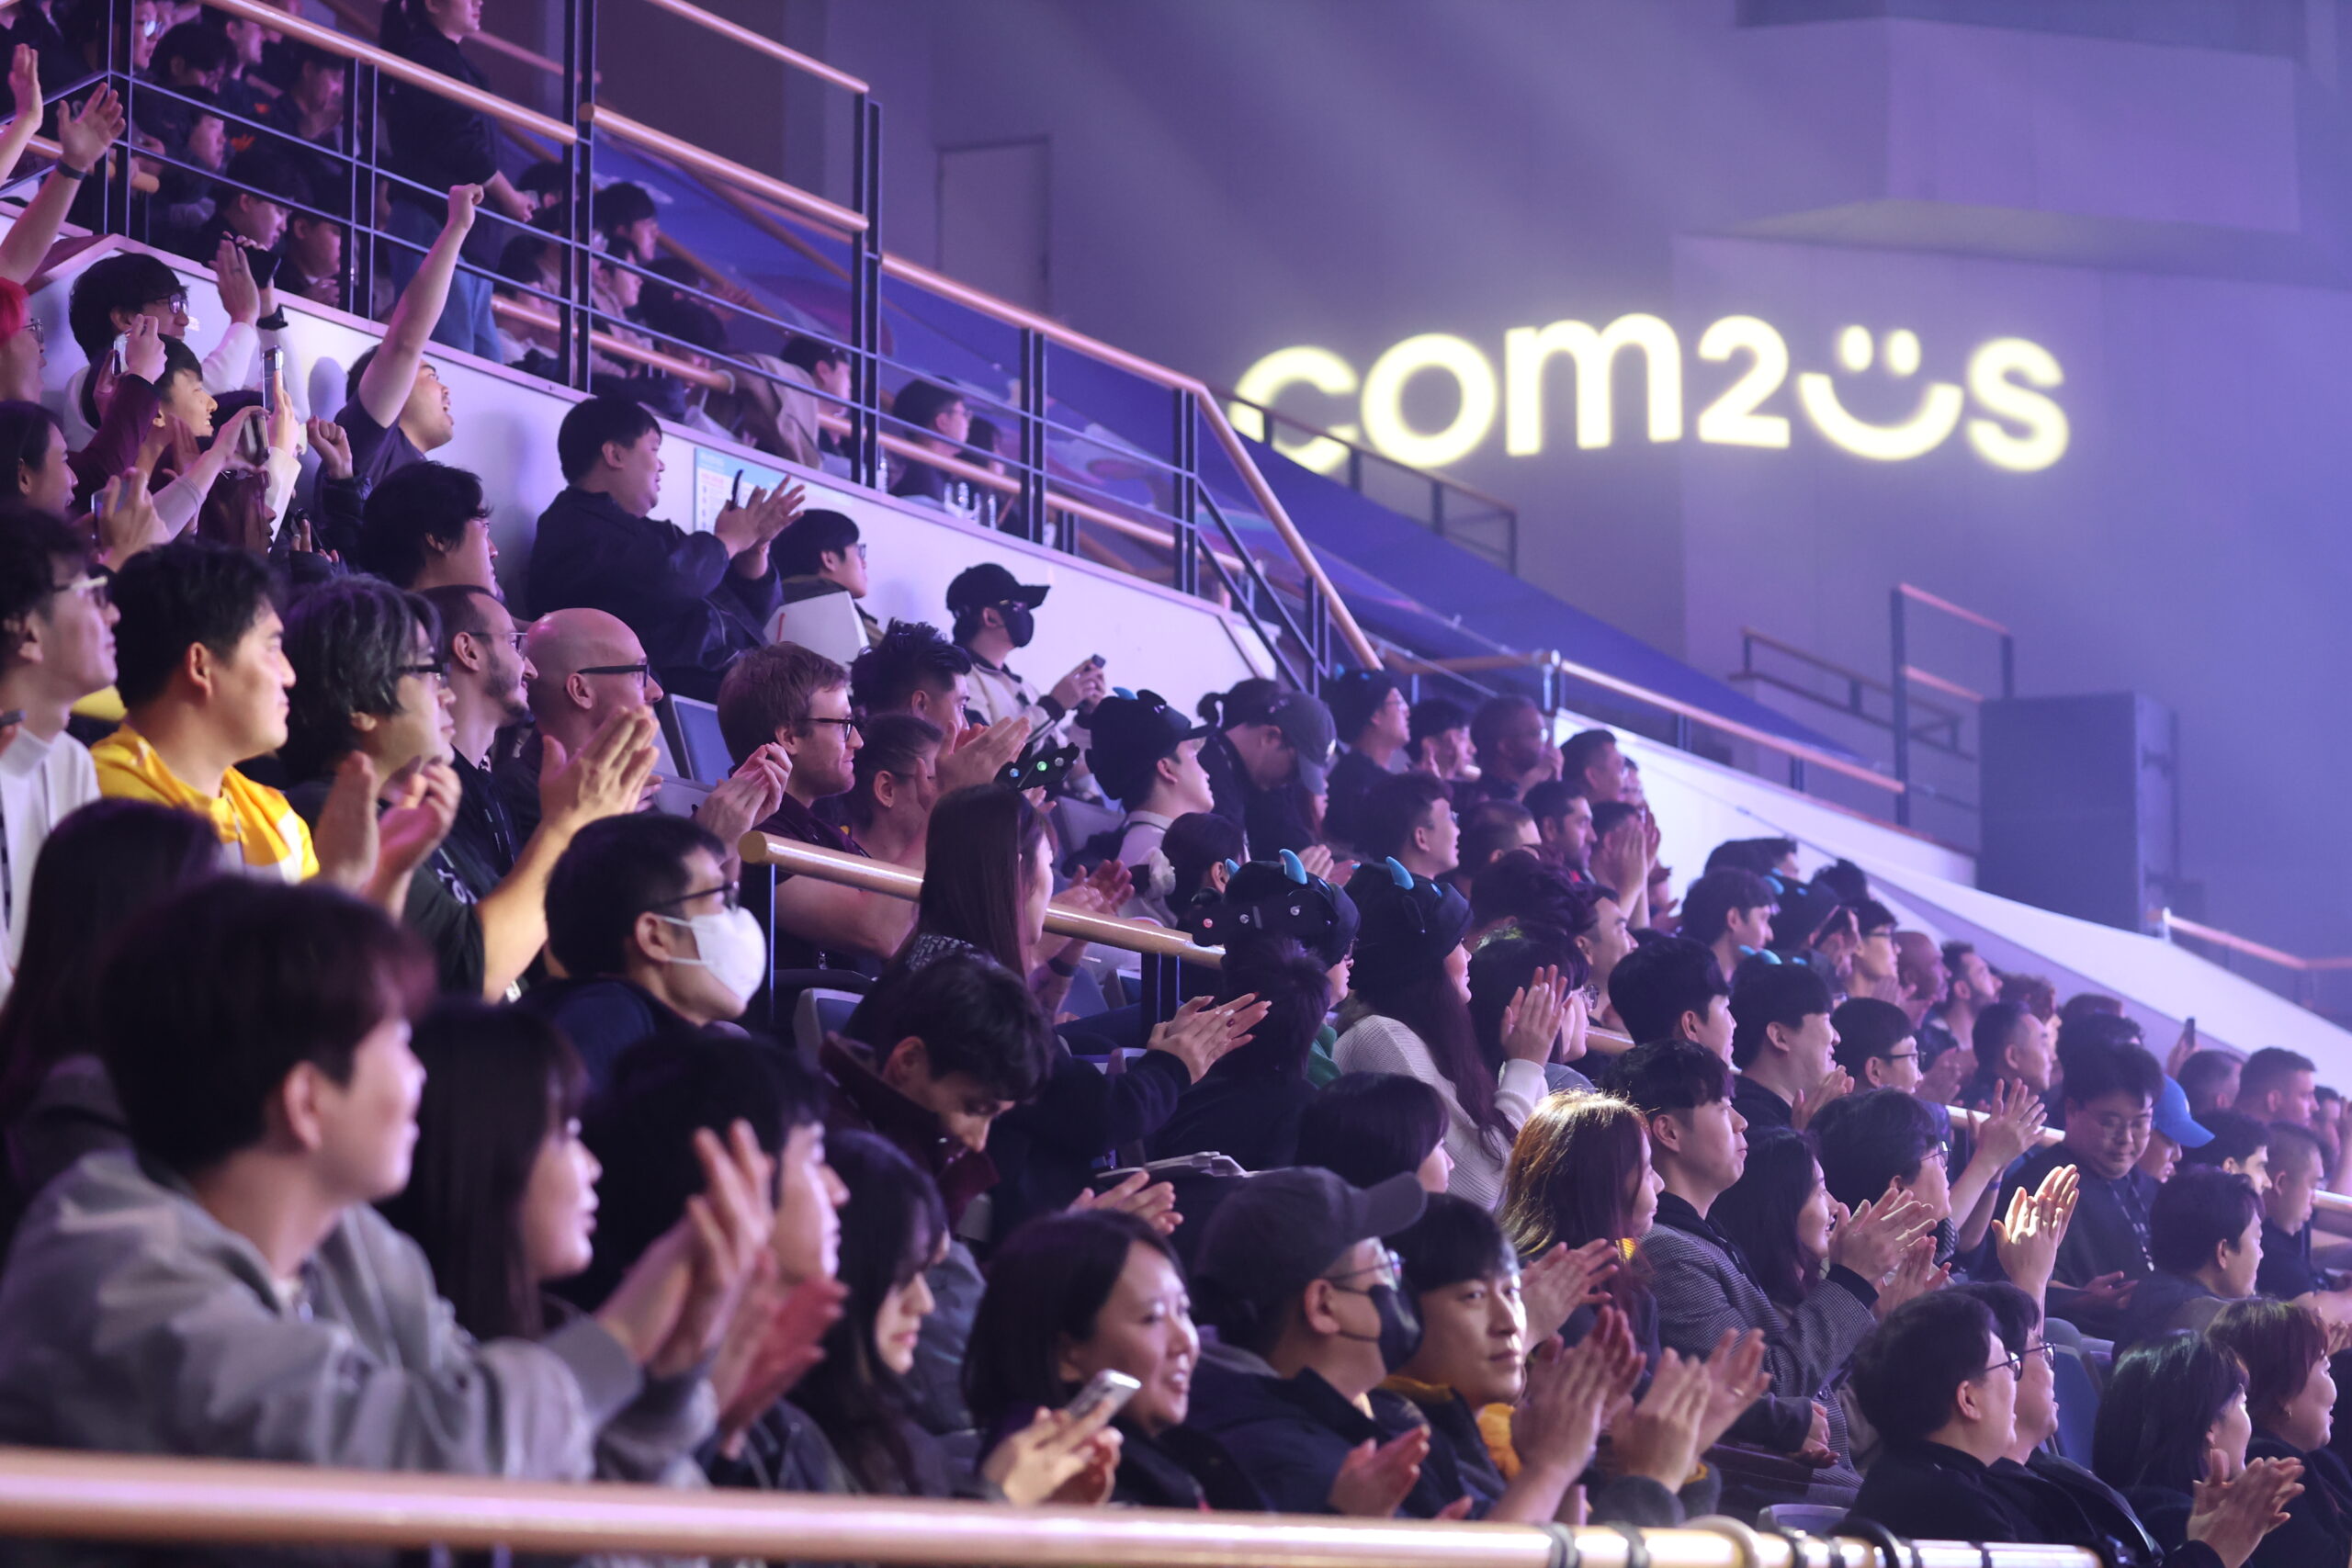
지난 11월 14일, 컴투스의 글로벌 e스포츠 대회 ‘서머너즈 워 월드 아레나 챔피언십 2026(이하 SWC2026)’ 월드 파이널이 서울 KBS아레나에서 열렸다. 티켓은 예매를 시작하자마자 전석 매진됐고, 궂은 날씨에도 불구하고 천여 명의 관객이 파이널 무대를 함께했다.
 |  |
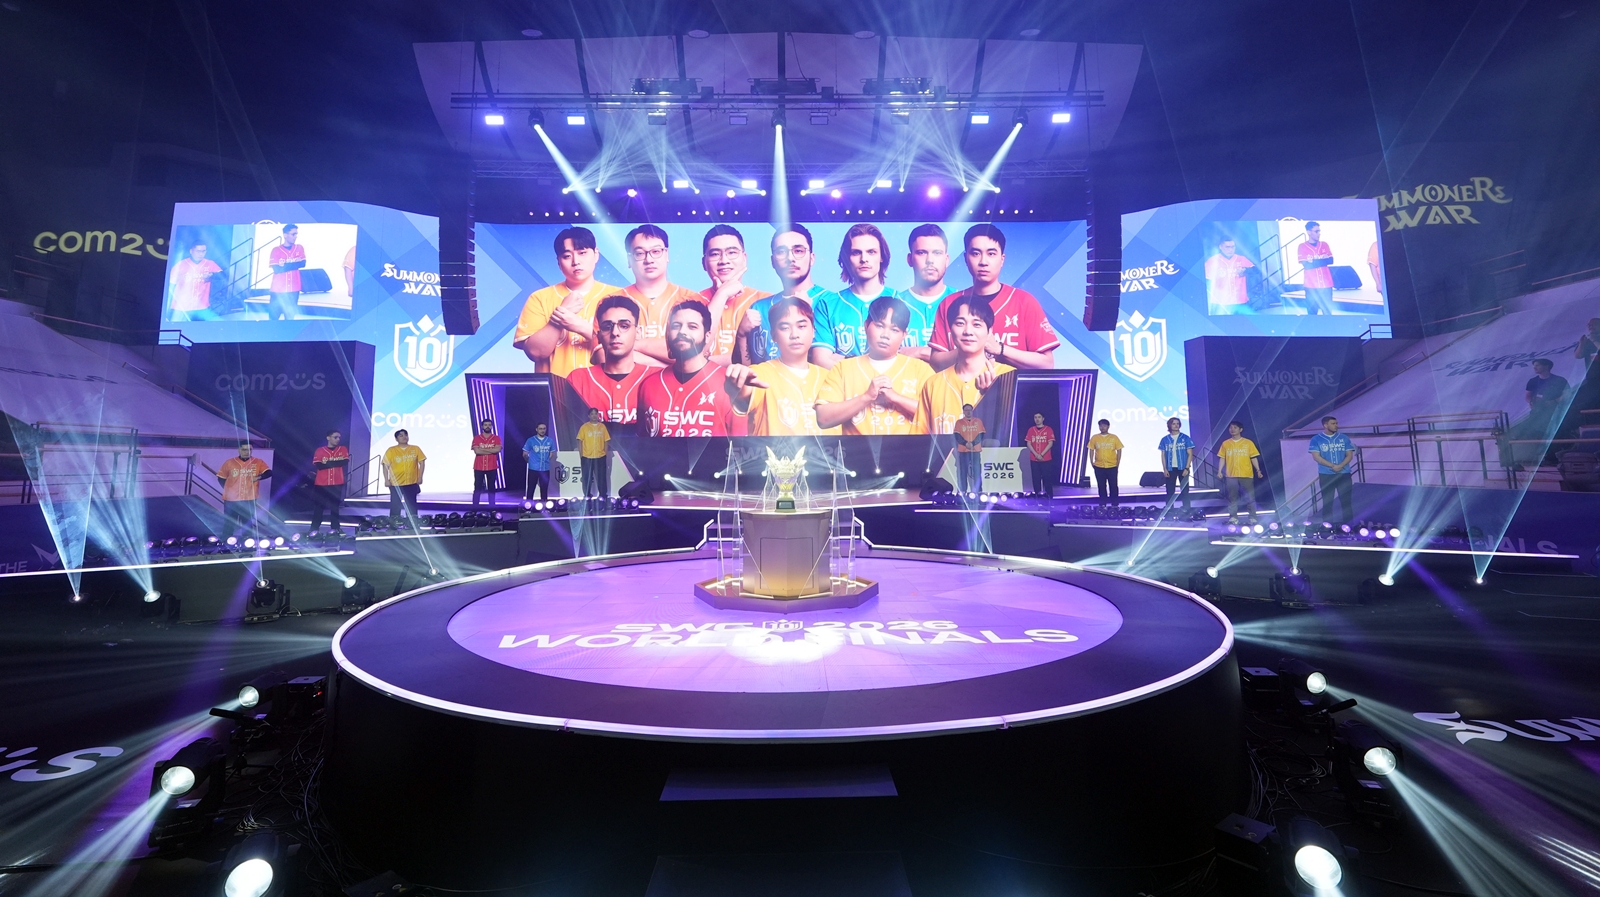
2017년 미국 로스앤젤레스(LA)에서 첫 월드 파이널을 연 SWC는 10회째인 올해 ‘서머너즈 워’가 탄생한 대한민국 서울에서 마지막 무대를 열었다. 4개월간 지역 컵을 거쳐 올라온 12명의 선수가 열 번째 월드 챔피언 자리를 두고 맞붙었다.
SWC는 어떤 대회인가: 10년간 이어진 ‘서머너즈 워’ 세계 대회
SWC는 ‘서머너즈 워: 천공의 아레나(이하 서머너즈 워)’의 세계 최강자를 가리는 글로벌 e스포츠 대회다. 2017년 출범 이후 매년 세계 챔피언을 배출했고, 코로나19 팬데믹 기간에도 온라인으로 대회를 이어갔다.
SWC는 컴투스 송병준 의장의 글로벌 e스포츠 구상에서 출발했다. 송병준 의장은 2017년 ‘서머너즈 워’에 도입된 실시간 대전 콘텐츠 ‘월드 아레나’를 기반으로 유저 간 경쟁을 글로벌 e스포츠로 키우는 전략을 적극 추진했다. 게임 속 대결을 전 세계 팬들이 함께 보고 응원하는 무대로 만들겠다는 계획은 같은 해 SWC 출범으로 이어졌다.
첫 월드 파이널은 LA 마이크로소프트 시어터에서 열렸다. 이후 SWC는 서울, 파리, 방콕, 도쿄 등 세계 주요 도시로 무대를 넓혔다. 유저들은 게임에서 쌓은 실력과 전략을 세계 무대에서 겨뤘고, 팬들은 선수들의 경기에서 새로운 전략과 플레이의 재미를 얻었다. 여러 나라에서 열린 대회는 지역이 다른 팬들이 교류하는 자리가 됐다. SWC는 세계 팬들이 함께 즐기는 e스포츠 축제로 자리 잡으며 ‘서머너즈 워’ 12년 흥행의 원동력이 됐다.
올해 SWC2026은 중국 시안, 캐나다 토론토, 독일 함부르크, 태국 방콕에서 오프라인 지역 본선을 치렀다. 각 지역 컵을 통과한 12명의 선수가 서울 월드 파이널에 올랐다.
경기장 밖에서도 이어진 ‘서머너즈 워’ 한 판
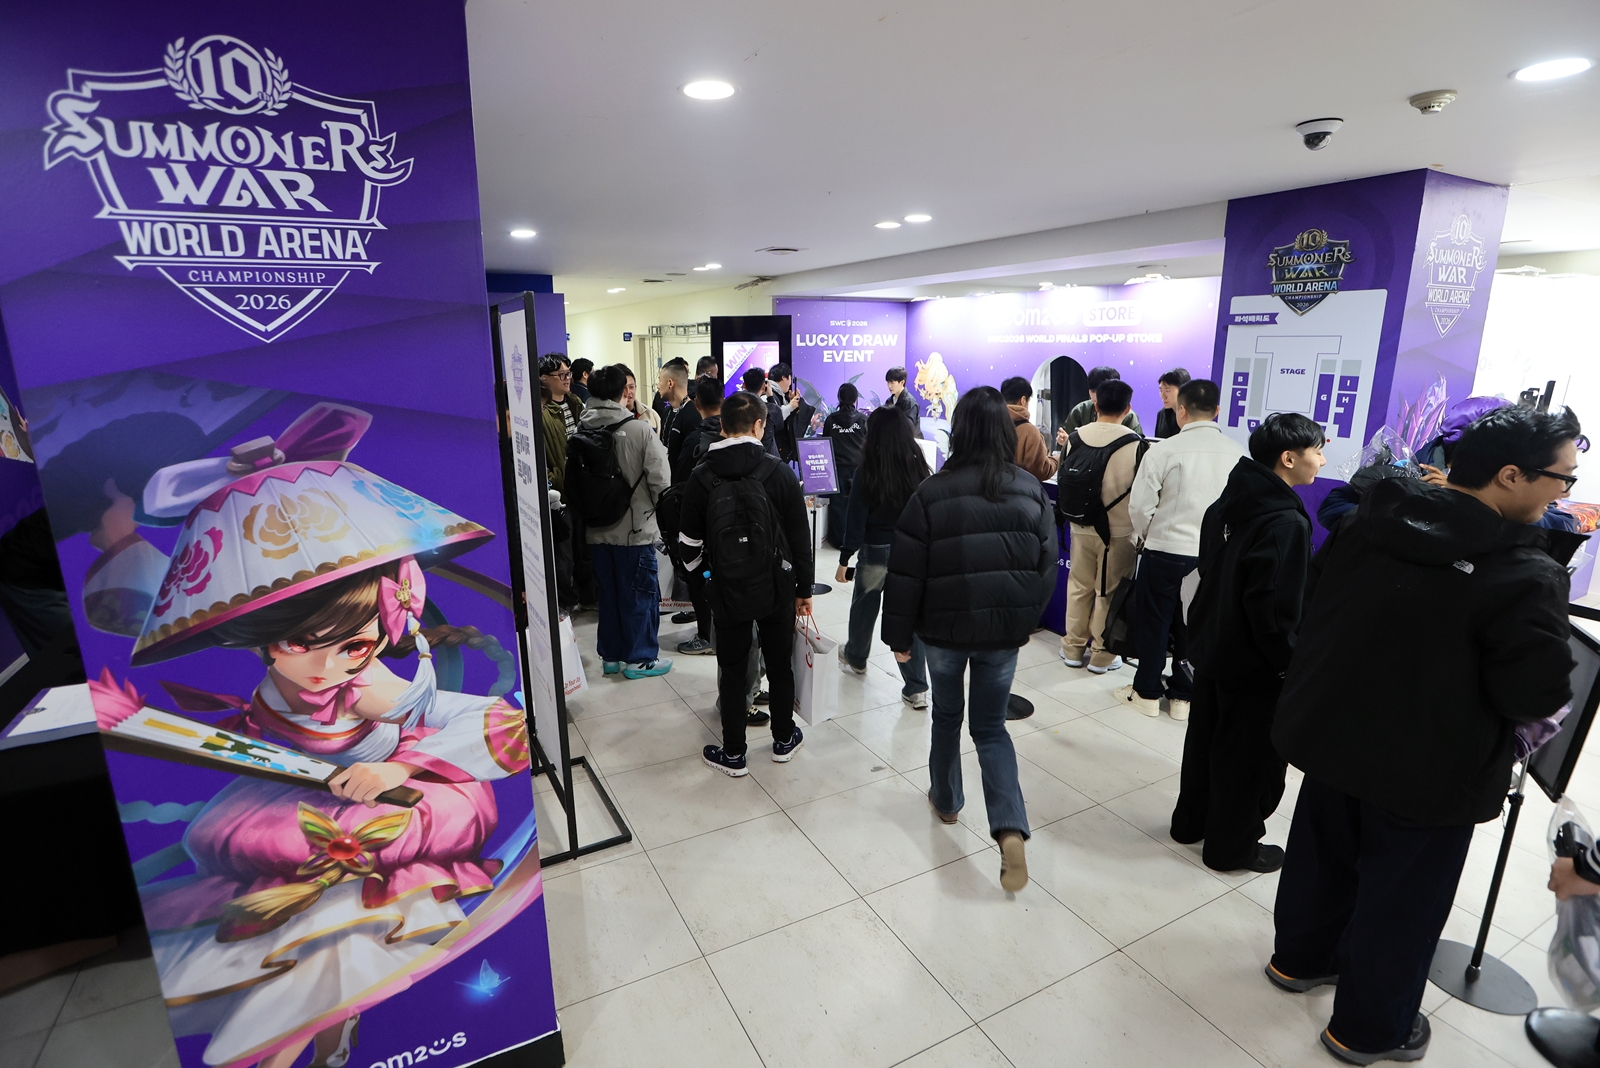
행사장에는 체험형 이벤트존과 공식 팝업 스토어, 응원 공간이 마련됐다. 티켓 소지자는 오전 10시부터, 티켓이 없는 소환사는 낮 12시부터 현장 수용 인원에 따라 이벤트존과 팝업 스토어를 이용할 수 있었다.
실외 이벤트존에는 ‘서머너즈 워’ 몬스터 이름을 딴 미션 네 가지가 준비됐다. ‘토템술사의 토템 쌓기’는 제한 시간 안에 토템을 쌓는 미션이고, ‘해왕의 파도 휩쓸기’는 빠르게 물병을 세우는 미션이다. ‘주사위술사의 랜덤뽑기’에서는 제라투 피규어와 스페셜 팩 등을 뽑을 수 있었다. ‘브라우니의 다함께 날려날려’는 네 명이 함께 도전하는 협동 미션이었다.
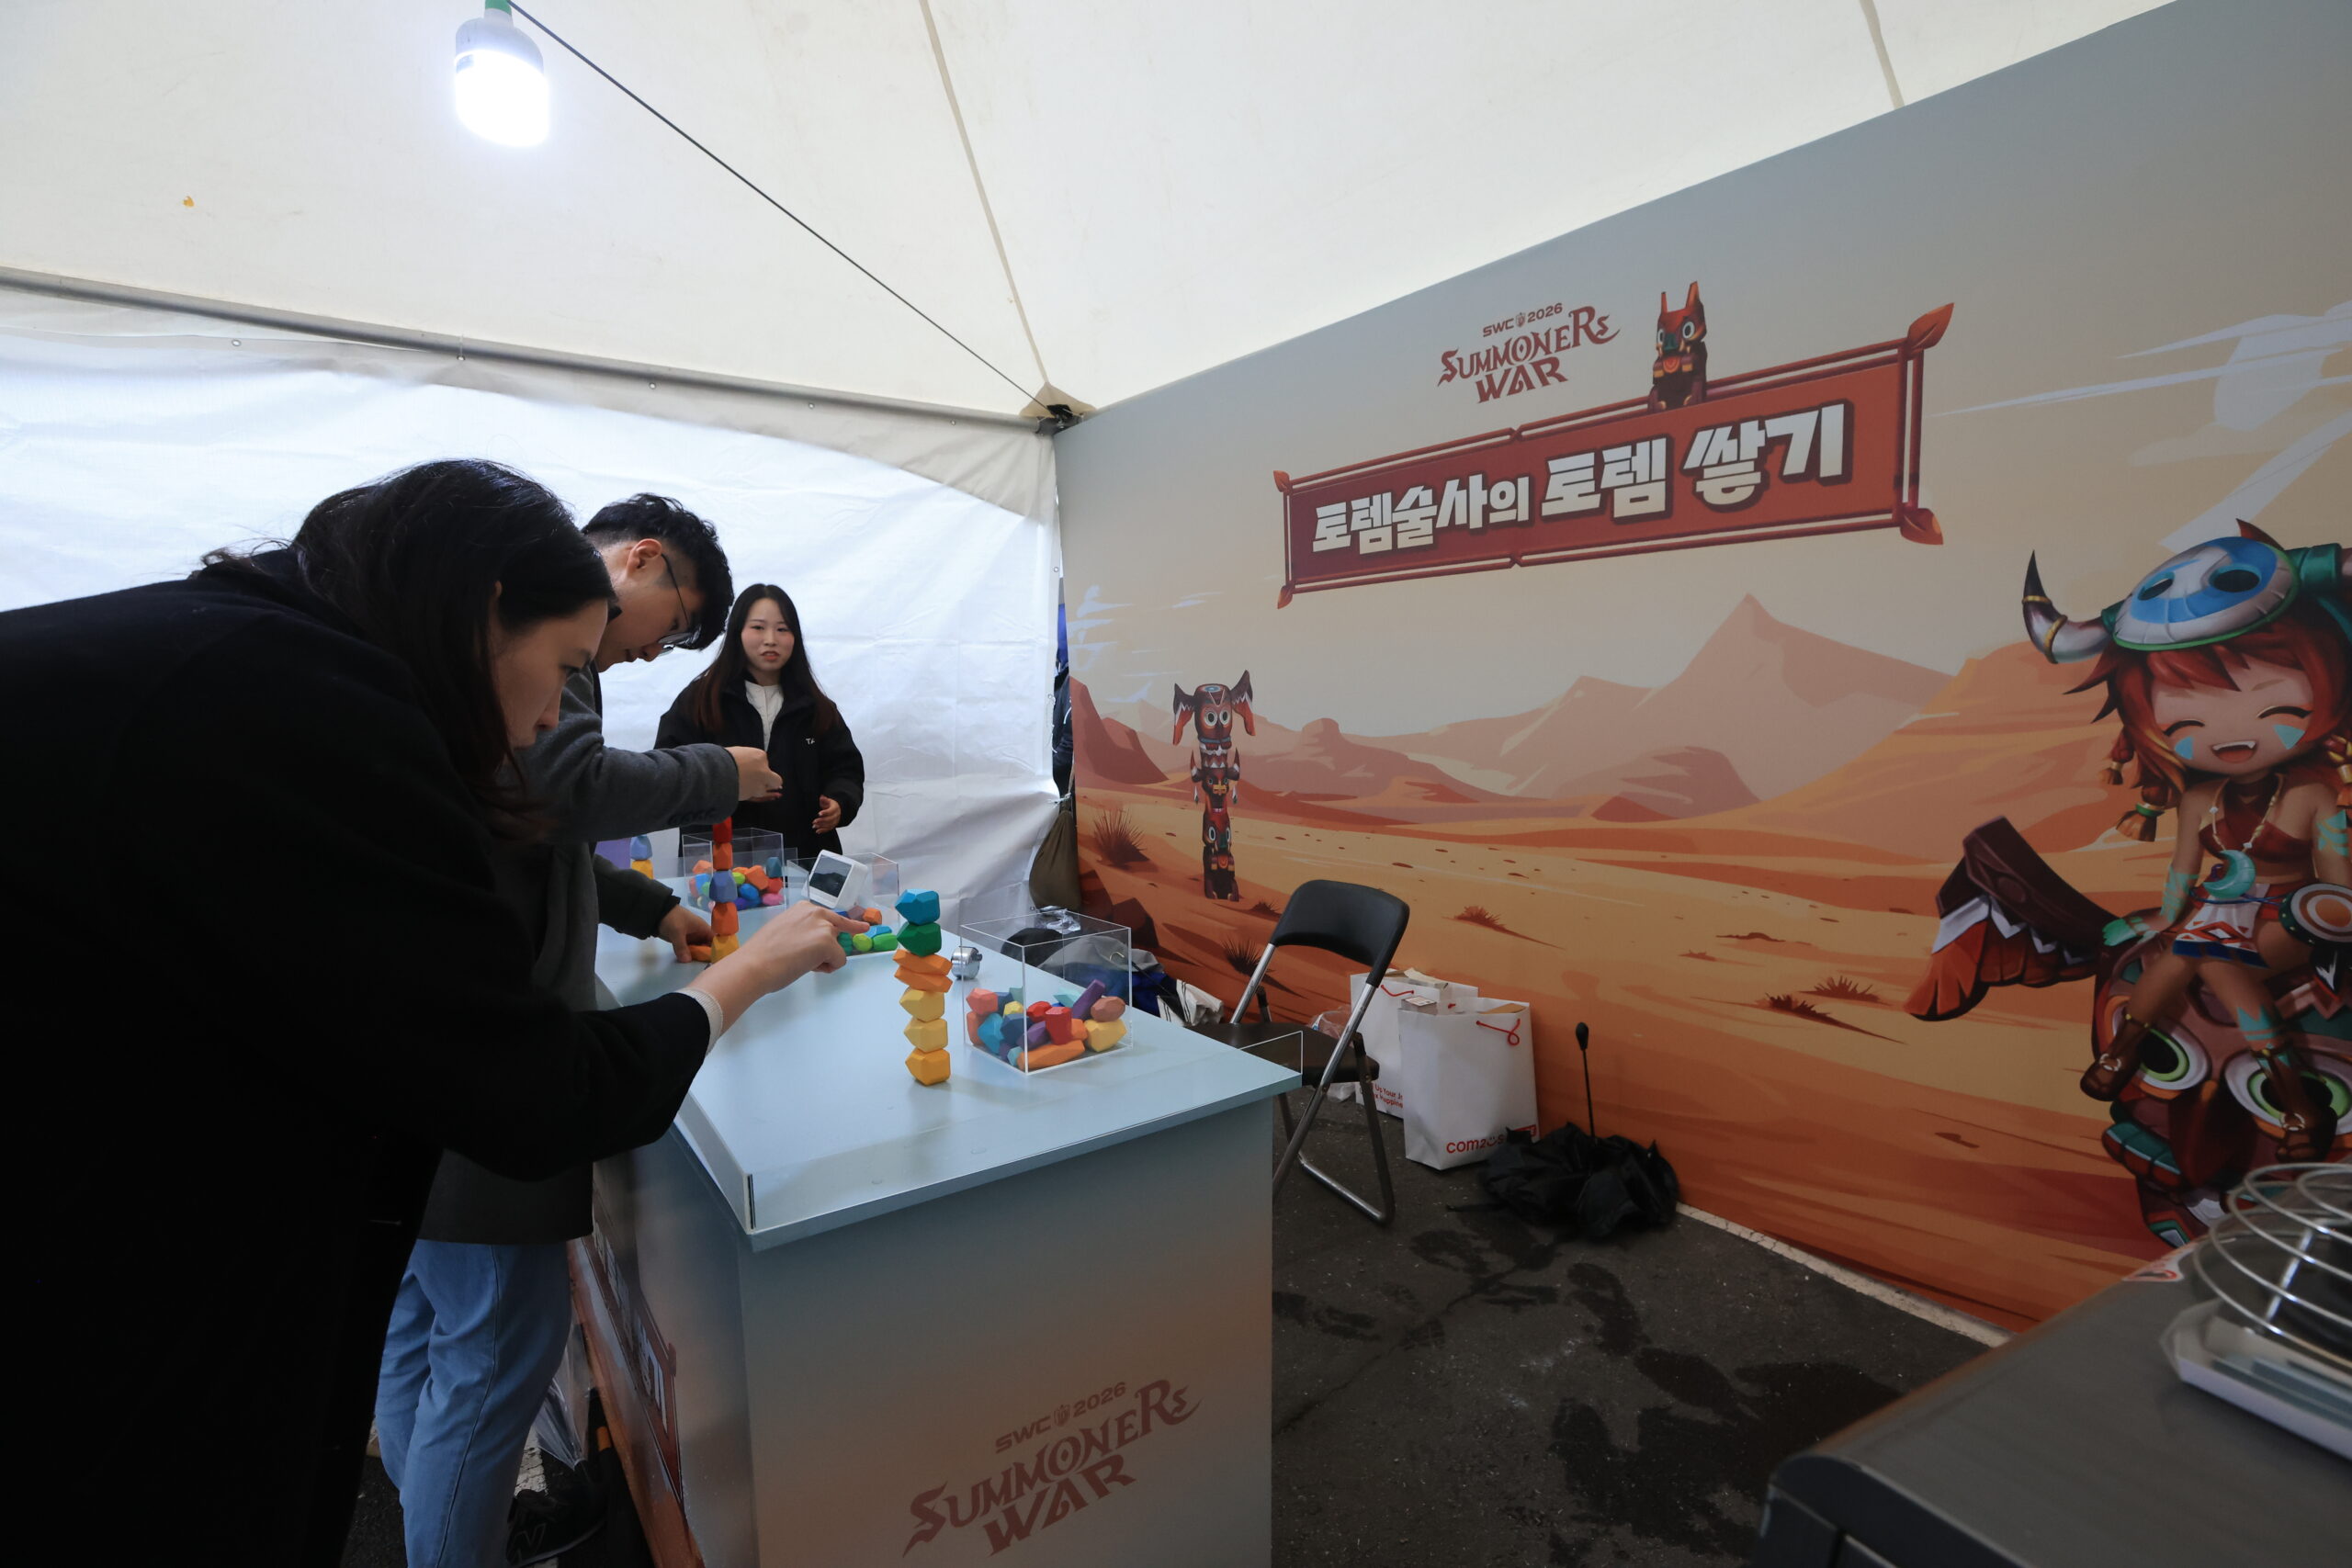 | 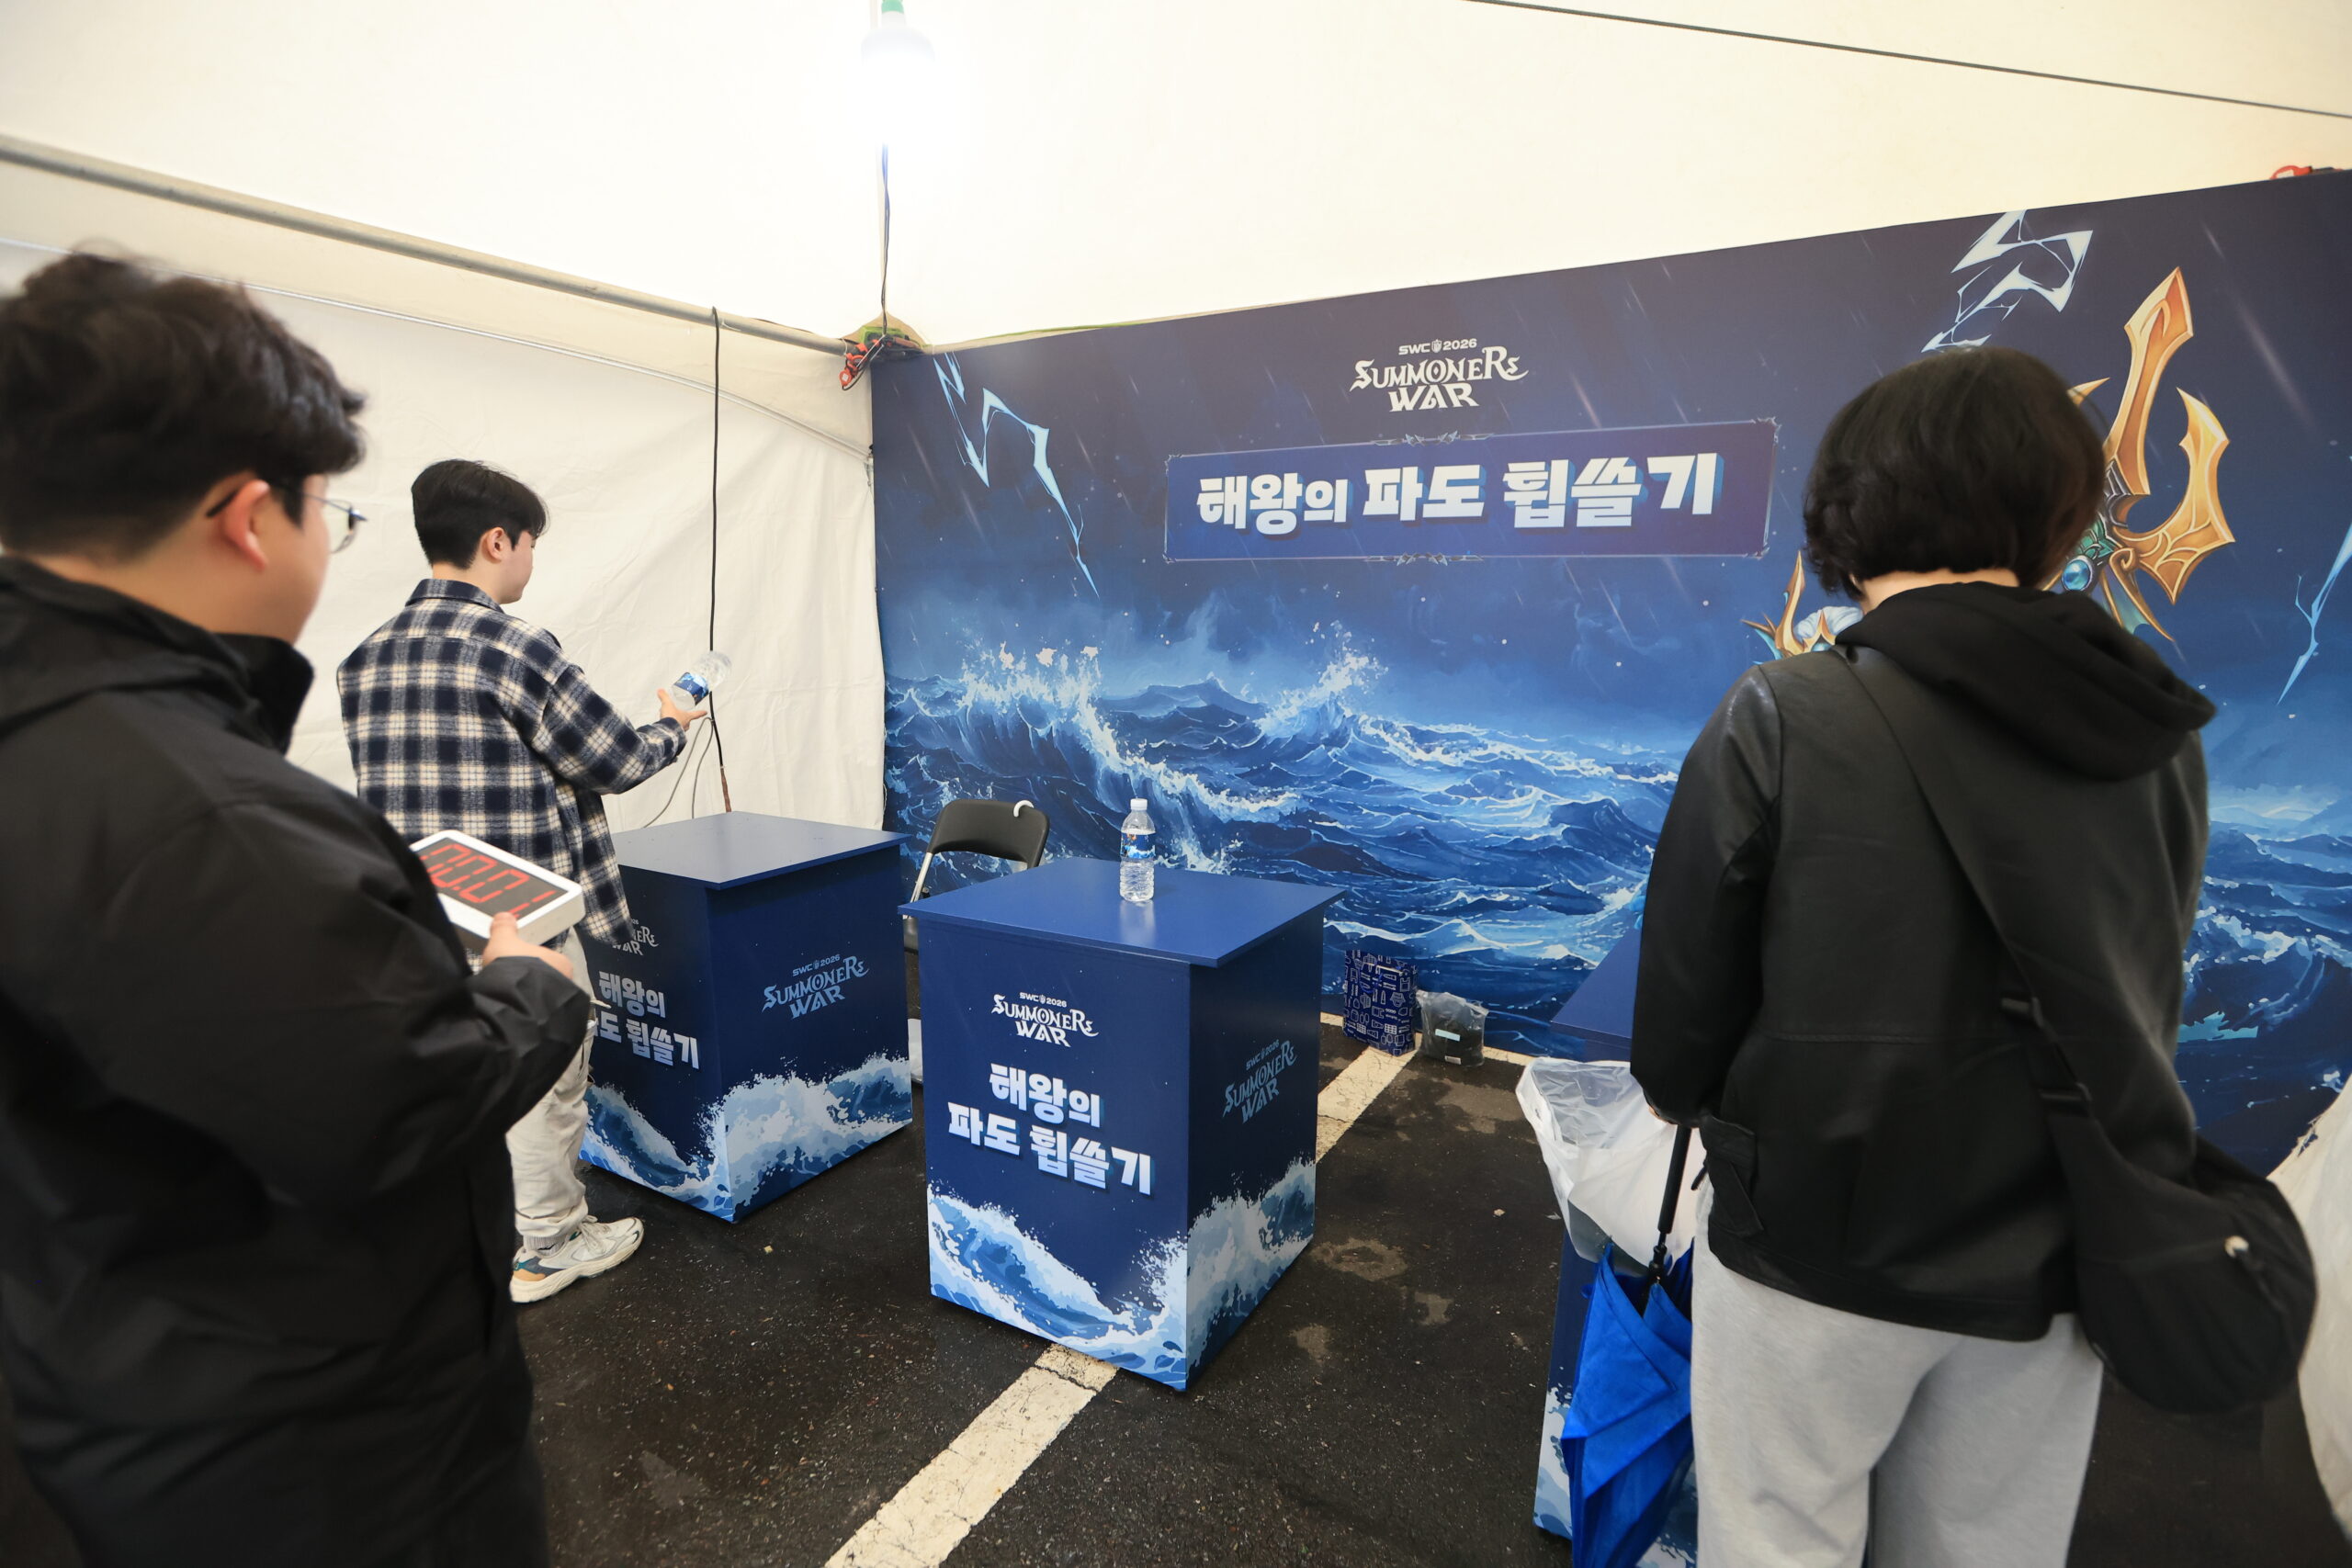 | 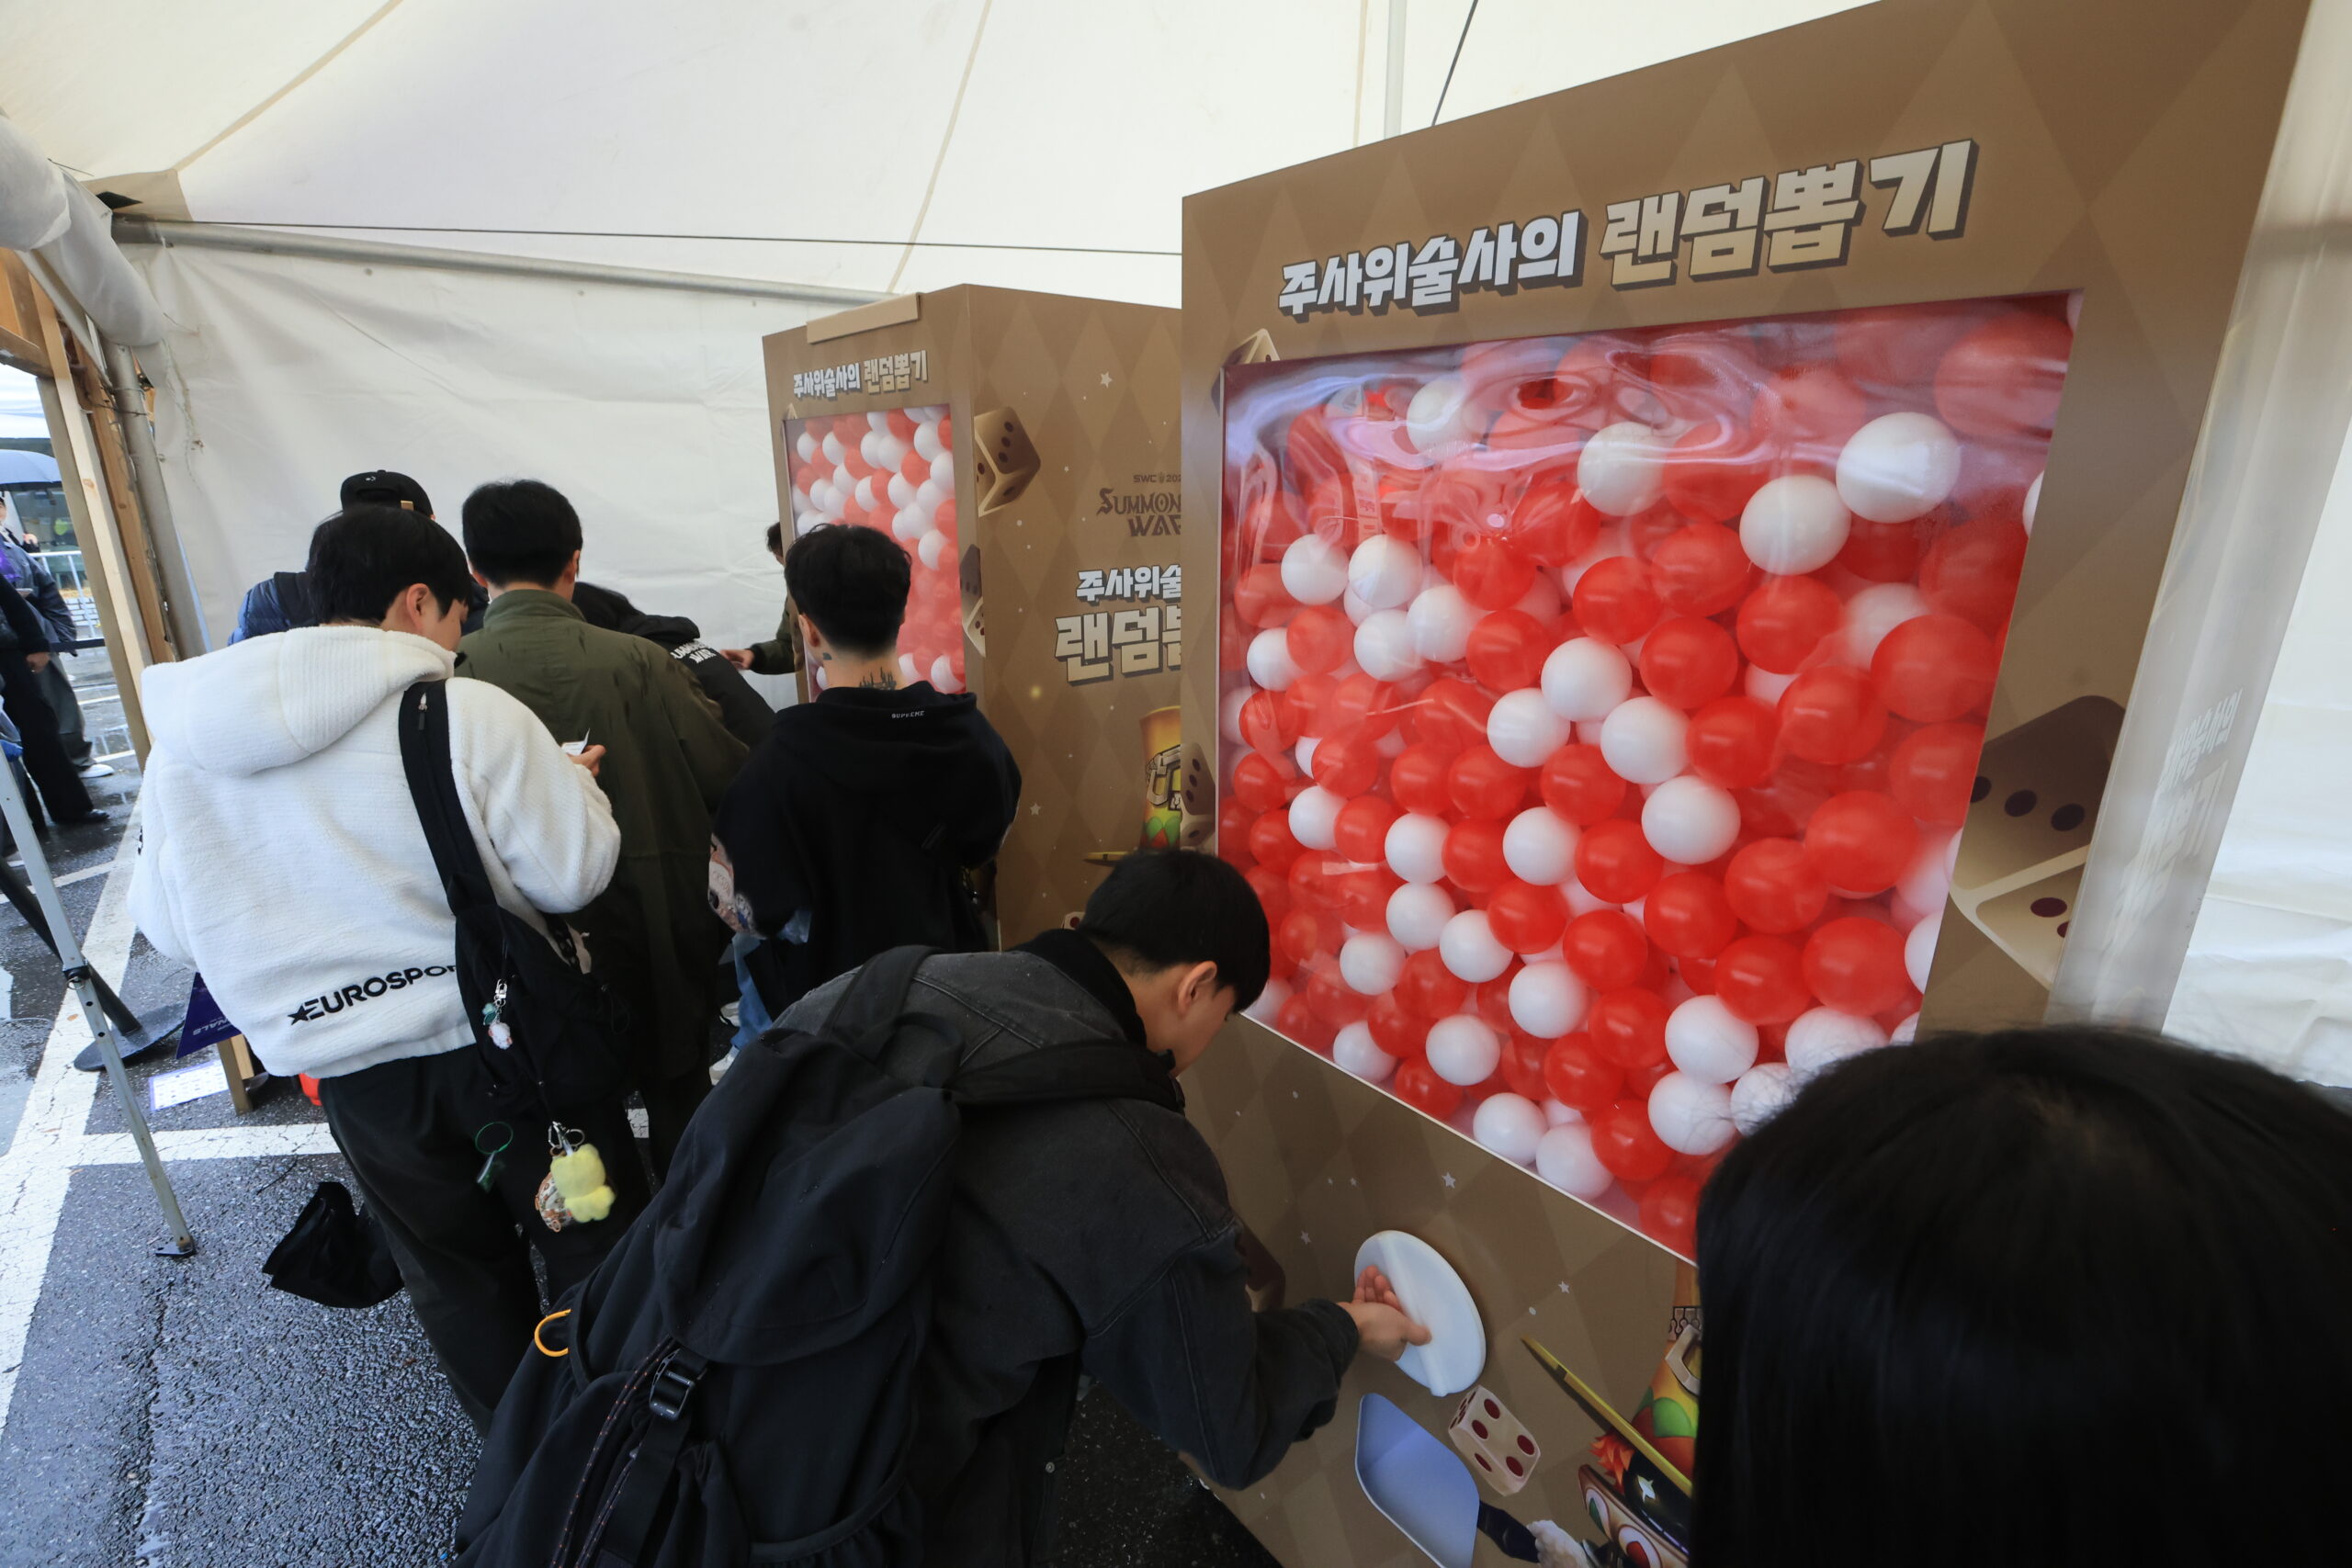 |
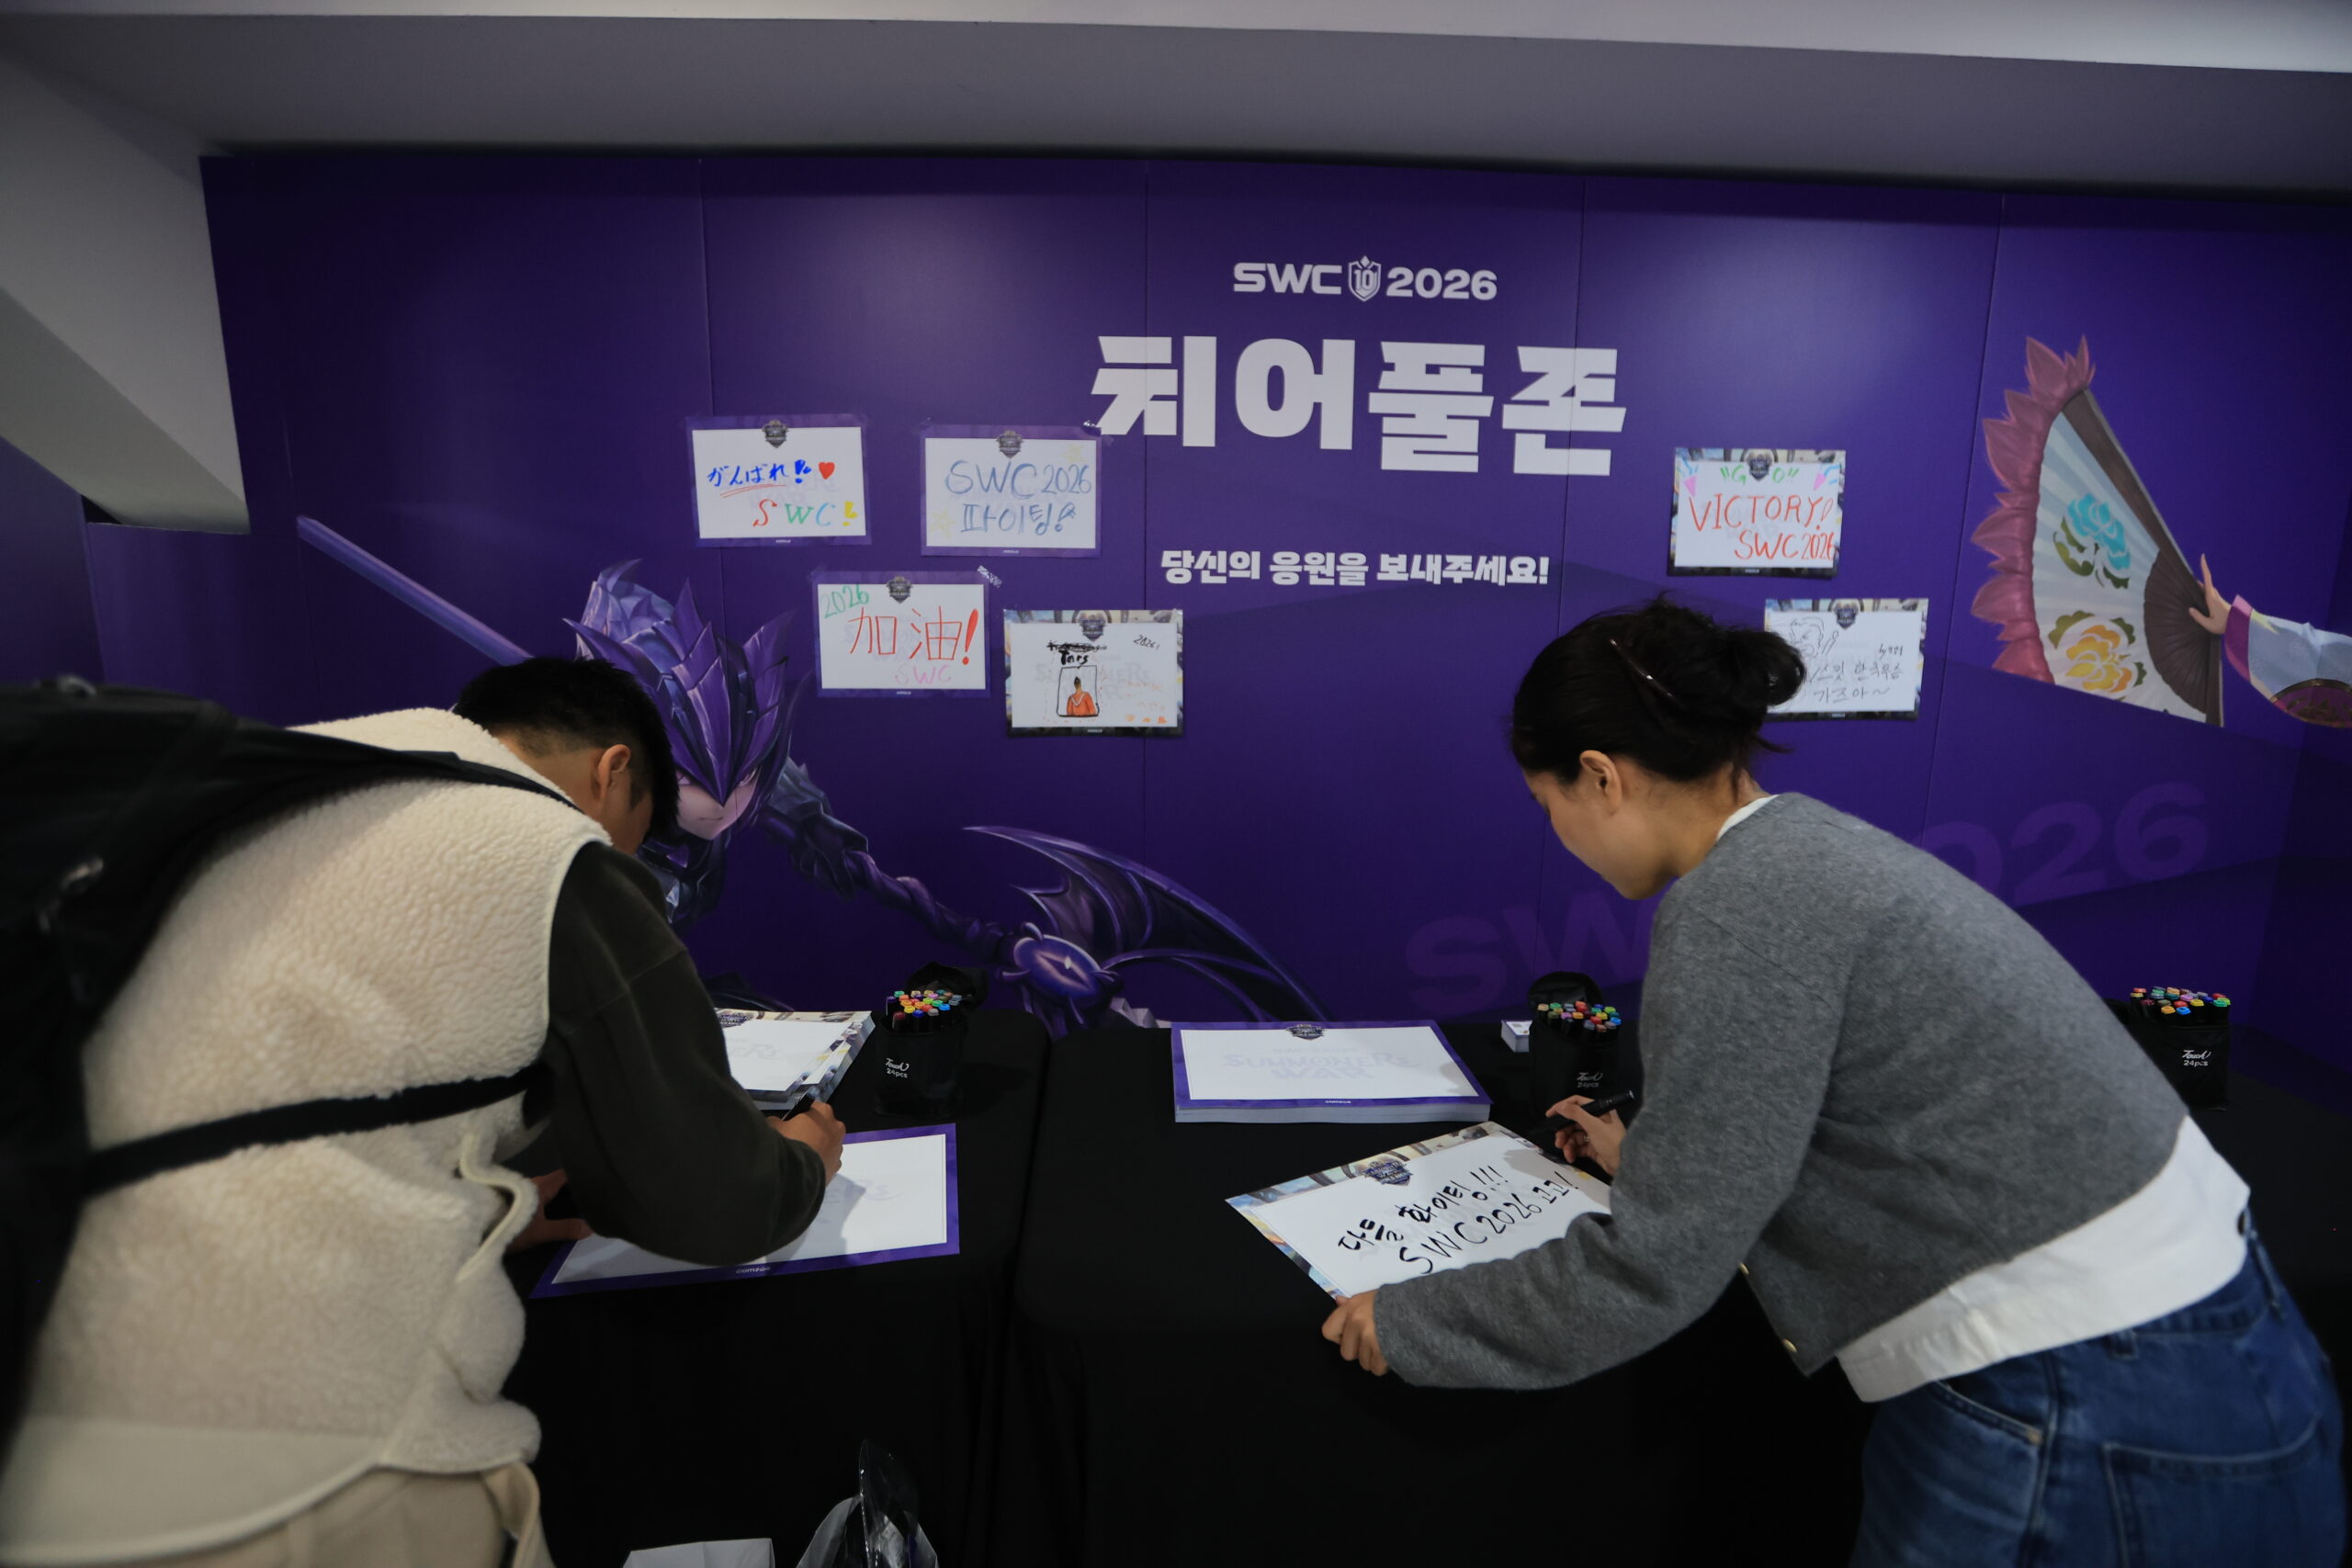
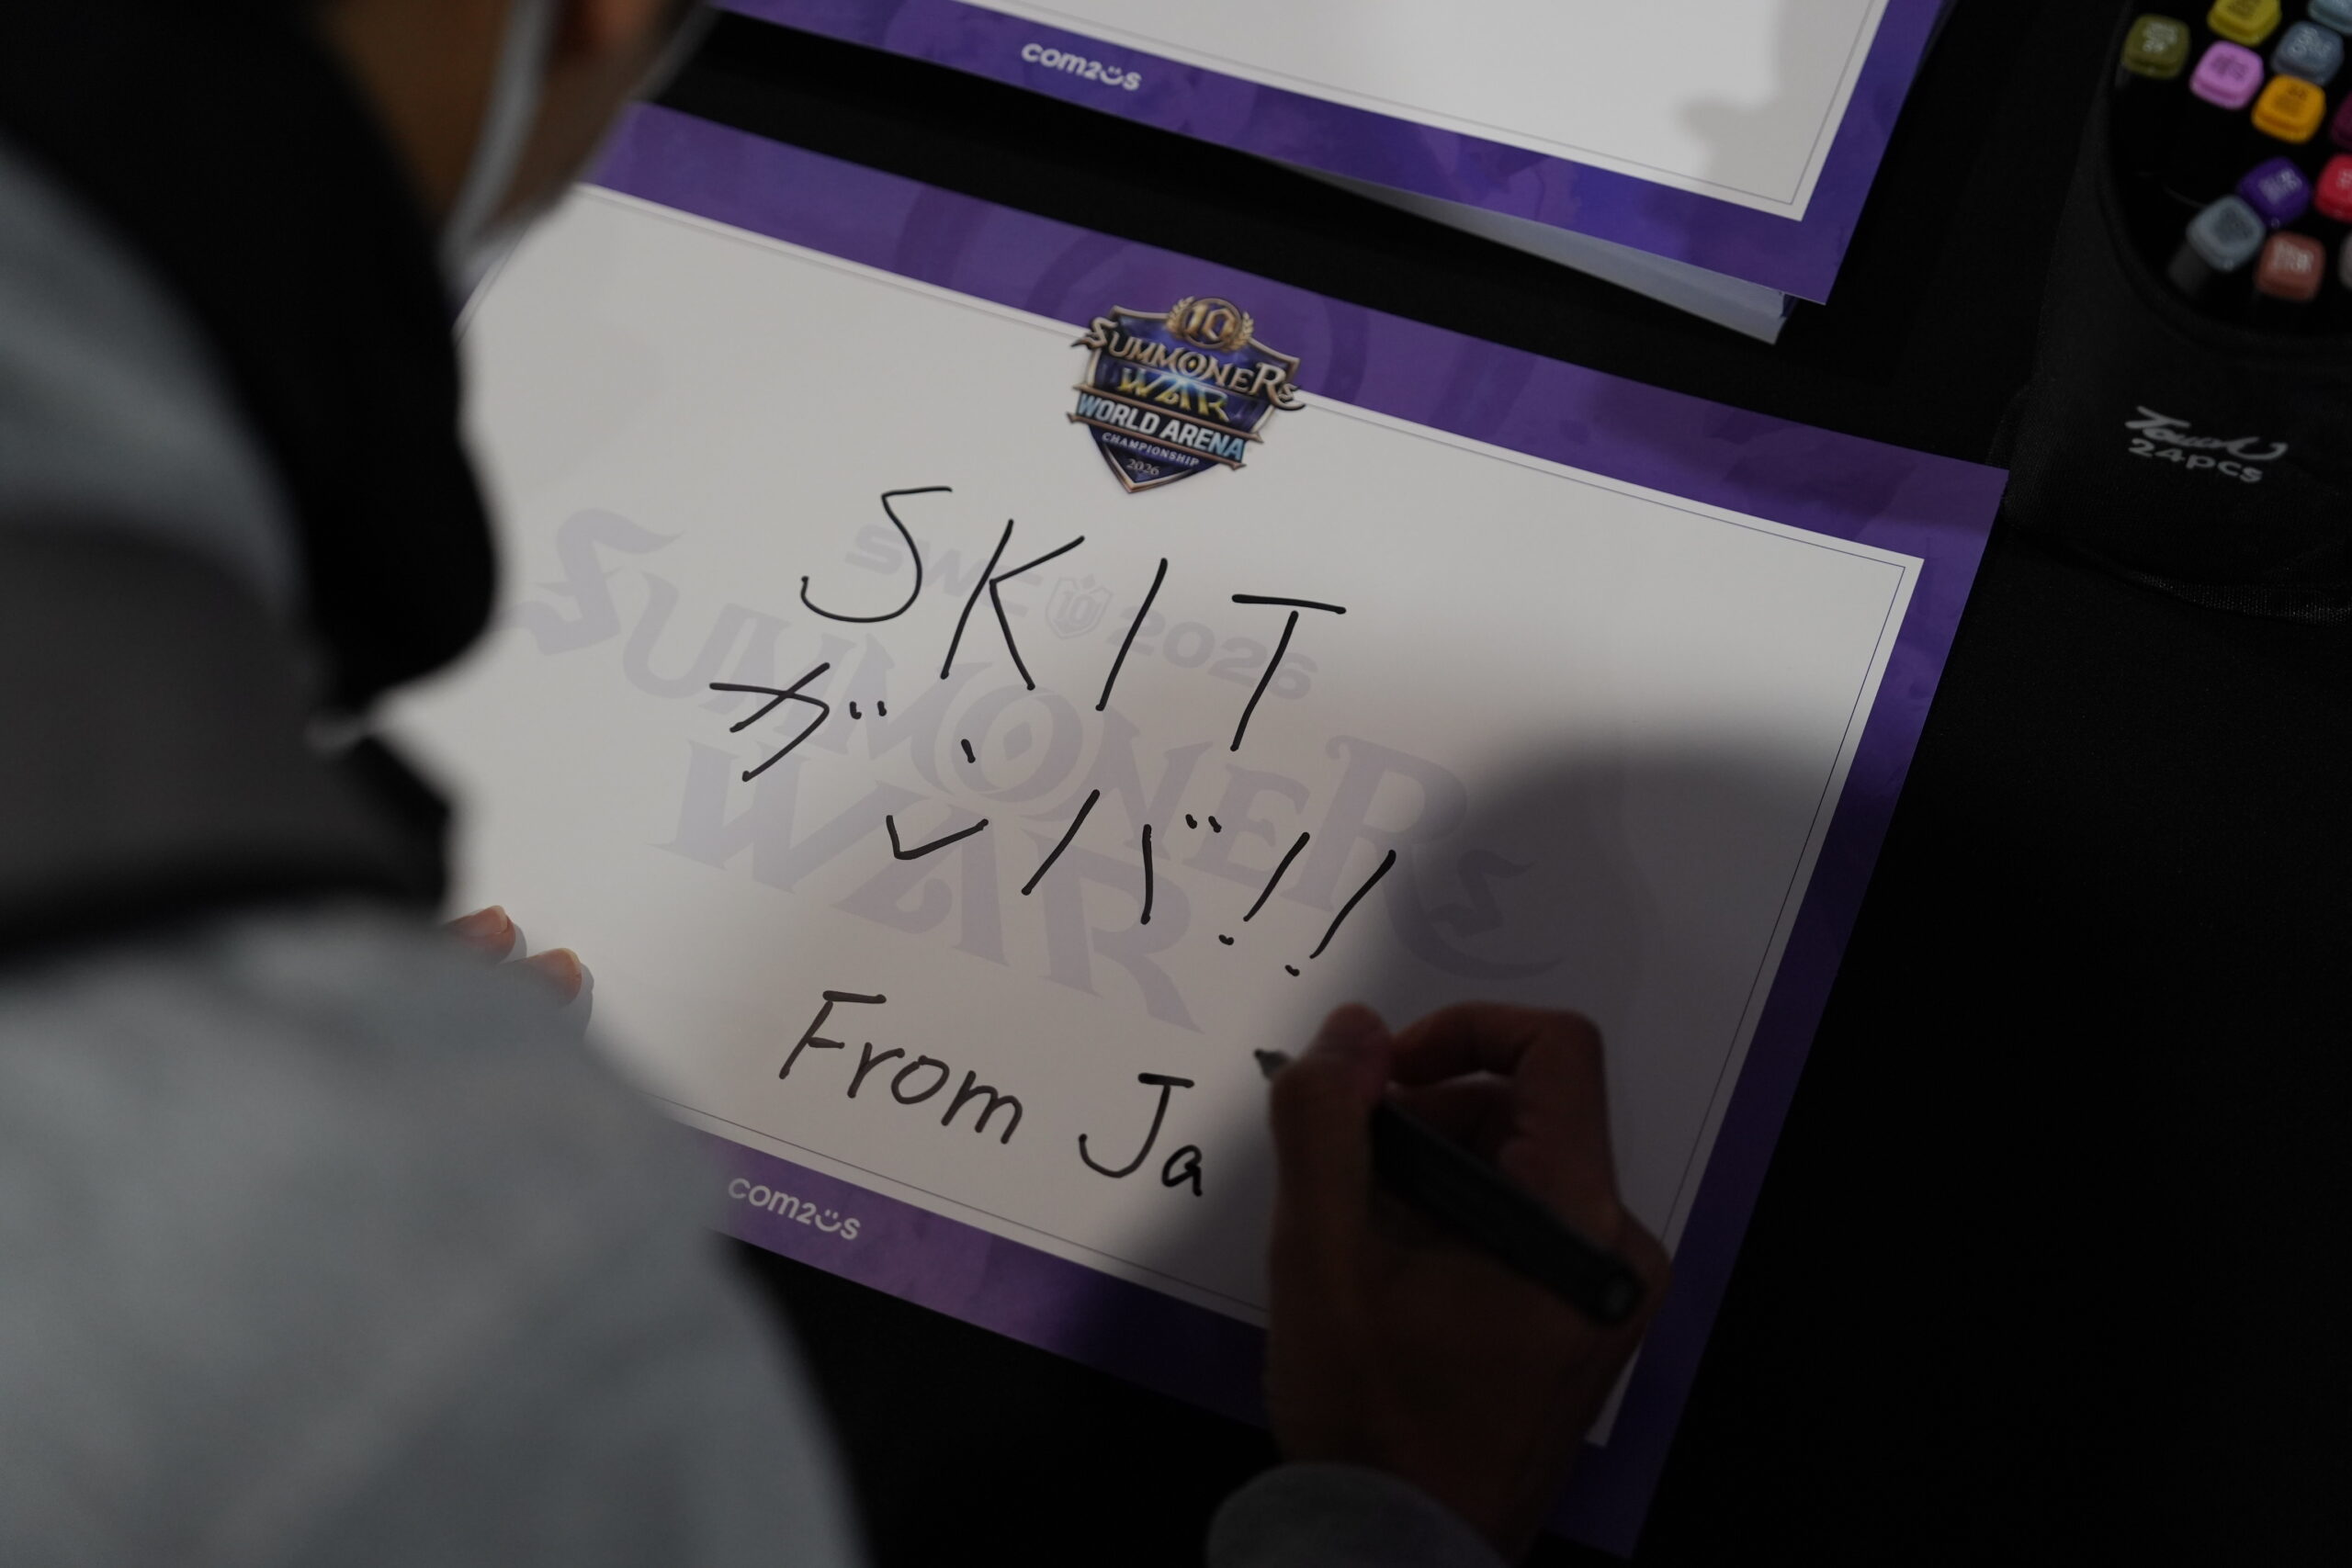
실내 이벤트존에서는 승부 예측과 치어풀 이벤트가 진행됐다. 관객들은 최종 우승자를 예상하고 선수들에게 응원 메시지를 남겼다. 승부 예측 이벤트에는 선수단 전용 공식 바람막이가 경품으로 걸렸다.
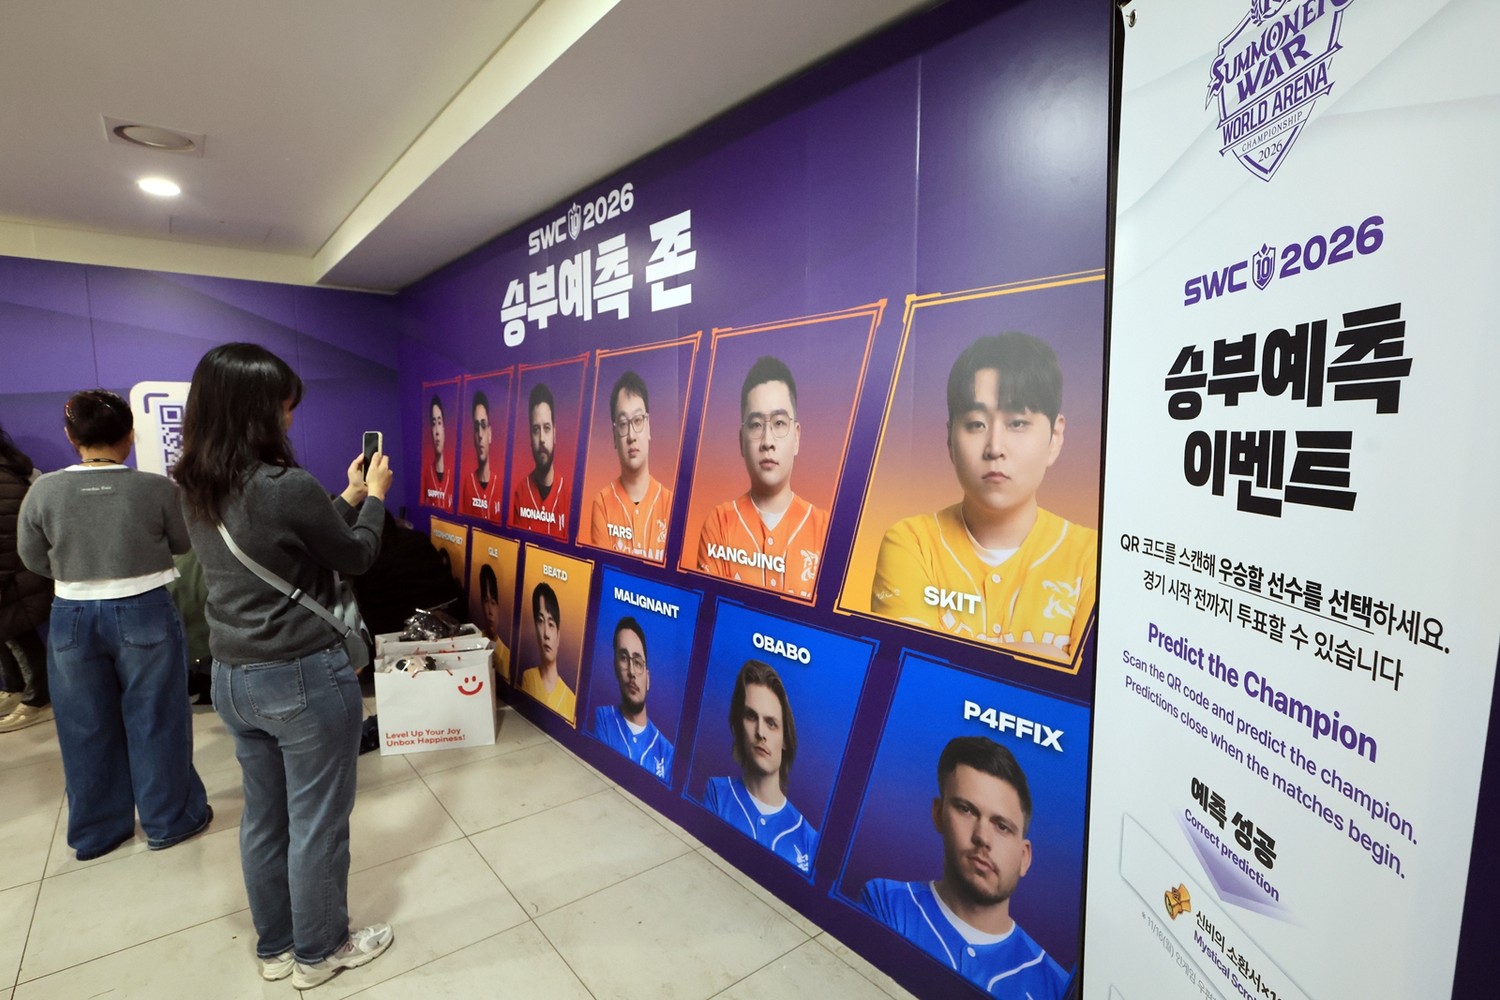 |  |
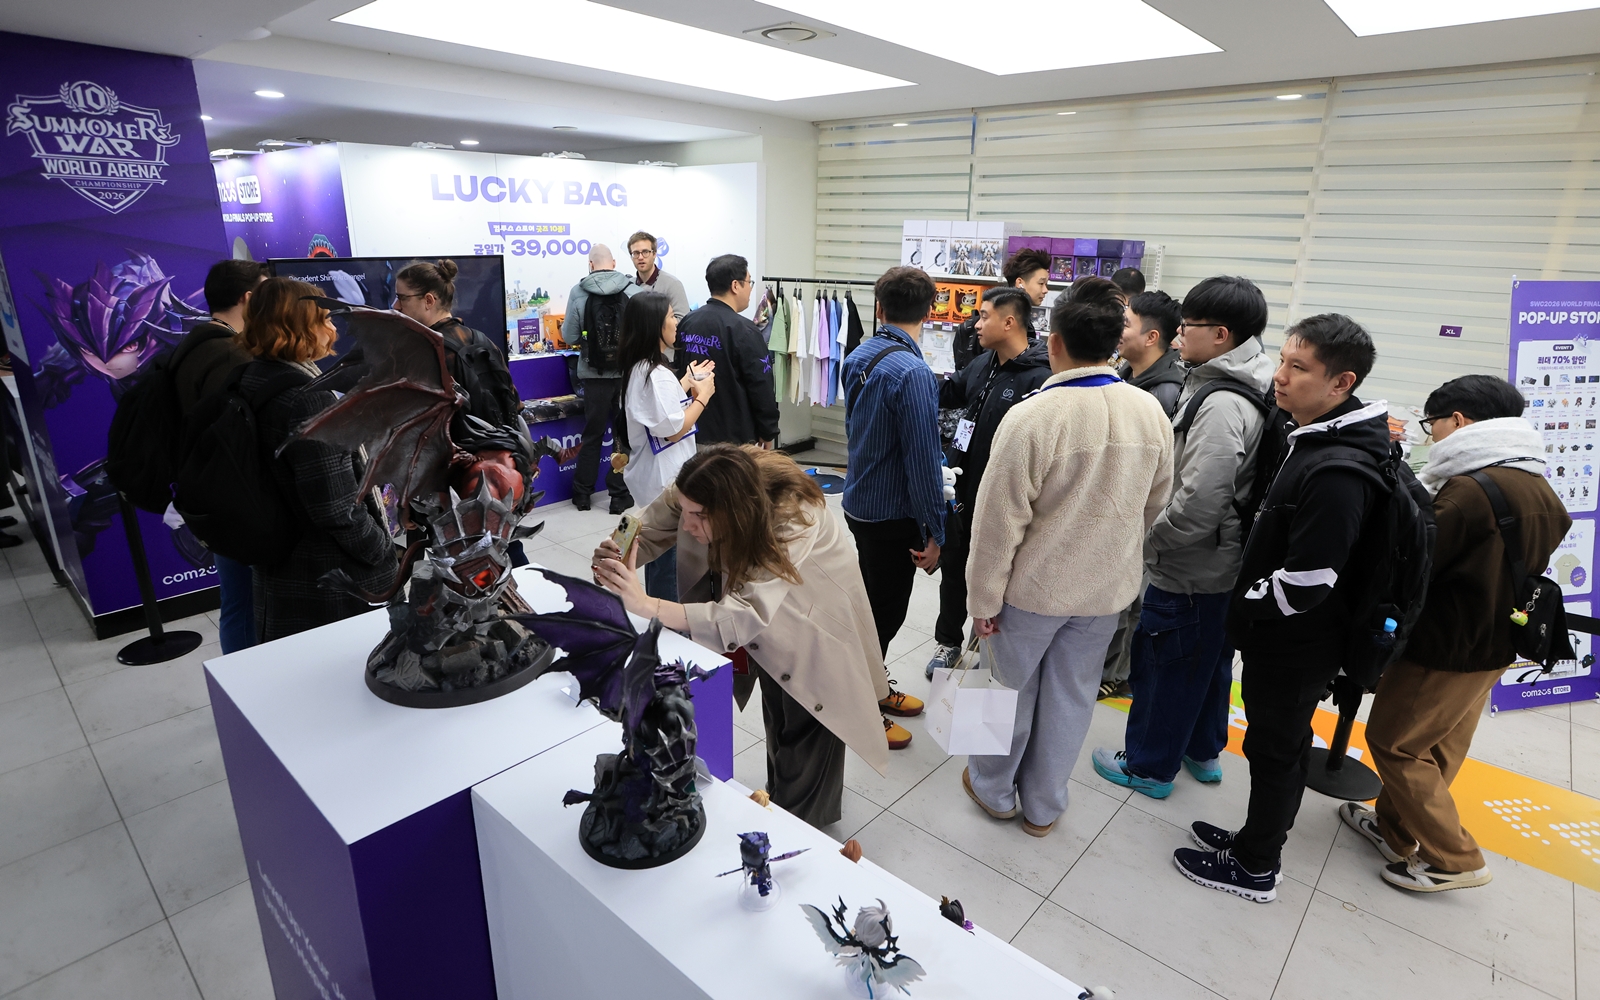
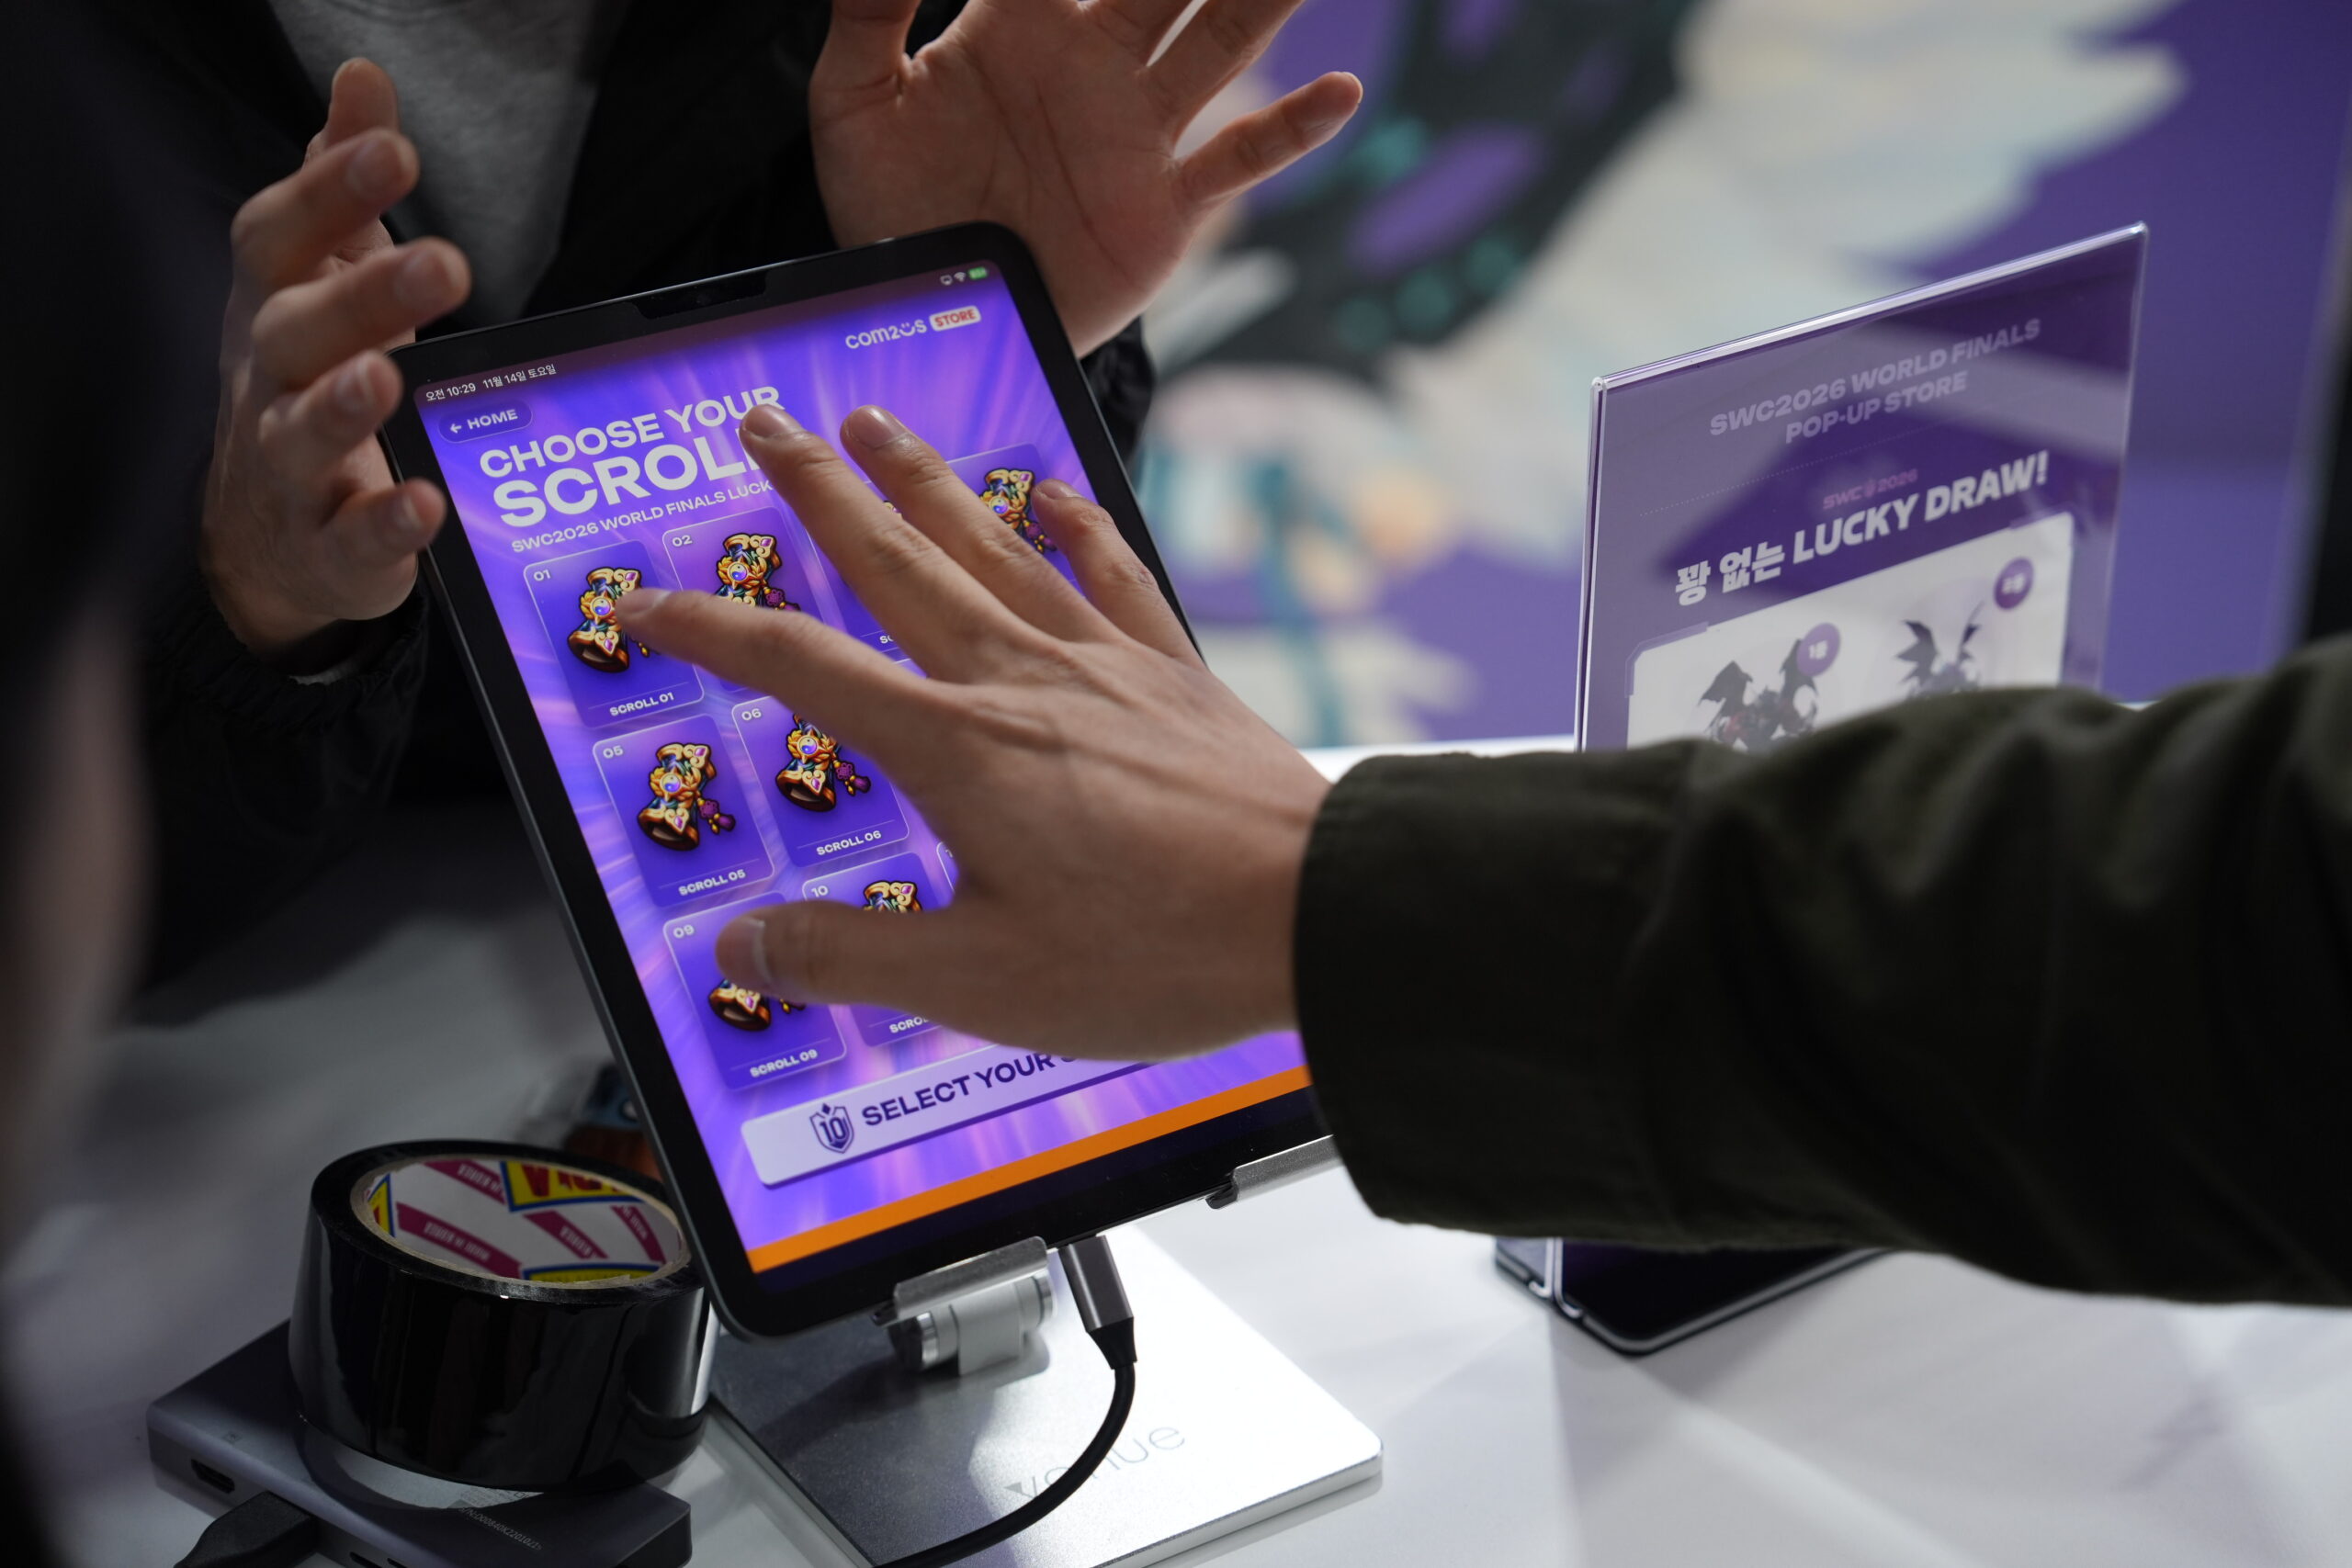
공식 팝업 스토어에서는 ‘서머너즈 워’ 공식 MD를 판매했다. 관람객에게는 Cafe_Lapis 협업 쿠키와 함께, 간식 교환권을 통한 먹거리가 제공됐다.
SWC2026 월드 파이널 경기 결과: TARS, 결승 4대 0 완승
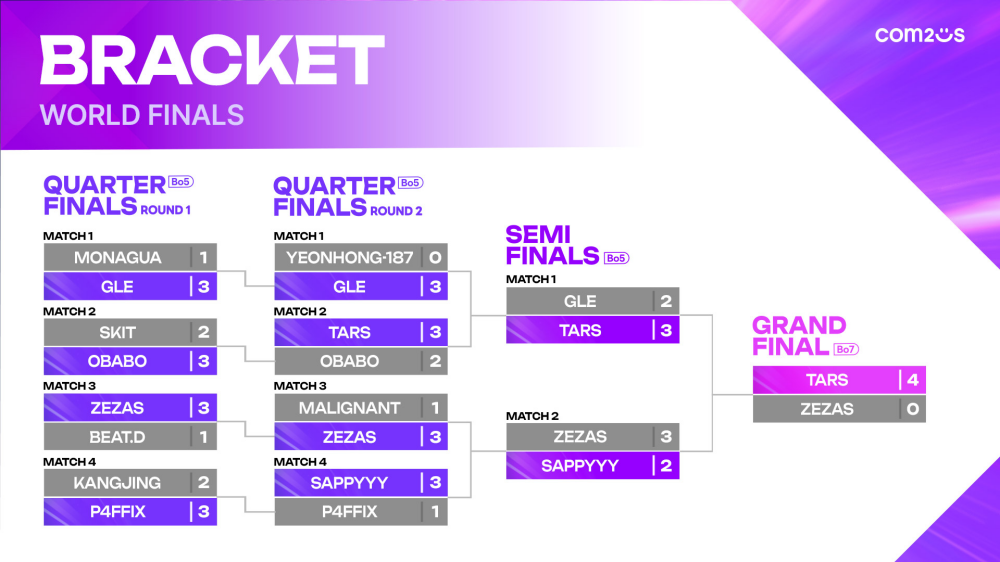
월드 파이널은 낮 12시에 시작됐다. 한국의 SKIT과 BEAT.D를 비롯해 세계 각지 예선과 본선을 통과한 12명의 선수가 출전했다. 경기는 싱글 엘리미네이션 토너먼트로 진행됐다. 8강 1·2라운드와 4강은 5전 3선승제(BO5), 결승은 7전 4선승제(BO7)로 치러졌다.
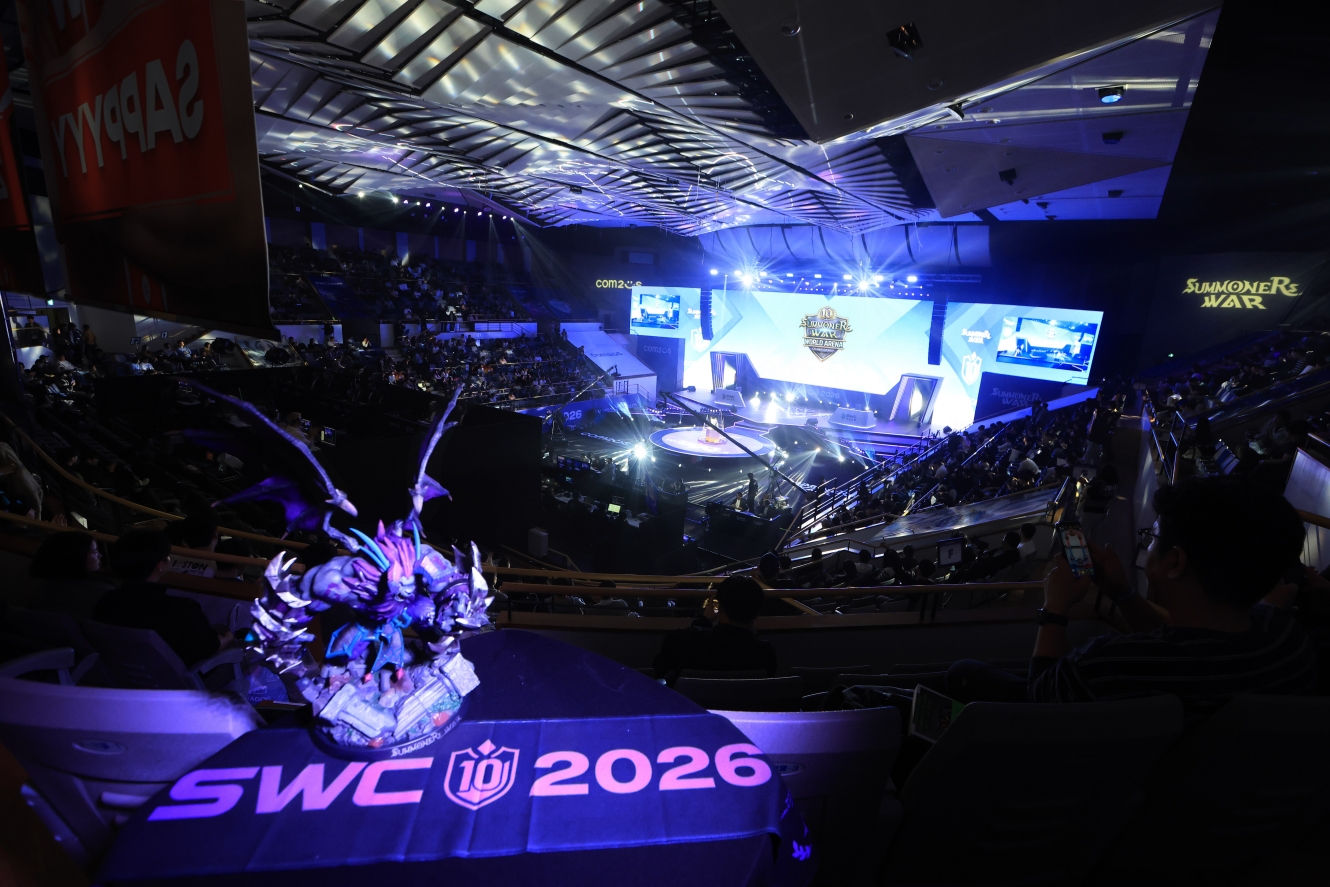
선수들은 몬스터를 고르고 상대의 선택을 제한하는 픽밴 단계부터 전략을 겨뤘다. 객석에서는 매 경기 환호와 응원이 터져 나왔다.
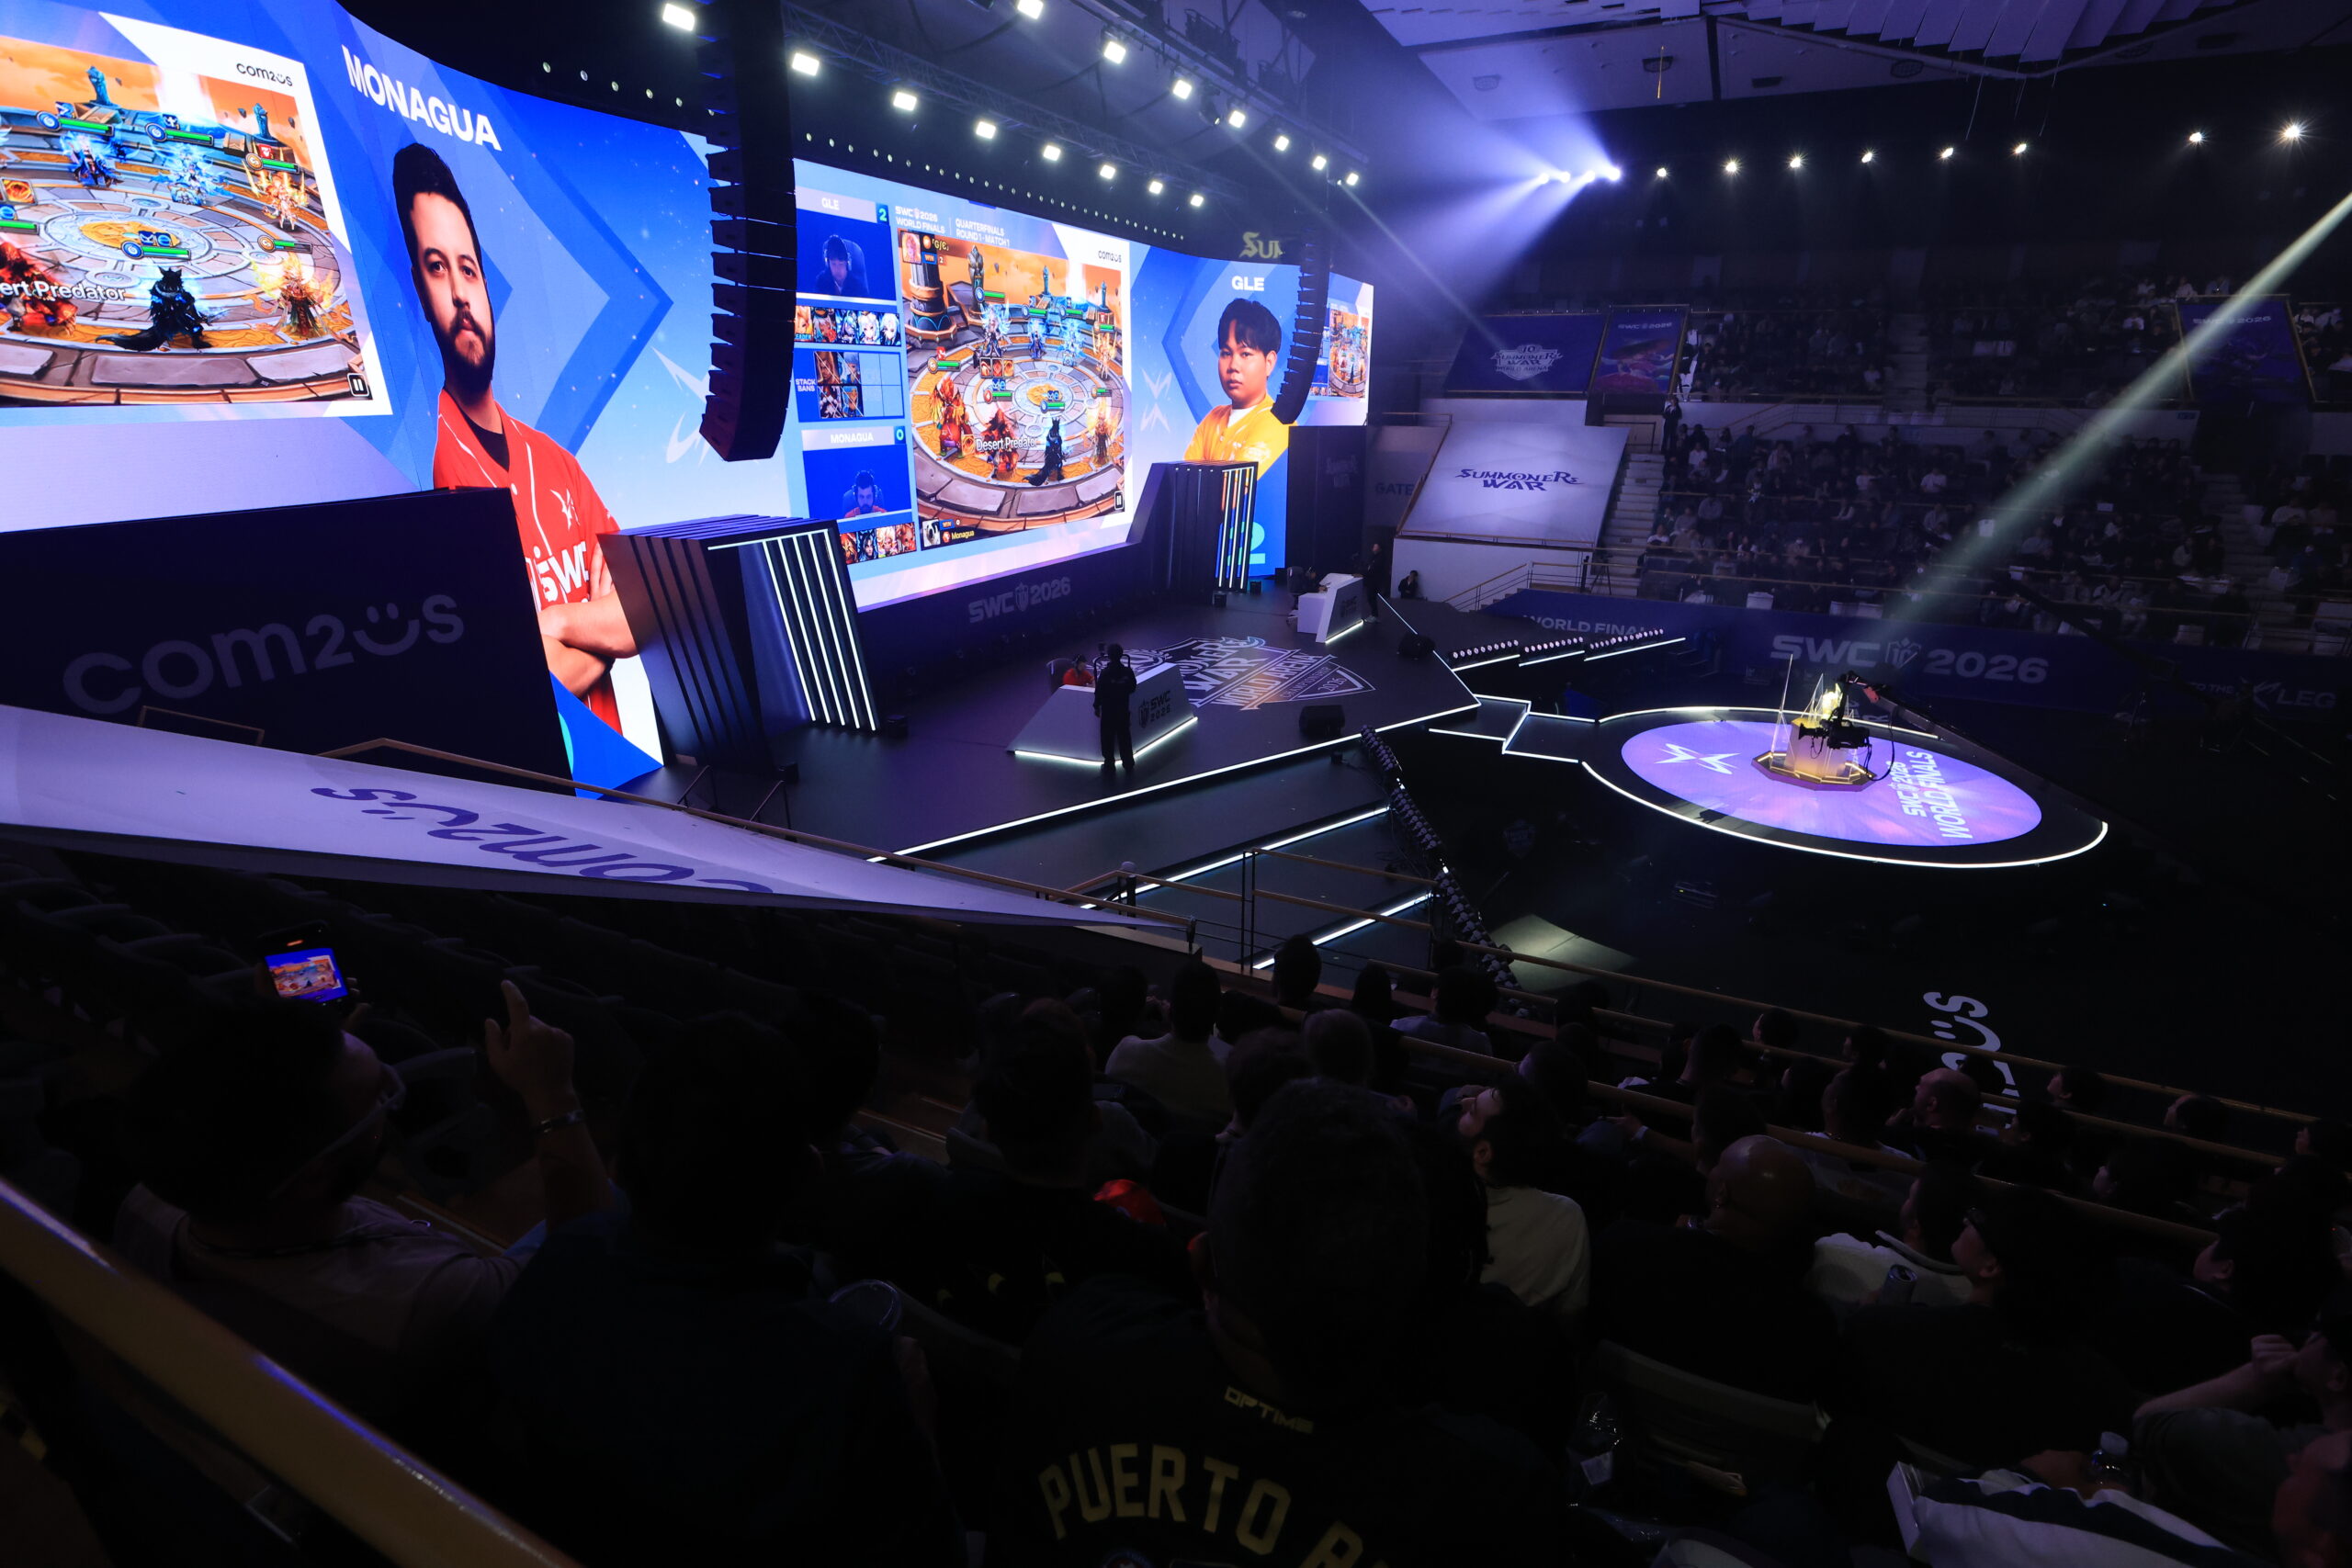
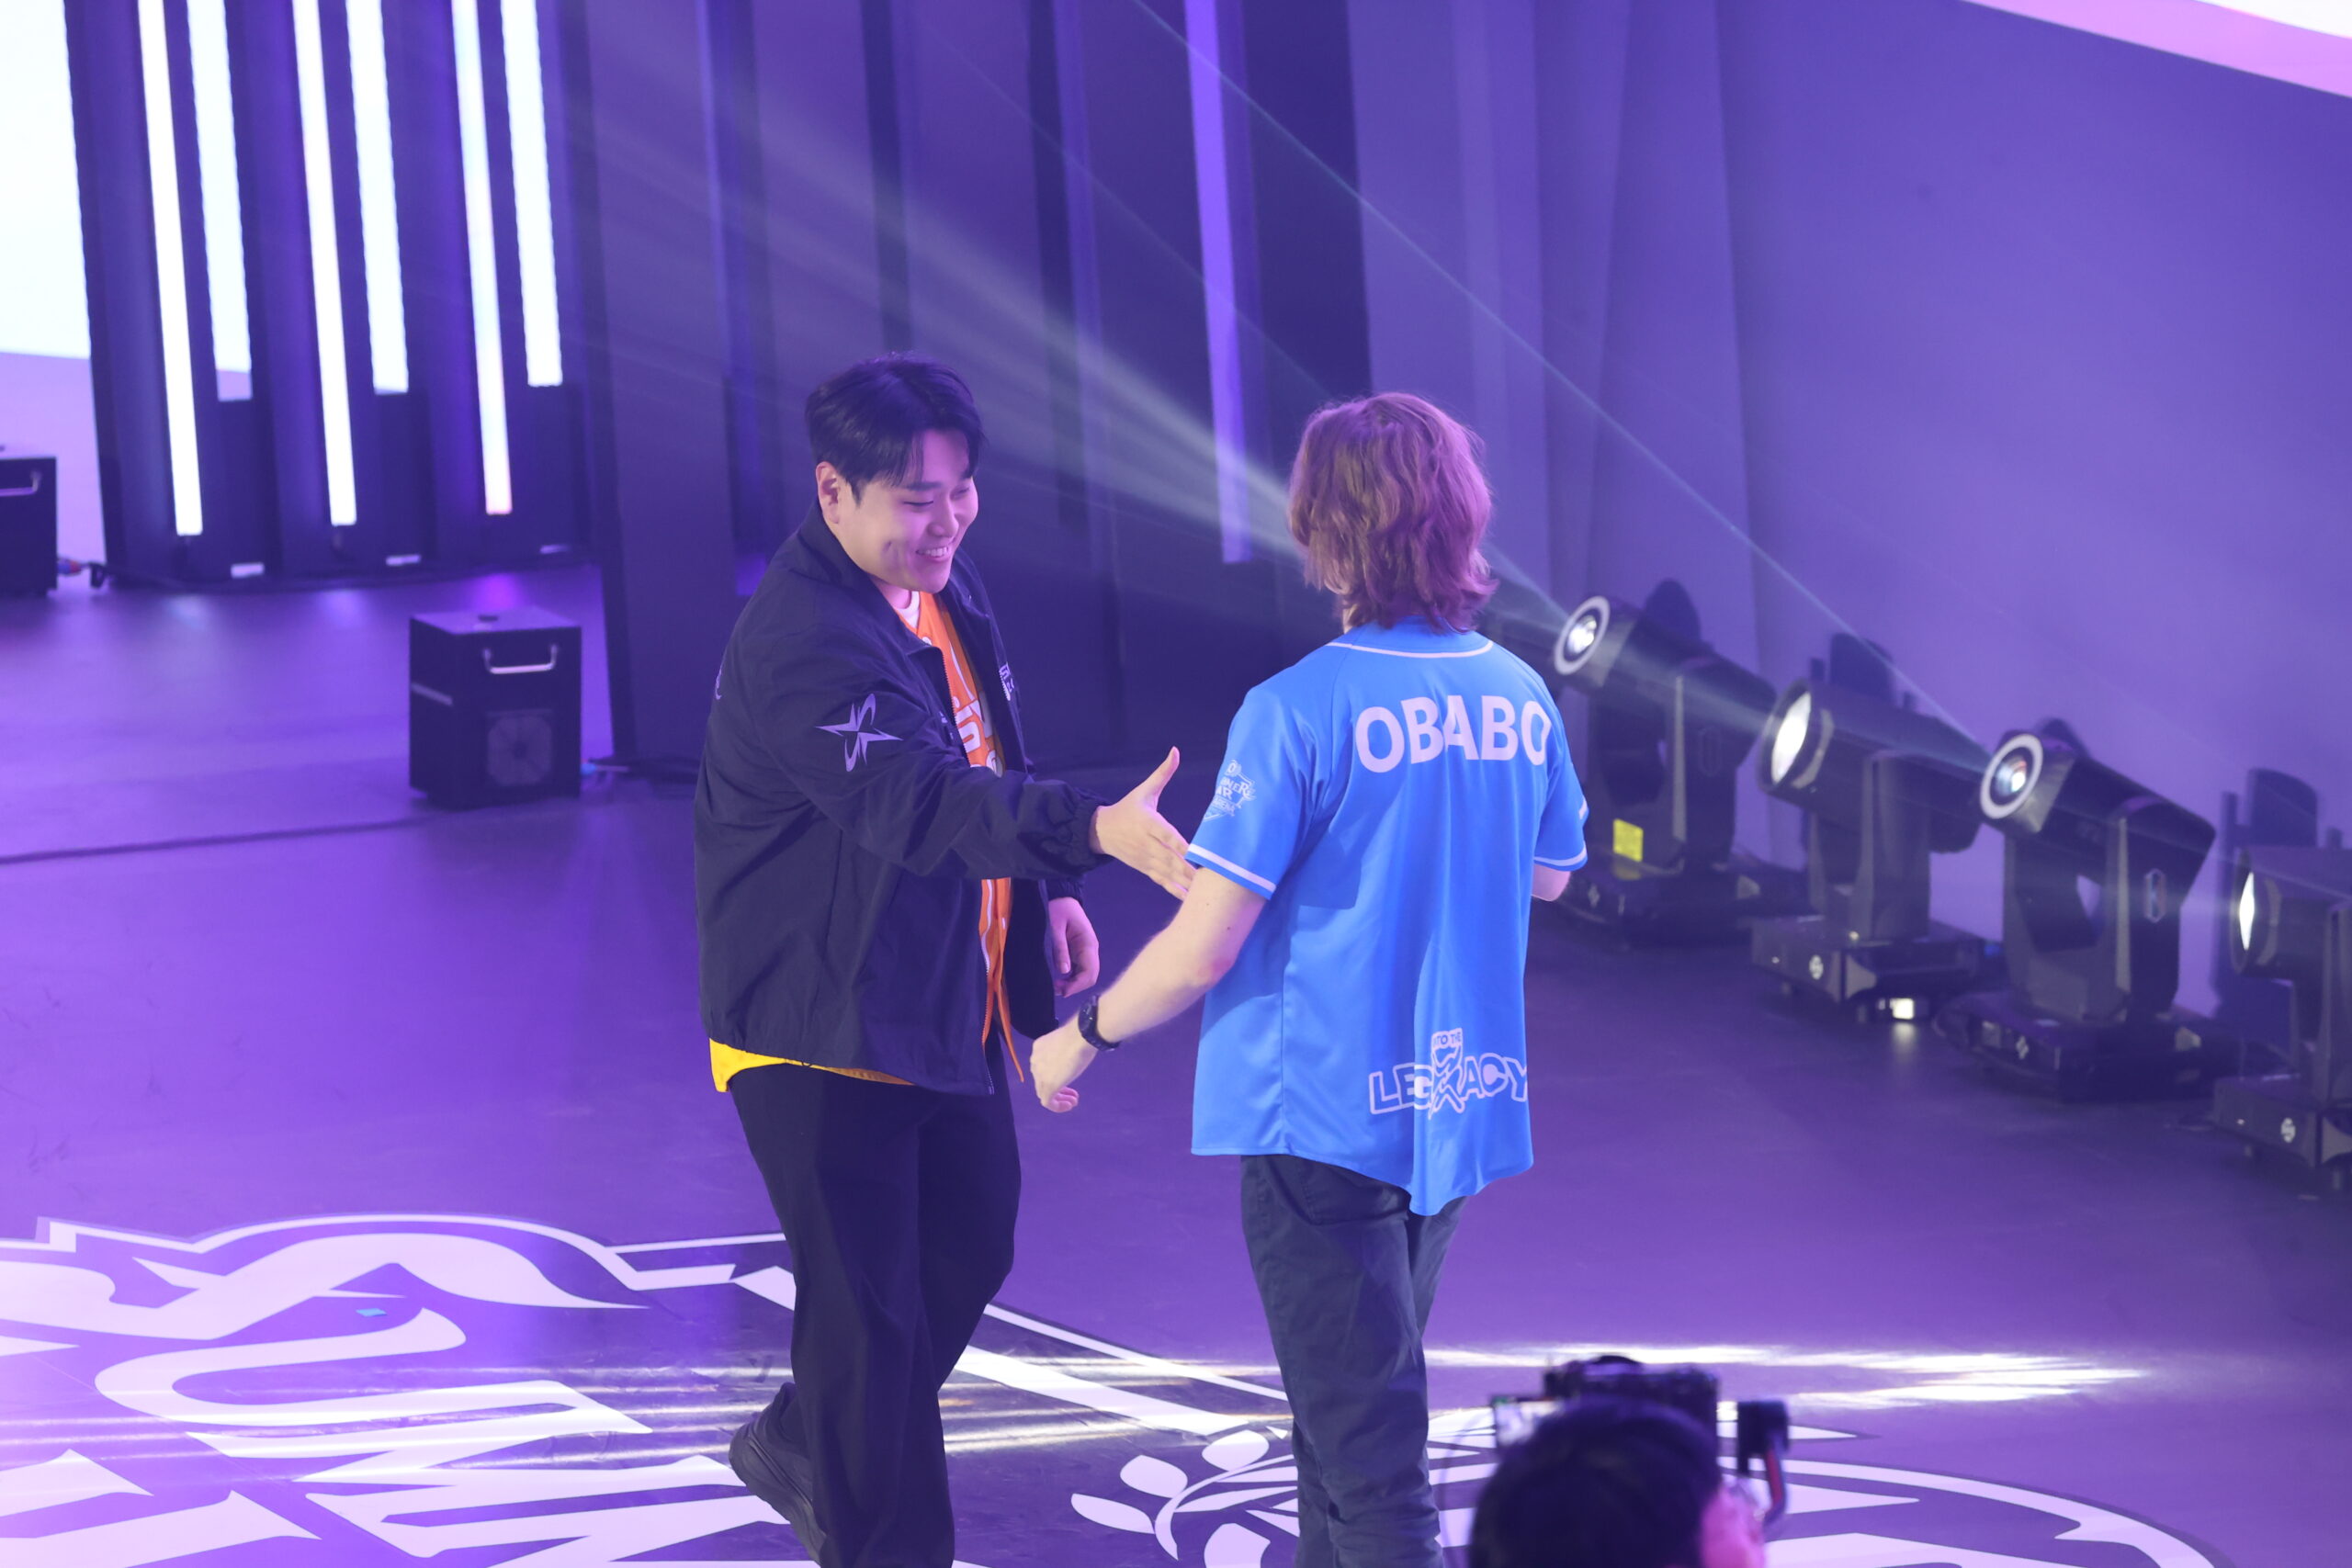
한국의 SKIT과 BEAT.D는 8강 1라운드에서 각각 OBABO에게 2대 3, ZEZAS에게 1대 3으로 패했다.
TARS는 결승에 오르기까지 두 번 풀세트를 치렀다. 8강 2라운드에서 OBABO를 3대 2로 꺾었고, 4강에서도 GLE와 풀세트 접전 끝에 3대 2로 이겼다.
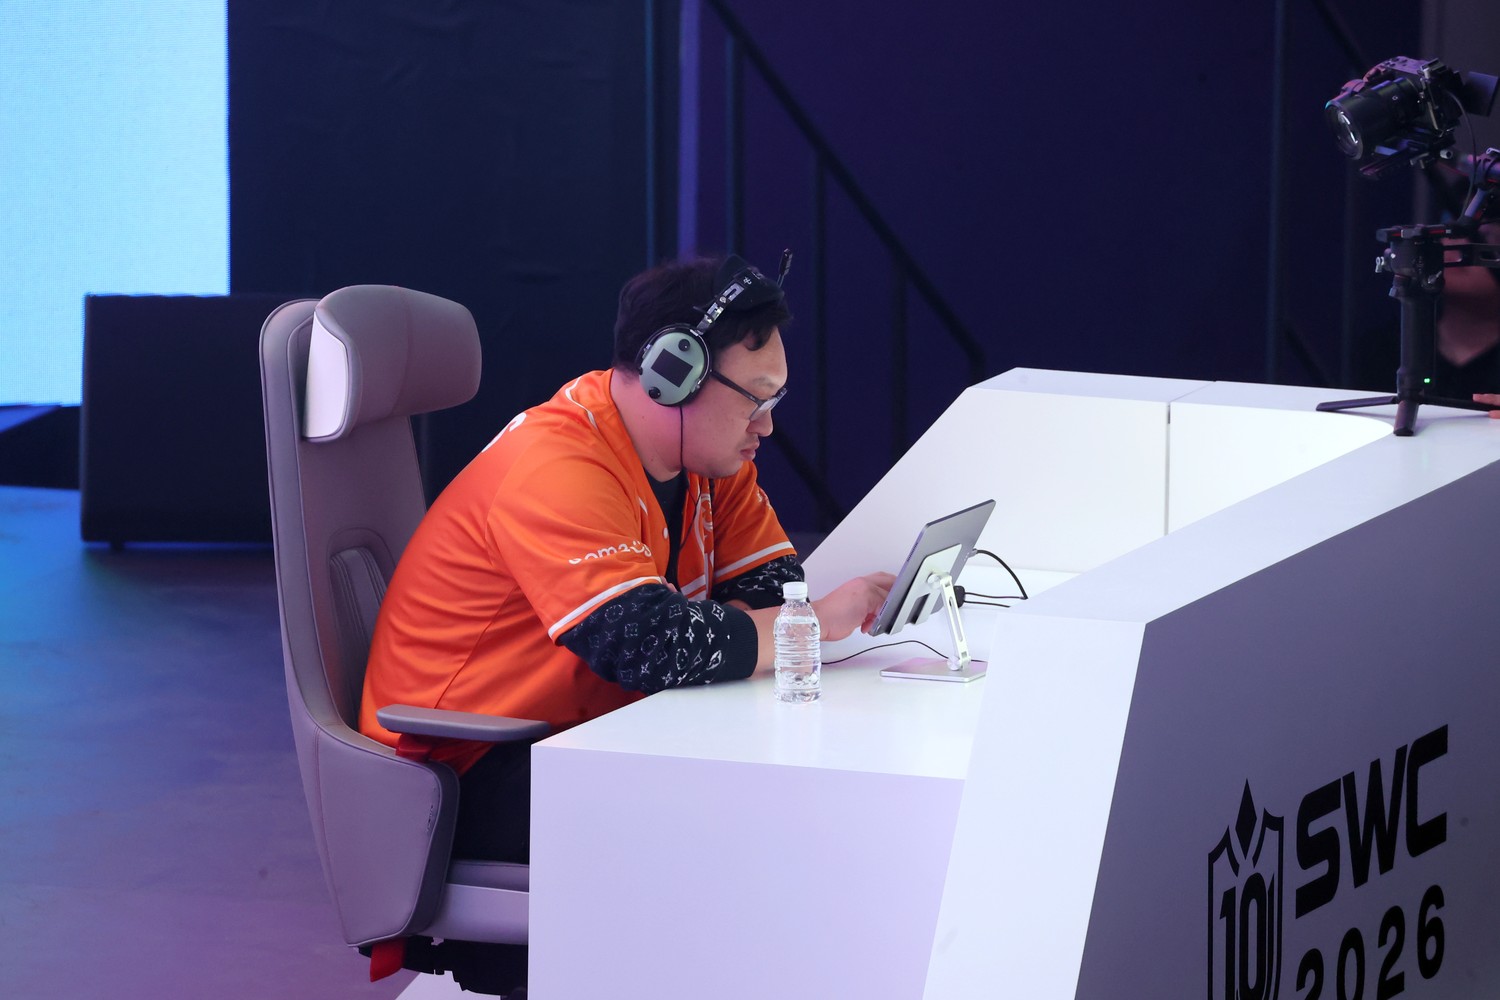 | 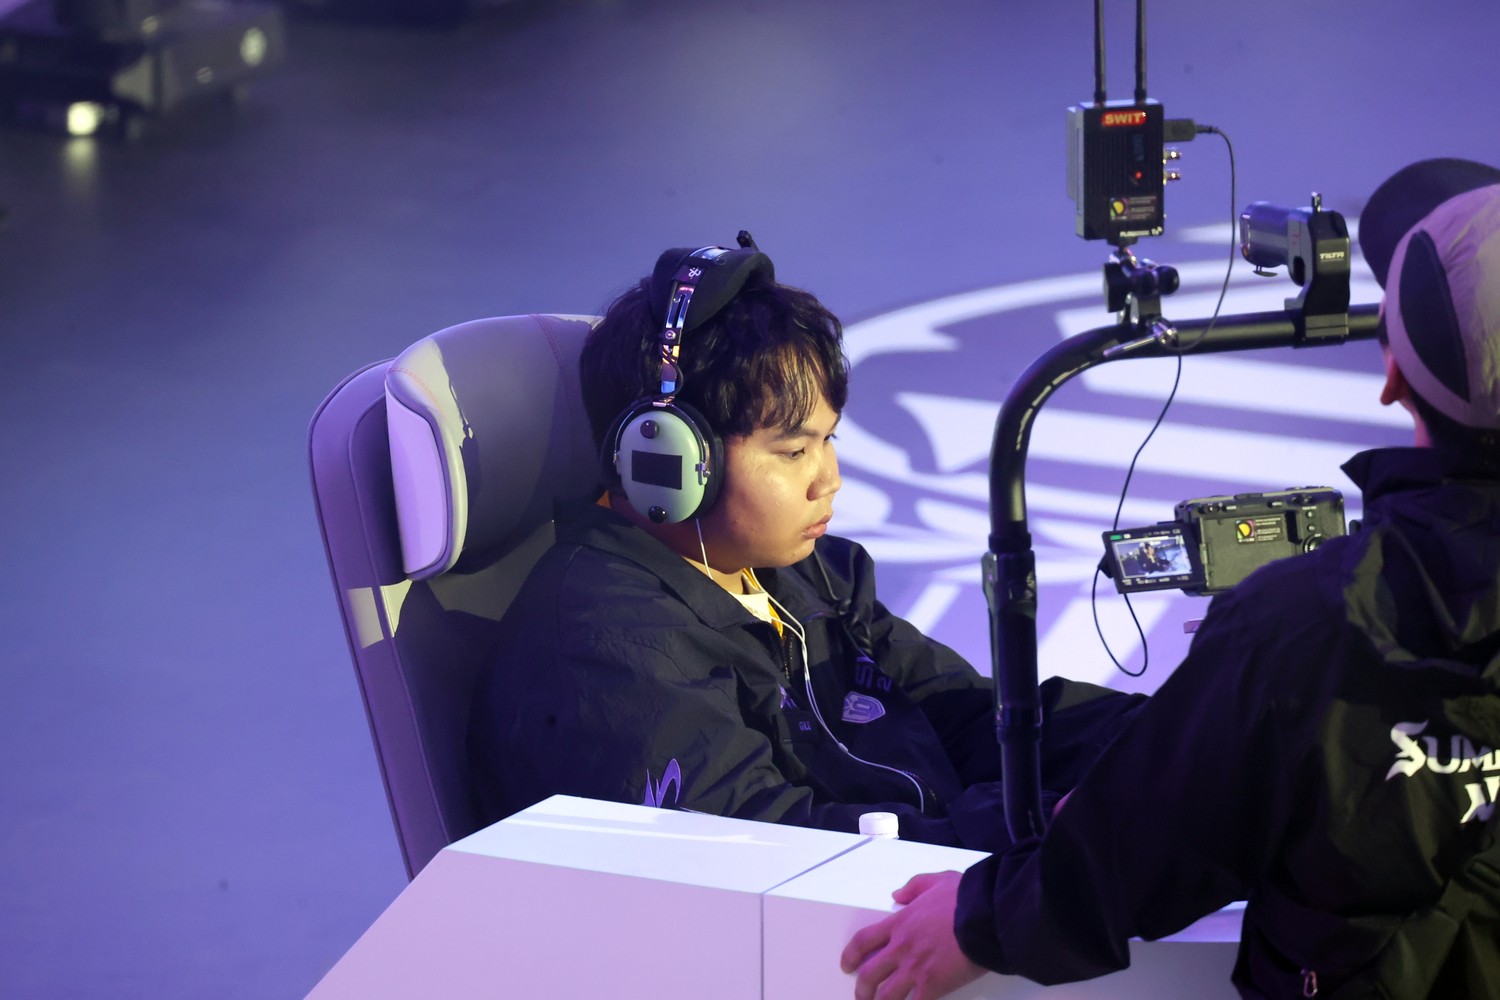 |
반대편에서는 ZEZAS가 BEAT.D(3대 1), MALIGNANT(3대 1), SAPPYYY(3대 2)를 차례로 꺾고 결승에 올랐다.
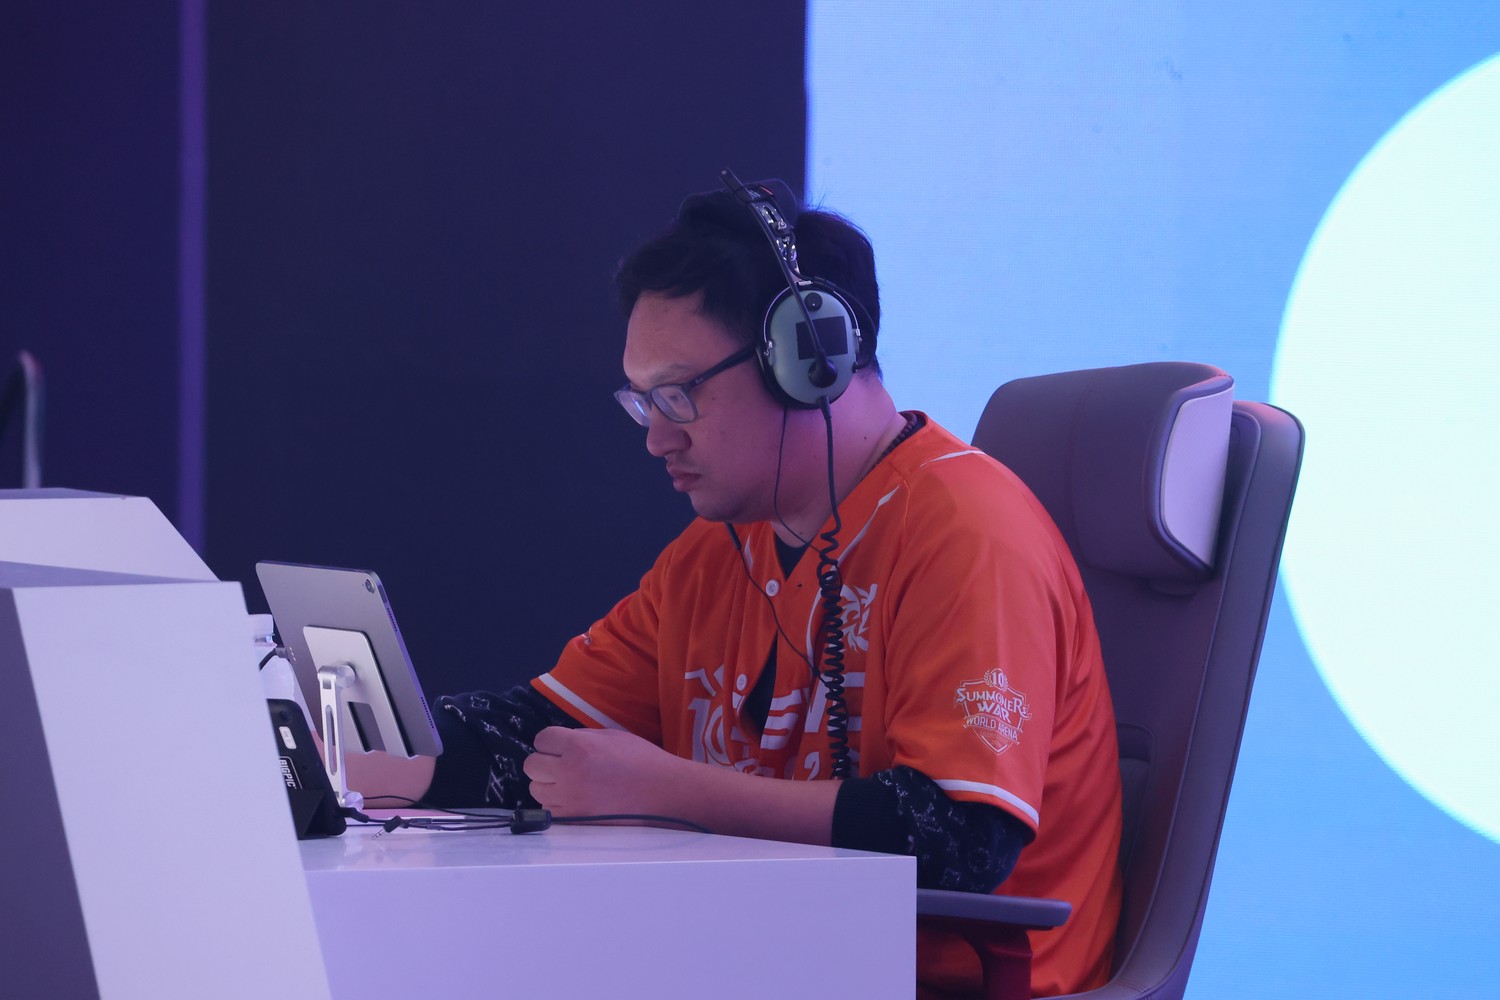 | 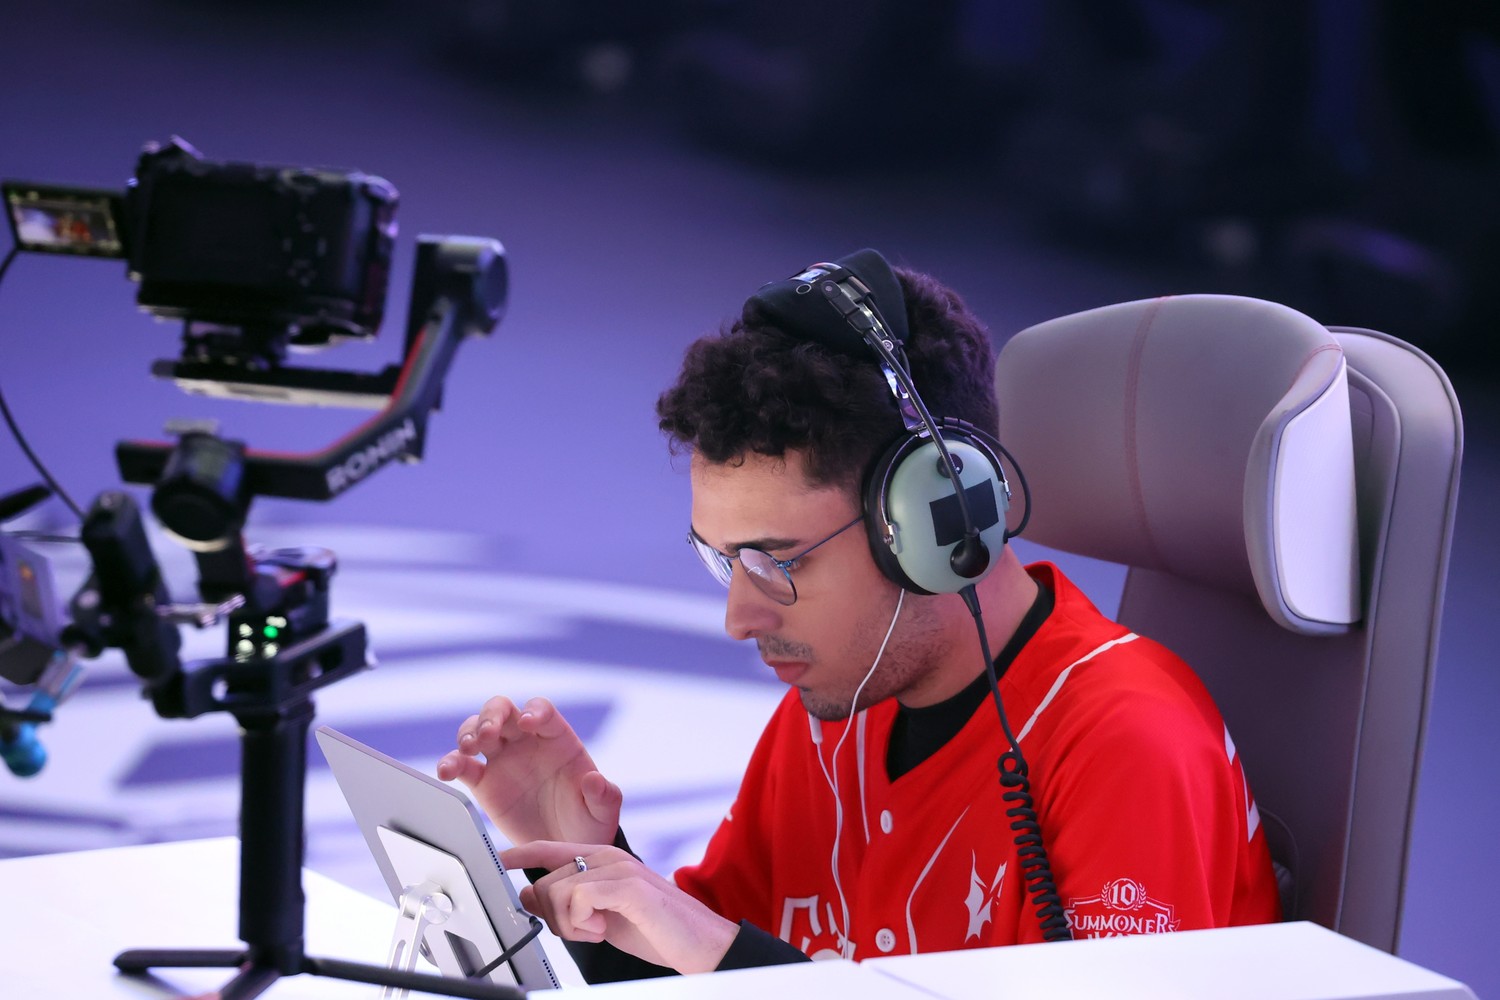 |
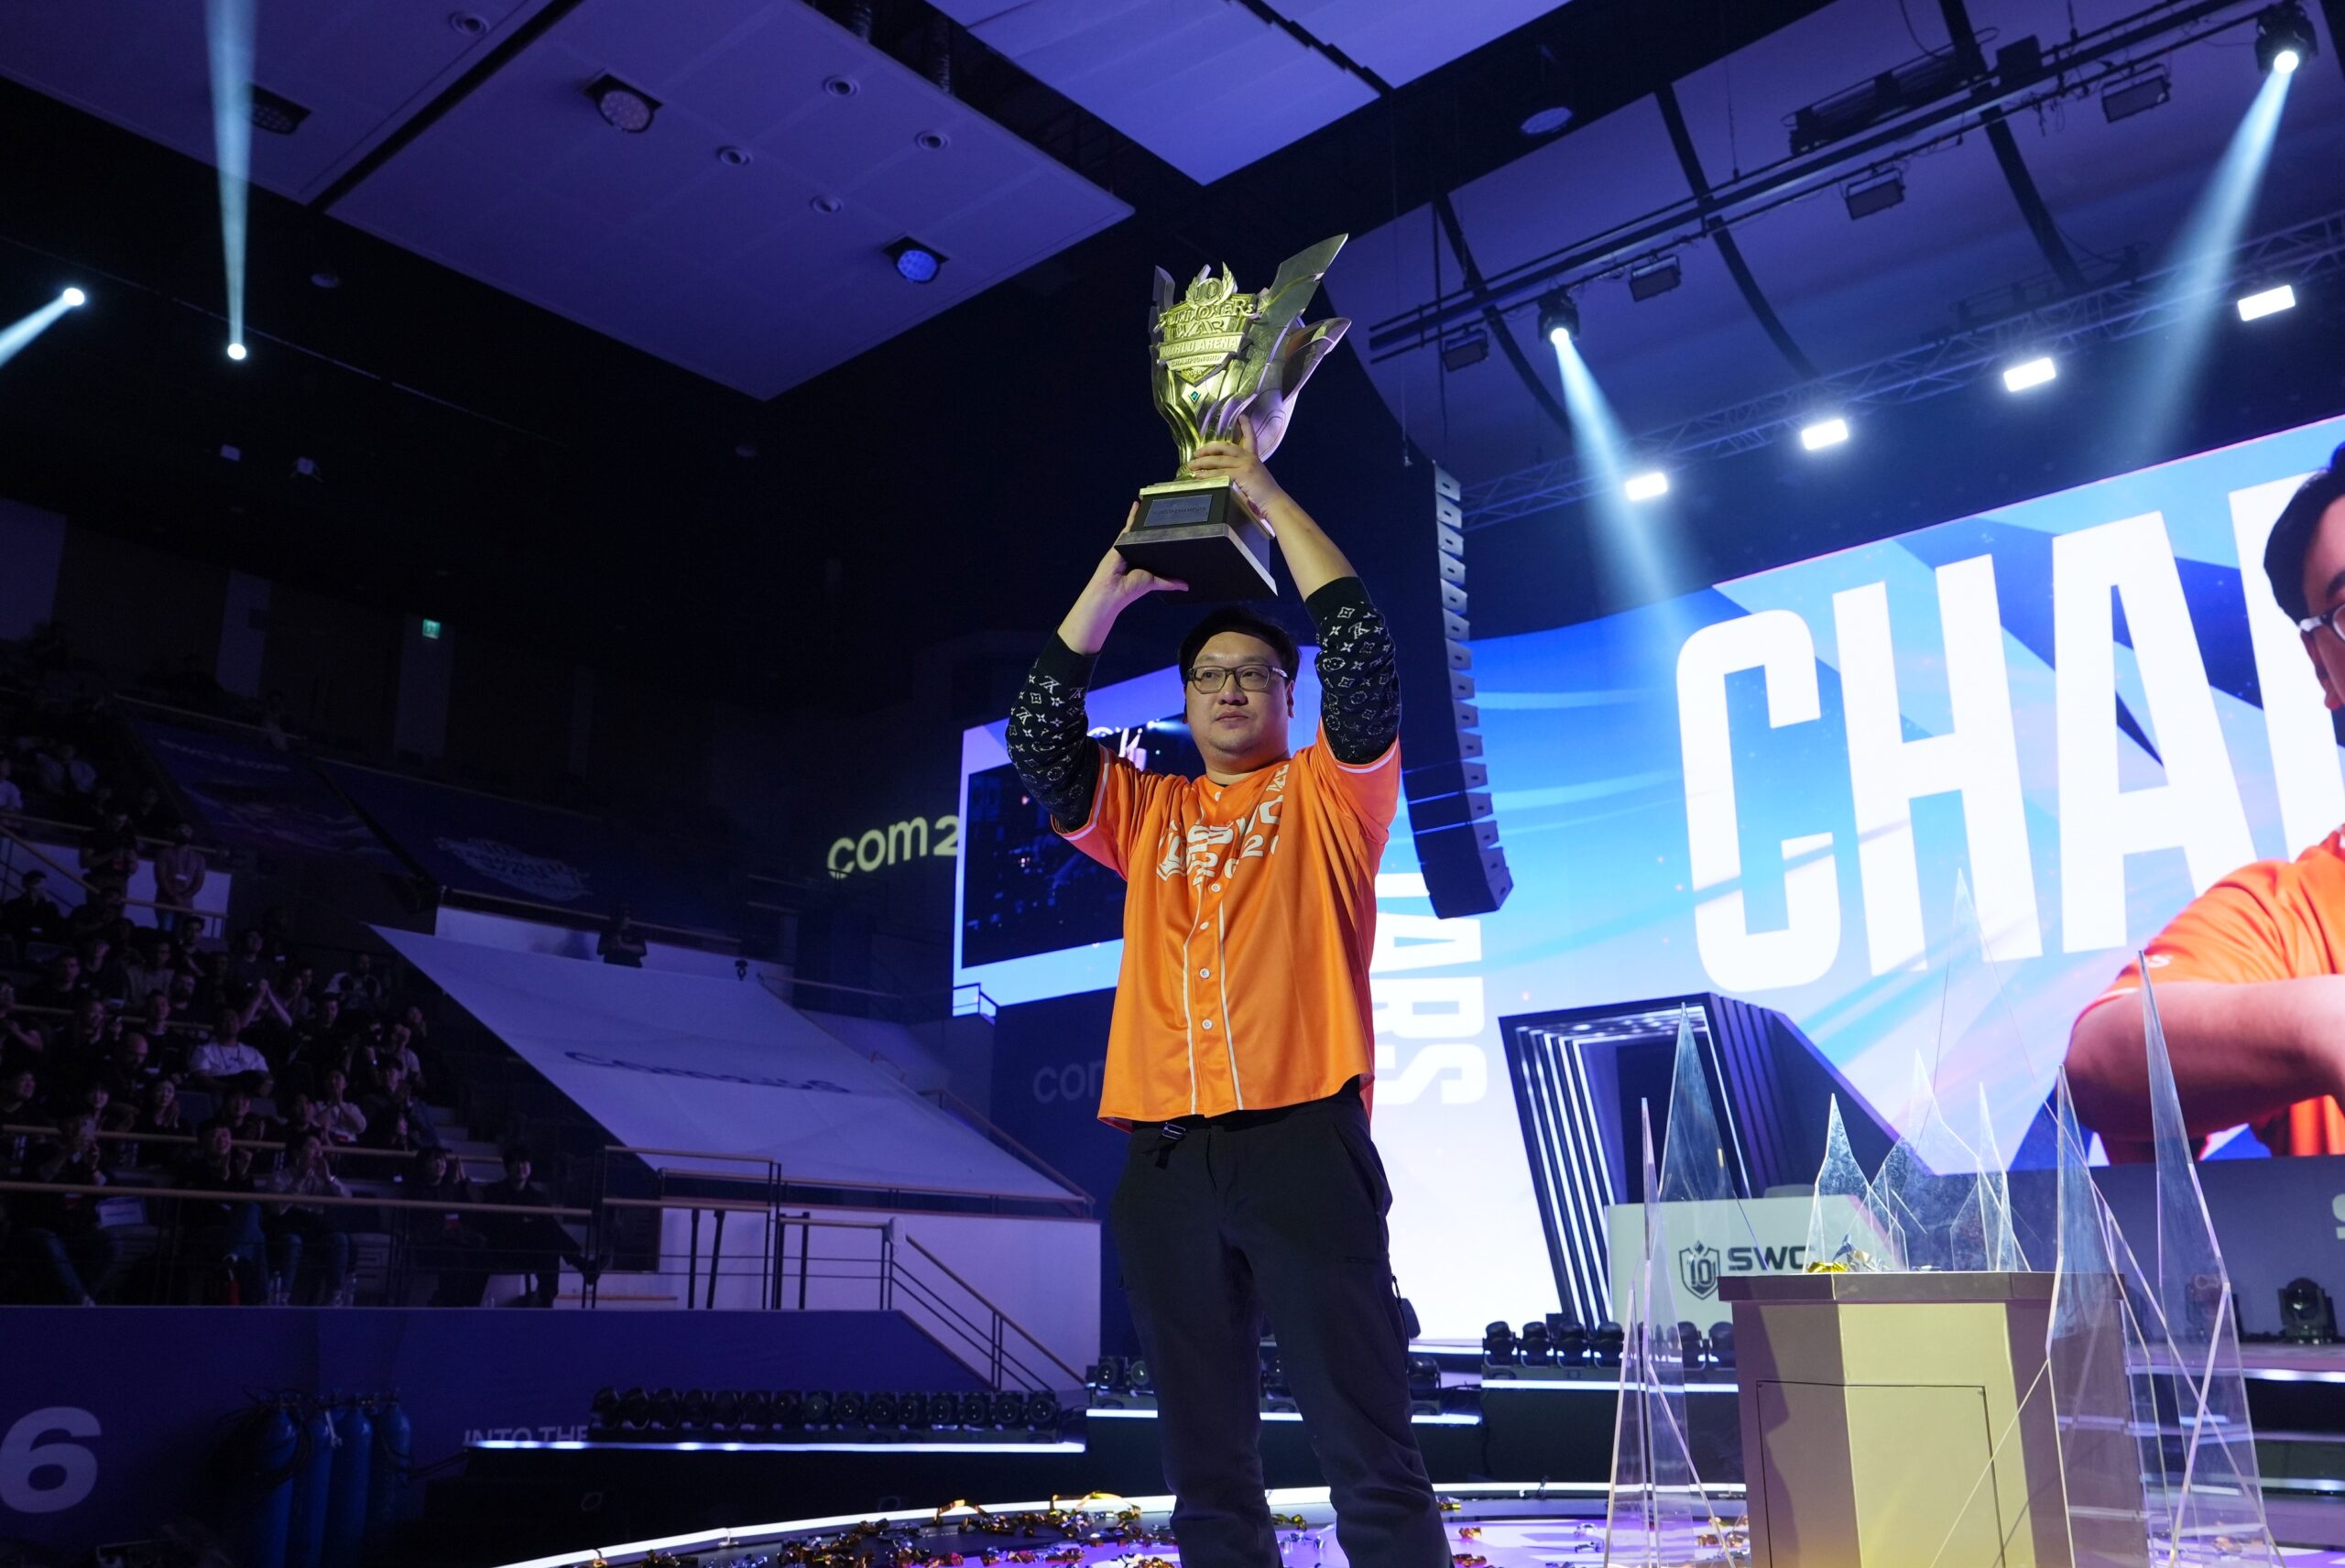
결승에서 TARS는 ZEZAS를 4대 0으로 제압했다. 2022년 SWC 우승자인 TARS는 4년 만에 두 번째 월드 챔피언 타이틀을 차지하며 SWC 열 번째 챔피언에 이름을 올렸다.
SWC2026 월드 파이널 최종 순위
| 순위 | 선수 |
|---|---|
| 1위 | TARS |
| 2위 | ZEZAS |
| 공동 3위 | GLE, SAPPYYY |
| 5~8위 | YEONHONG-187, OBABO, MALIGNANT, P4FFIX |
| 9~12위 | MONAGUA, SKIT, BEAT.D, KANGJING |
SWC2026 우승자 혜택은? 형상 변환 제작 참여와 우승 등장 이펙트
TARS에게는 SWC2026 트로피와 함께 올해 새로 생긴 우승자 혜택 두 가지가 주어진다.
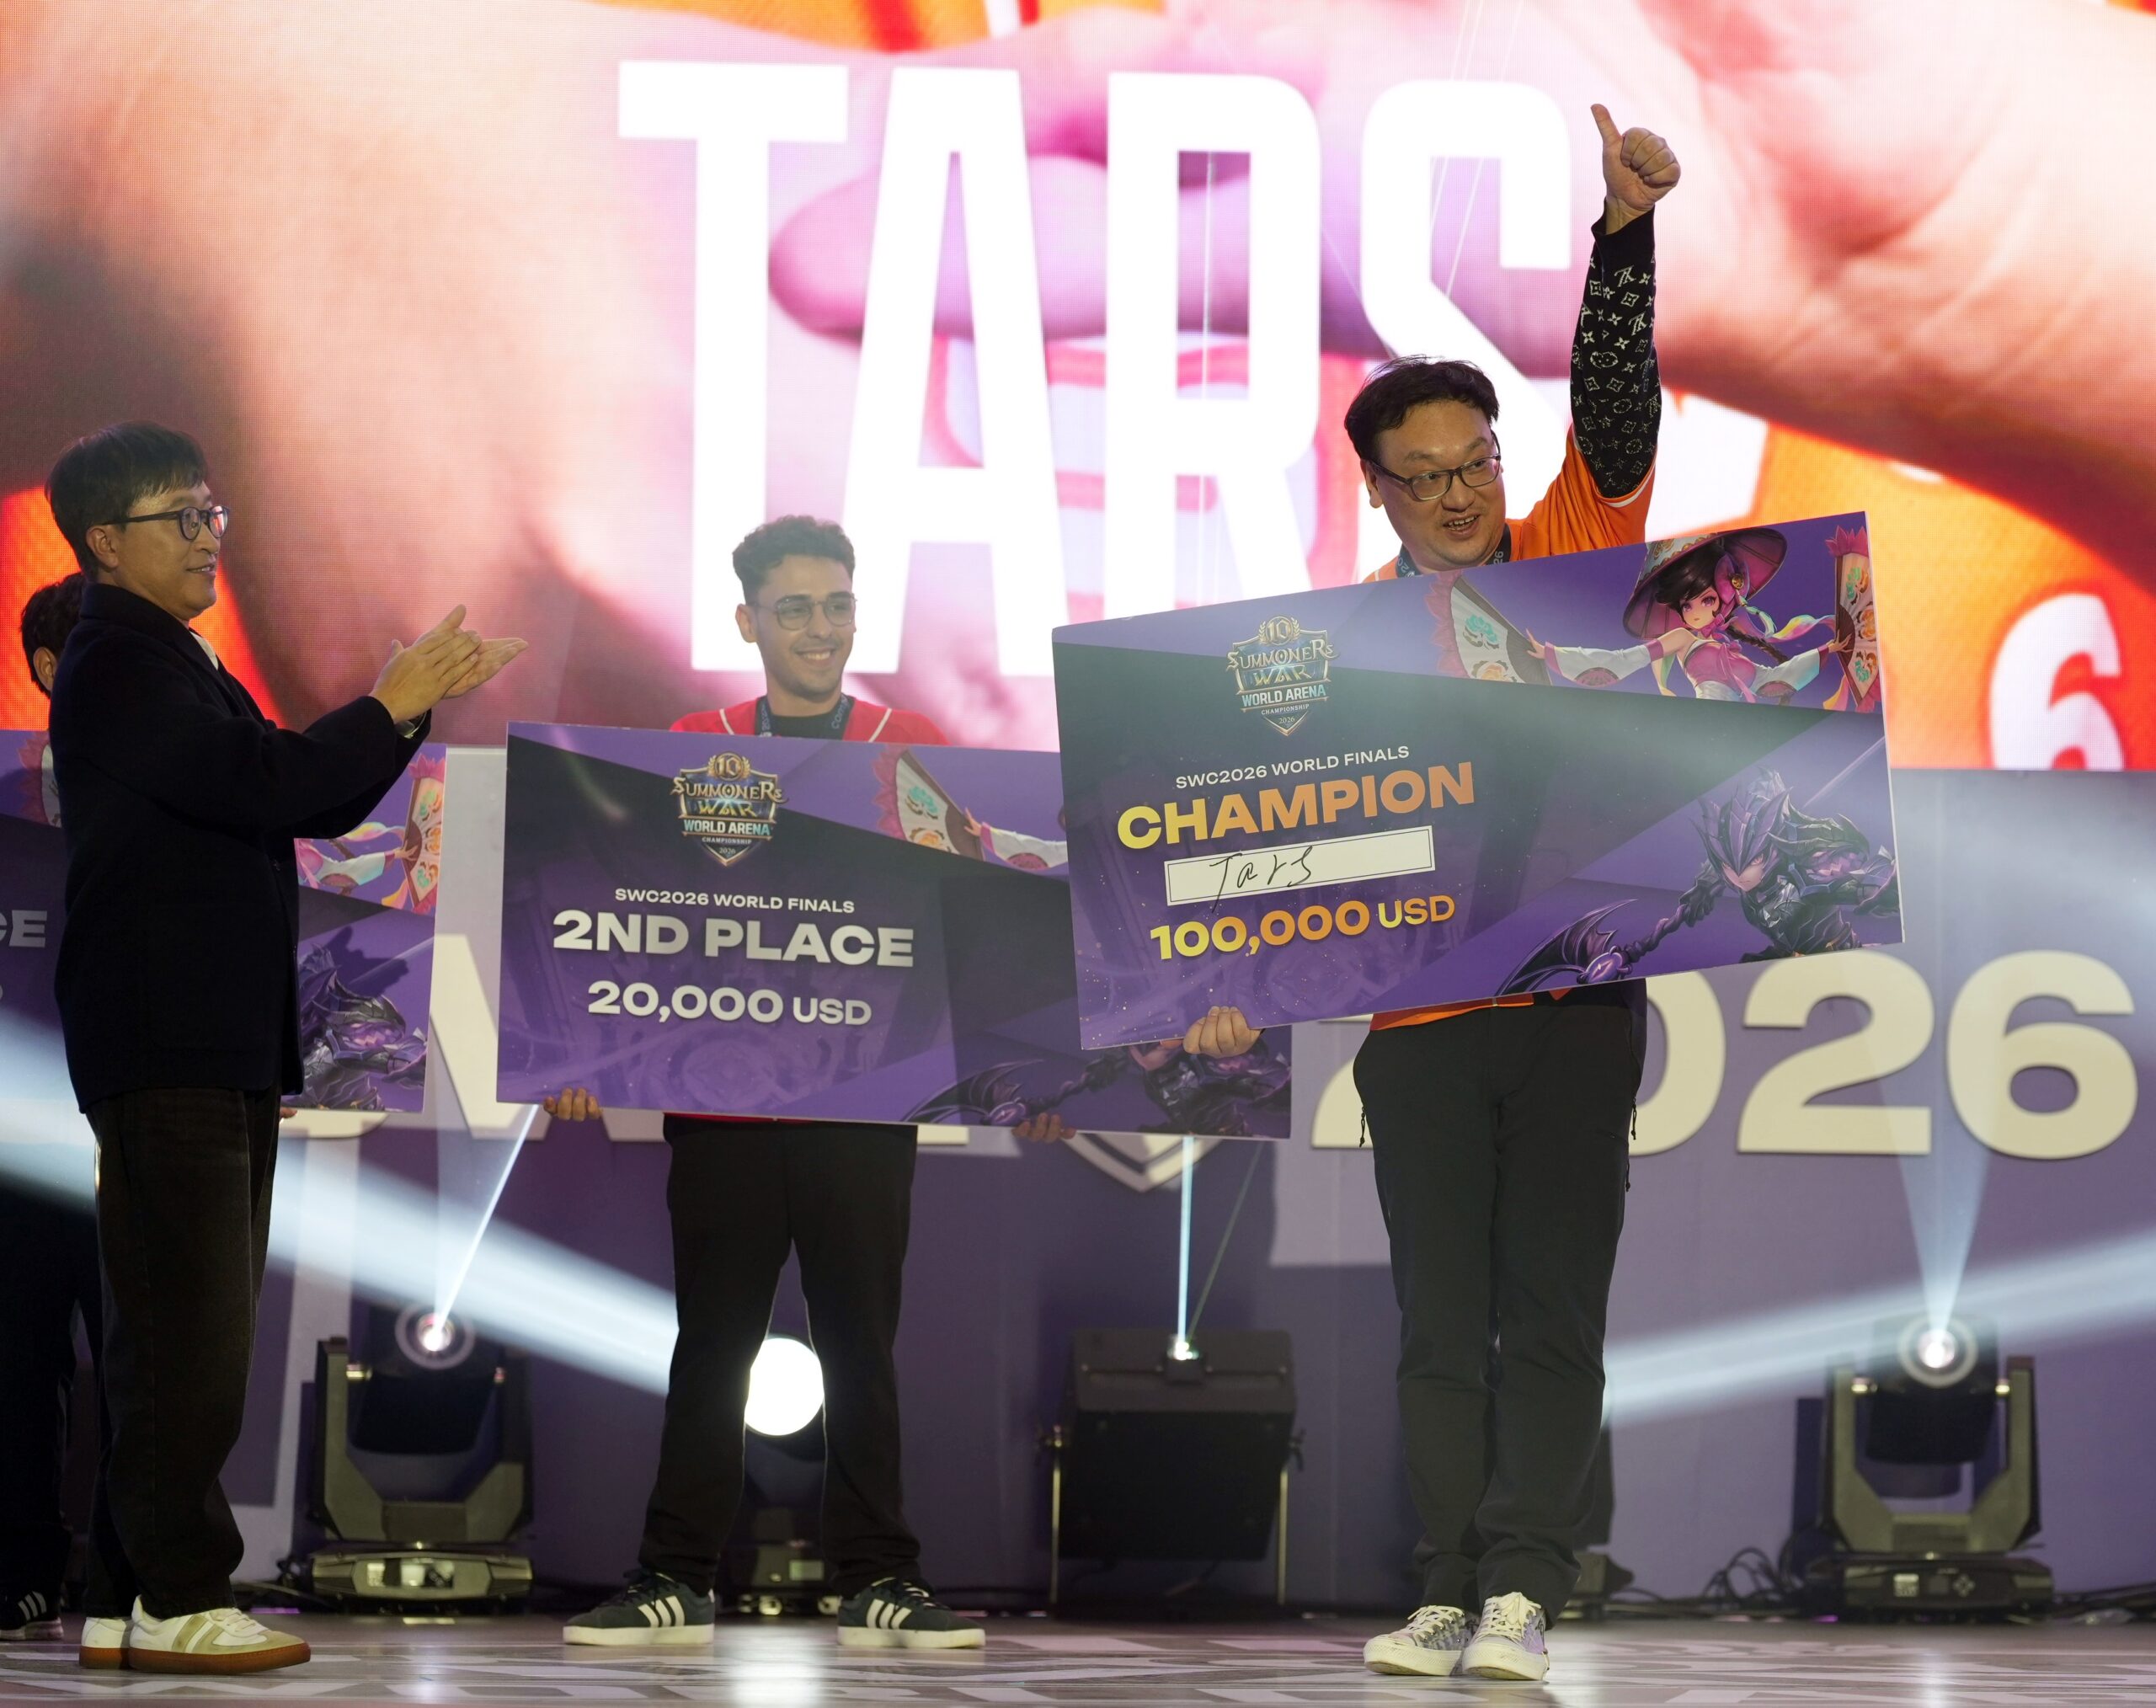
첫째는 우승자 기념 형상 변환이다. 우승자는 우승에 핵심 역할을 한 몬스터 1마리를 직접 고르고, ‘서머너즈 워’ 개발팀과 콘셉트와 디자인을 논의하며 형상 변환 제작에 참여한다. 완성된 형상 변환은 이후 별도 이벤트를 통해 모든 소환사에게 제공될 예정이다.
둘째는 우승자 한정 등장 이펙트다. 월드 아레나 랭킹전, 일반전, 스페셜 리그 전투에서 사용할 수 있다.
우승, 준우승, 공동 3위 선수에게는 월드 파이널 메달이 주어진다. 출전 선수 12명 전원은 인게임 재화와 채팅창 엠블럼을 받는다. 채팅창 엠블럼은 SWC2026 월드 파이널이 끝난 뒤부터 SWC2027 월드 파이널까지 적용된다.
12개 언어 생중계와 1,000만 회 넘은 전 세계 응원
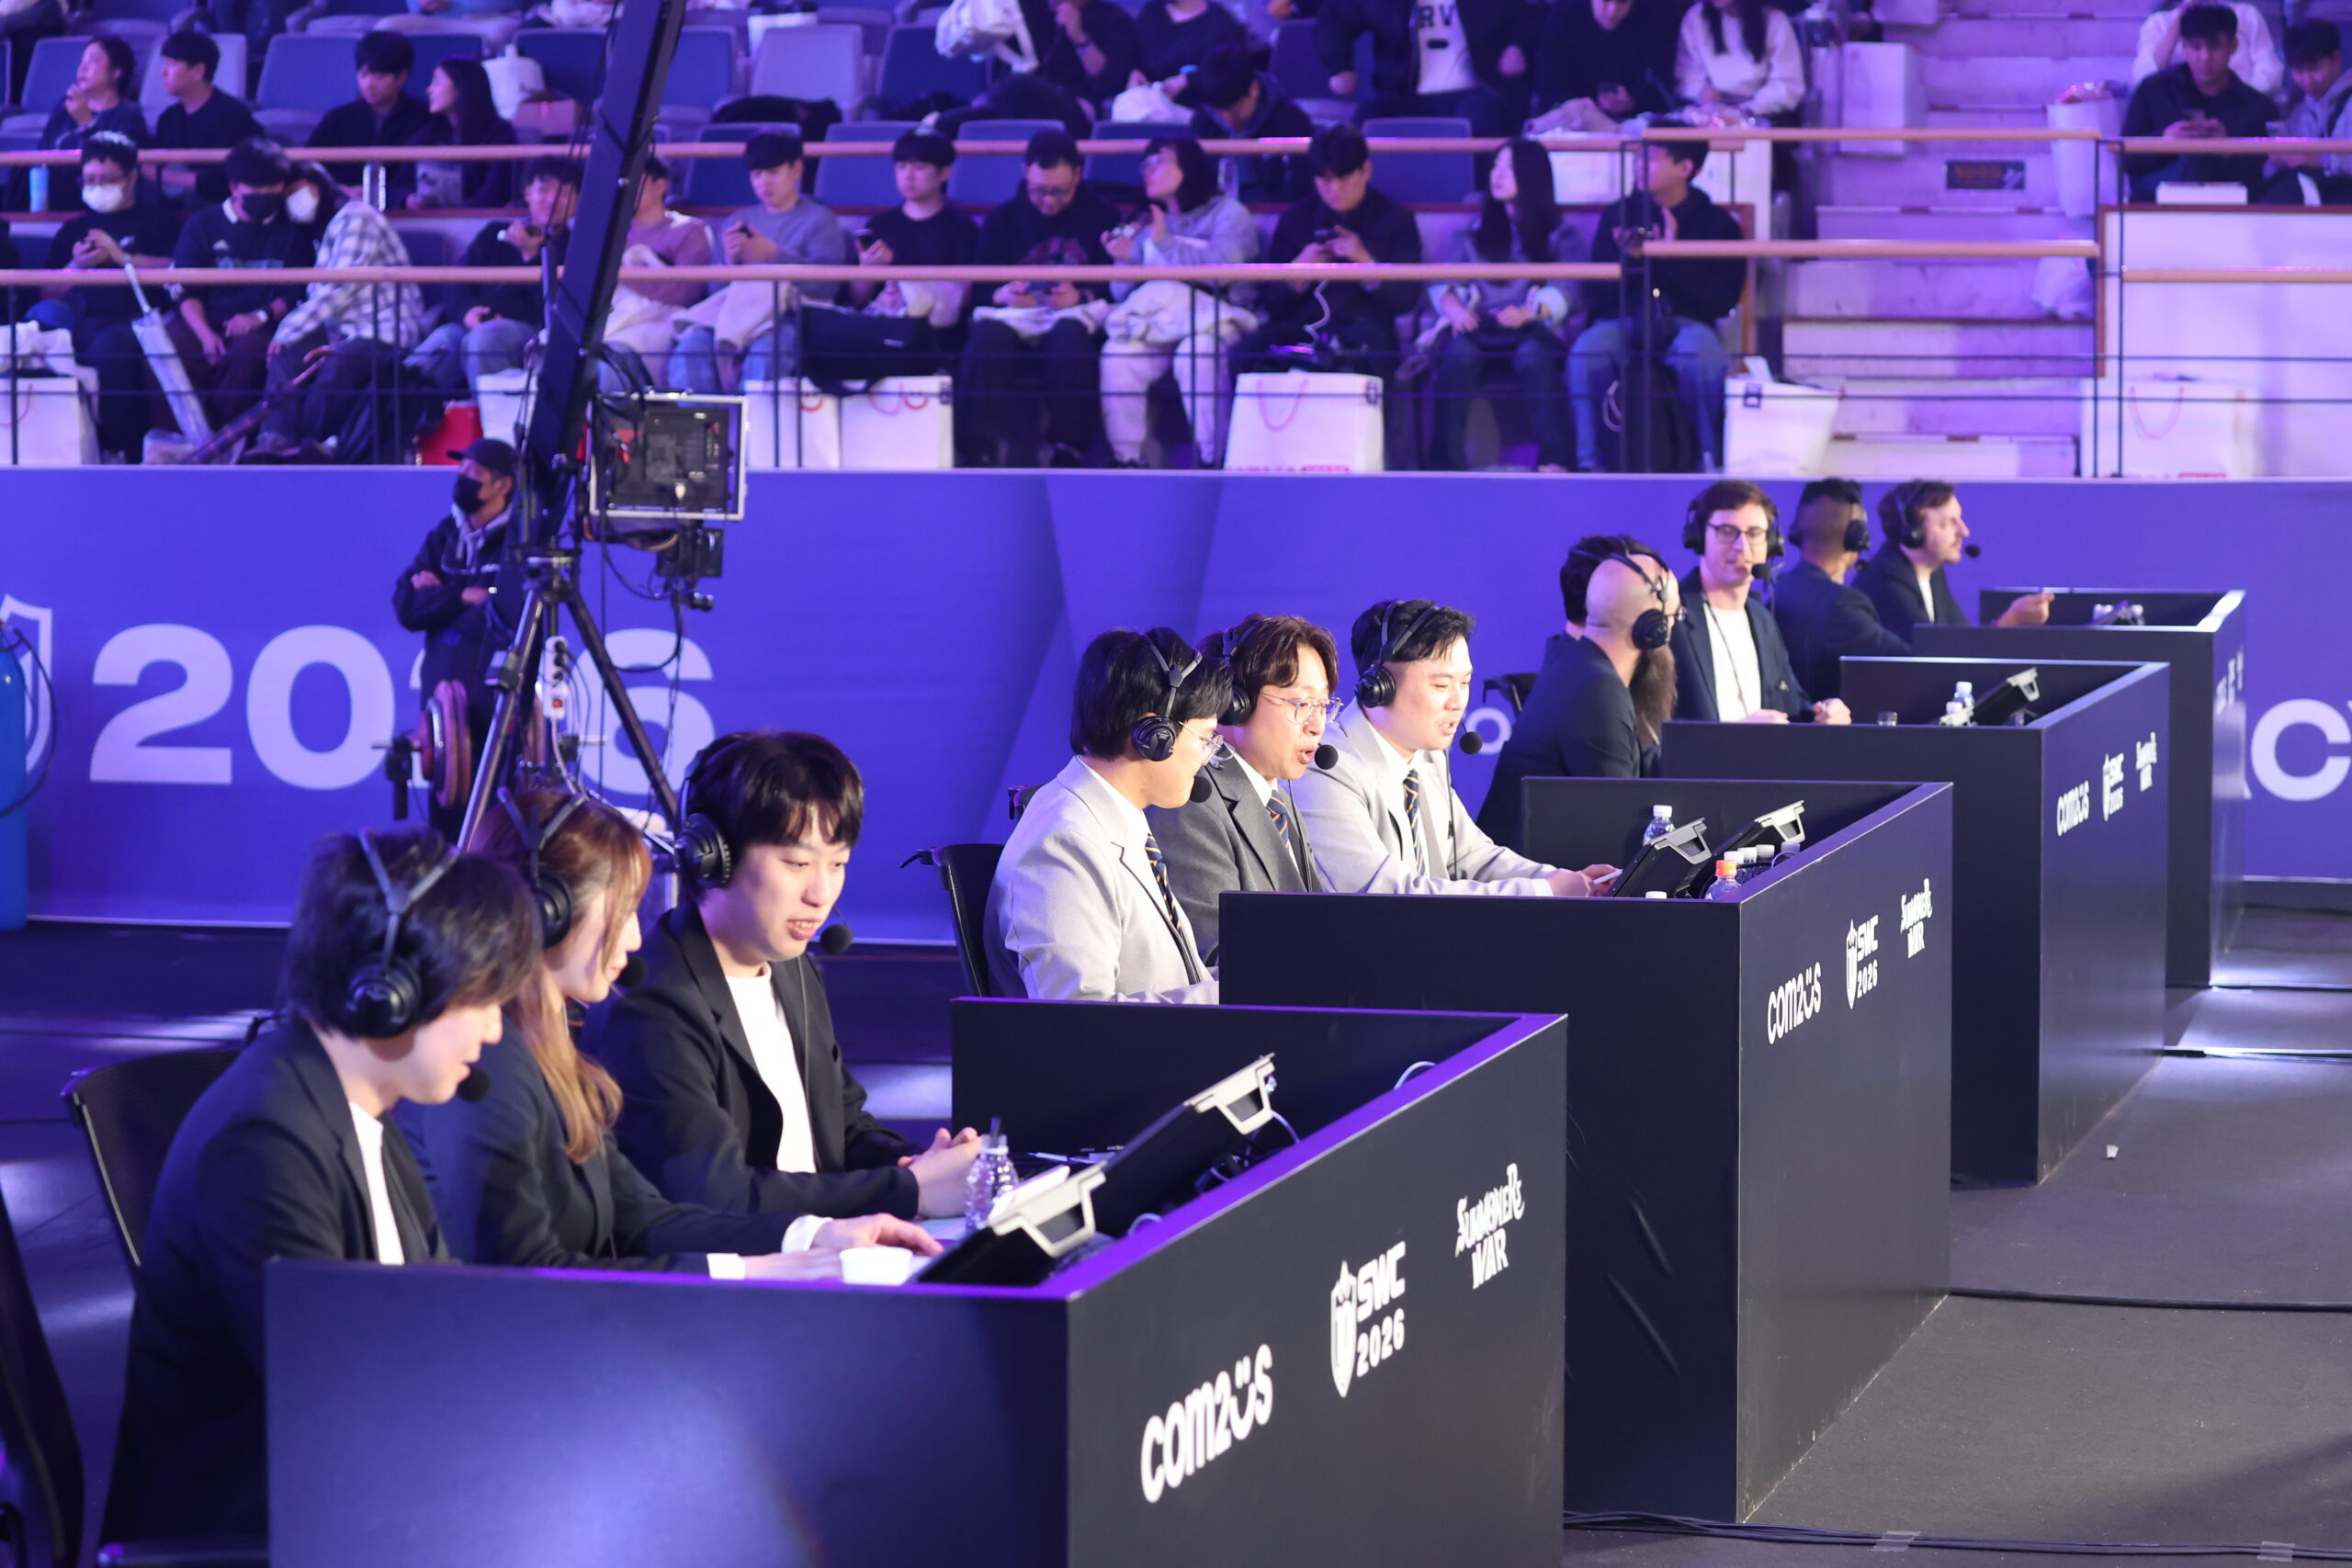
월드 파이널은 한국어, 영어, 일본어, 프랑스어 등 12개 언어 전문 해설과 함께 전 세계에 생중계됐다. 한국어 중계는 허준, 심양홍(Byunja), 찌숭이 맡았다. 온라인 시청자들은 실시간 댓글로 선수들을 응원했다.
인게임 ‘SWC2026 WORLD FINALS 기념! 출전 선수 응원 이벤트’에는 총 1,000만 회가 넘는 응원이 모였다. 최종 구간까지 달성되면서 모든 소환사가 아래 보상을 받는다. 룬, 아티팩트, 보석, 연마석은 종류가 무작위로 지급된다.
| 누적 응원 달성 구간 | 보상 |
|---|---|
| 200만 | 4★ 무지개몬(Lv.1)x2, 5★ 무지개몬(Lv.1)x1 |
| 400만 | 6★ 전설 등급 룬(종류 랜덤)x2, 전설 등급 아티팩트(종류 랜덤)x2 |
| 600만 | 전설 등급 마력이 깃든 보석(종류 랜덤)x2, 전설 등급 연마석(종류 랜덤)x2 |
| 800만 | SWC2026 휘장x200, 축복이 깃든 룬 상자(종류 선택)x1 |
| 1,000만 | 빛과 어둠의 소환서x1, 신비의 소환서x10 |
개인 누적 응원 횟수에 따른 데빌몬과 연성석 보상도 따로 받을 수 있다.
SWC2026 쿠폰 코드와 이벤트 보상 수령 기한
생중계 중 공개된 쿠폰 4종은 11월 22일 0시(KST)까지 사용할 수 있다. 21일 밤 자정에 끝나므로 미리 받아 두는 편이 좋다. 쿠폰은 11월 14일 0시(KST) 이전에 생성된 계정에서만 쓸 수 있다.
| 보상 | AOS 쿠폰 코드 | iOS |
|---|---|---|
| 에너지+200, 마나석+1,000,000, 신비의 소환서x5, SWC2026 휘장x20 | 20EOSEOOSEYOSWC26 | 쿠폰 받기 |
| 마나석+1,500,000, 신비의 소환서x10, SWC2026 조각상 – WORLD FINALSx1, SWC2026 휘장x30 | SWC1NTOTHELEG4CY | 쿠폰 받기 |
| 데빌몬x1, 연성석x2, SWC2026 WORLD FINALS 아레나 건물 기념스킨x1, SWC2026 휘장x50 | 10THCHAMPCOMEUP | 쿠폰 받기 |
| SWC2026 소환서x1, 크리스탈+200, SWC2026 휘장x150 | SWCLEGACYC0NTINUES | 쿠폰 받기 |
안드로이드에서는 게임 내 ‘이벤트 > 게임 가이드’ 탭의 ‘이벤트 쿠폰 교환소’에 코드를 입력하면 된다. 하이브 쿠폰 교환소에서도 쿠폰을 쓸 수 있다. ‘SWC2026 조각상 – WORLD FINALS’는 우편함에서 받은 뒤 천공의 섬에 설치할 수 있다.
승부 예측·출전 선수 응원 이벤트11월 18일 23시 59분(KST)까지
승리를 향해! SWC2026 휘장의 길 이벤트11월 21일 23시 59분(KST)까지
SWC2026 소환서, 전설의 전속성 소환서, 빛과 어둠의 소환서, 데빌몬 등이 보상으로 걸려 있다. 참여 내역과 달성 조건에 따라 보상이 다르므로 기한 안에 이벤트 페이지에서 확인해야 한다.
SWC2026 월드 파이널 다시 보기
SWC2026 월드 파이널 전 경기는 ‘서머너즈 워’ e스포츠 공식 유튜브 채널에서 다시 볼 수 있다. TARS의 4대 0 결승전도 처음부터 확인할 수 있다.
지난 10년간 SWC를 채운 것은 ‘서머너즈 워’를 즐겨 온 전 세계 소환사들의 응원이었다. 앞으로도 ‘서머너즈 워: 천공의 아레나’에 많은 관심과 성원을 부탁드린다.
ⓘ 확률형 아이템 포함
개발자의 하루가 코드 작성만으로 채워지지는 않는다. 여러 문서에 흩어진 요청을 읽고, 낯선 프로그램의 동작을 파악하고, 수정한 내용을 다른 사람에게 설명하는 일도 개발자의 몫이다. 코드가 빨리 만들어지더라도 이런 과정이 그대로 남아 있다면 일은 생각만큼 가벼워지지 않는다.
필자는 이 ‘코드 밖의 일’에도 AI를 연결해봤다. 업무 요청을 정리해 구현과 검토로 이어가고, 문의에 답할 근거를 모으고, 복잡한 코드의 흐름을 그림으로 살펴보는 식이다. 매번 정보를 찾아 옮기던 수고를 덜면 무엇을 바꿔야 하는지, 결과가 제대로 나왔는지를 살피는 데 더 집중할 수 있다.
AI로 반복되는 일만 줄인 것은 아니다. 개인 시간에는 예전에 즐기던 게임을 직접 만들어보기도 했다. 만들고 싶다는 생각으로만 남겨뒀던 게임을 실제로 움직여보고, 어긋난 부분을 고치며 다음 장면을 만들어가는 경험이었다.
이렇게 써보면서 관심사도 달라졌다. 어떤 AI가 코드를 더 잘 만드는지와 함께, 내가 하던 일의 어디에 AI를 연결해야 수고가 줄고 새로운 시도가 가능해지는지를 보게 됐다. 이 글에서는 그 과정에서 찾은 활용법을 소개한다. 도구의 기능을 나열하기보다 어떤 일을 맡겼는지, 무엇을 직접 확인했는지, 기존 방식과 무엇이 달라졌는지를 중심으로 정리했다.
jira-auto-agent 일감을 선택하고 웹에서 구현·검증 결과를 받아보기
필자가 만든 jira-auto-agent는 Jira 일감을 선택해 실행하면 코드 수정부터 검증과 검토 자료 준비까지 이어지도록 구성한 로컬 웹 도구다. Jira와 저장소, 사용할 Codex 또는 Claude Code를 연결해두면, 웹 화면에서 작업을 시작하고 진행 상태와 결과를 확인할 수 있다.
도구는 Jira의 설명과 댓글, 관련 코드를 바탕으로 작업 명세를 준비한다. 빠진 조건이나 중요한 선택이 있으면 구현 전에 확인하고, 기준이 정리되면 연결된 코딩 에이전트의 구현과 테스트를 이어 진행한다. 작업이 끝나면 변경 내용과 실제 검사 결과, 남은 확인 사항을 웹 화면에 모아 보여준다. 화면 변경 작업의 전후 비교도 함께 살펴볼 수 있다.
이렇게 연결하면서 줄이려 한 것은 각 단계의 결과를 가져와 다음 도구에 다시 전달하는 수고였다. 일감을 선택해 시작한 작업이 검토할 자료로 돌아오도록 만든 것이다. 설정에 따라 초안 PR·MR 생성과 Jenkins 테스트 배포까지 이어지며, 개발자는 확인이 필요한 조건과 최종 결과의 검토에 집중할 수 있다.
“검색 화면에 조건 하나만 추가해주세요.”
짧은 요청이지만 실제로 손을 대려면 확인할 것이 여럿이다. 어떤 조건인지, 기존 검색 방식은 유지해야 하는지, 검색 결과를 파일로 내려받을 때도 같은 조건을 적용해야 하는지 살펴야 한다. 요청은 한 문장이어도 그 안에 담긴 일은 하나가 아닐 수 있다.
수정이 끝났다는 답변을 받으면 반갑지만, 곧 궁금한 점이 생긴다. 실제로 실행해봤는지, 요청한 부분만 바뀌었는지, 아직 확인하지 못한 내용은 없는지다. 그래서 AI가 작성한 완료 설명과 실제 테스트 결과를 따로 기록했다. 필요한 검사가 실패하면 변경 내용을 저장소 이력에 남기는 작업도 자동으로 진행되지 않게 했다.
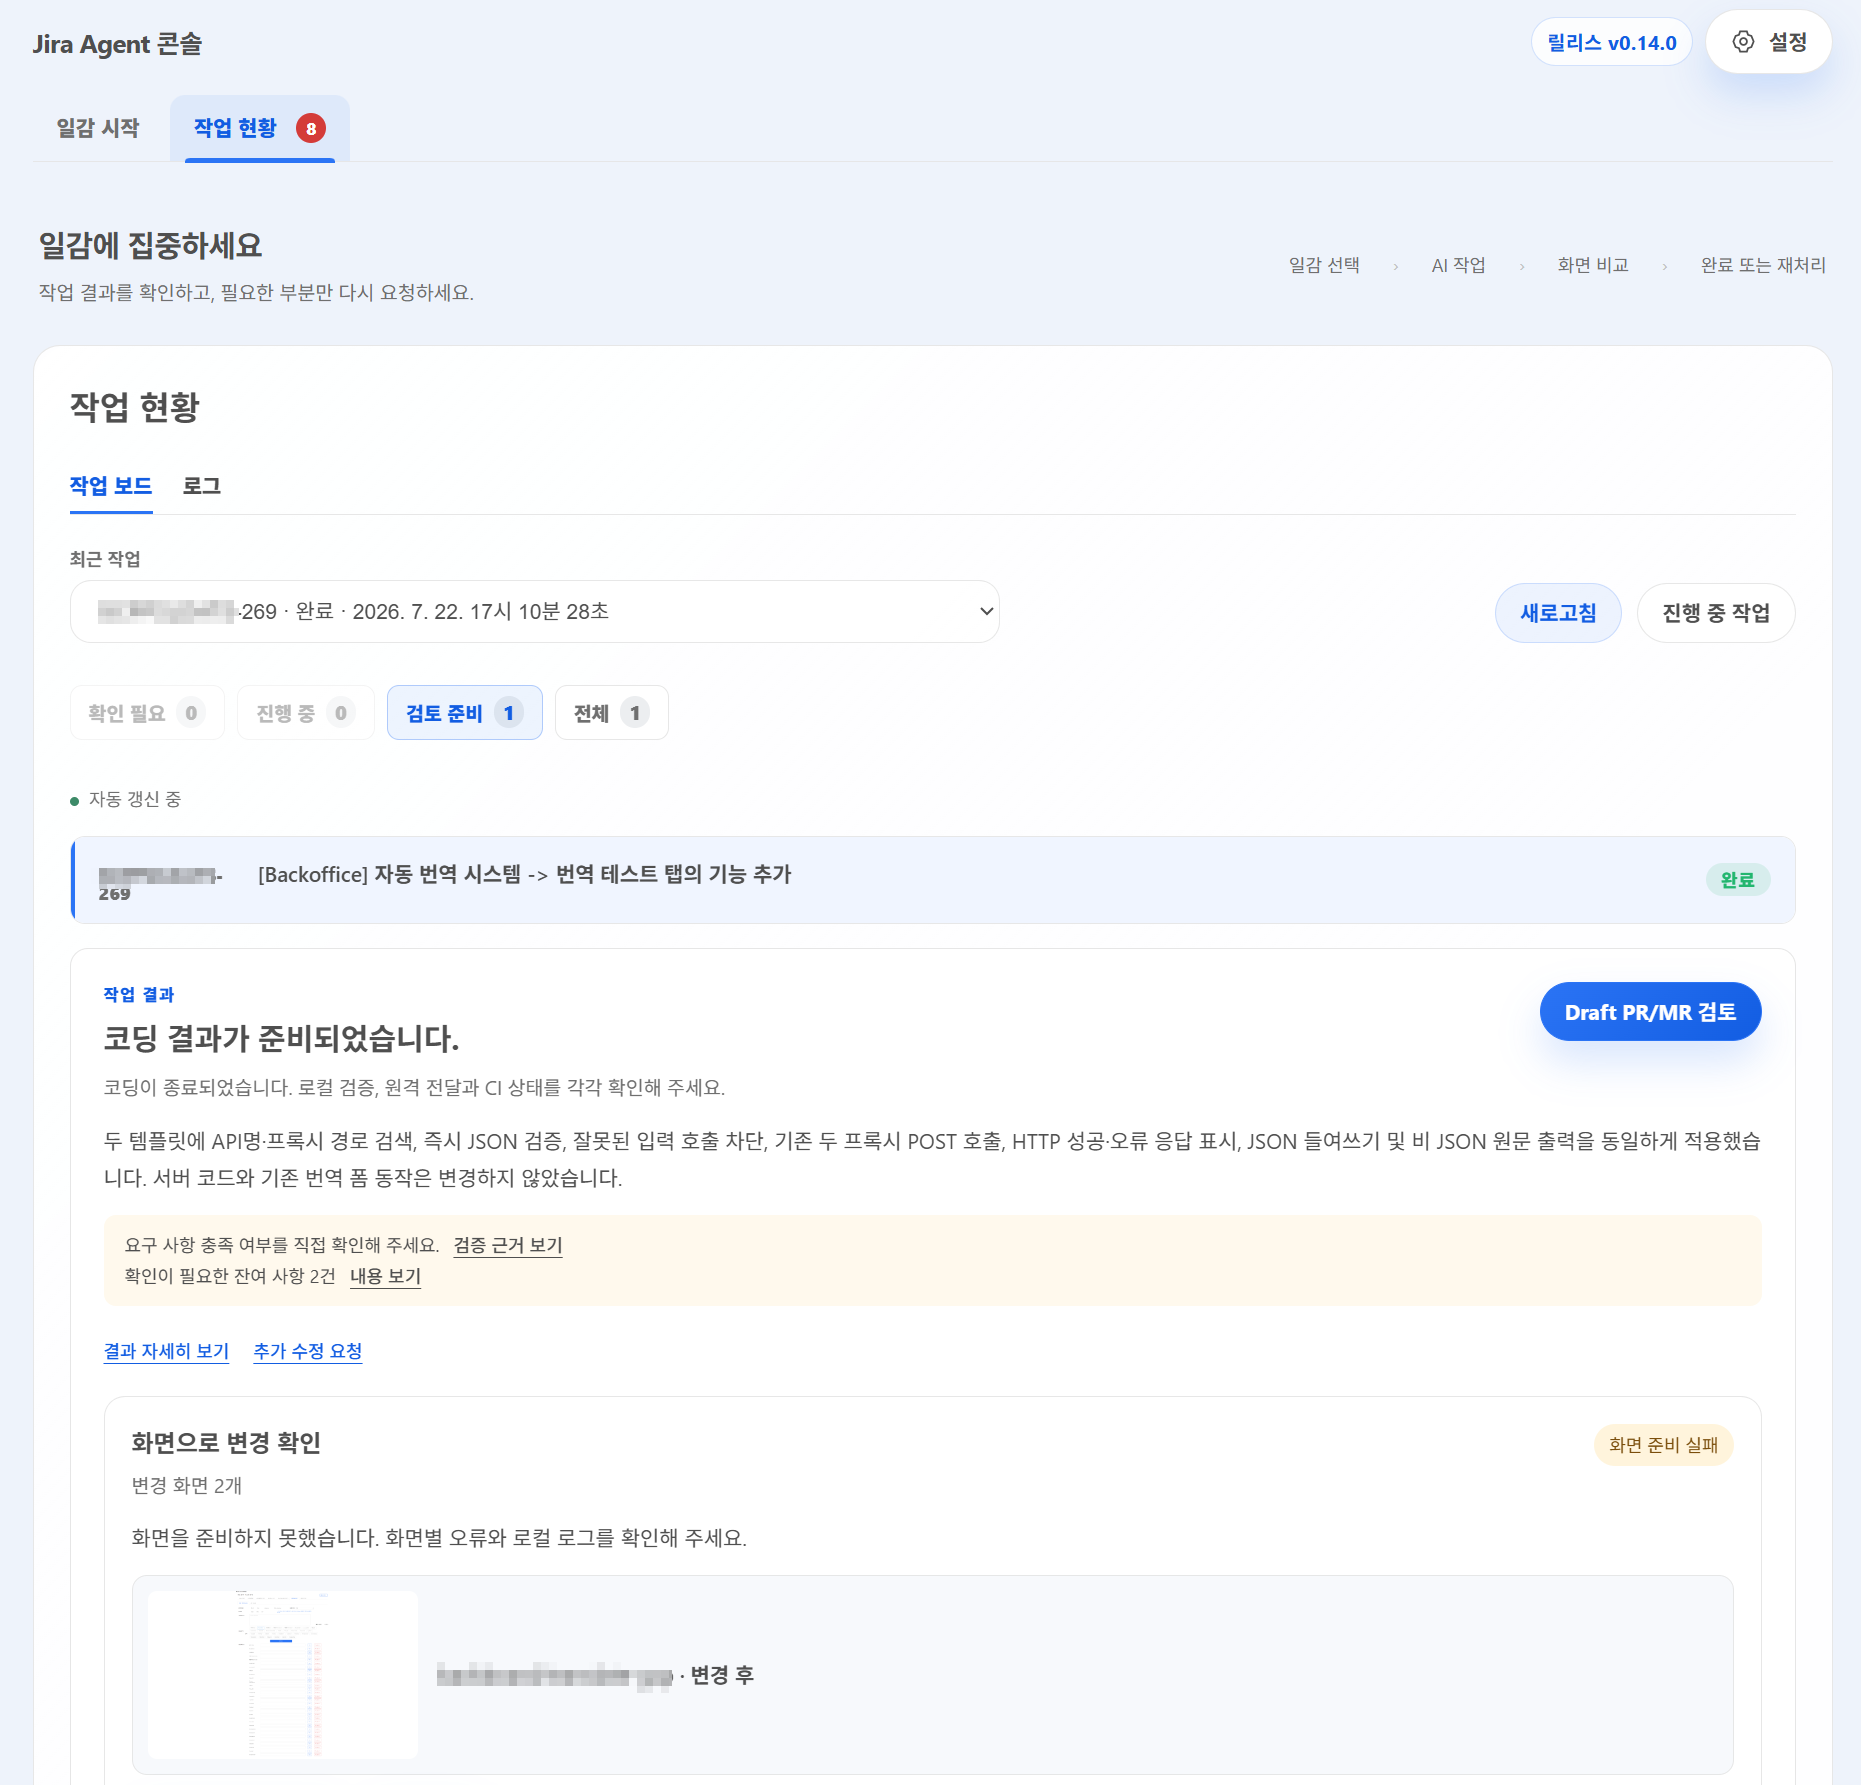
화면이 바뀌는 작업은 변경 전후 모습을 나란히 비교한다. 내부에서 일어나는 변화는 아키파이(Archify)를 연결해 그림으로 정리했다. 아키파이는 코드나 설명을 바탕으로 프로그램의 구조와 처리 순서를 시각화하는 공개 도구로, jira-auto-agent 안에서는 작업 흐름과 변경 전후 구조를 그림으로 보여주는 역할을 맡는다. 코드 수정과 테스트, PR·MR 생성은 필자가 만든 도구와 여기에 연결된 개발 도구들이 담당한다.
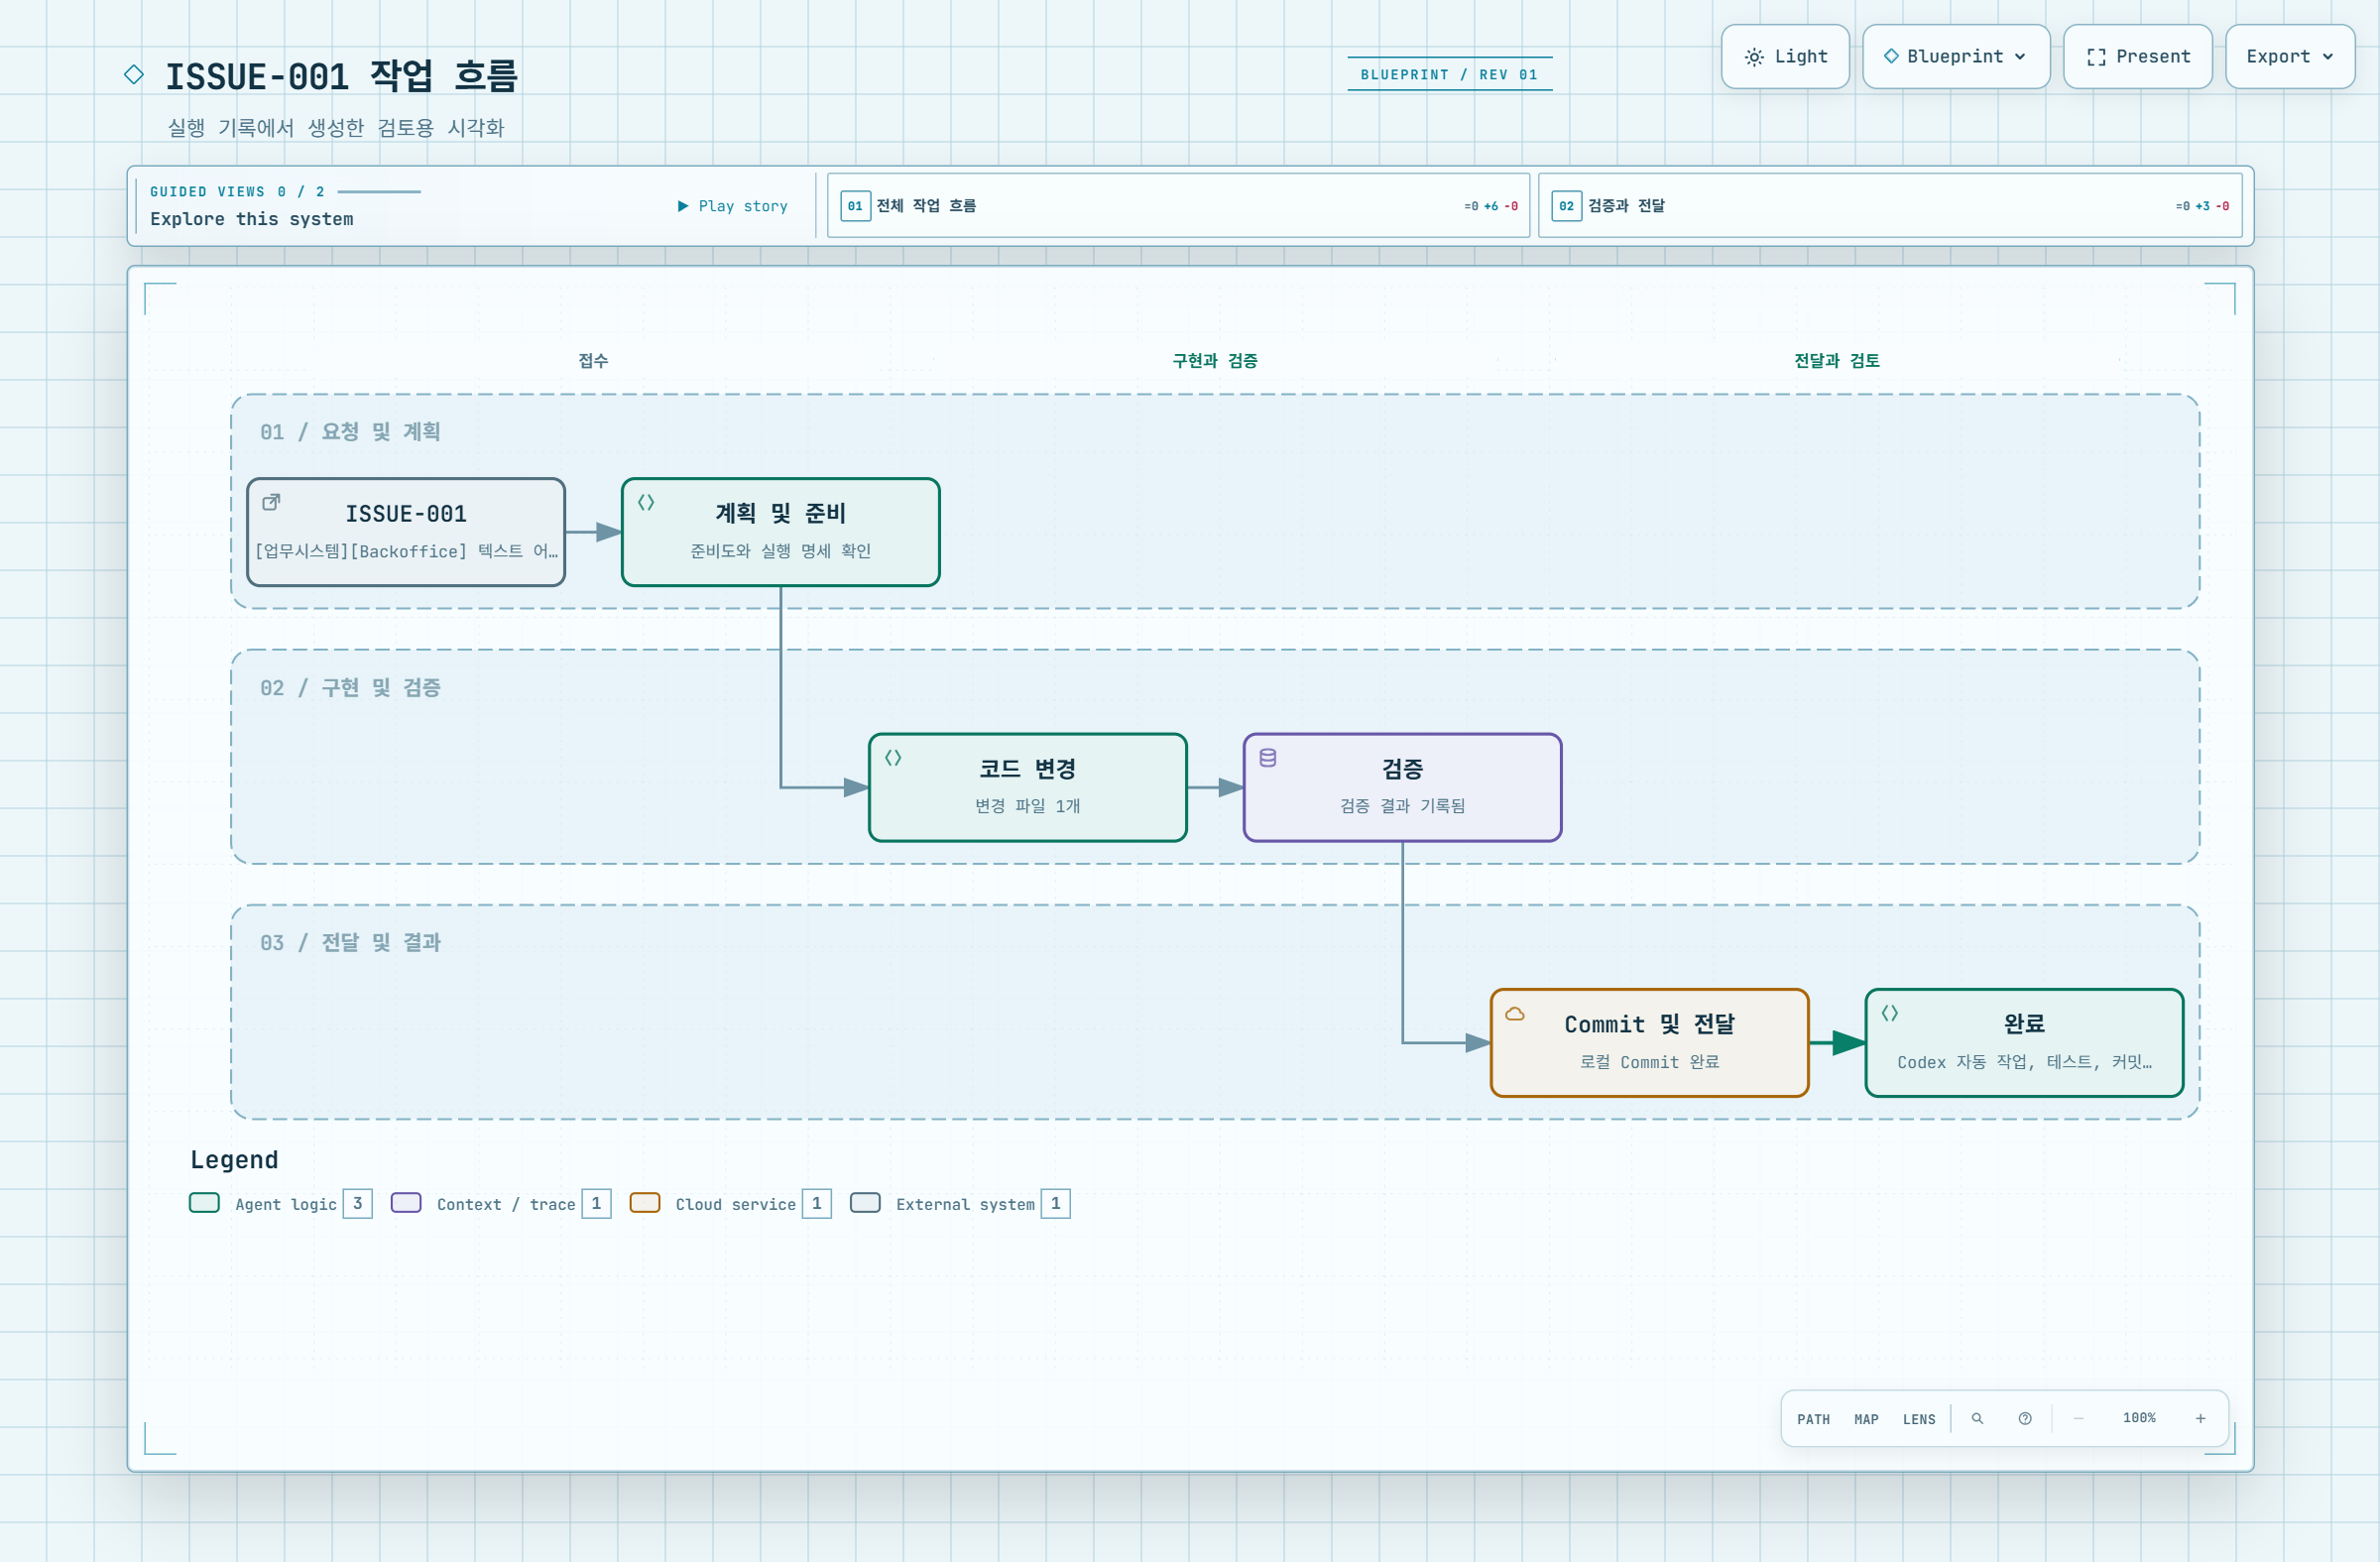
코드를 작성한 사람에게는 익숙한 연결도 처음 검토하는 사람에게는 낯설 수 있다. 파일 이름만 여러 개 나열돼 있으면 어디부터 읽어야 할지 잠시 멈추게 된다. 이때 전체 흐름을 보여주는 그림이 있으면 큰 구조를 먼저 파악한 뒤 자세히 확인할 코드로 들어가기 수월하다. 다른 사람에게 수정 내용을 설명할 때도 같은 그림을 놓고 이야기를 시작할 수 있다.
물론 그림이 잘 그려졌다고 프로그램이 제대로 동작한다는 뜻은 아니다. 앞의 검색 기능이라면 화면에 입력 항목이 생겼는지만 볼 것이 아니라, 검색 결과와 내려받은 파일에도 같은 조건이 적용되는지 확인해야 한다. 구조도와 테스트 결과는 처음 요청한 내용이 실제로 반영됐는지 살펴보는 자료로 쓴다.
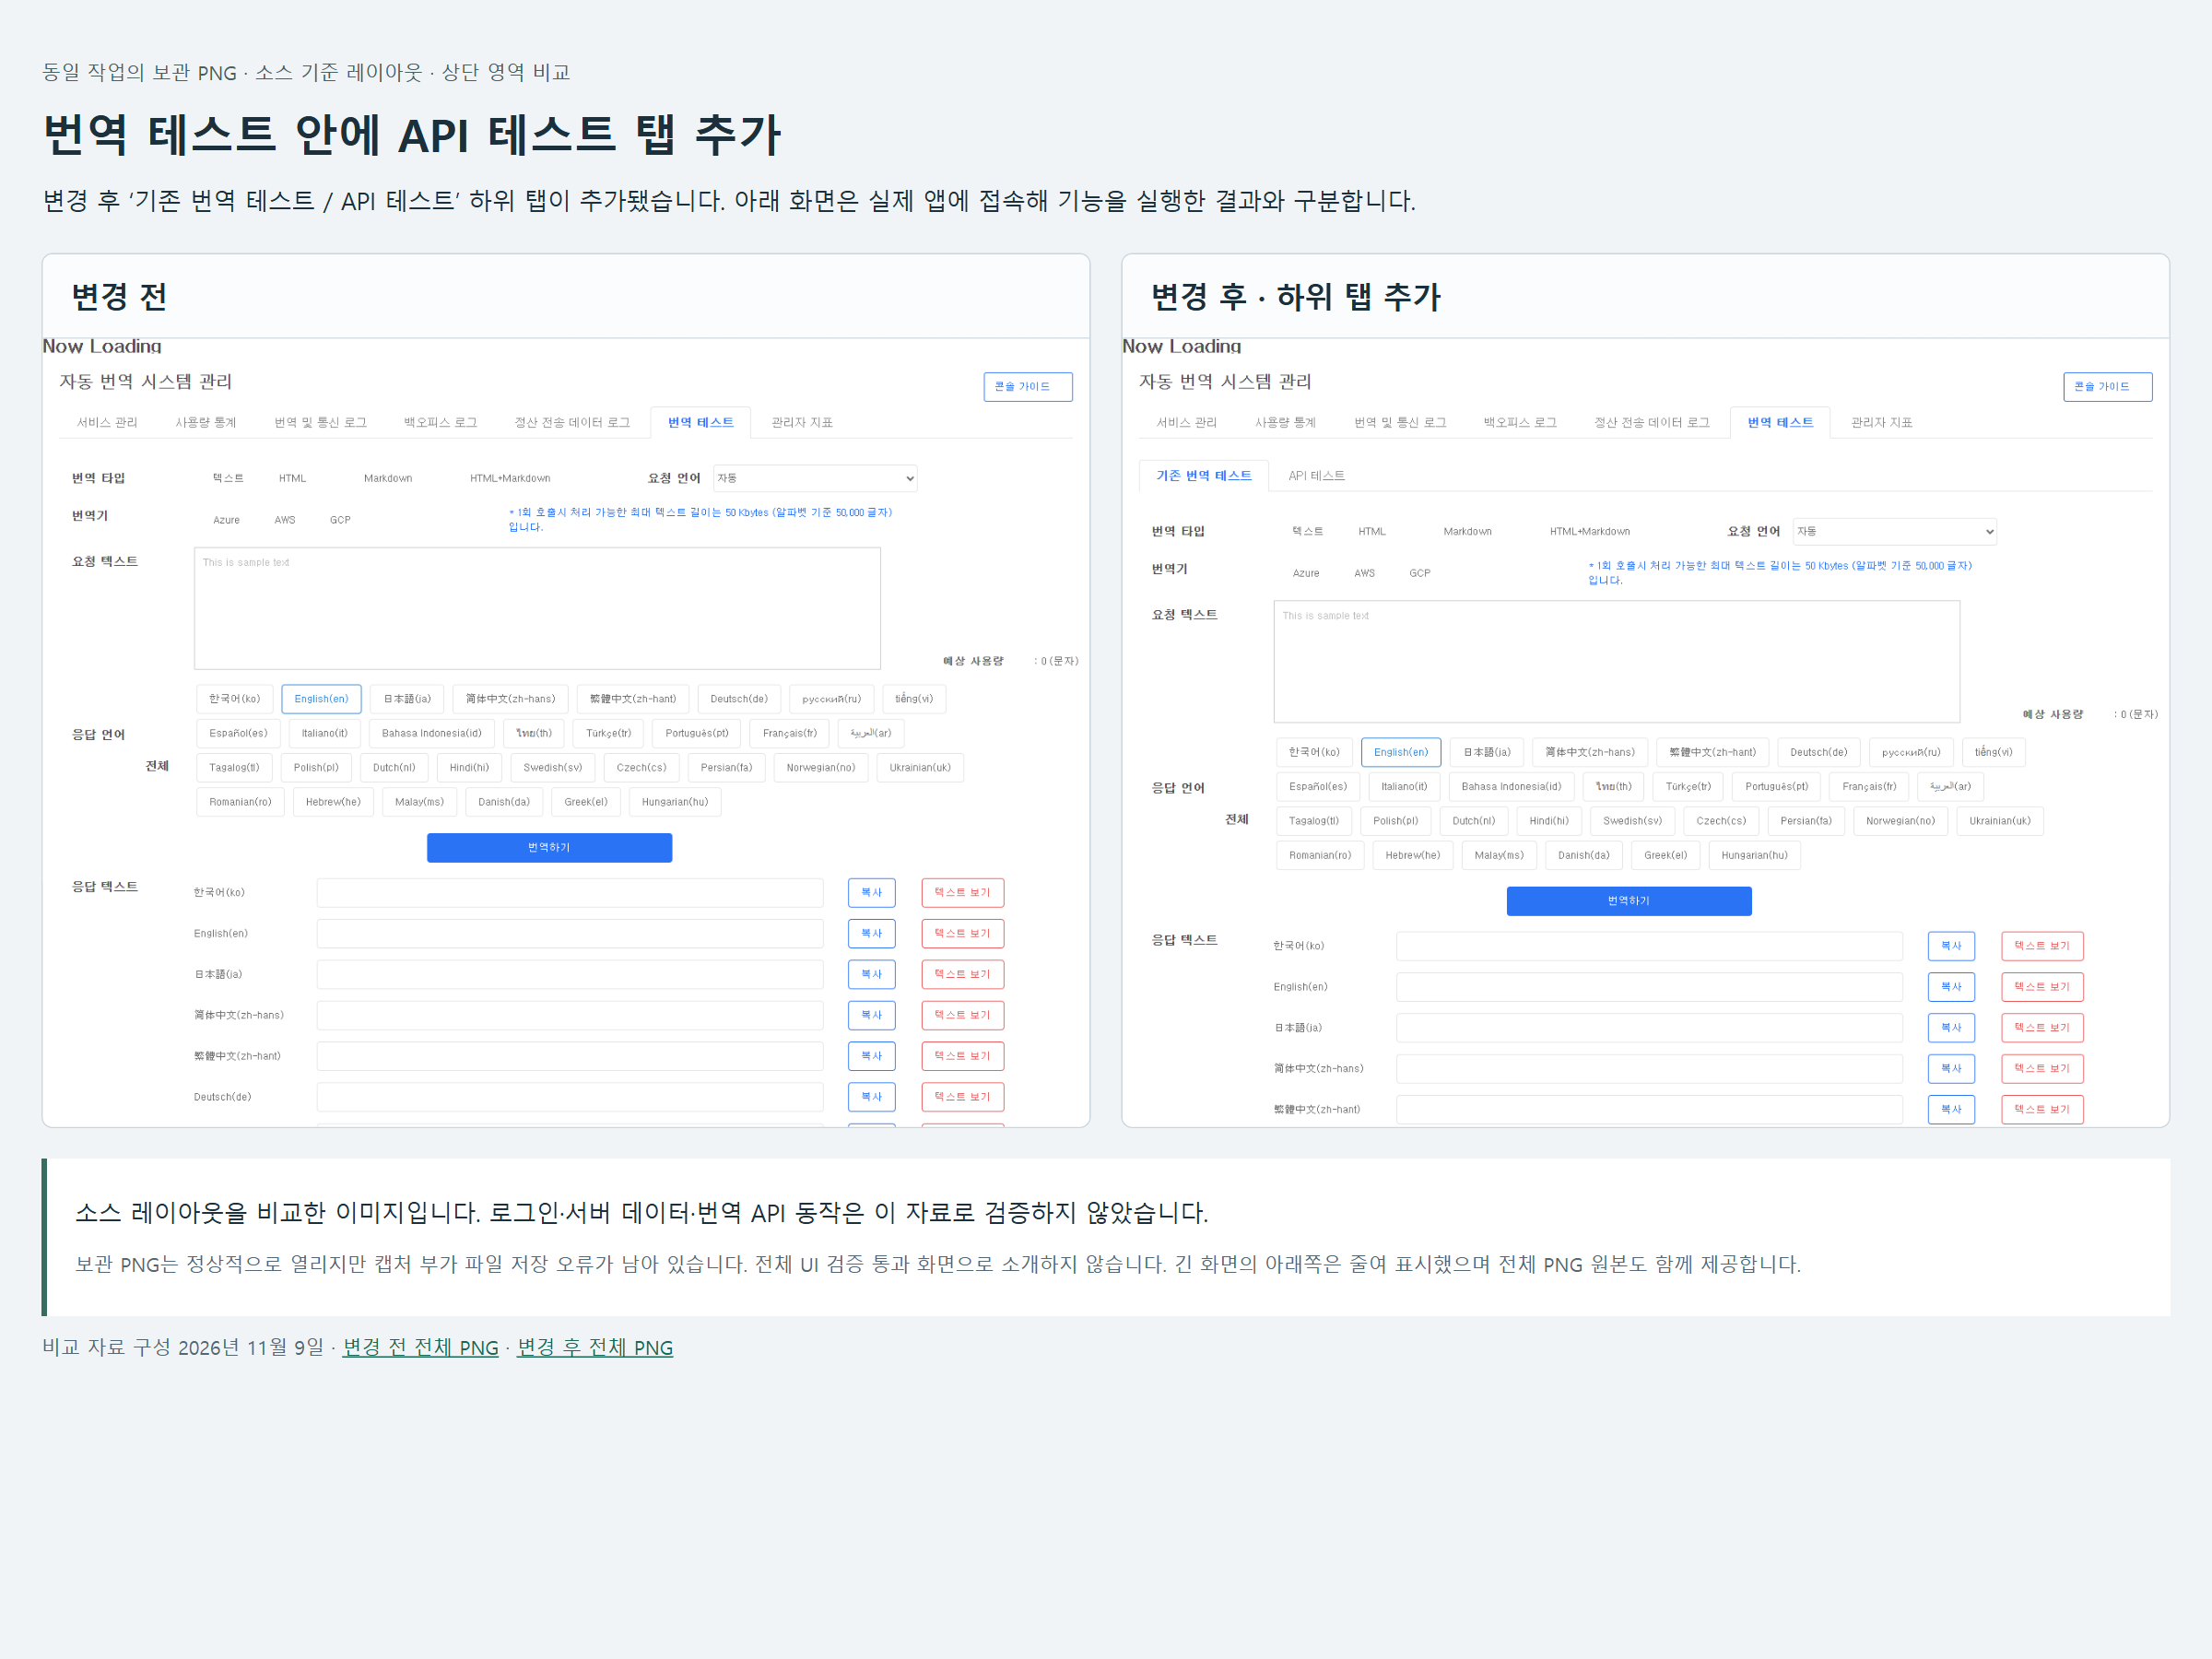
필요하면 초안 PR·MR 생성까지 이어진다. 초안 상태로 먼저 공유한 뒤, 준비가 끝나면 정식 검토를 요청하는 방식이다.
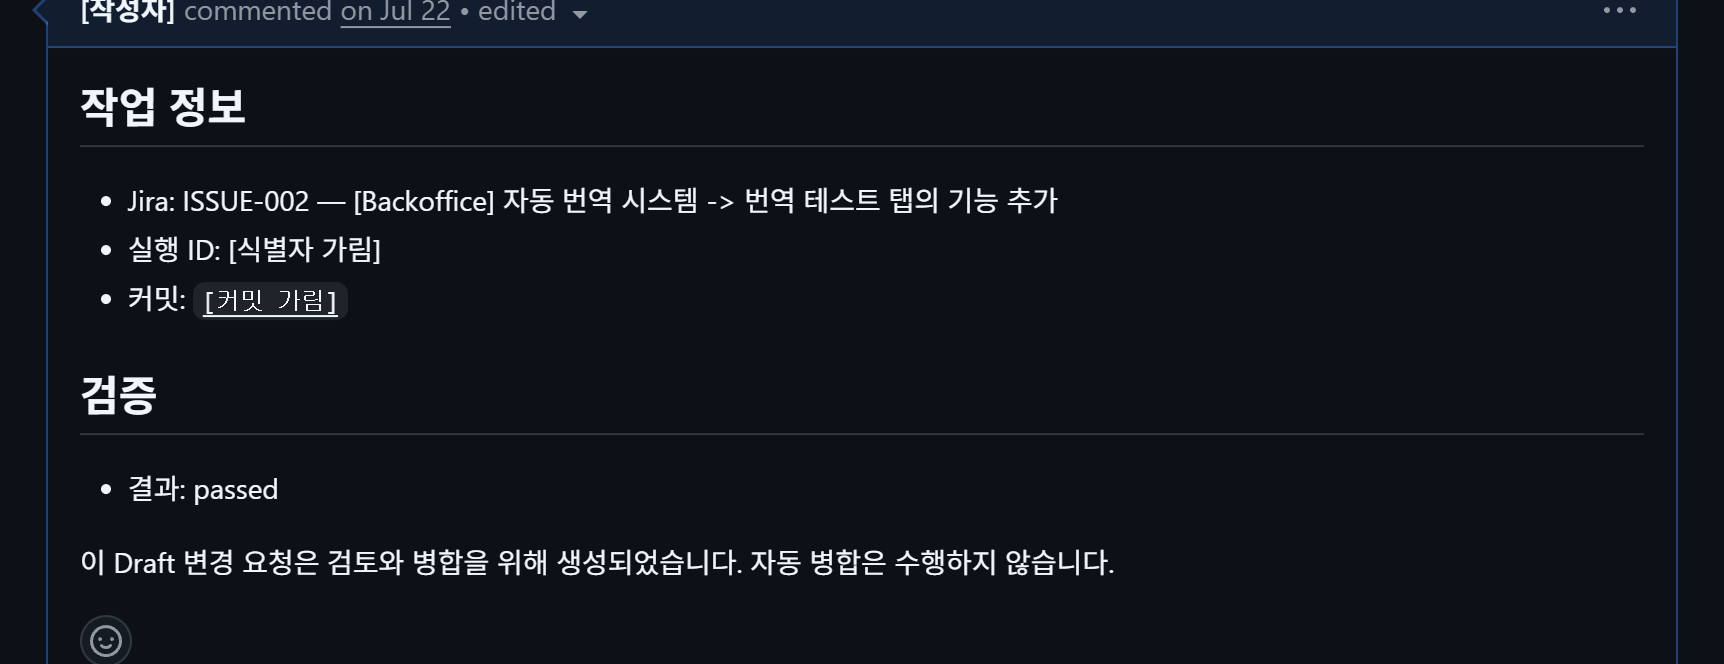
완료 상세 화면에는 변경 내용과 테스트 결과, 남은 확인 사항이 함께 정리되고 초안 PR·MR 본문에는 작업 정보와 검증 상태가 남는다. 검토자는 필요한 자료를 처음부터 다시 모으지 않고 준비된 내용을 확인하는 데서 시작할 수 있다. 설정에 따라 Jenkins를 이용한 테스트 배포도 가능하다. 실제 서비스 반영과 운영 배포는 별도의 검토와 승인을 거쳐 진행한다.
필자는 이 도구를 실제 업무에 10여 회 적용했다. 중복 실행과 재시도를 합산한 시스템 실행 횟수가 아니라, 업무 단위로 센 대략적인 적용 횟수다. 써보면서 달라진 점은 작업 명세, 변경 내용, 검증 결과와 화면 비교를 한 도구에서 모아 보게 됐다는 것이다. 어떤 요청에서 시작해 무엇을 바꿨고 어디까지 확인했는지를 차례로 따라갈 수 있었다.
기대와 다르게 흘러간 작업도 있었다. 번역 테스트 화면을 수정할 때 AI가 코드를 전혀 바꾸지 못한 채 끝난 적이 있다. 실행 기록에는 미리 전달한 코드에서 필요한 부분이 잘려 있었고, 파일을 다시 읽지 못하게 한 제약 때문에 안전하게 수정할 수 없었다는 설명이 남아 있었다. 실제로 변경된 파일도 없었다. 작업을 맡기는 쪽에서 필요한 맥락을 충분히 주고 있는지부터 점검해야 했다.
코드를 수정한 뒤 검증 단계에서 멈춘 사례도 있었다. AI가 ‘Git 변경 내역을 확인하지 못했다’고 보고한 내용을 도구가 ‘코딩 규칙 위반’으로 처리하면서 테스트와 자동 커밋이 중단됐다. 검증을 마치지 못한 이유가 화면에는 다른 문제로 표시된 셈이다. 이 일로 실패 표시만 볼 것이 아니라, 어느 단계에서 무엇 때문에 멈췄는지 확인할 수 있어야 한다는 점을 배웠다.
이 과정을 거치며 작업을 끝냈다고 보는 기준도 바뀌었다. 코드가 만들어진 상태에서 멈추지 않고, 다음 사람이 검토할 수 있는 상태까지 준비하는 것이다. 구현 속도와 함께, 다음 사람이 일을 이어받기까지 드는 수고도 줄이고 싶었다.
FocusDesk와 Aside로 답변에 필요한 근거 모으기
“이 기능은 이미 적용됐나요?”
Jira에는 ‘완료’라고 적혀 있는데, 안내 문서를 열어보니 ‘다음 배포에 반영 예정’이라고 쓰여 있다. 이런 상황이라면 어느 쪽이 맞는지 바로 답하기 어렵다. 개발 작업이 끝났다는 말과 사용자가 실제로 이용할 수 있다는 말은 서로 다른 상태를 가리킬 수 있기 때문이다.
이런 일은 개발 업무에서만 생기지 않는다. 회의에서 정한 계획과 이후 진행 상황이 서로 다른 문서에 나뉘어 있을 때도 마찬가지다. 답변은 한두 문장이면 충분한데, 그 답을 확인하려고 여러 화면을 오가야 한다.
필자는 이 자료 조사 과정을 줄이려고 업무 문의 지원 도구 FocusDesk를 만들고 Aside를 연결했다. 두 도구는 서로 별개다. 사용자의 AI가 허용된 자료를 조회하면 FocusDesk가 답변 후보와 확인한 사실, 원문 근거, 추가 확인 사항을 모아 보여준다. Aside는 기존에 로그인된 업무 화면에서 자료를 읽는 통로로 활용했다. 연결에는 AI 도구와 브라우저가 필요한 작업을 주고받을 수 있게 해주는 MCP(Model Context Protocol)를 사용했다.
문의가 들어오면 FocusDesk가 먼저 확인할 내용을 정리하고, 그중 로그인된 업무 화면을 직접 살펴봐야 하는 부분을 Aside에 맡긴다. 화면을 찾아 들어가 확인해야 하는 일을 보완하는 용도다.
결과 화면에는 답변 후보와 확인된 내용, 원문 링크, 추가로 확인할 사항이 함께 모인다. 앞의 질문이라면 개발이 완료됐다는 근거와 실제 서비스에 반영됐다는 근거를 나눠 보고, 서비스 반영 근거를 확인할 수 없으면 그 부분을 따로 남겨두는 식이다.
사용하면서 유용했던 점도 이 부분이었다. 답변 후보를 읽다가 궁금한 내용이 있으면 연결된 원문을 확인하고, 근거가 부족하거나 자료끼리 내용이 다른 부분은 따로 살펴볼 수 있었다. ‘작업이 끝났다’는 기록과 ‘운영에 반영됐다’는 기록을 구분해 보니 어디까지 답할 수 있고 무엇을 더 물어봐야 할지 판단하기가 수월했다. FocusDesk는 답변에 필요한 자료를 모으고, 필자가 직접 확인할 부분을 짚어주는 용도로 썼다.
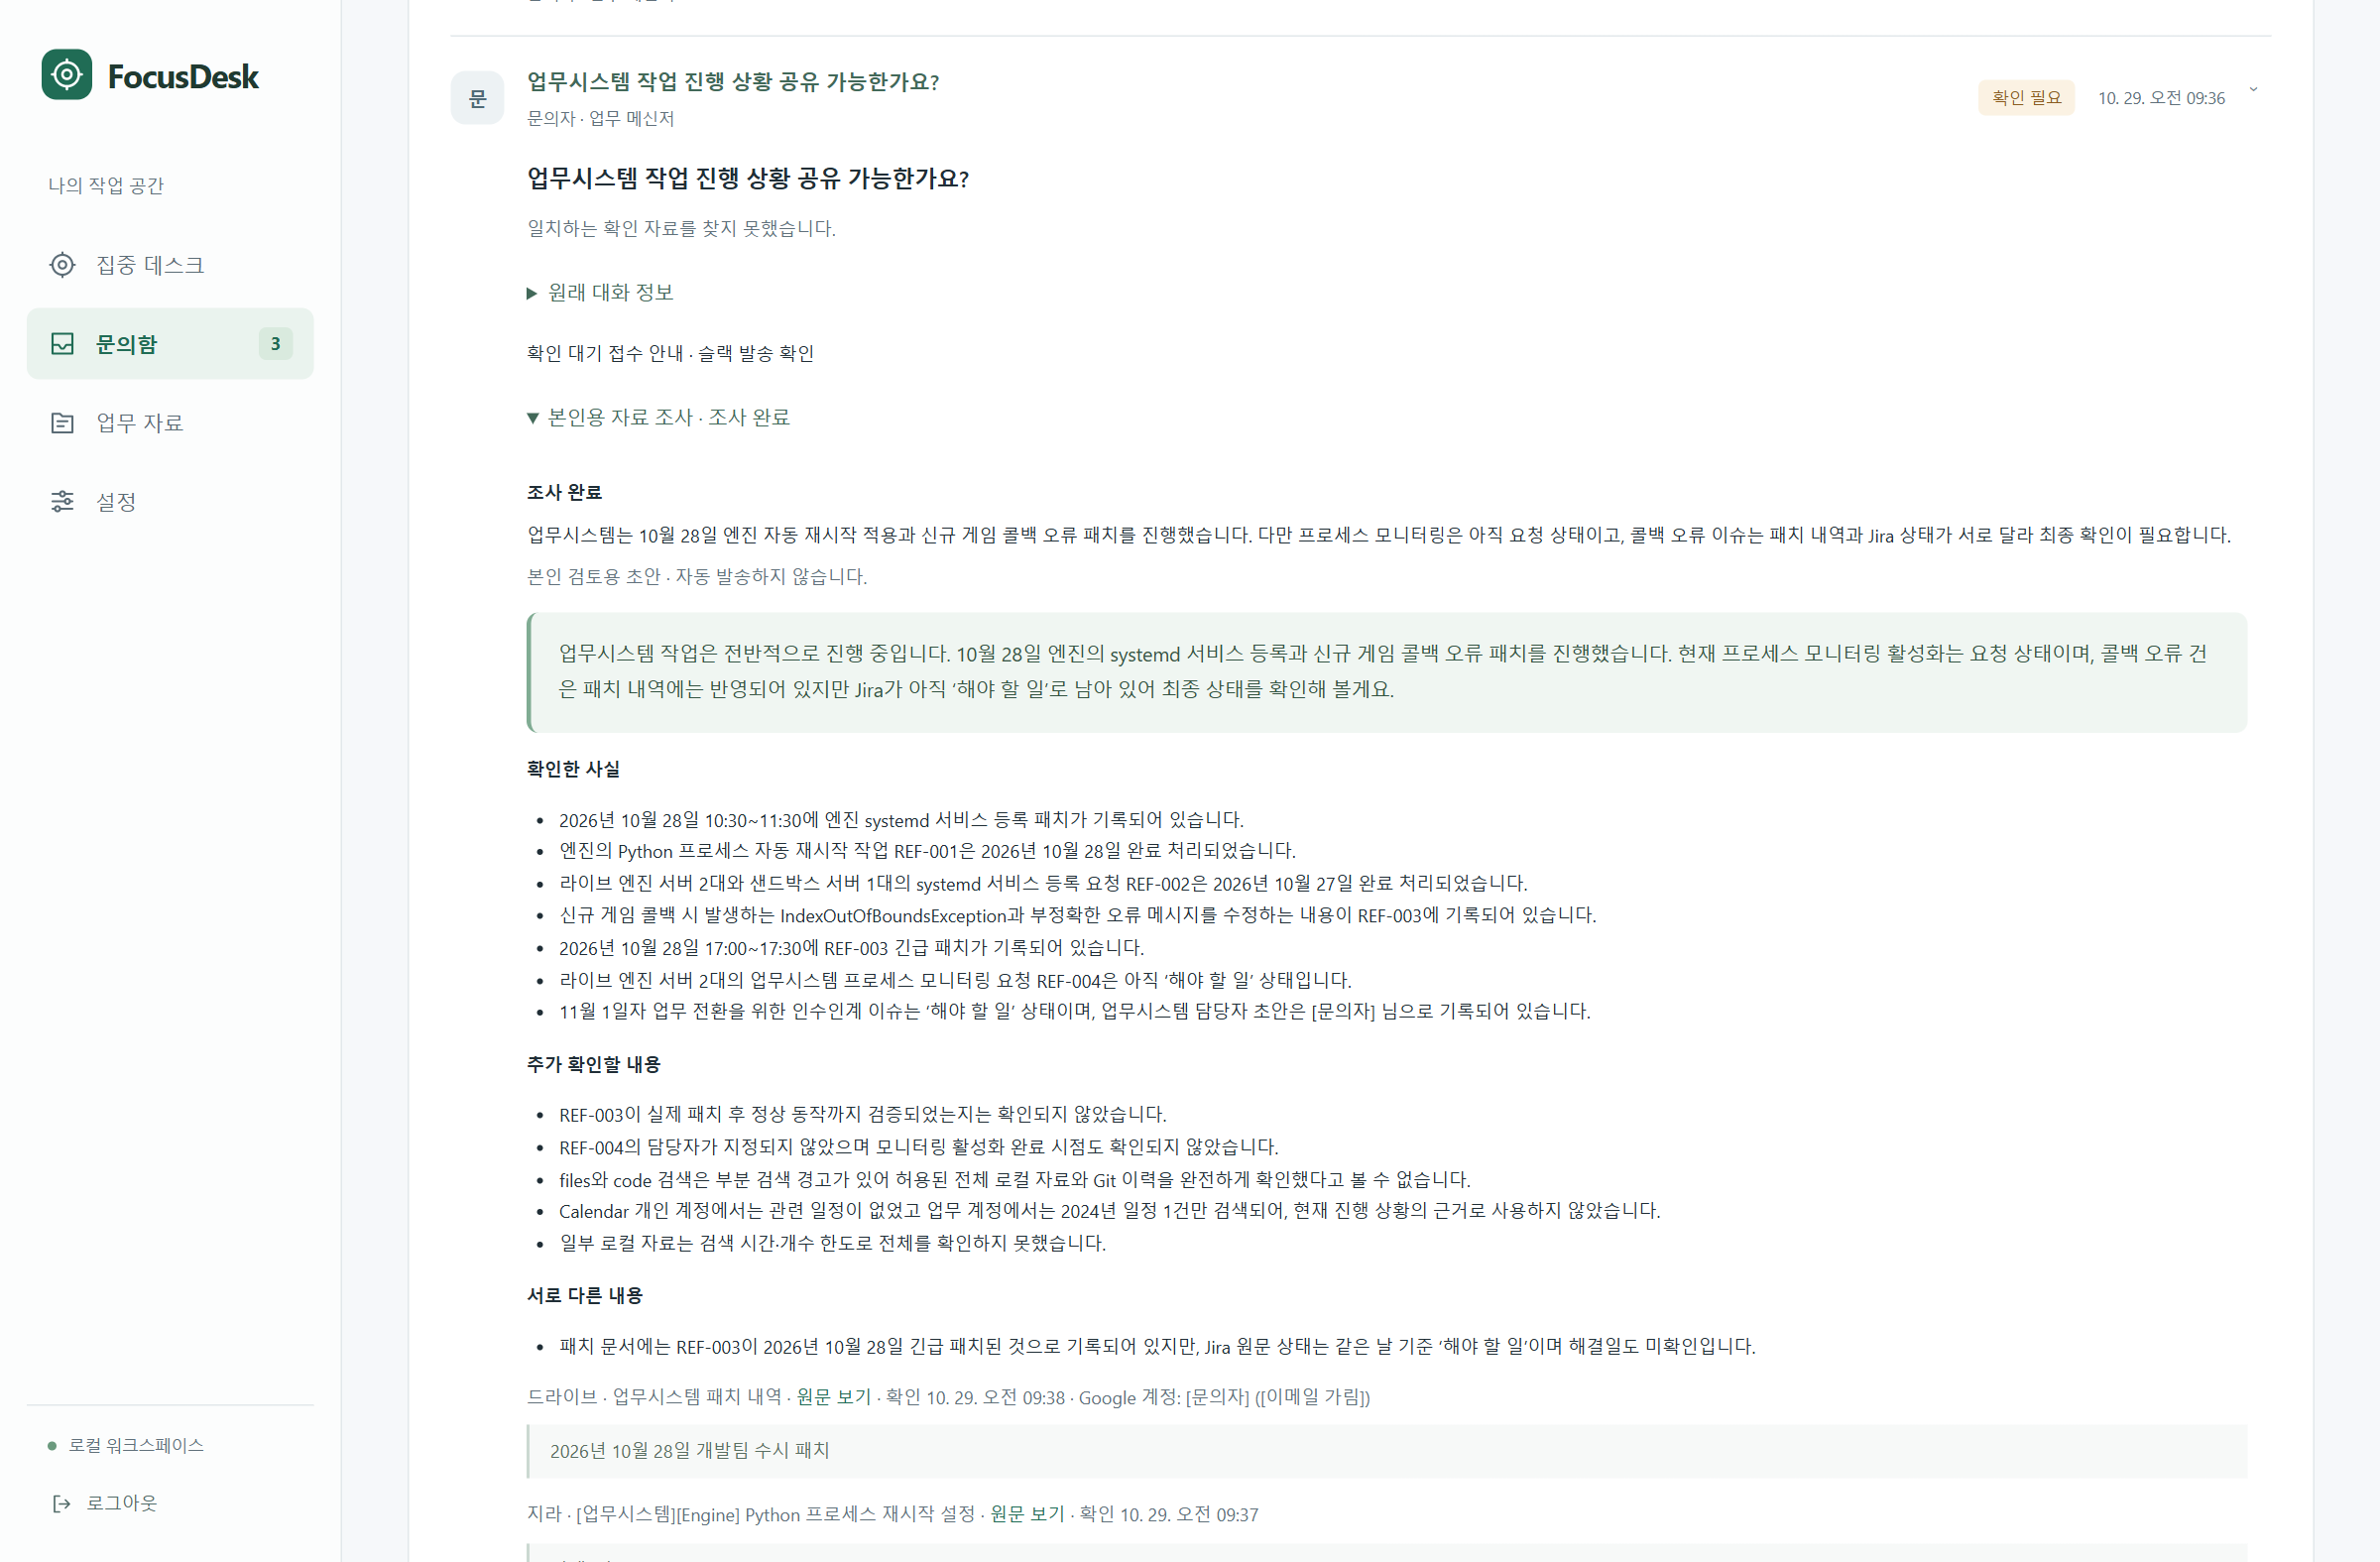
자료를 찾지 못했을 때도 이유를 구분하도록 했다. 접근 권한이 없어 읽지 못한 것과, 자료를 확인했지만 관련 내용이 없는 것은 다르다. 이 차이가 표시돼 있으면 권한을 요청할지, 다른 자료를 찾을지, 담당자에게 물어볼지 정하기 쉽다.
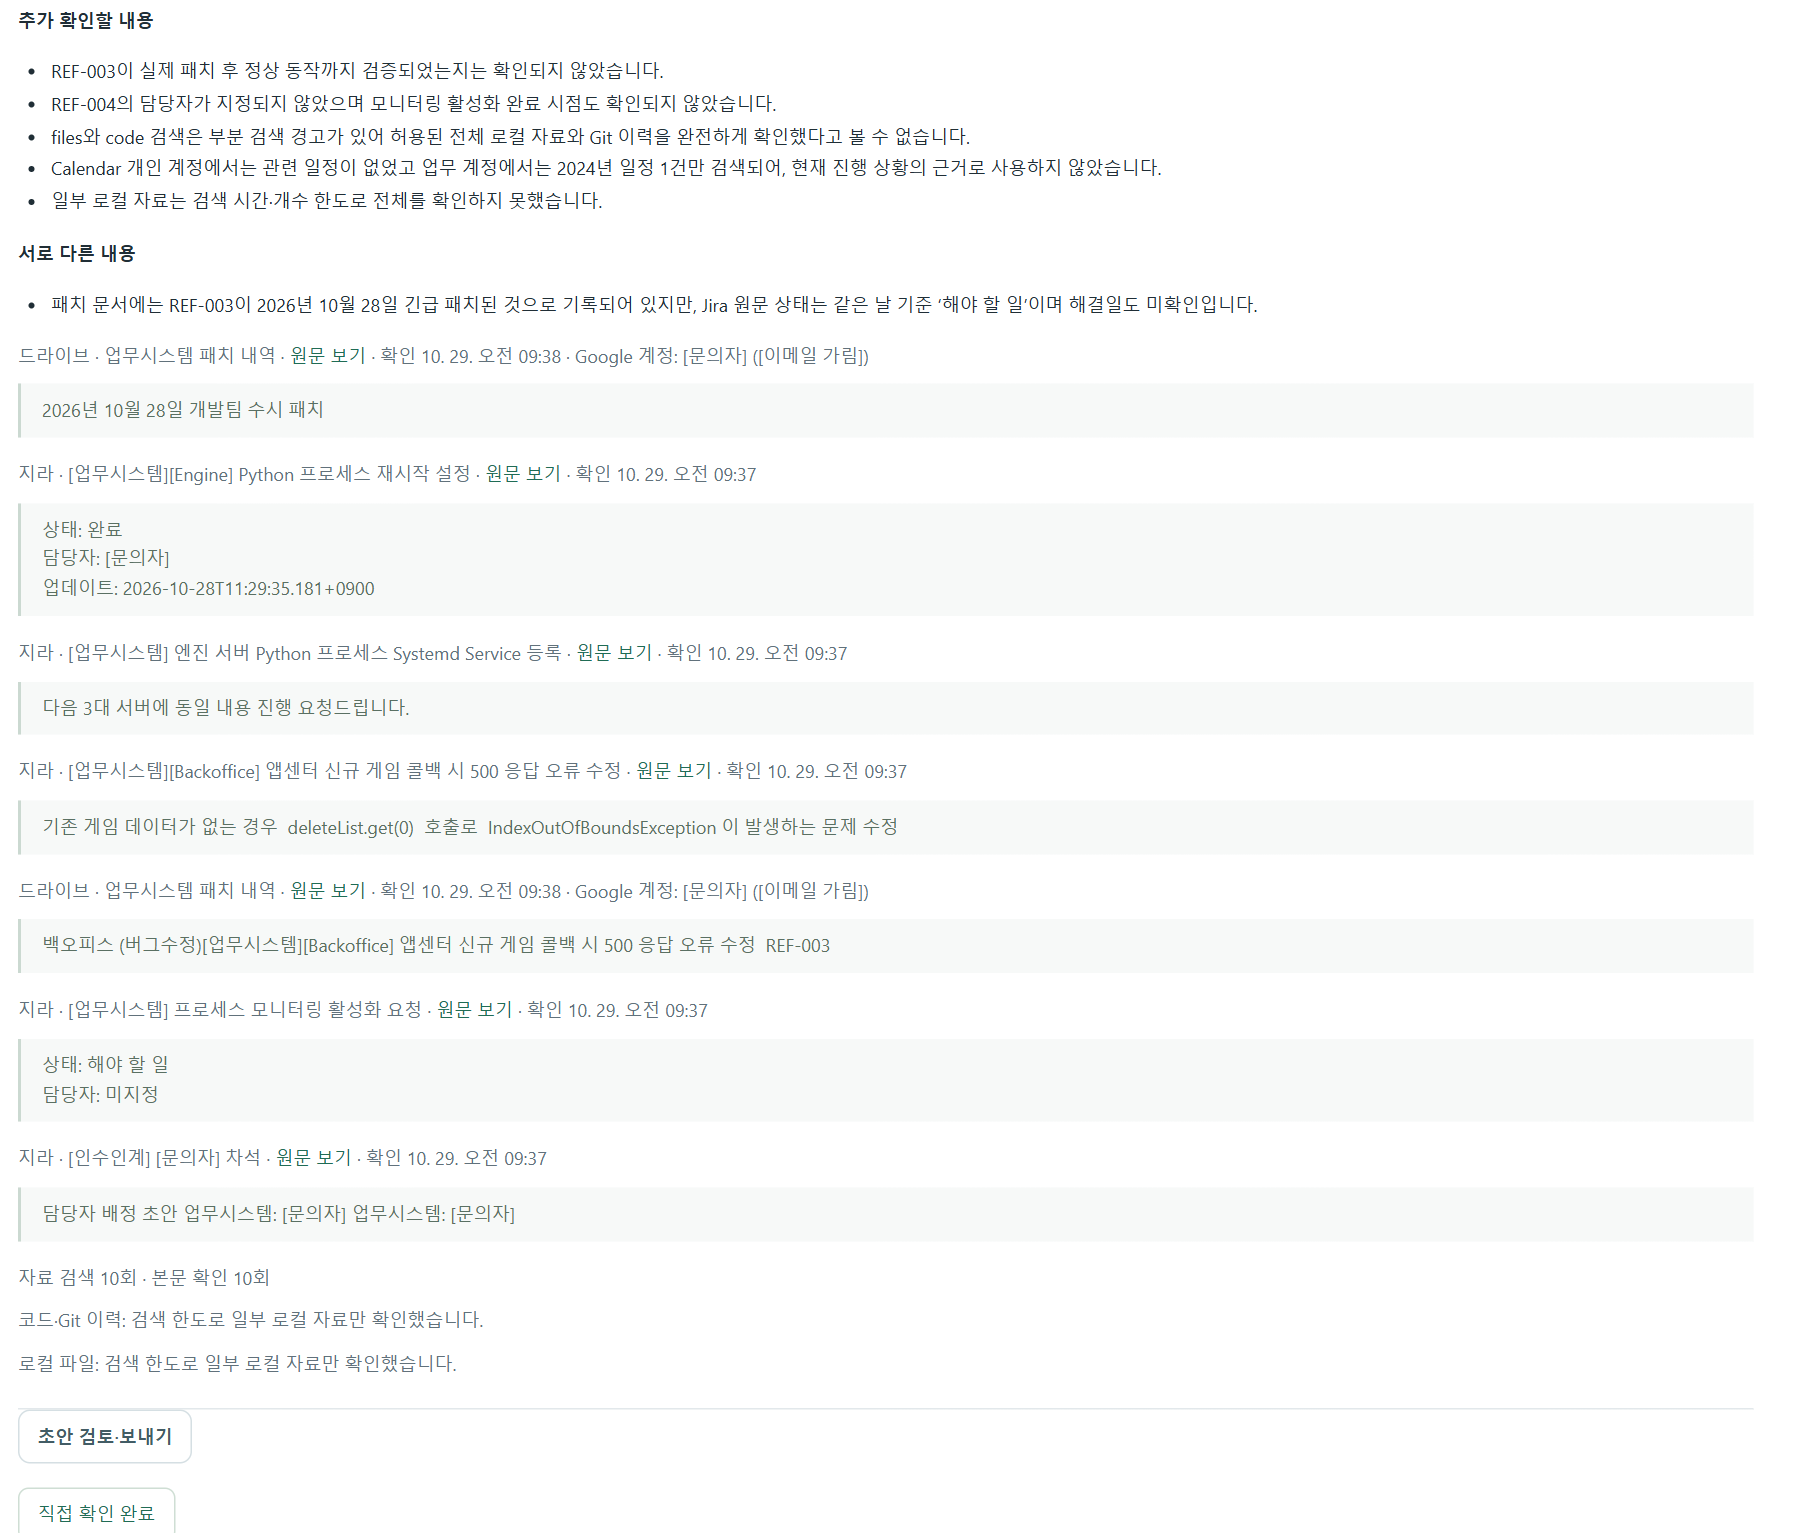
이 흐름은 필자의 개인용 로컬 환경에서 약 2주 동안 채팅 50건 이상으로 시험했다. 어디까지 확인됐고 무엇이 남았는지를 먼저 보여주는 데 초점을 두었다. 답변을 확정하지 못하더라도 다음에 무엇을 해야 할지 알 수 있다면 자료 조사는 제 역할을 한 셈이다.
네이버웍스로 들어온 진행 상황 문의에서는 확인된 내용까지 답변 전체가 보류된 적이 있다. AI는 자료를 읽고 ‘작업은 완료됐지만 운영 반영은 확인하지 못했다’고 구분했지만, 필자가 넣어둔 ‘일부라도 미확인이면 보류’라는 지시 때문에 답변을 내보내지 않았다. 이후에는 확인된 사실은 알려주고 미확인 부분을 함께 설명하도록 조정했다. 자료를 잘 찾는 것만큼 어디까지 답해도 되는지 기준을 정하는 일도 필요했다.
Slack에서는 연달아 들어온 서로 다른 질문 중 하나가 조사에서 빠진 적도 있다. 같은 대화방의 최신 메시지만 처리하는 로직 때문에 앞선 질문이 제외된 것이다. 질문별로 따로 처리하도록 고친 뒤, 누락됐던 질문도 조사와 초안 저장이 이뤄지는 것을 확인했다. AI의 답변뿐 아니라 문의를 받아 AI에 전달하는 프로그램의 흐름까지 함께 살펴봐야 했던 사례다.
회사 자료를 다루는 만큼 보안 정책과 허용된 자료 범위는 먼저 확인한다. Aside에는 기능별로 허용하거나, 사용 전에 승인을 받거나, 아예 차단하는 설정이 있다. 자료를 읽는 일과 답변을 전송하거나 내용을 바꾸는 일은 이 설정에서도 구분해 두어야 한다.
REA로 낯선 코드에서 읽기 시작할 지점 찾기
자료를 찾는 대상이 문서에서 코드로 바뀌어도 어려움은 비슷하다. 익숙하지 않은 프로젝트를 열면 파일은 많은데 어디부터 읽어야 할지 막막할 때가 있다. AI에게 전체 설명을 부탁해도 긴 소개문을 다 읽고 나면 “그래서 내가 고칠 부분은 어디지?”라는 질문이 남을 수 있다.
이럴 때는 프로그램 전체를 이해하려 하기보다 궁금한 동작 하나에서 시작하는 편이 낫다. 버튼을 눌렀을 때 어떤 처리가 이어지는지, 입력한 내용이 어떤 과정을 거쳐 화면에 나타나는지처럼 눈에 보이는 행동을 기준으로 삼는 것이다.
REA(Reverse Engineer Anything)는 이런 조사에 활용할 수 있는 도구다. AI가 프로그램의 구조와 동작을 분석할 수 있도록 기능을 더해준다. 분석 대상에 따라 연결된 코드의 위치나 프로그램 내부의 관계, 실행 중에 일어나는 일을 살펴볼 수 있다.
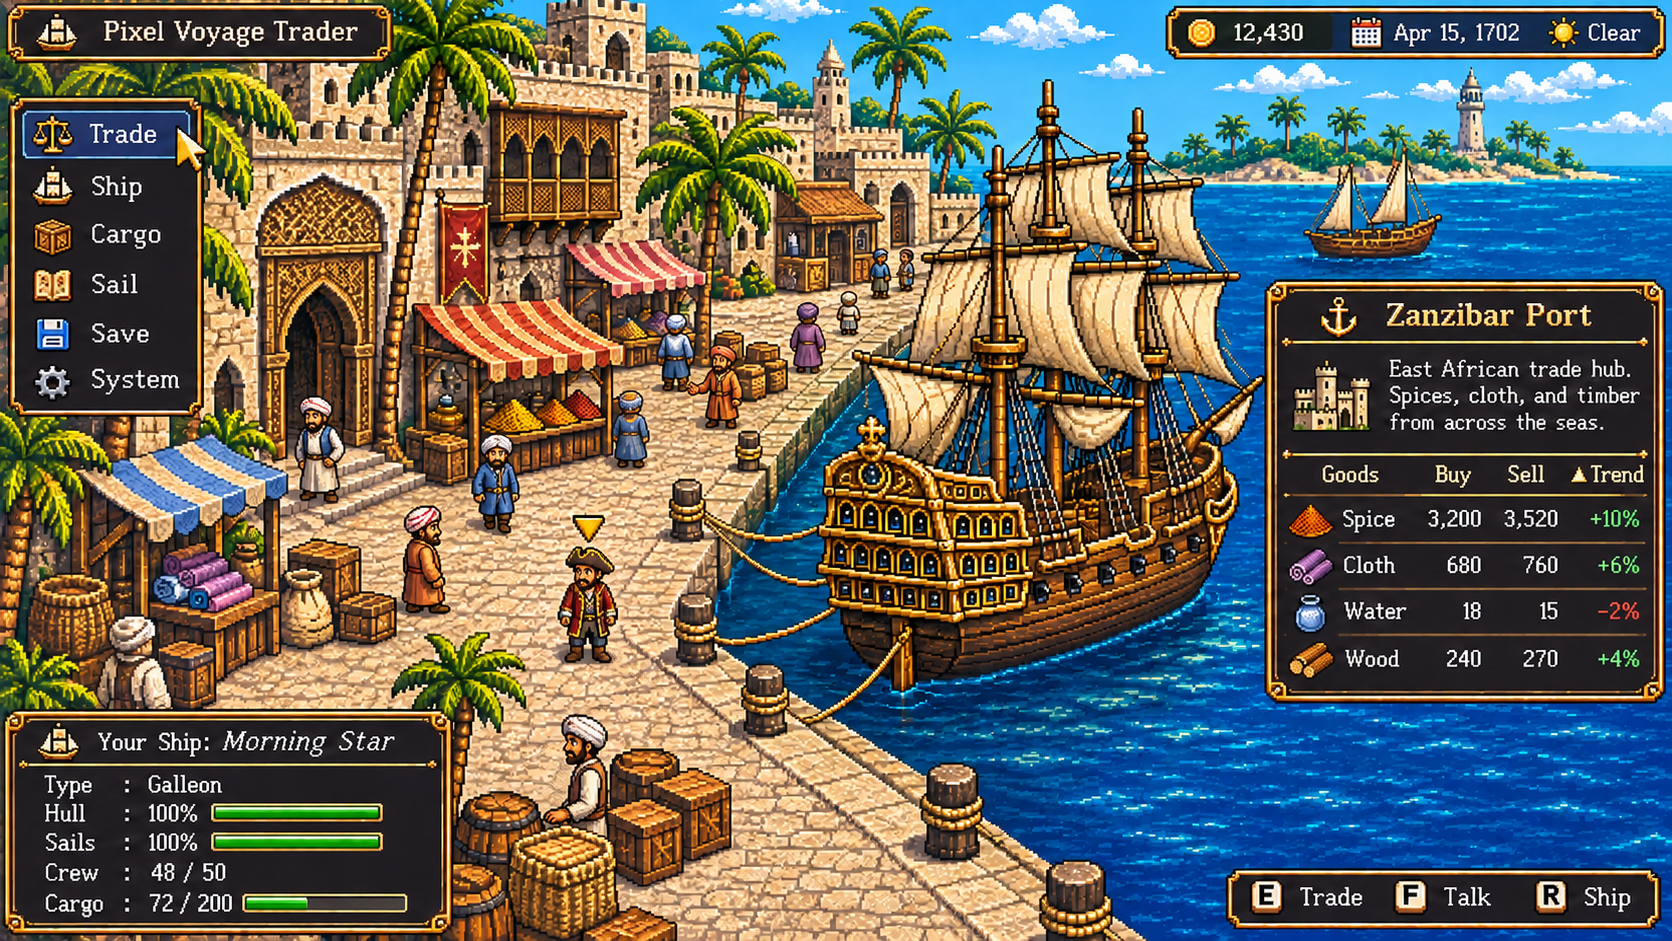
필자는 pixel-voyage-trader 프로젝트를 진행하며 REA를 사용해봤다. 게임의 맵과 항적을 일치시키는 작업에 참고하려고 대항해시대 게임을 분석했다. 원하는 동작 하나를 정하고, 그 동작을 이해하는 데 필요한 자료부터 살펴본 사례다.
공개 소스로 살펴볼 수 있는 예로는 VS Code의 문서 미리보기 기능이 있다. VS Code는 개발자가 코드를 작성할 때 쓰는 편집 도구로, 마크다운 형식의 문서를 쓰면서 옆에 완성된 모습을 미리 띄워둘 수 있다. 내용을 수정하면 미리보기에도 변화가 반영된다.
쓰는 입장에서는 자연스러운 기능이다. 글자를 바꾸면 옆 화면도 바뀐다. 하지만 비슷한 기능을 직접 만들려고 하면 질문이 생긴다. 문서가 바뀌었다는 사실은 어디서 알아차릴까? 새 내용을 화면으로 보내는 부분은 어디일까? 글자를 연달아 입력할 때도 매번 같은 처리를 반복할까?
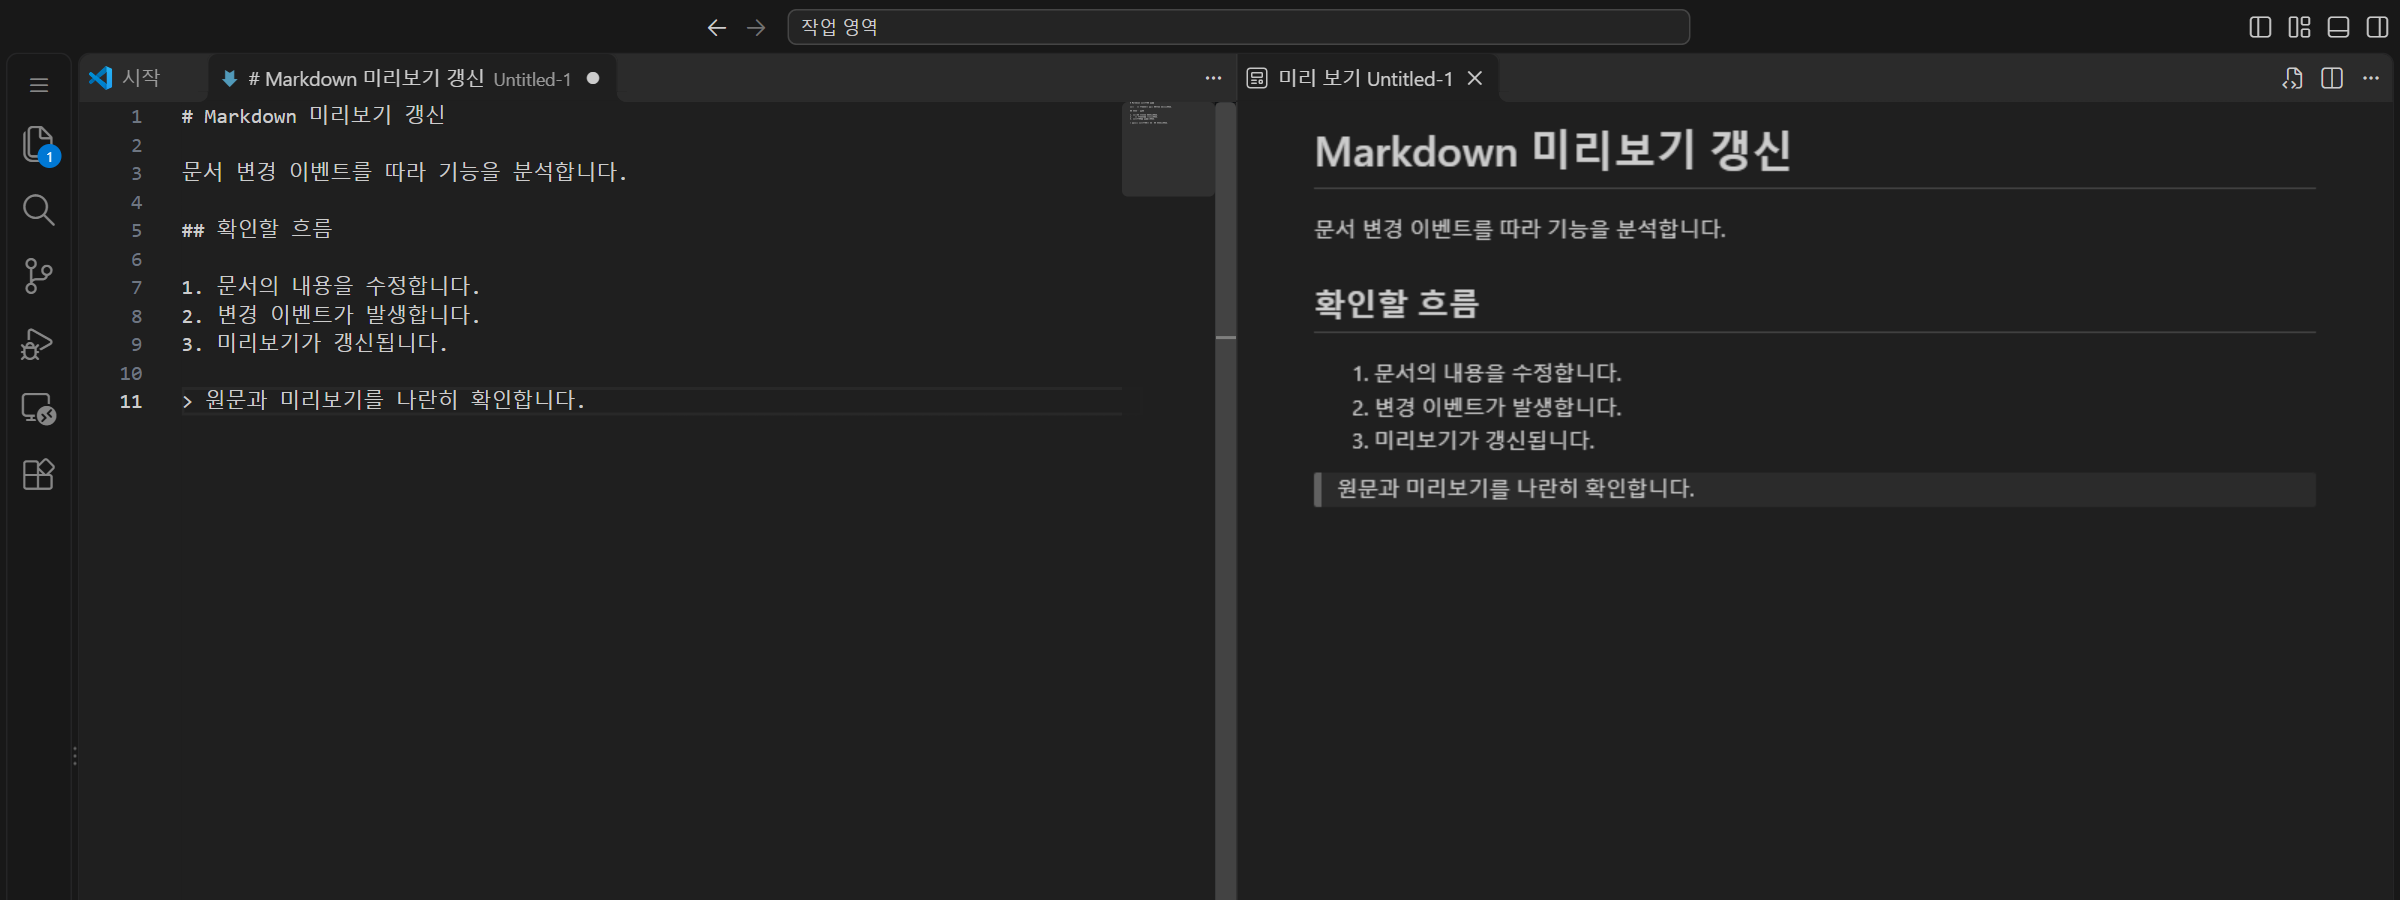
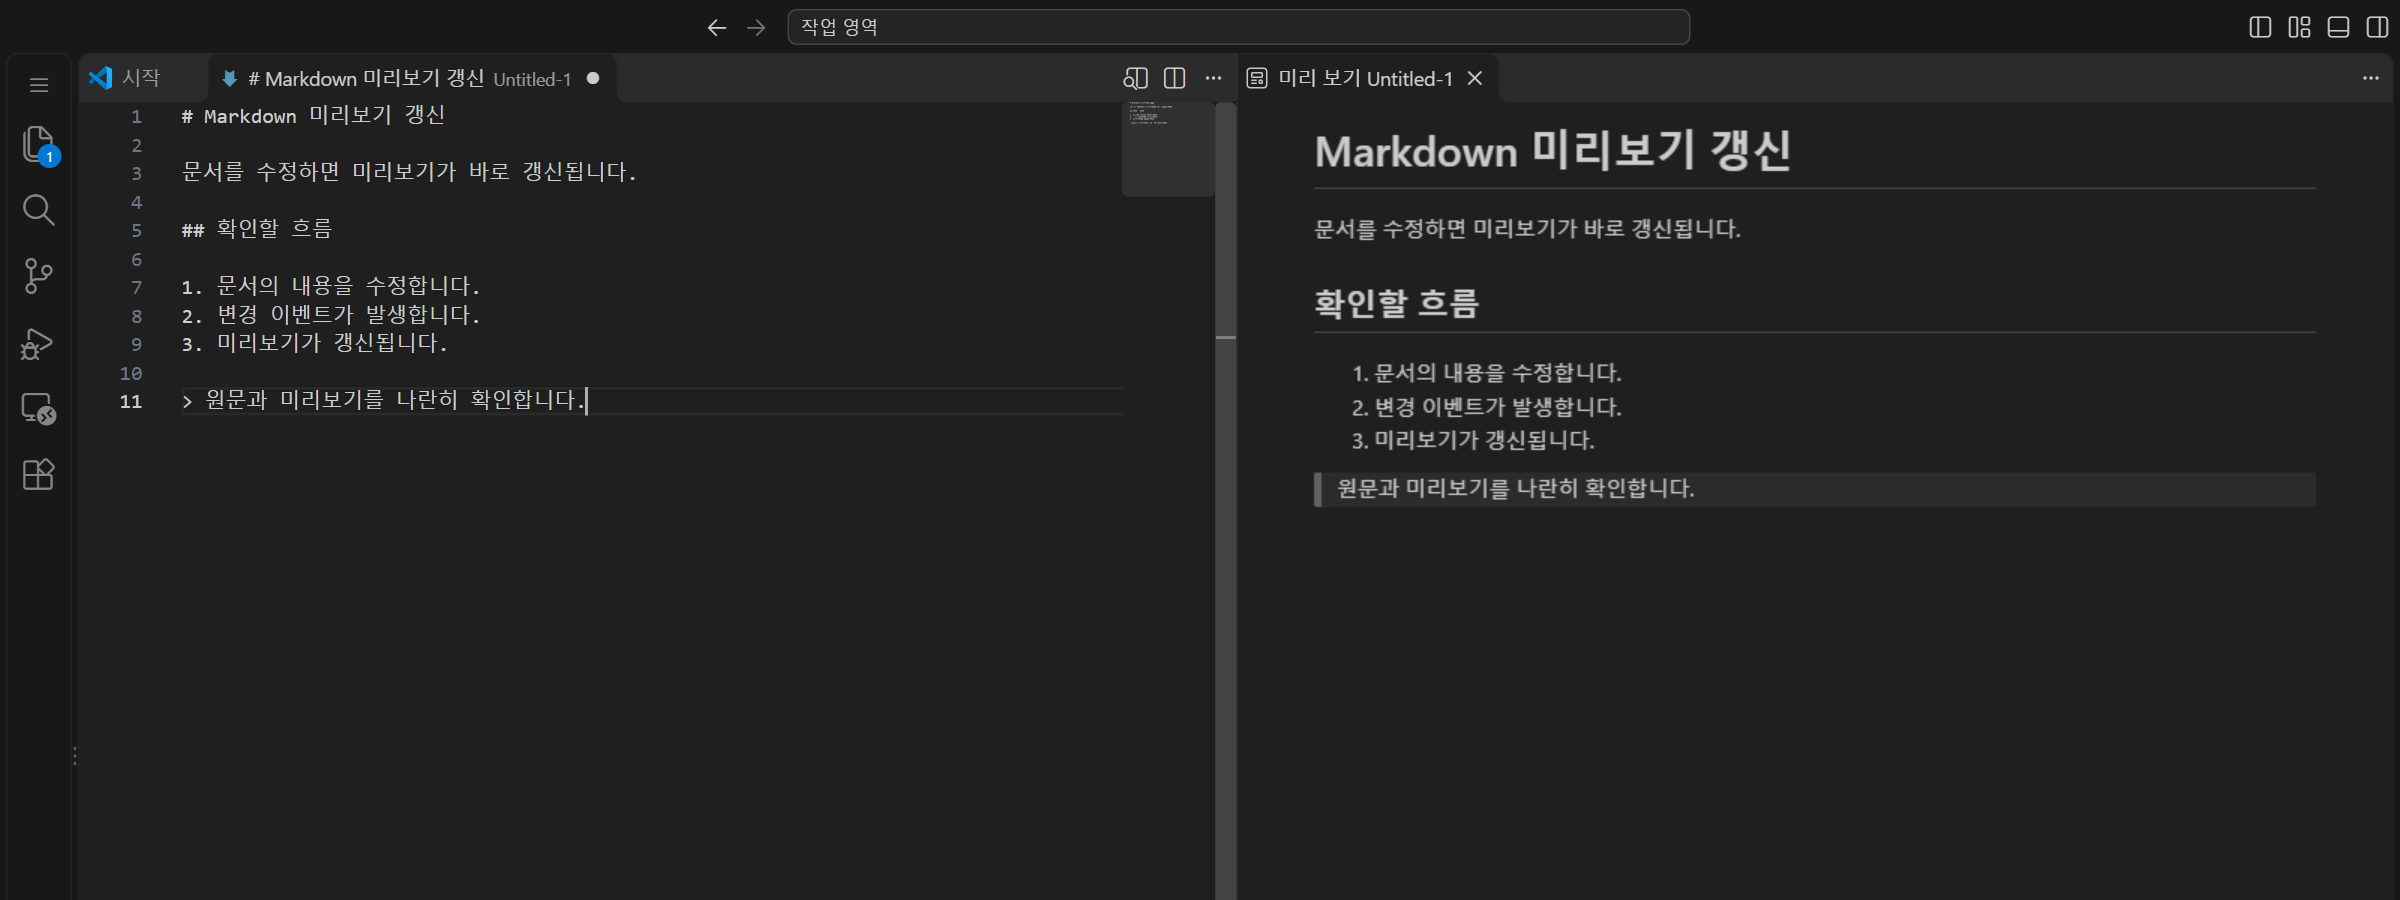
이렇게 질문을 좁히면 조사할 코드의 범위도 정해진다. 실제 공개 코드에는 문서 변경을 감지하는 처리, 이어지는 갱신 요청을 조절하는 처리, 새 내용을 미리보기에 반영하는 처리가 나뉘어 있다. 이 연결을 따라가면 큰 프로젝트 전체를 읽지 않고도 미리보기 기능에 필요한 부분부터 살펴볼 수 있다.
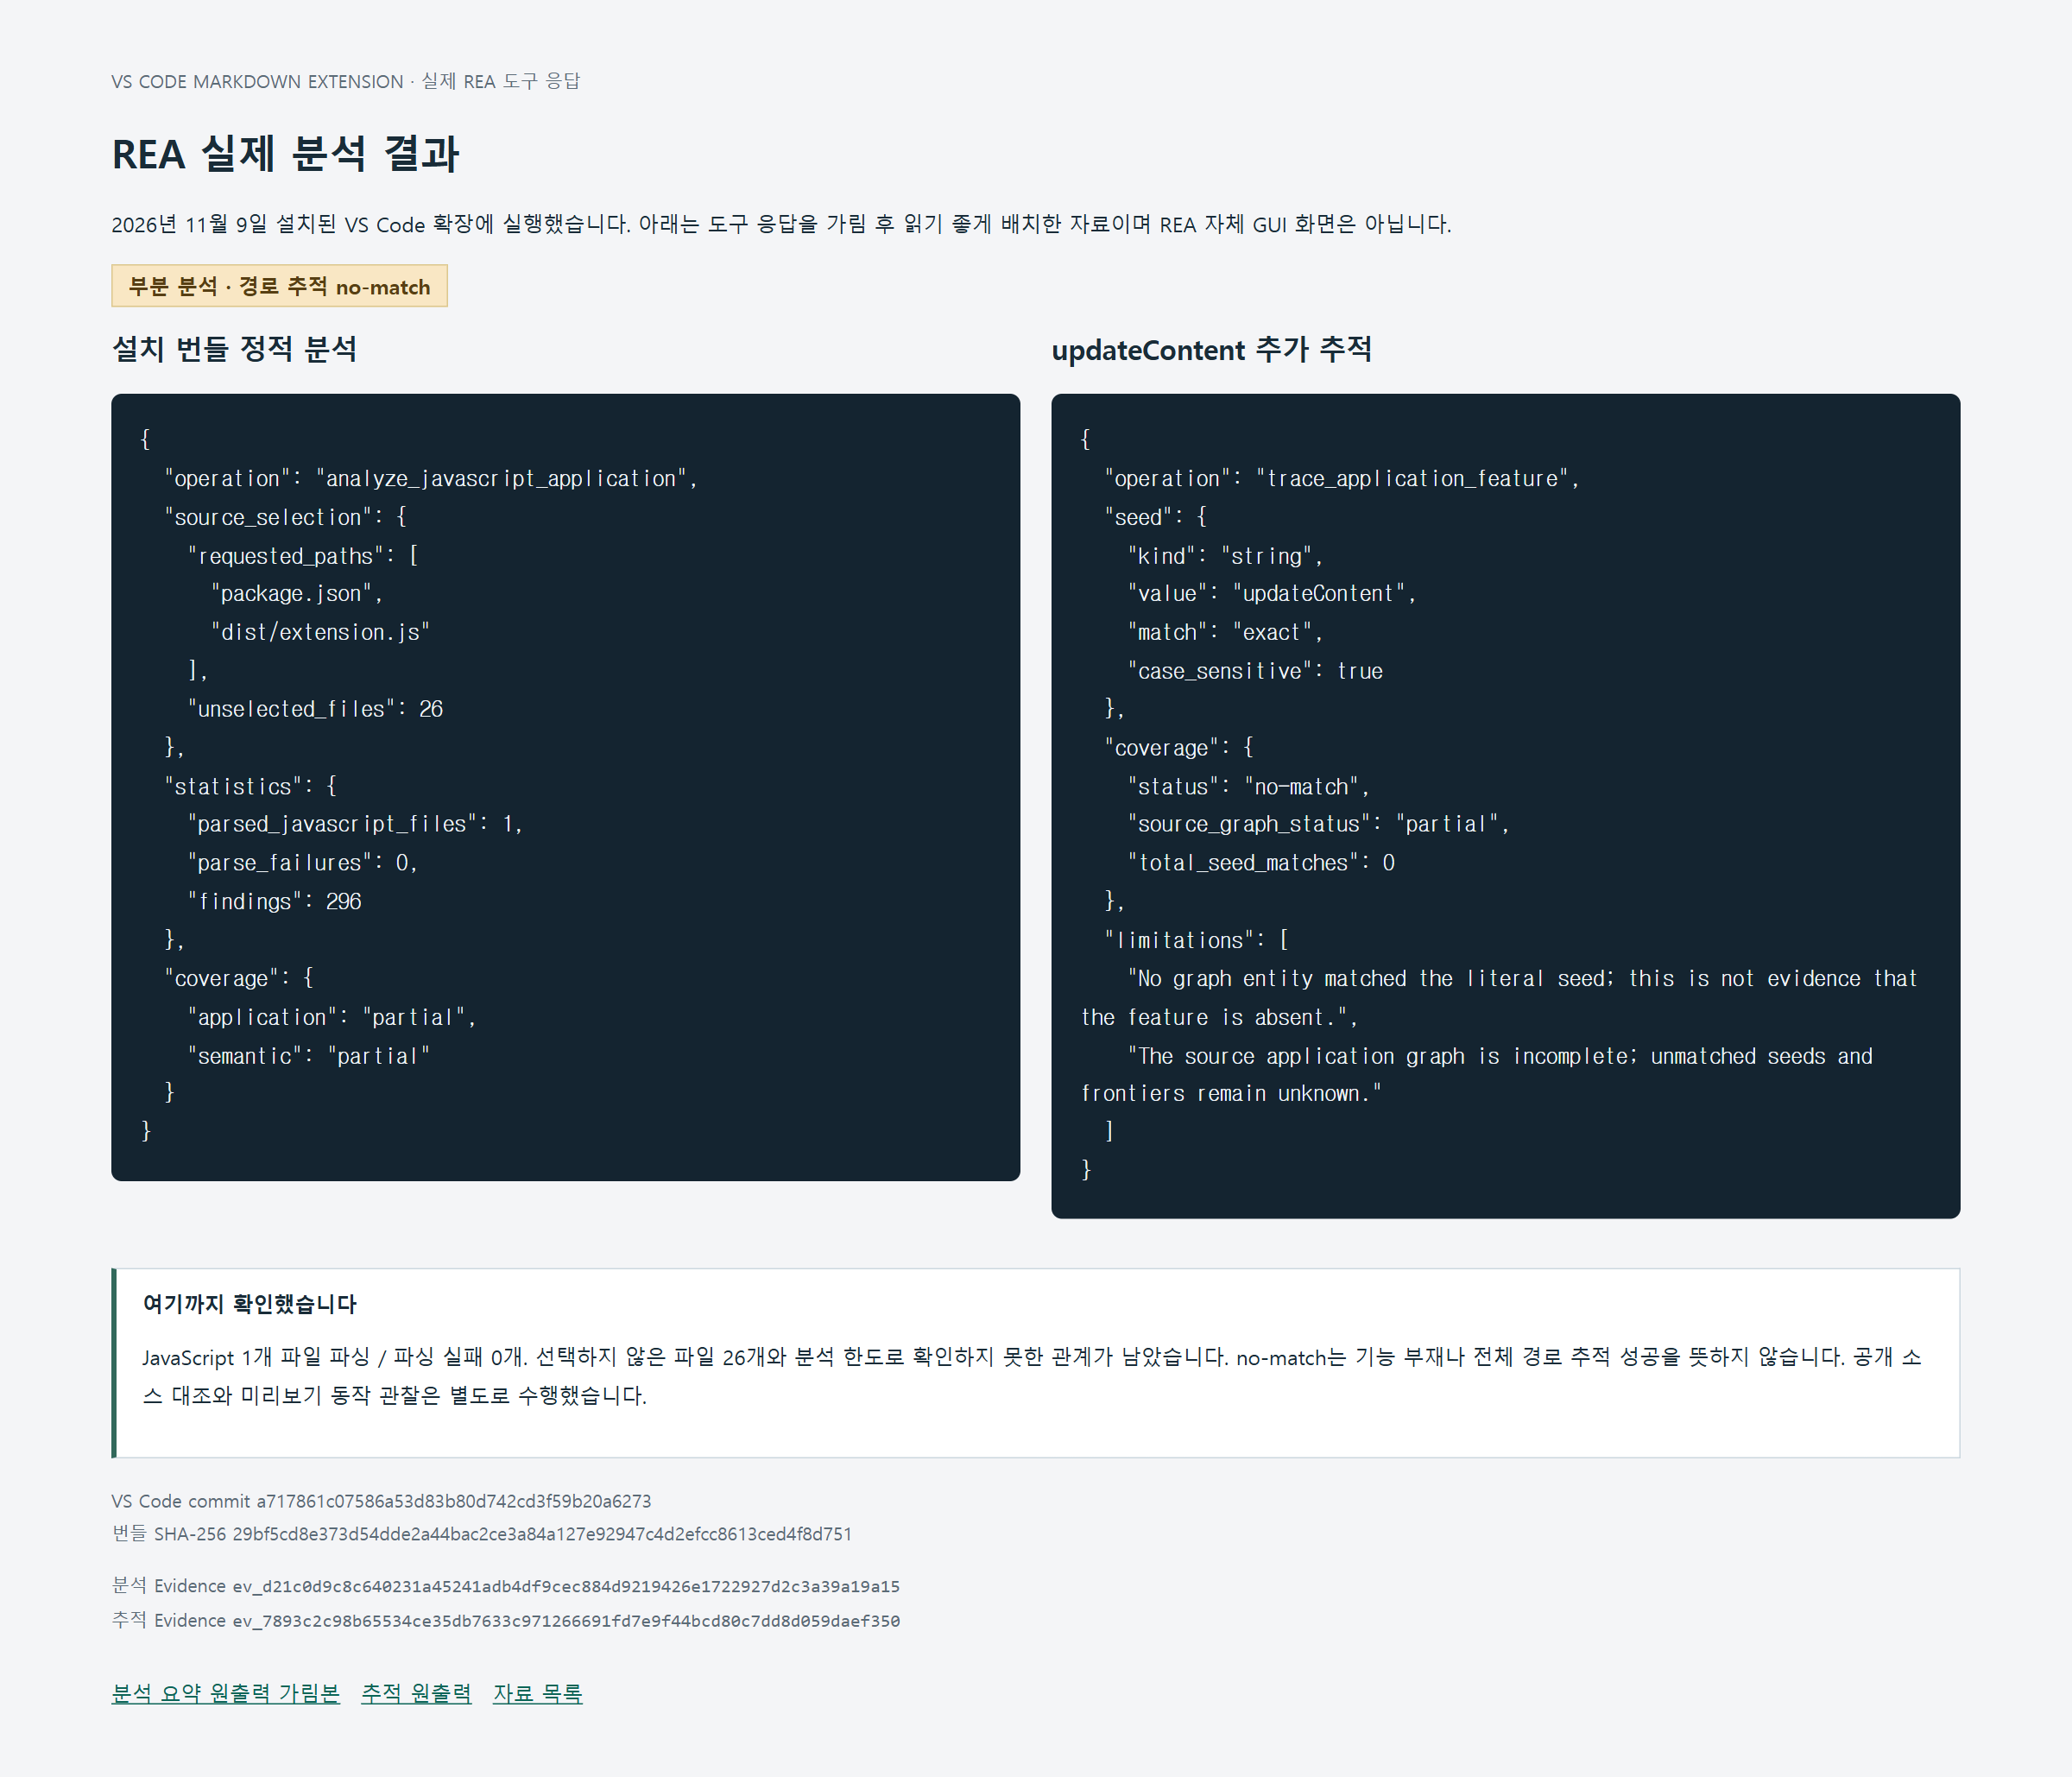
이 예시에서는 실제로 설치된 VS Code 확장 번들에도 REA를 실행했다. JavaScript 파일 1개의 파싱은 성공했지만, 선택하지 않은 파일과 분석 한도 때문에 결과는 부분 분석으로 남았다. 미리보기 갱신과 관련된 updateContent라는 문자열의 연결 경로를 찾는 추가 추적에서도 일치하는 항목을 찾지 못했다. 그래서 공개 소스에서 확인한 흐름과 REA의 분석 범위를 나눠 보았고, 이 사례를 REA가 전체 실행 경로를 자동으로 찾아낸 경우로 보지는 않았다.
여기서 한 가지를 더 정해두면 좋다. 이번 조사로 무엇을 결정하려는지다. 미리보기 갱신 방식을 바꾸는 것이 목적이라면 관련 경로와 수정할 위치를 찾는 것이 우선이다. 그 부분을 확인했다면 구현과 테스트로 넘어가면 된다. 관련 없는 기능까지 모두 설명받을 필요는 없다.
AI의 설명을 그대로 받아들이자는 이야기는 아니다. 필자는 AI의 설명과 실제 코드를 비교하며 어디서부터 읽을지 출발점을 잡는 데 쓴다. 공개 코드를 검색하고 읽는 정도라면 일반 코딩 에이전트로도 시작할 수 있고, 더 깊은 구조나 실행 중 동작을 조사해야 할 때 별도의 분석 도구를 검토하면 된다.
분석 결과를 받으면 설명의 길이보다 다음에 할 일이 분명해졌는지를 먼저 본다. 어느 파일을 더 읽을지, 어디를 수정할지, 어떤 동작을 시험할지 알게 됐다면 그 분석은 실제 작업으로 이어질 수 있다.
Hermes와 OMX로 즐기던 게임을 만들며 설계와 구현 나누기
개인 시간에는 조금 다른 주제로 AI를 활용해봤다. 예전에 즐겨 했던 ‘대항해시대’를 떠올리며 항해와 교역을 하는 게임 pixel-voyage-trader를 만들어본 것이다. 게임 개발이 본업은 아니지만, 배를 타고 항구를 오가던 재미를 이번에는 만드는 쪽에서 살펴보고 싶었다.
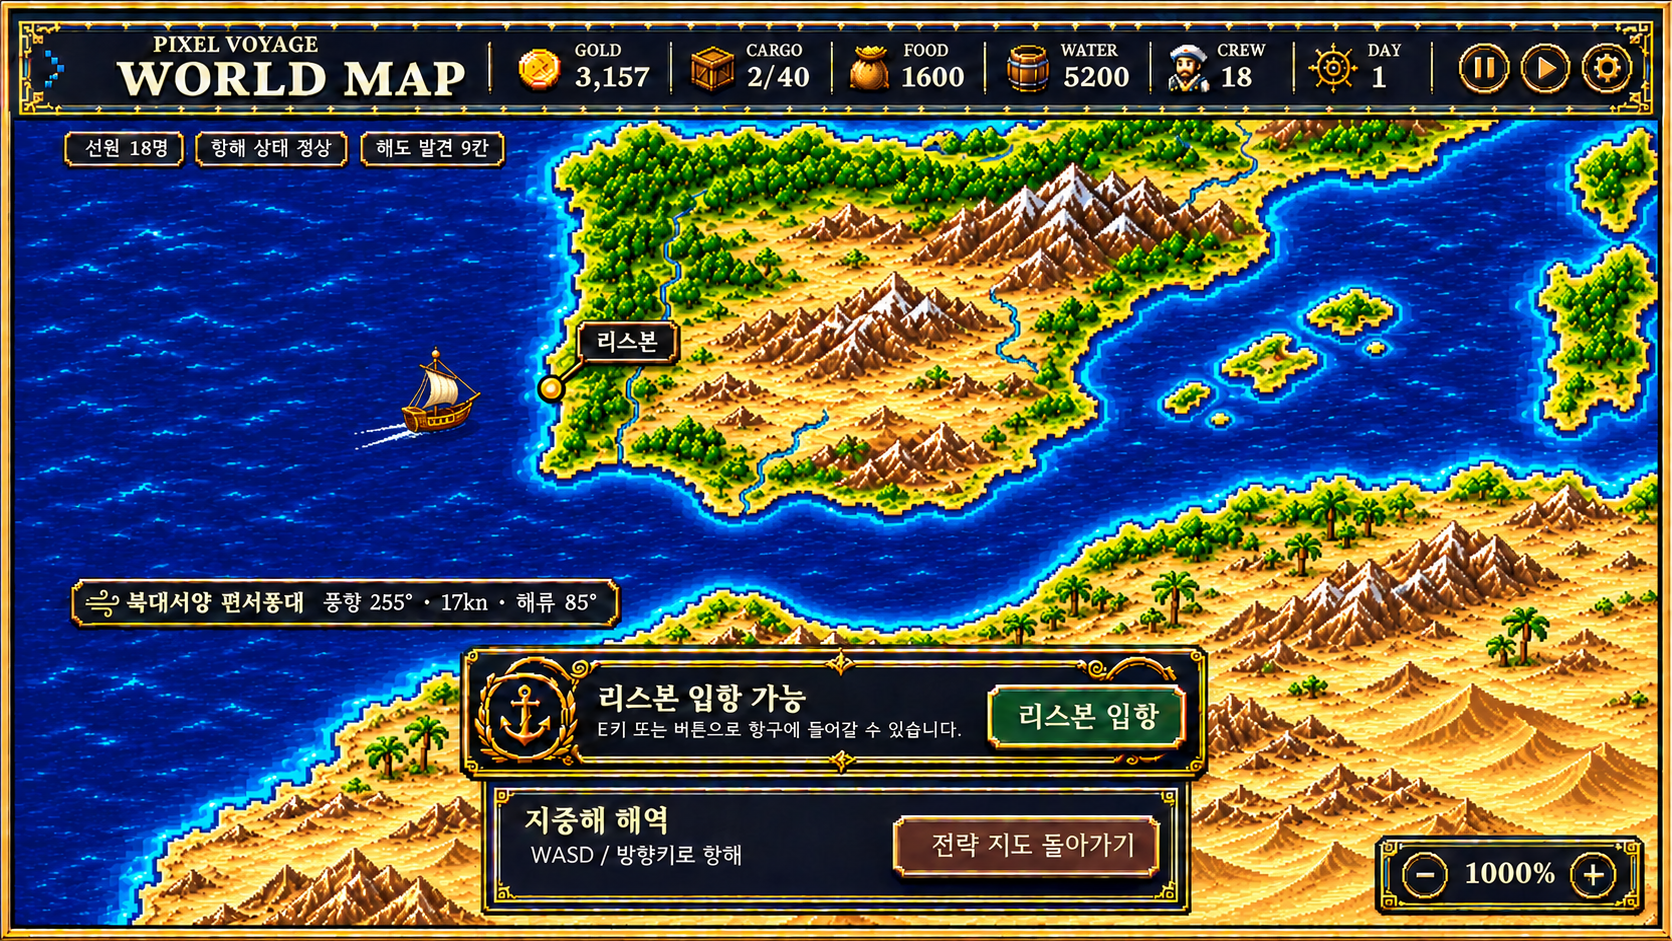
처음 화면에 바다와 배가 나타났을 때는 제법 게임다운 모습이었다. 다만 배가 보인다고 바로 항해를 시작할 수 있는 것은 아니었다. 움직이지 않는 문제를 고치고, 화면에 보이는 항구와 실제로 입항할 수 있는 위치를 맞춰야 했다. 배를 그리는 일과 배가 제대로 항해하게 만드는 일은 별개였다.
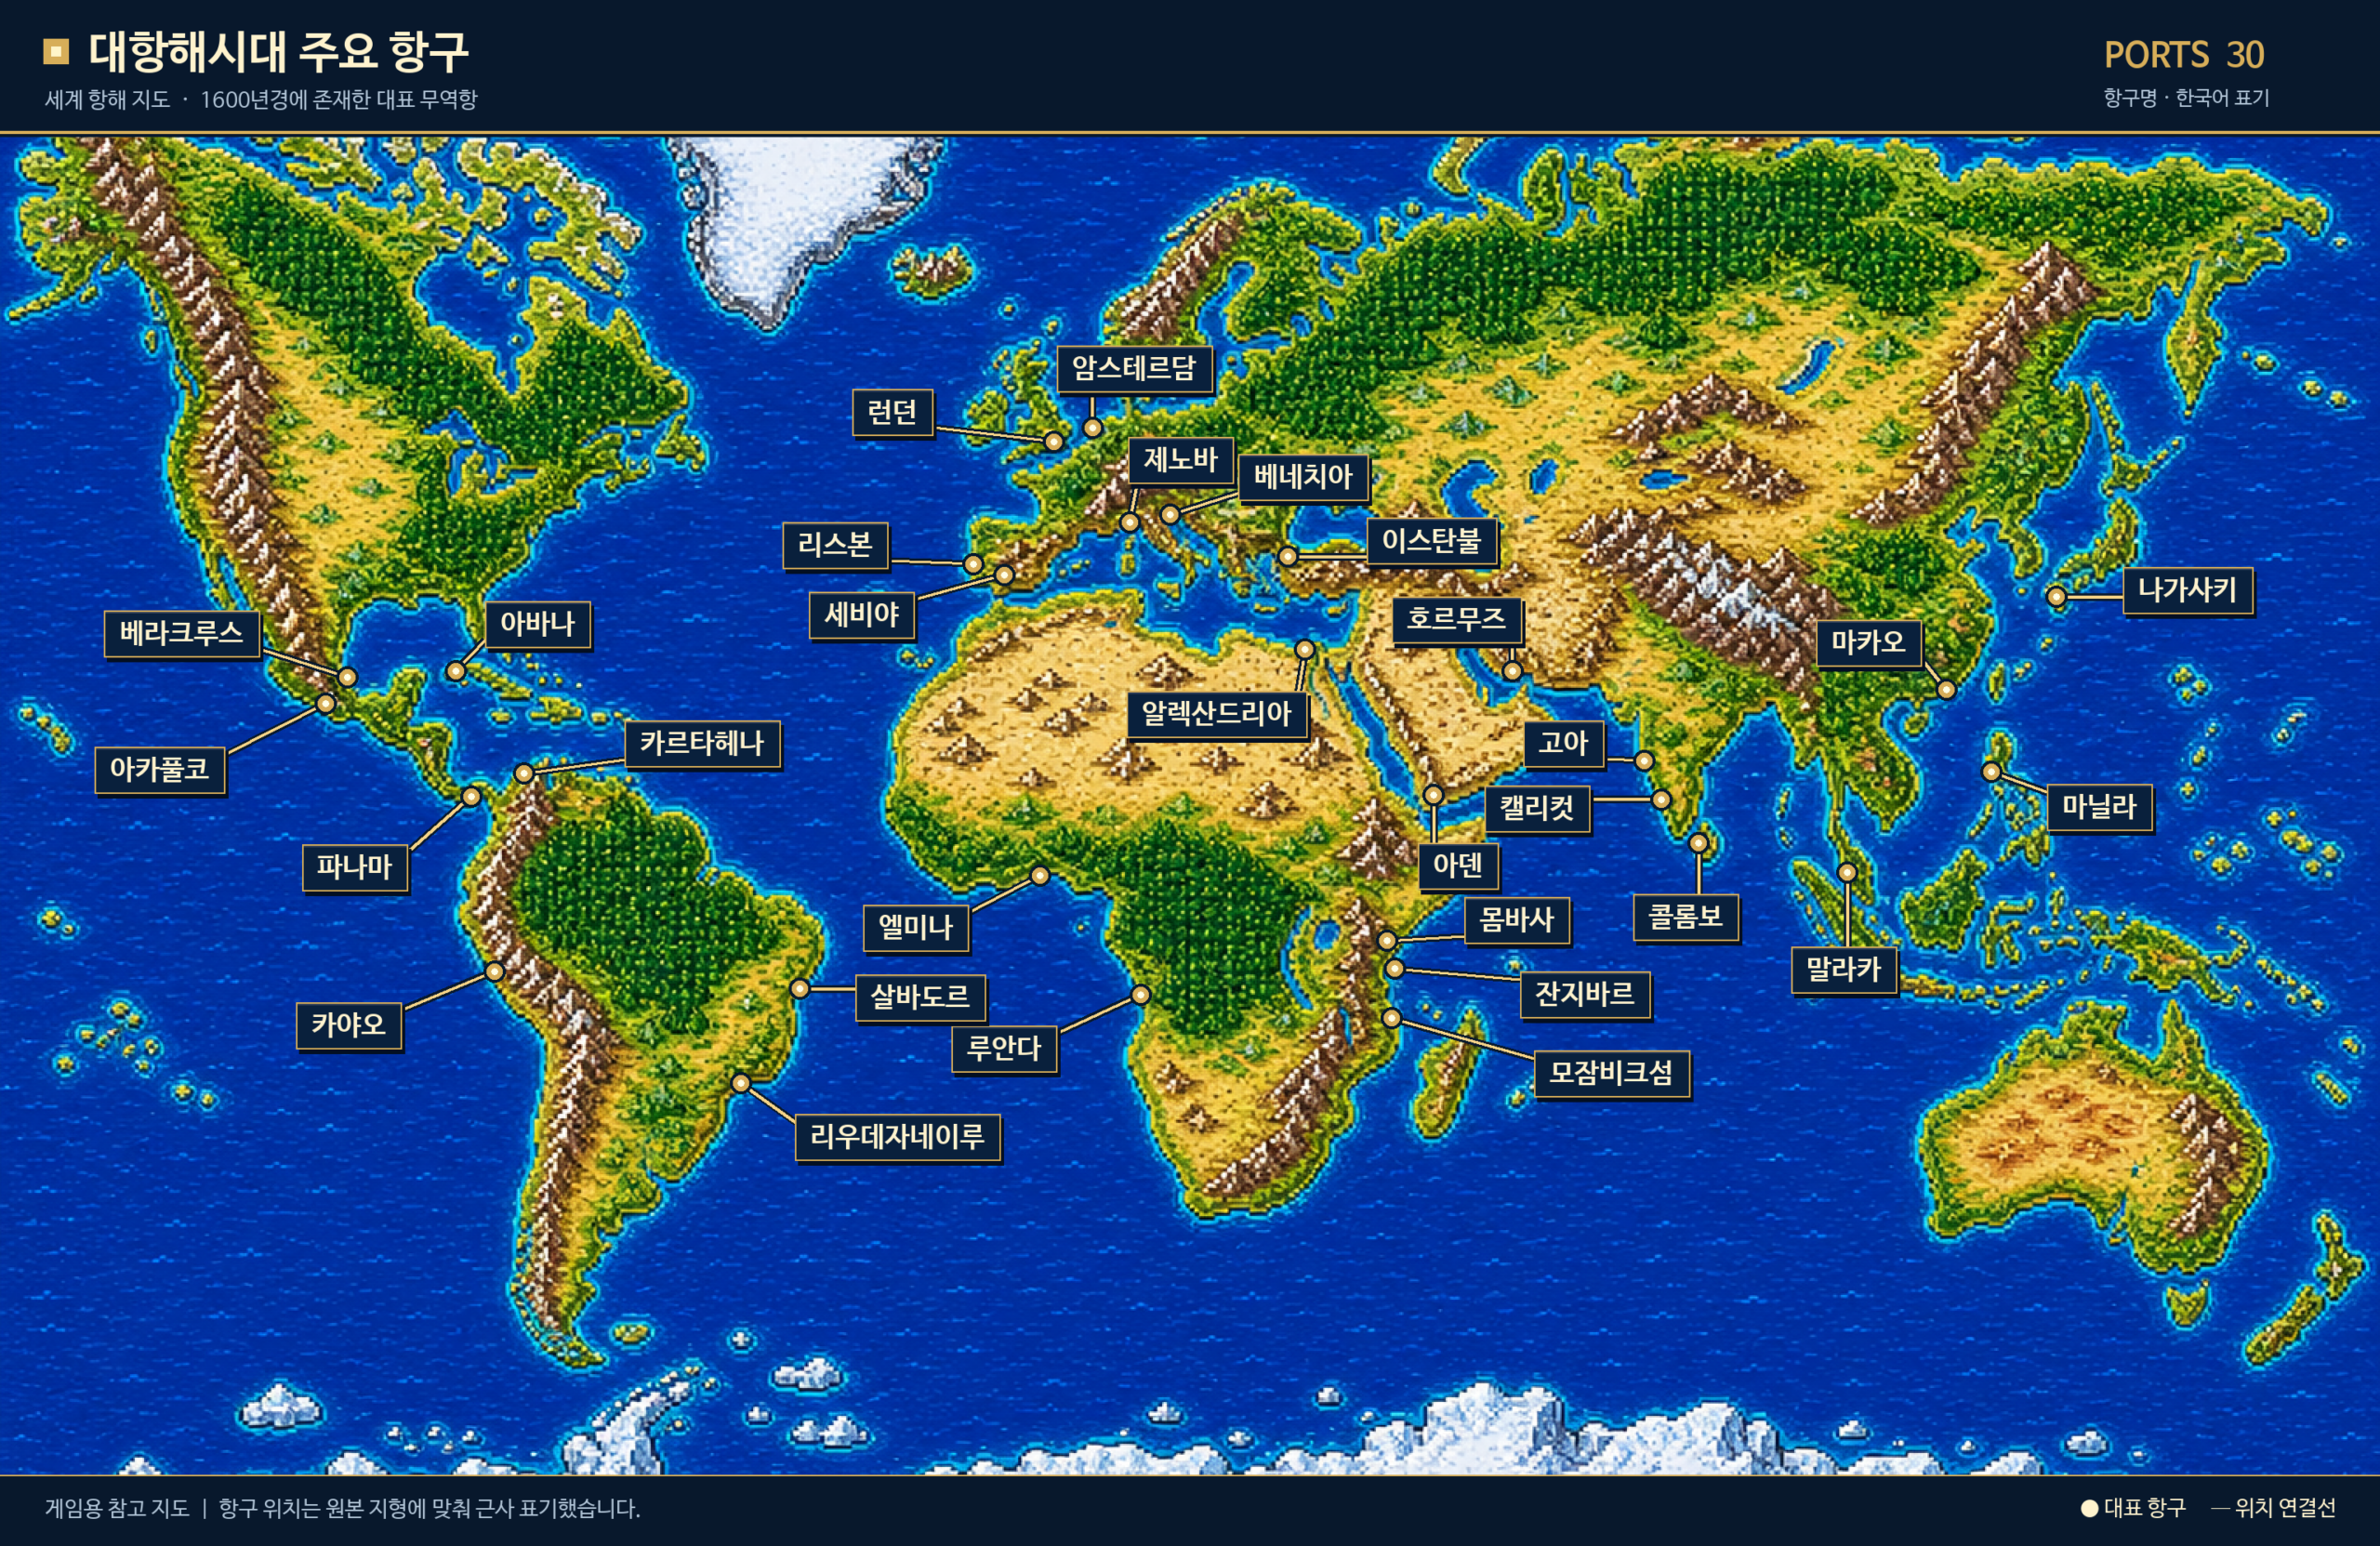
익숙한 게임이라 머릿속에 원하는 장면은 있었지만, 막상 구현하려니 설명하지 않은 조건이 꽤 많았다. 기능을 이야기하다 오류를 고치고, 다시 다음 기능을 붙이다 보면 처음 정한 내용을 되짚어야 했다. 그래서 설계를 논의하는 대화와 코드를 고치는 작업을 나눠보기로 했다.
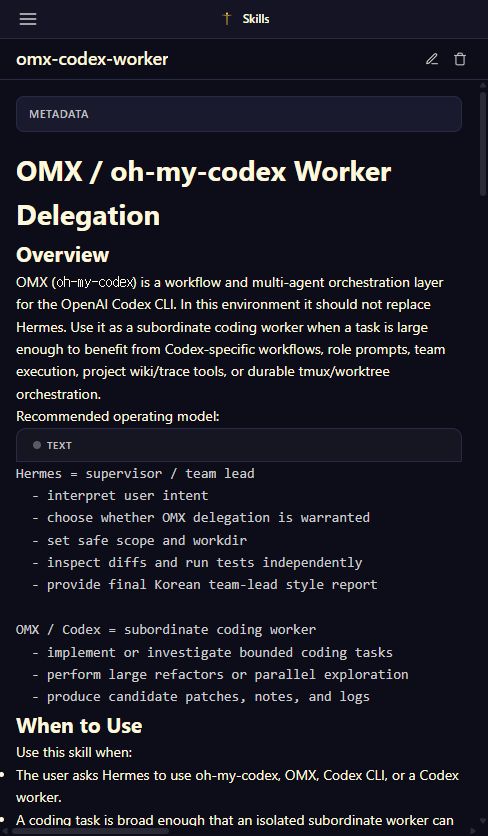
이 프로젝트에서는 Hermes Agent에 OMX(oh-my-codex)를 연결했다. OMX는 Codex를 이용한 개발 작업에 계획과 역할 분담, 구현·검토 과정을 더하는 도구다. Hermes 쪽에서 작업을 전달하고 진행 상태와 결과를 받아볼 수 있는 연결도 제공한다.
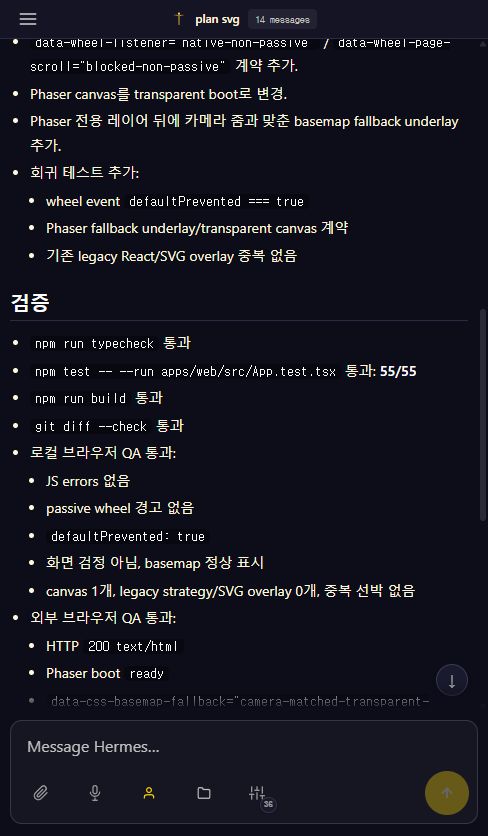
필자는 Hermes와 함께 원하는 기능과 사용 흐름을 정리했다. 기준이 잡히면 OMX에 이번에 만들 부분과 확인할 조건을 전달해 구현과 테스트를 진행했다. 쉽게 말해 한쪽에서는 무엇을 만들지 계속 살피고, 다른 쪽에서는 정해진 내용을 실제로 만드는 방식이다.
 |  |
교역 기능을 예로 들면, 먼저 항구에 들어가 물건을 고르고 거래를 마치는 장면을 떠올린다. 그다음 거래 화면에 무엇을 보여줄지, 물건을 사고팔면 자금과 적재량이 어떻게 바뀔지를 정한다. 돈이 부족하면 거래를 막아야 하고, 거래가 실패했다면 자금과 적재량도 그대로 남아 있어야 한다. 이런 조건을 정리한 뒤에 구현을 맡긴다.
설계와 구현을 나눈 이유는 두 과정에 필요한 정보가 다르기 때문이다. 거래 규칙은 다음 기능을 만들 때도 계속 참고해야 하지만, 특정 오류의 기록은 그 문제를 고치는 동안 주로 필요하다. 설계 쪽에는 결정한 내용을 남기고 구현 쪽에는 이번 작업의 범위와 결과를 남기니, 대화가 뒤섞이는 일이 줄었다.
수정할 때도 기준이 생겼다. 정한 규칙은 맞는데 동작이 잘못됐다면 코드를 고친다. 실제로 써보니 규칙 자체가 불편하다면 설계부터 다시 살펴본다. 모든 문제를 곧바로 “다시 만들어줘”로 넘기지 않고, 무엇을 바꿔야 하는지부터 구분하는 것이다.
이렇게 작업을 이어가며 좋았던 점은 배경을 매번 처음부터 설명하지 않아도 된다는 것이었다. 정리해둔 조건과 지난 결과를 바탕으로 다음 수정을 논의할 수 있었다. 생각으로만 남겨뒀을 게임을 직접 움직여보고, 다음에는 무엇을 바꿀지 고민하는 단계까지 이어갈 수 있었다.
작은 수정까지 매번 여러 도구로 나눌 필요는 없다. 간단한 변경은 짧게 처리하고, 여러 기능이 맞물리거나 수정이 반복되는 작업에 이런 구성을 쓴다. 역할을 나누는 목적은 도구를 많이 쓰는 데 있지 않고, 처음 정한 방향을 잃지 않고 작업을 이어가는 데 있다.
처음부터 큰 서비스일 필요는 없다
여기까지 읽으면 여러 도구를 연결하고 지원 프로그램까지 만들어야 AI를 잘 활용하는 것처럼 보일 수 있다. 하지만 처음부터 이런 구성을 갖출 필요는 없다. 평소 반복하던 일 하나를 고르는 편이 오히려 시작하기 쉽다.
여러 문서에서 필요한 내용을 모으는 일, 요청을 일정한 형식으로 정리하는 일, 수정한 부분과 확인 결과를 한곳에 모으는 일 모두 출발점이 될 수 있다. 익숙한 업무라면 어떤 결과가 나와야 하는지 알고 있으므로, AI가 준비한 내용이 쓸 만한지도 판단하기 수월하다.
필자는 몇 번 해보다가 비슷한 요청을 계속 작성하게 되면, 그 부분을 도구로 묶을 수 있을지 살펴본다. 매번 설명하던 조건을 미리 정해두고, 필요한 자료를 가져오고, 결과를 다음 작업에 전달하도록 만드는 것이다. 앞서 소개한 개발 업무 지원 도구도 이런 반복을 하나의 기능으로 연결한 사례다.
모든 과정에 AI가 들어가야 하는 것도 아니다. 문서의 의미를 읽고 내용을 정리하는 데는 AI를 활용하되, 파일을 옮기거나 정해진 검사를 실행하는 일은 일반 프로그램이 맡을 수 있다. AI에게 매번 같은 부탁을 하는 대신, 반복해서 쓸 수 있는 프로그램을 만드는 데 AI의 도움을 받는 방법도 있다.
만든 것을 평가할 때는 코드가 나오는 속도만 보지 않으려 한다. 요청을 준비하는 시간, 결과를 검토하는 시간, 잘못된 부분을 다시 고치는 수고까지 포함해야 한다. 처음에는 빨라 보여도 뒤에서 다시 정리할 일이 많아진다면 전체 업무가 줄었다고 말하기 어렵다. 반대로 작은 자동화라도 매번 자료를 찾아 옮기던 일을 덜어준다면 꾸준히 쓸 이유가 생긴다.
또 하나 구분할 것은 ‘한 번 돌아가는 것’과 ‘계속 쓸 수 있는 것’이다. AI 덕분에 가능성을 확인하는 시제품, 흔히 말하는 POC(Proof of Concept)를 만드는 부담은 줄었다. 하지만 내 컴퓨터에서 한 번 잘된 기능을 다른 사람에게 제공하려면 예상하지 못한 입력과 접근 권한, 실패했을 때의 처리, 운영 비용까지 확인해야 한다.
그래서 처음에는 자료 조회나 초안 작성처럼 결과를 확인한 뒤 다음 단계로 넘길 수 있는 일부터 맡긴다. 충분히 살펴본 다음 필요한 기능을 넓혀가는 식이다. 작게 시작한다는 말은 목표를 작게 잡는다는 뜻이 아니다. 무엇이 잘되고 무엇을 더 고쳐야 하는지 확인할 수 있는 크기로 시작한다는 뜻이다.
AI와 함께 달라지는 개발자의 역할
이런 작업을 하다 보니 개발자의 역할에 관한 이야기도 조금 다르게 읽힌다. 코드를 직접 입력하는 시간이 줄어들면 그 자리를 어떤 일이 채우게 될까 하는 질문이다.
Claude Code를 만든 보리스 체르니(Boris Cherny)는 2026년 5월 26일 게재된 Platformer 인터뷰에서 당시 6개월 넘게 코드를 직접 쓰지 않았다고 말했다. 다만 이는 자신이 다루는 비교적 단순한 코드베이스에서의 경험이며, 크고 복잡한 기업 코드베이스에서는 모델이 여전히 실수한다고 설명했다. 구현을 맡기더라도 사용자와 이야기하고, 다음에 무엇을 만들지 고민하고, 문제를 해결하는 일은 남는다는 것이다.
안드레이 카르파티(Andrej Karpathy)가 2026년 4월 30일 개인 블로그에 공개한 Sequoia Ascent 2026 대담 정리에서도 비슷한 변화가 나타난다. 이 글은 대담 전사본을 AI로 요약·정리한 뒤 카르파티 본인이 읽고 검토해 게시한 것이다. 카르파티는 코드 몇 줄보다 기능 구현이나 테스트처럼 더 큰 작업을 AI에게 맡기게 됐다고 말하면서, 사람은 무엇을 요청해야 하는지 알고 만들어진 프로그램의 구성이 타당한지 판단해야 한다고 강조한다. 세부 구현은 맡길 수 있어도 기본 원리를 이해하는 일까지 없어지지는 않는다는 설명이다.
이런 사례를 보면 앞으로 AI에게 맡기는 범위는 코드 일부에서 하나의 일감으로 넓어질 것으로 보인다. 필요한 내용을 조사하고, 수정하고, 결과를 확인하는 과정이 지금보다 자연스럽게 이어지는 것이다. 물론 모든 프로젝트에 같은 방식이 통하지는 않는다. 오래된 프로그램이나 여러 서비스가 복잡하게 얽힌 환경에서는 더 많은 확인이 필요할 것이다. 공개된 사례와 필자의 작업 경험을 바탕으로 한 예상이다.
문제를 정의하고 결과를 검토하는 일은 이전에도 개발자의 역할이었다. AI 때문에 갑자기 생긴 일은 아니다. 다만 반복적인 구현과 자료 정리의 일부를 맡길 수 있다면, 그동안 시간이 부족해 자세히 보지 못했던 부분에 더 신경 쓸 수 있다. 사용자가 정말 원하는 동작인지 다시 살펴보거나, 다른 해결 방법을 하나 더 시험해보는 식이다.
필자가 원하는 결과물의 모습을 먼저 그려보는 이유도 여기에 있다. 도구가 빠르게 무언가를 만들어도 무엇과 비교해야 하는지 모르면 방향을 판단하기 어렵다. 반대로 원하는 장면이 구체적이면 AI가 만든 결과를 실행해보고, 어긋난 부분을 찾아 고쳐갈 수 있다. 머릿속 생각을 실제로 확인할 수 있는 형태로 바꾸는 데 AI를 쓰는 셈이다.
새로운 방법은 주로 Threads나 기술 기사, 다른 개발자들의 사용기를 통해 접한다. 관심 가는 방법을 개인 작업에서 먼저 시험하고, 괜찮았던 방식을 업무에 연결하는 과정은 앞으로도 이어갈 생각이다. 도구 이름을 많이 아는 것보다, 직접 써보니 어떤 수고가 줄었고 무엇을 더 해볼 수 있었는지 설명할 수 있는 경험을 쌓고 싶다.
처음에는 AI가 코드를 얼마나 잘 작성하는지가 궁금했다. 지금은 일을 맡긴 뒤 무엇을 받아야 다음 일을 바로 시작할 수 있는지를 더 살핀다. 요청이 정리되고, 근거가 모이고, 검토 자료와 PR까지 준비되면 AI가 맡을 수 있는 일도 코드 밖으로 넓어진다. 코딩만 시키기엔 아까운 이유다.
부록 1. 참고 자료 및 출처
| Archify 코드 구조와 처리 흐름 시각화 | 공식 저장소: github.com/tt-a1i/archify 설치 및 에이전트 안내: Archify llms.txt |
| Aside 브라우저 작업과 접근 권한 관리 | 다운로드: aside.com/download 작업 안내: Aside 작업 안내 문서 CLI·MCP 연결: Aside 개발자 문서 에이전트 권한: Aside 보안·권한 문서 |
| REA 프로그램 구조와 동작 분석 | 공식 저장소: github.com/morluto/rea FAQ: rea.tools/faq 설치 안내: REA 설치 문서 |
| Hermes Agent 기본 설정과 외부 도구 연결 | 공식 저장소: github.com/NousResearch/hermes-agent 시작하기: Hermes Agent 퀵스타트 MCP 연결: Hermes Agent MCP 안내 |
| OMX 개발 작업 관리와 Hermes 연동 | 공식 저장소: github.com/Yeachan-Heo/oh-my-codex Hermes–OMX 연결: Hermes MCP 브리지 문서 |
| 보리스 체르니 인터뷰 Platformer · Casey Newton 인터뷰 2026년 5월 26일 게재 | Claude Code’s creator on the end of the software engineer |
| 안드레이 카르파티 대담 정리 개인 블로그 · 2026년 4월 30일 게시 카르파티가 AI로 정리하고 본인이 검토한 대담 요약 | Sequoia Ascent 2026 summary 대담 원영상(YouTube) |
부록 2. 소개한 도구 설치하고 시작하기
아래는 2026년 11월 6일 확인한 공식 문서를 바탕으로 정리한 기본 설치 방법이다. 필요한 도구 하나를 골라, 결과를 직접 확인할 수 있는 작은 작업부터 시작하면 된다.
명령은 터미널이나 PowerShell처럼 명령어를 입력하는 창에서 실행한다. 회사 컴퓨터라면 설치 정책과 외부 AI에 전달할 수 있는 자료 범위를 먼저 확인한다.
Archify: 코드와 설명을 그림으로 정리하기
아키파이는 코딩 에이전트에 ‘스킬’이라는 추가 기능을 설치해 사용하는 도구다. Node.js와 npm을 준비한 뒤 설치한다. 아래는 Codex에서 쓸 수 있도록 사용자 단위로 설치하는 예시다. 다른 에이전트를 쓴다면 공식 안내에 따라 설치 대상을 바꾸면 된다. (Archify 설치 안내)
npx skills@latest add https://archify.si --skill archify --agent codex --global --copy
설치 안내를 확인해 적용한 뒤, 에이전트에 “이 프로젝트의 로그인 처리 순서를 아키파이로 그려줘”처럼 작은 기능부터 요청해본다. 처음부터 프로젝트 전체를 그리기보다, 이미 알고 있는 흐름과 결과를 비교해보는 편이 확인하기 쉽다. (Archify GitHub)
Aside: 브라우저에서 자료 찾고 확인하기
공식 다운로드 페이지에서 Windows 또는 macOS용 설치 파일을 받아 설치한다. 실행 후 초기 설정을 마치고 작업에 사용할 웹사이트에 로그인하면, 브라우저 안에서 자료 조사 등을 시작할 수 있다. (Aside 다운로드)
본문처럼 다른 AI 도구와 연결하려면 Aside 개발자 설정에서 CLI(명령줄 도구)를 설치한다. 이후 연결할 도구의 MCP 설정에 실행 명령은 aside, 인수는 [“mcp”]로 등록한다. 개발자 설정에 실제 설치 경로가 표시된다면 그 경로를 사용한다.
처음에는 공개된 페이지의 내용을 정리하는 작업으로 시험해본다. 업무 계정을 연결할 때는 Settings > Agents에서 도구 권한을 확인하고, 자료 조회와 전송·수정 기능을 구분해 필요한 범위만 허용한다. (Aside Help Center)
REA: 프로그램의 구조와 동작 살펴보기
공식 설치 문서에서 지원하는 버전의 Node.js와 npm을 준비한다. 분석 대상 프로젝트 바깥의 신뢰할 수 있는 폴더에서 다음 명령을 실행한다. (REA 설치 문서)
npx rea-agents@latest setup
설정 화면에서 연결할 코딩 에이전트를 선택하고, 변경될 설정을 확인한 뒤 승인한다. 완료 안내에 따라 에이전트를 다시 실행하면 된다. 설치 과정에서 분석 도구 연결과 사용 지침이 함께 등록된다.
첫 작업은 분석 권한이 있는 작은 프로그램이나 공개된 예제로 시작한다. “전체를 분석해줘”보다 “이 버튼을 누른 뒤 어떤 처리가 이어지는지 찾아줘”처럼 질문을 좁히는 편이 좋다. 실행 파일 분석 등 작업 종류에 따라 별도의 분석 엔진이 필요할 수 있으므로, 대상에 맞는 준비 사항은 공식 문서를 확인한다. (REA FAQ)
Hermes Agent와 OMX: 설계와 구현을 나눠 진행하기
먼저 Hermes Agent를 설치한다. macOS와 Windows에서는 공식 Hermes Desktop 설치 프로그램을 이용할 수 있다. 설치한 뒤 다음 명령으로 사용할 AI 서비스와 인증 정보를 설정한다. 기본 대화가 정상적으로 되는지 확인한 다음 다른 도구를 연결하는 순서가 좋다. (Hermes Agent 퀵스타트)
hermes setup
OMX는 따로 설치한다. Node.js 20 이상과, 설치와 인증을 마친 Codex CLI가 필요하다. 아래는 OMX를 설치하고 사용자 단위로 설정한 뒤 설치 상태를 점검하는 명령이다. (OMX GitHub)
npm install -g oh-my-codex
omx setup --scope user
omx doctor
omx doctor는 설치와 설정 상태를 확인하는 명령이다. 실제 AI 요청까지 처리되는지는 작은 작업을 실행해 따로 확인한다. 여러 에이전트를 함께 실행하는 팀 기능은 macOS·Linux와 tmux 환경을 우선 권장하며, Windows에서는 WSL2 사용 등 공식 문서의 환경별 안내를 확인하는 편이 좋다.
두 도구를 함께 쓰려면 Hermes의 MCP 설정에 OMX를 추가로 등록한다. 실행 명령은 omx, 인수는 [“mcp-serve”, “hermes”]다. 작업을 허용할 프로젝트 경로도 제한해둔다. 이 연결을 통해 Hermes가 OMX에 작업을 전달하고 진행 상태와 결과물을 받아올 수 있다.
게임을 만드는 데는 몇 명이 필요할까?
기획자와 프로그래머, 아티스트 등 여러 직군이 모인 개발팀을 먼저 떠올리기 쉽다. 하지만 생성형 AI가 게임 개발 현장에 빠르게 들어오면서 이 익숙한 공식에도 변화가 시작되고 있다. 한 사람이 할 수 있는 일의 범위가 넓어지고, 머릿속 아이디어를 실제 게임으로 구현하는 데 필요한 시간도 빠르게 줄어들고 있기 때문이다.
그렇다면 앞으로 게임은 누가, 그리고 몇 명이 만들게 될까?
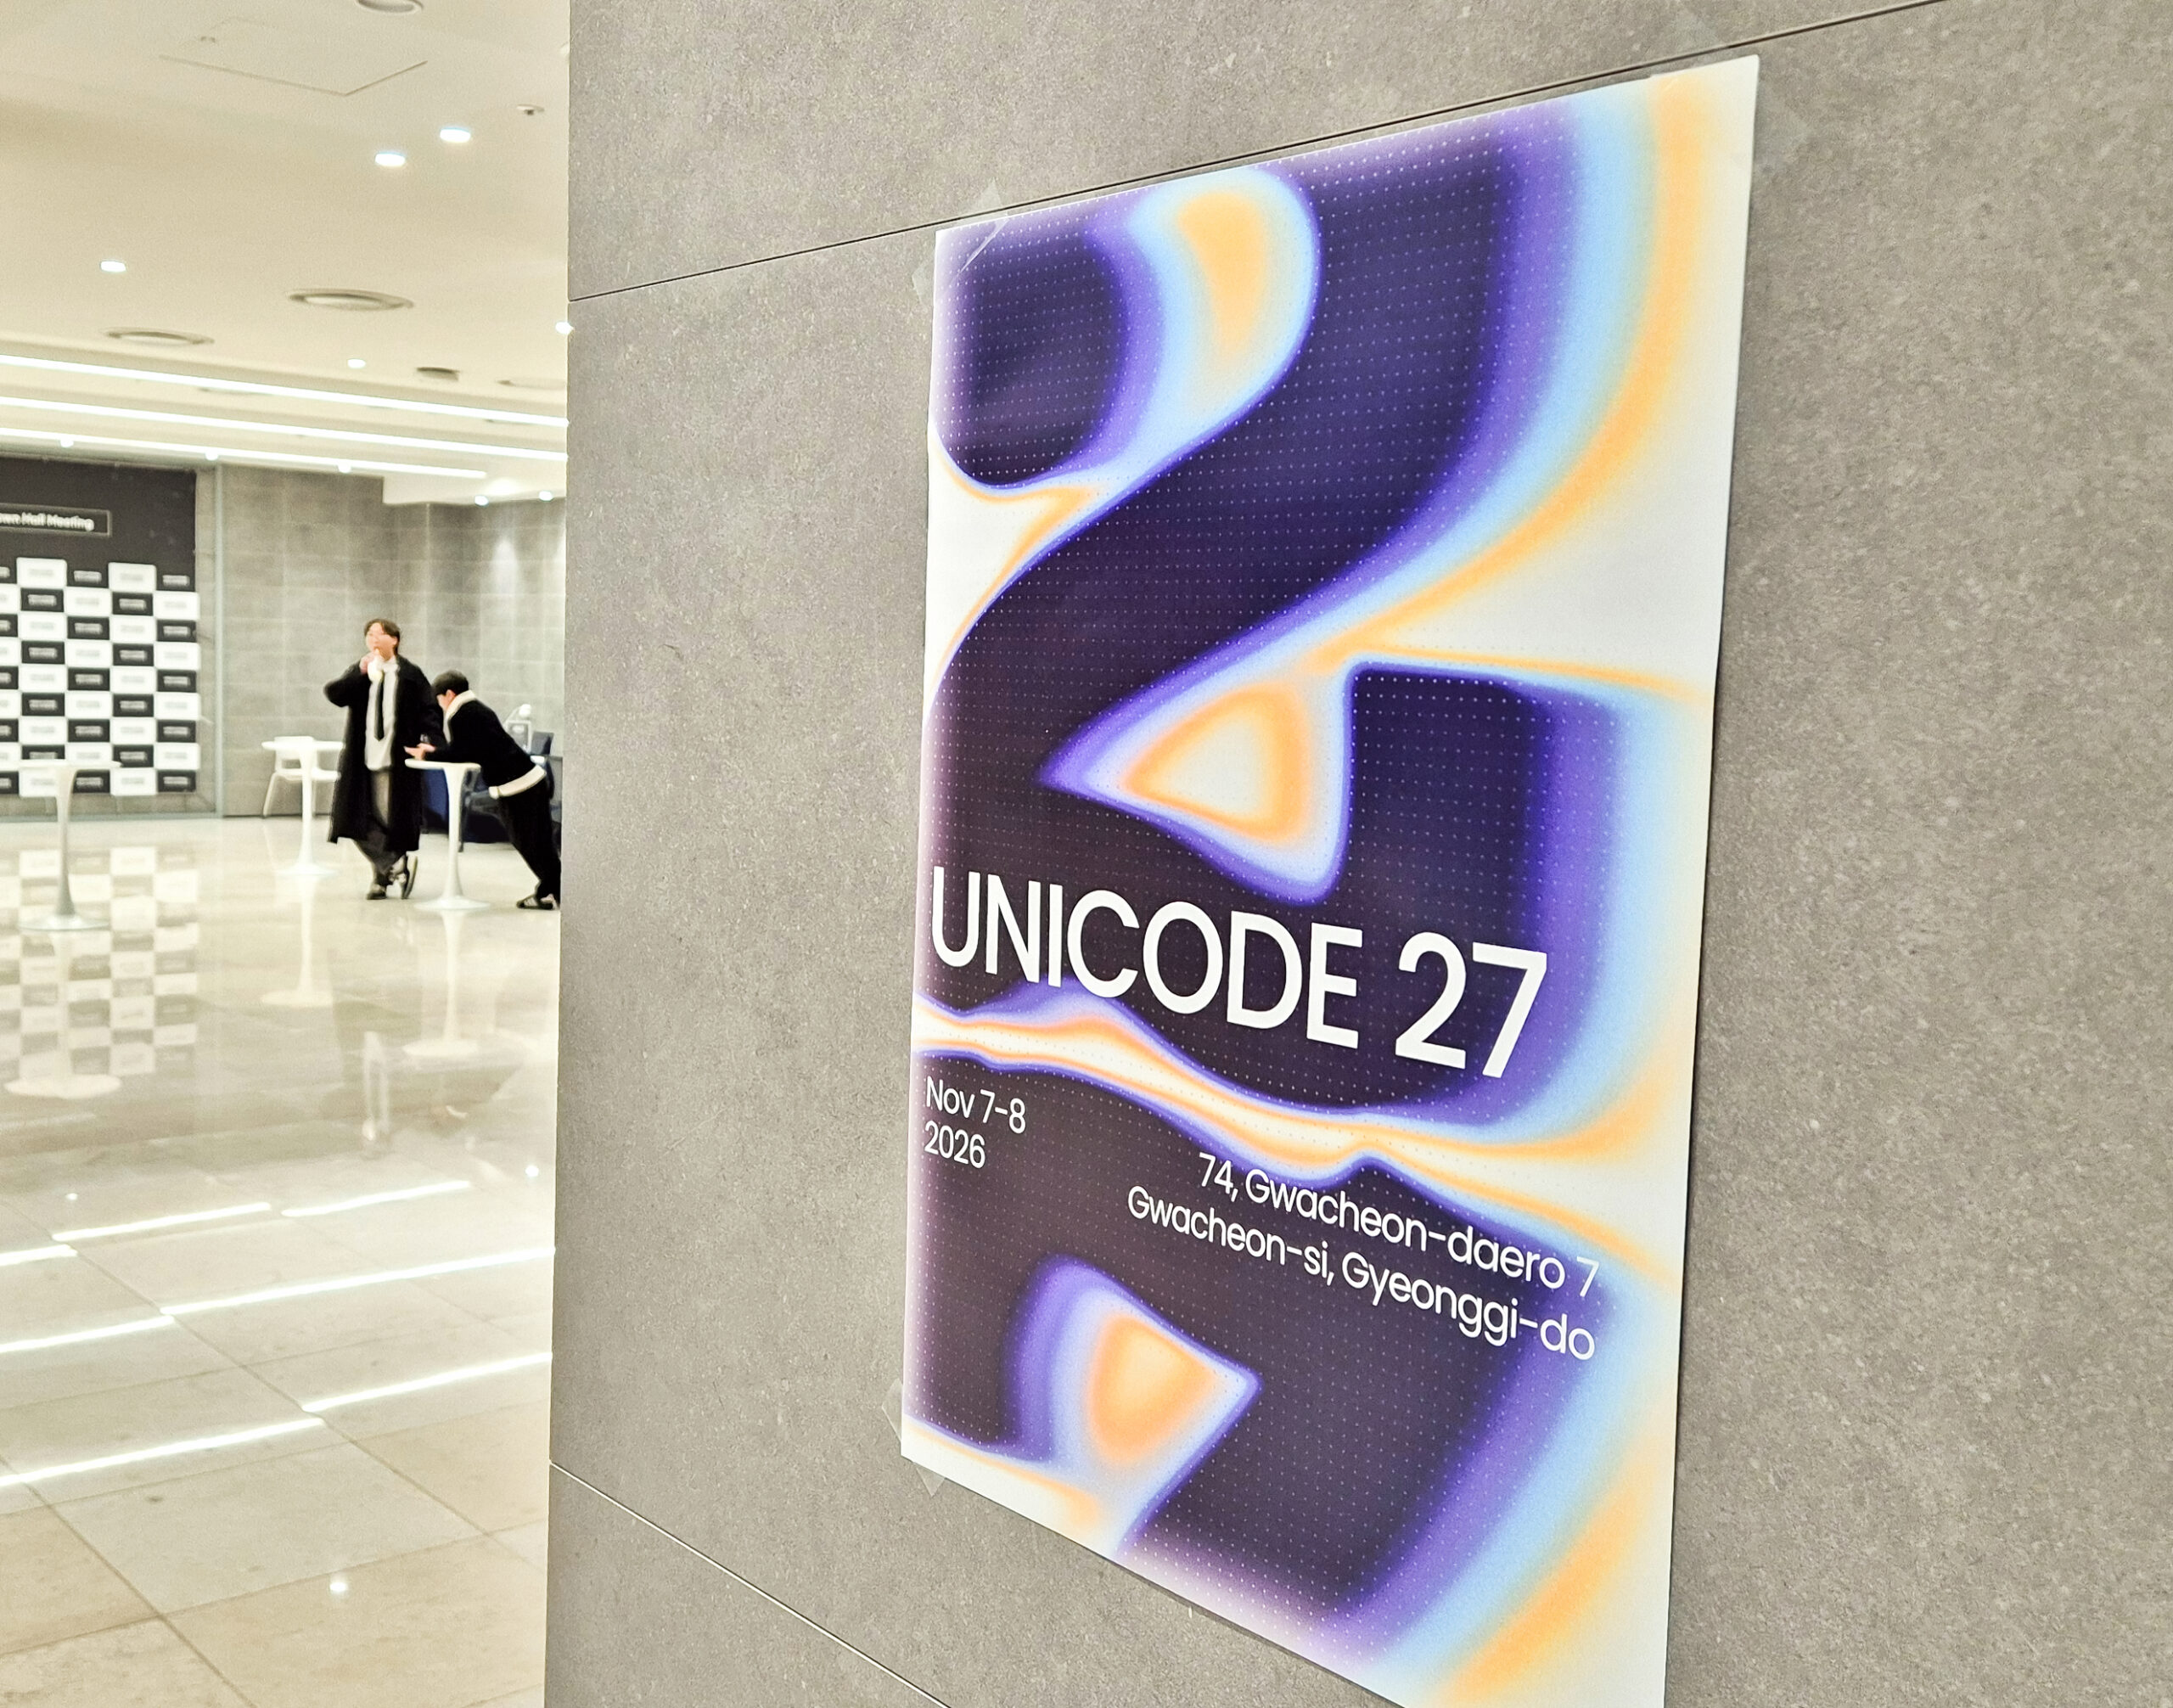
지난 11월 7일부터 8일까지 과천 메가존산학연센터에서 열린 전국 대학생 게임개발 동아리 연합 ‘유니데브(UNIDEV)’의 컨퍼런스 ‘유니코드27(UNICODE27)’에서 그 답을 들을 수 있었다.
행사장 곳곳에서 느껴지는 ‘게임人’ 아우라
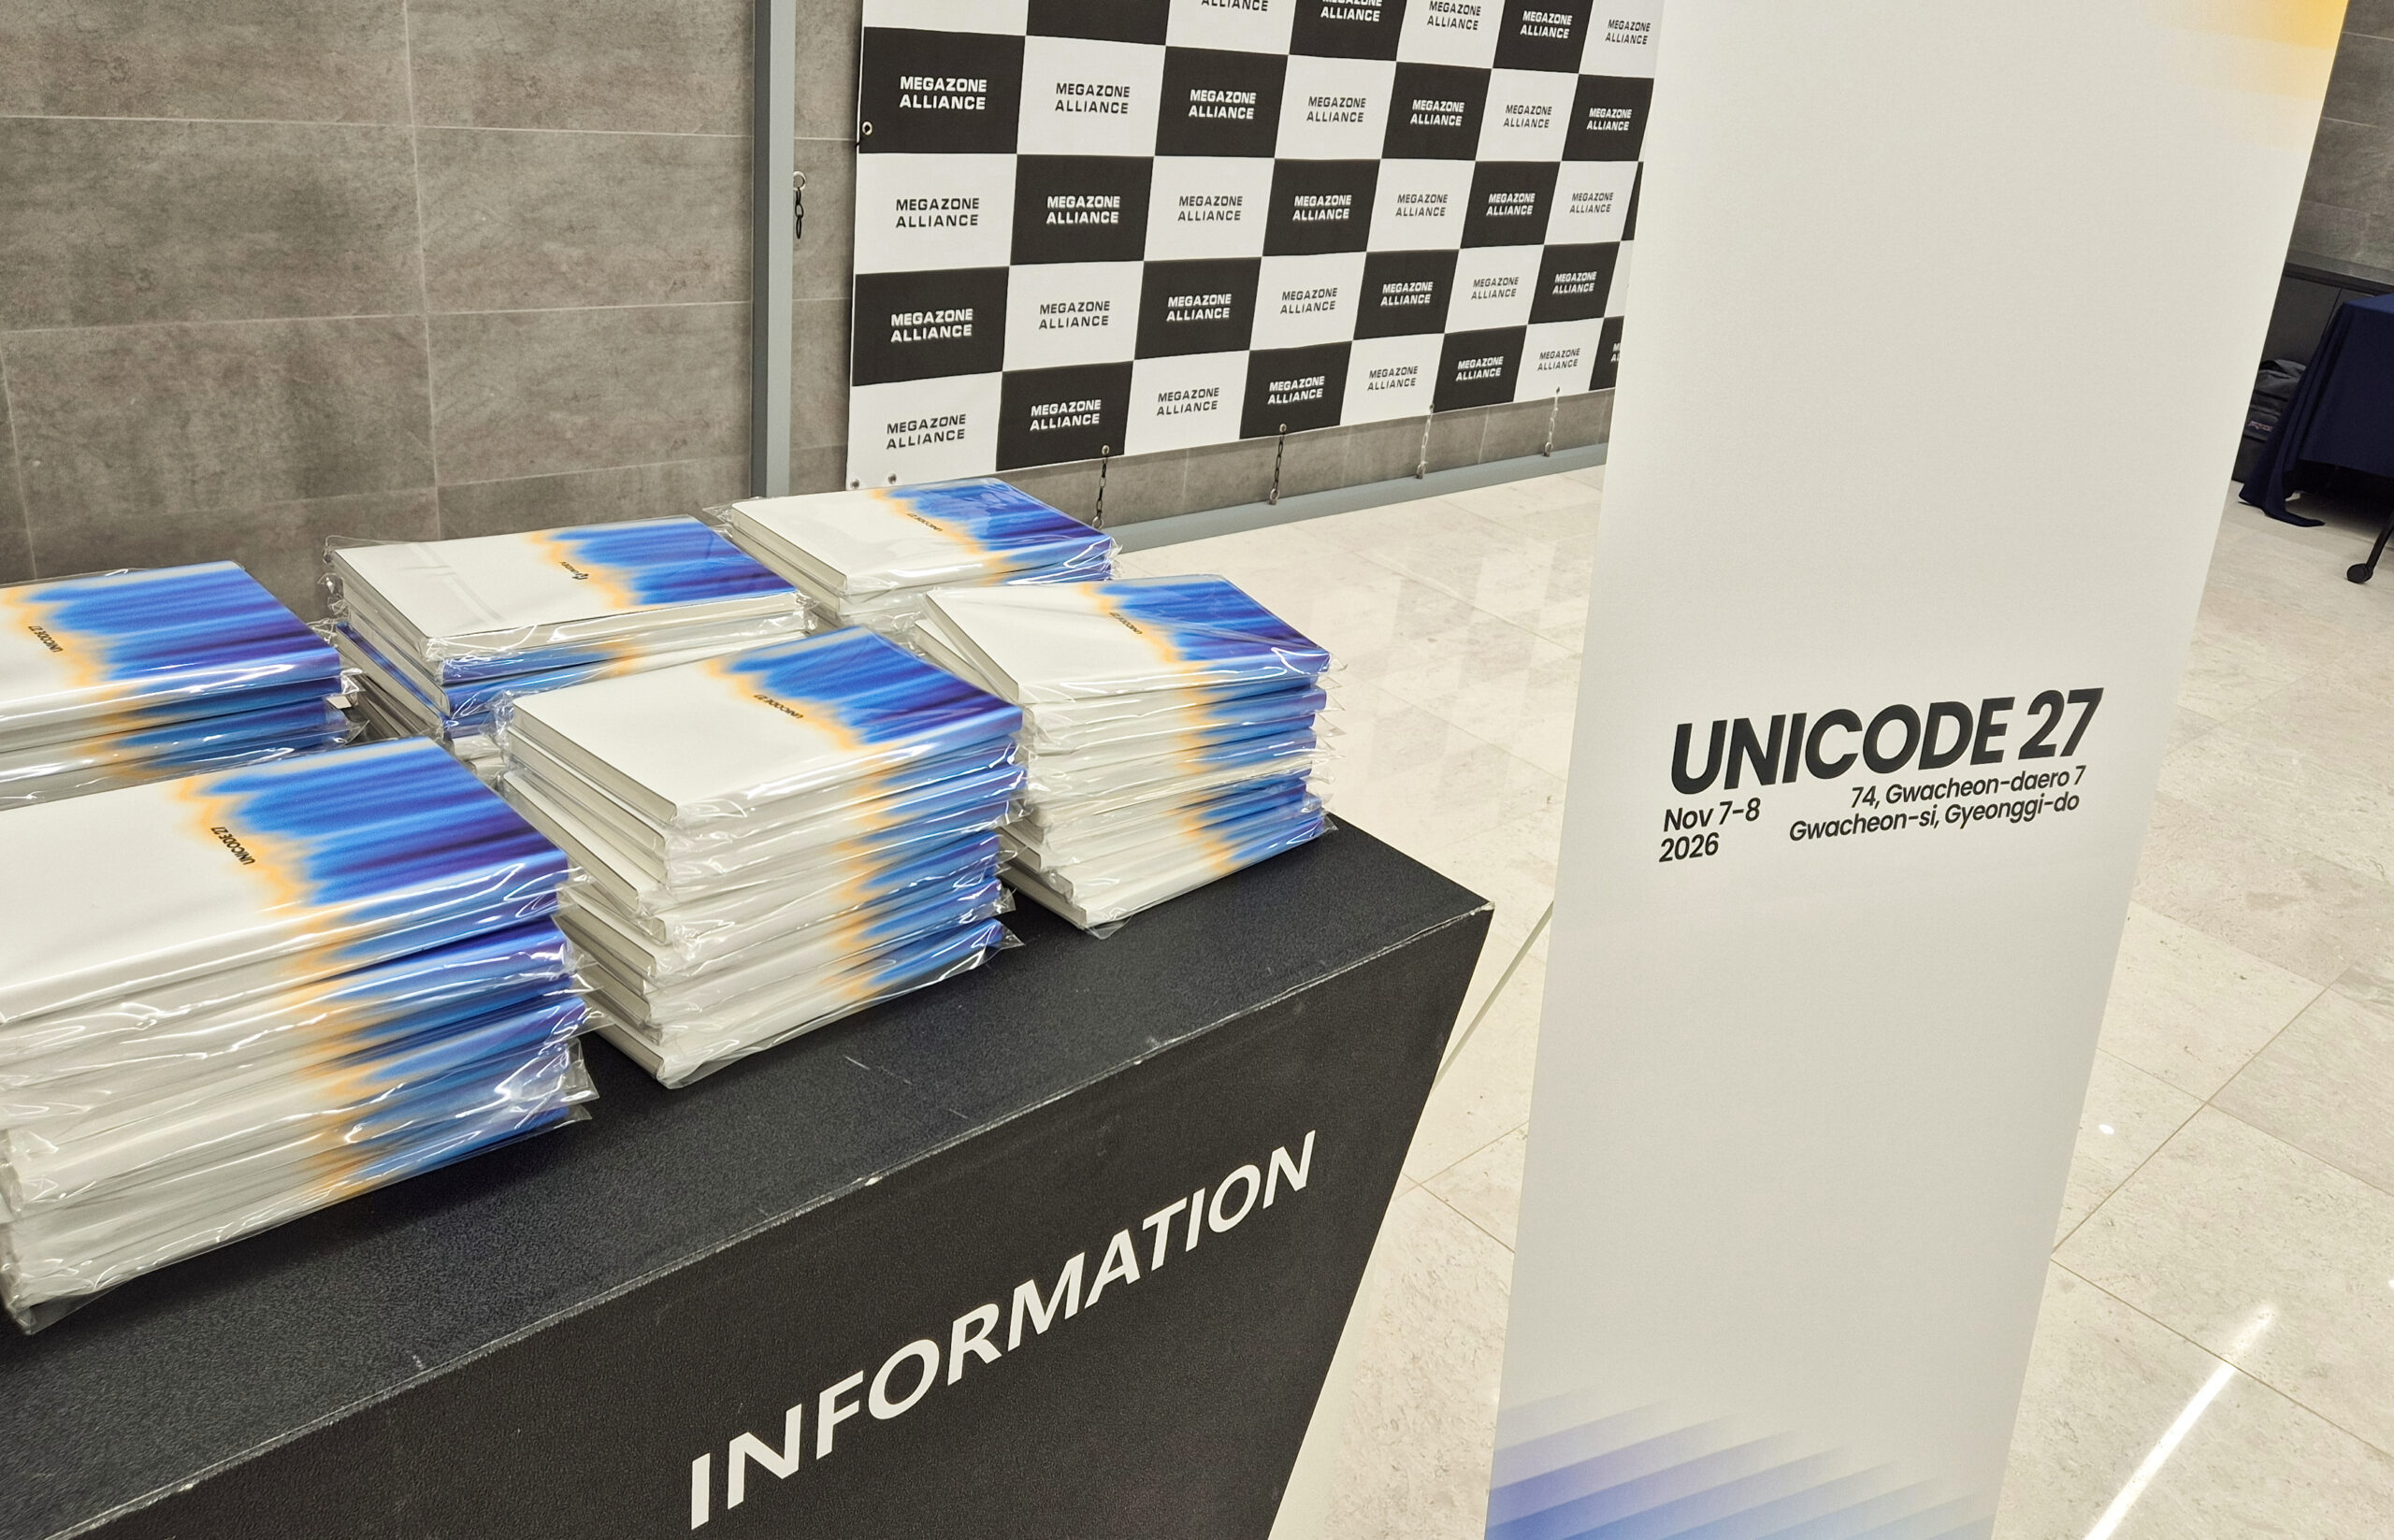
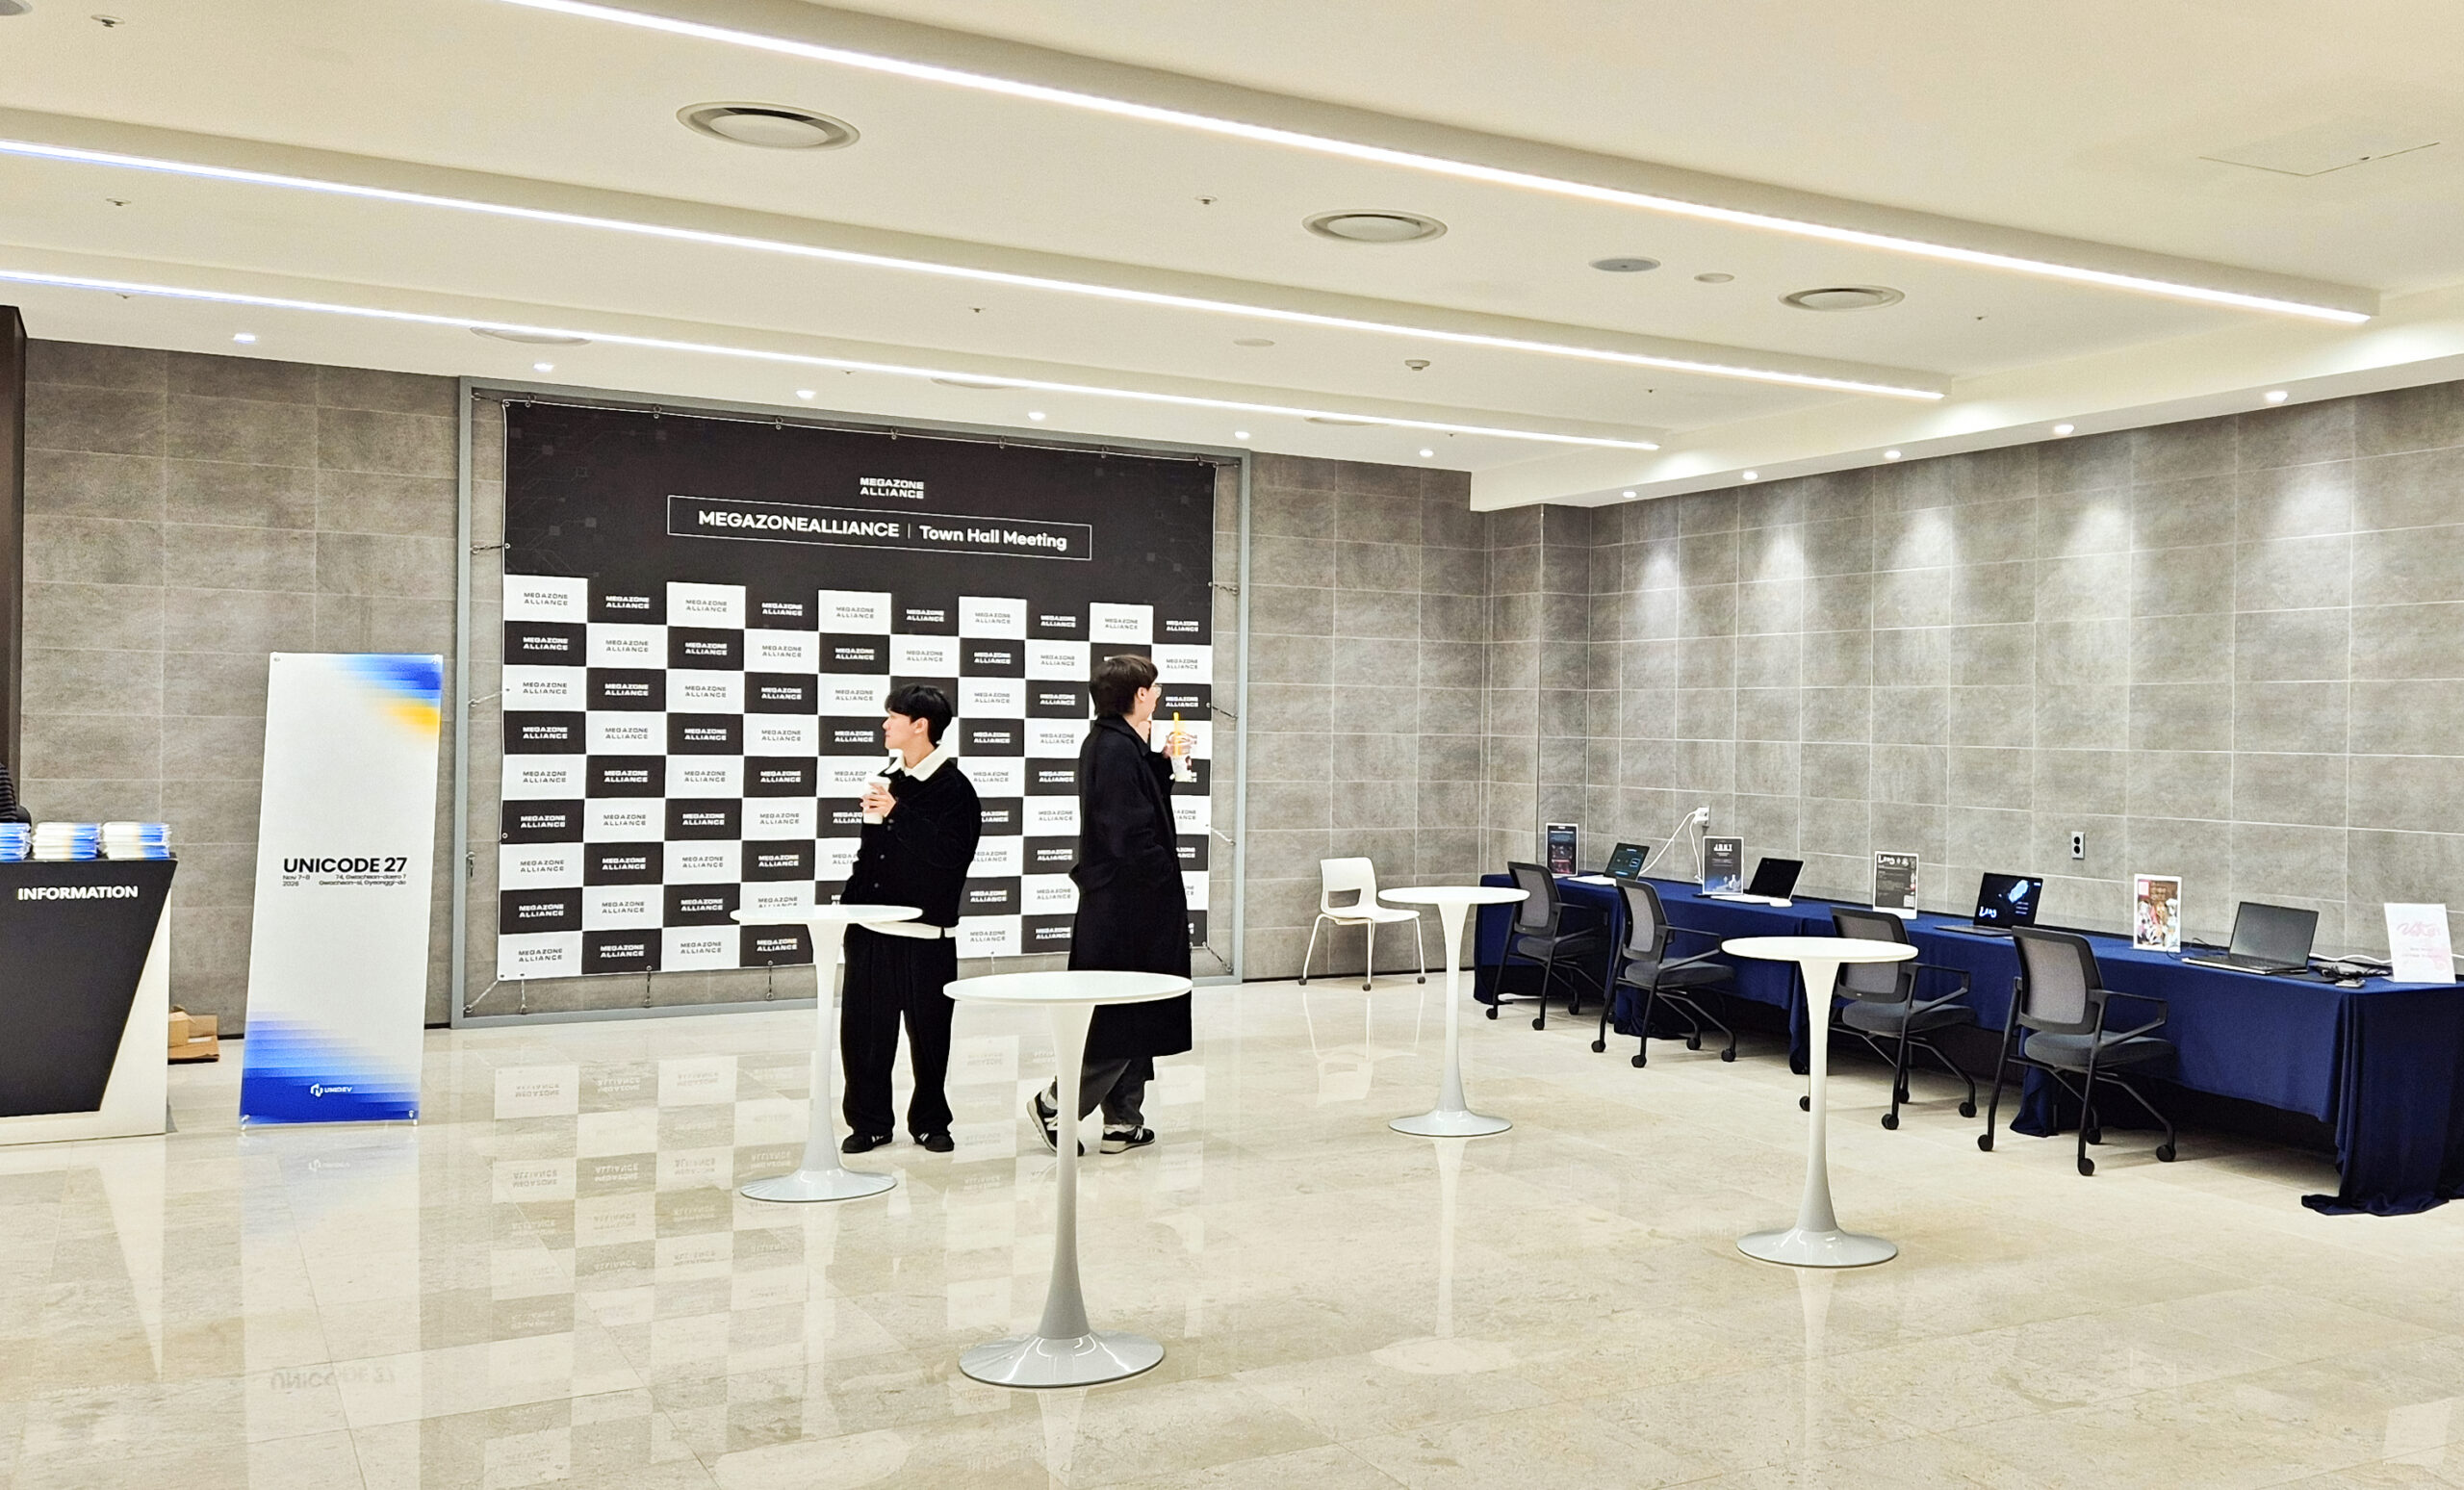
행사장에 들어서자 가장 먼저 참가자들을 맞이한 것은 유니코드27의 색깔을 담은 다양한 브랜딩이었다. 리셉션에는 행사 안내와 함께 참가자를 위한 굿즈가 마련됐고, 강연이 시작되기 한참 전부터도 몇몇 학생들이 도착해 행사장을 둘러보고 있었다.
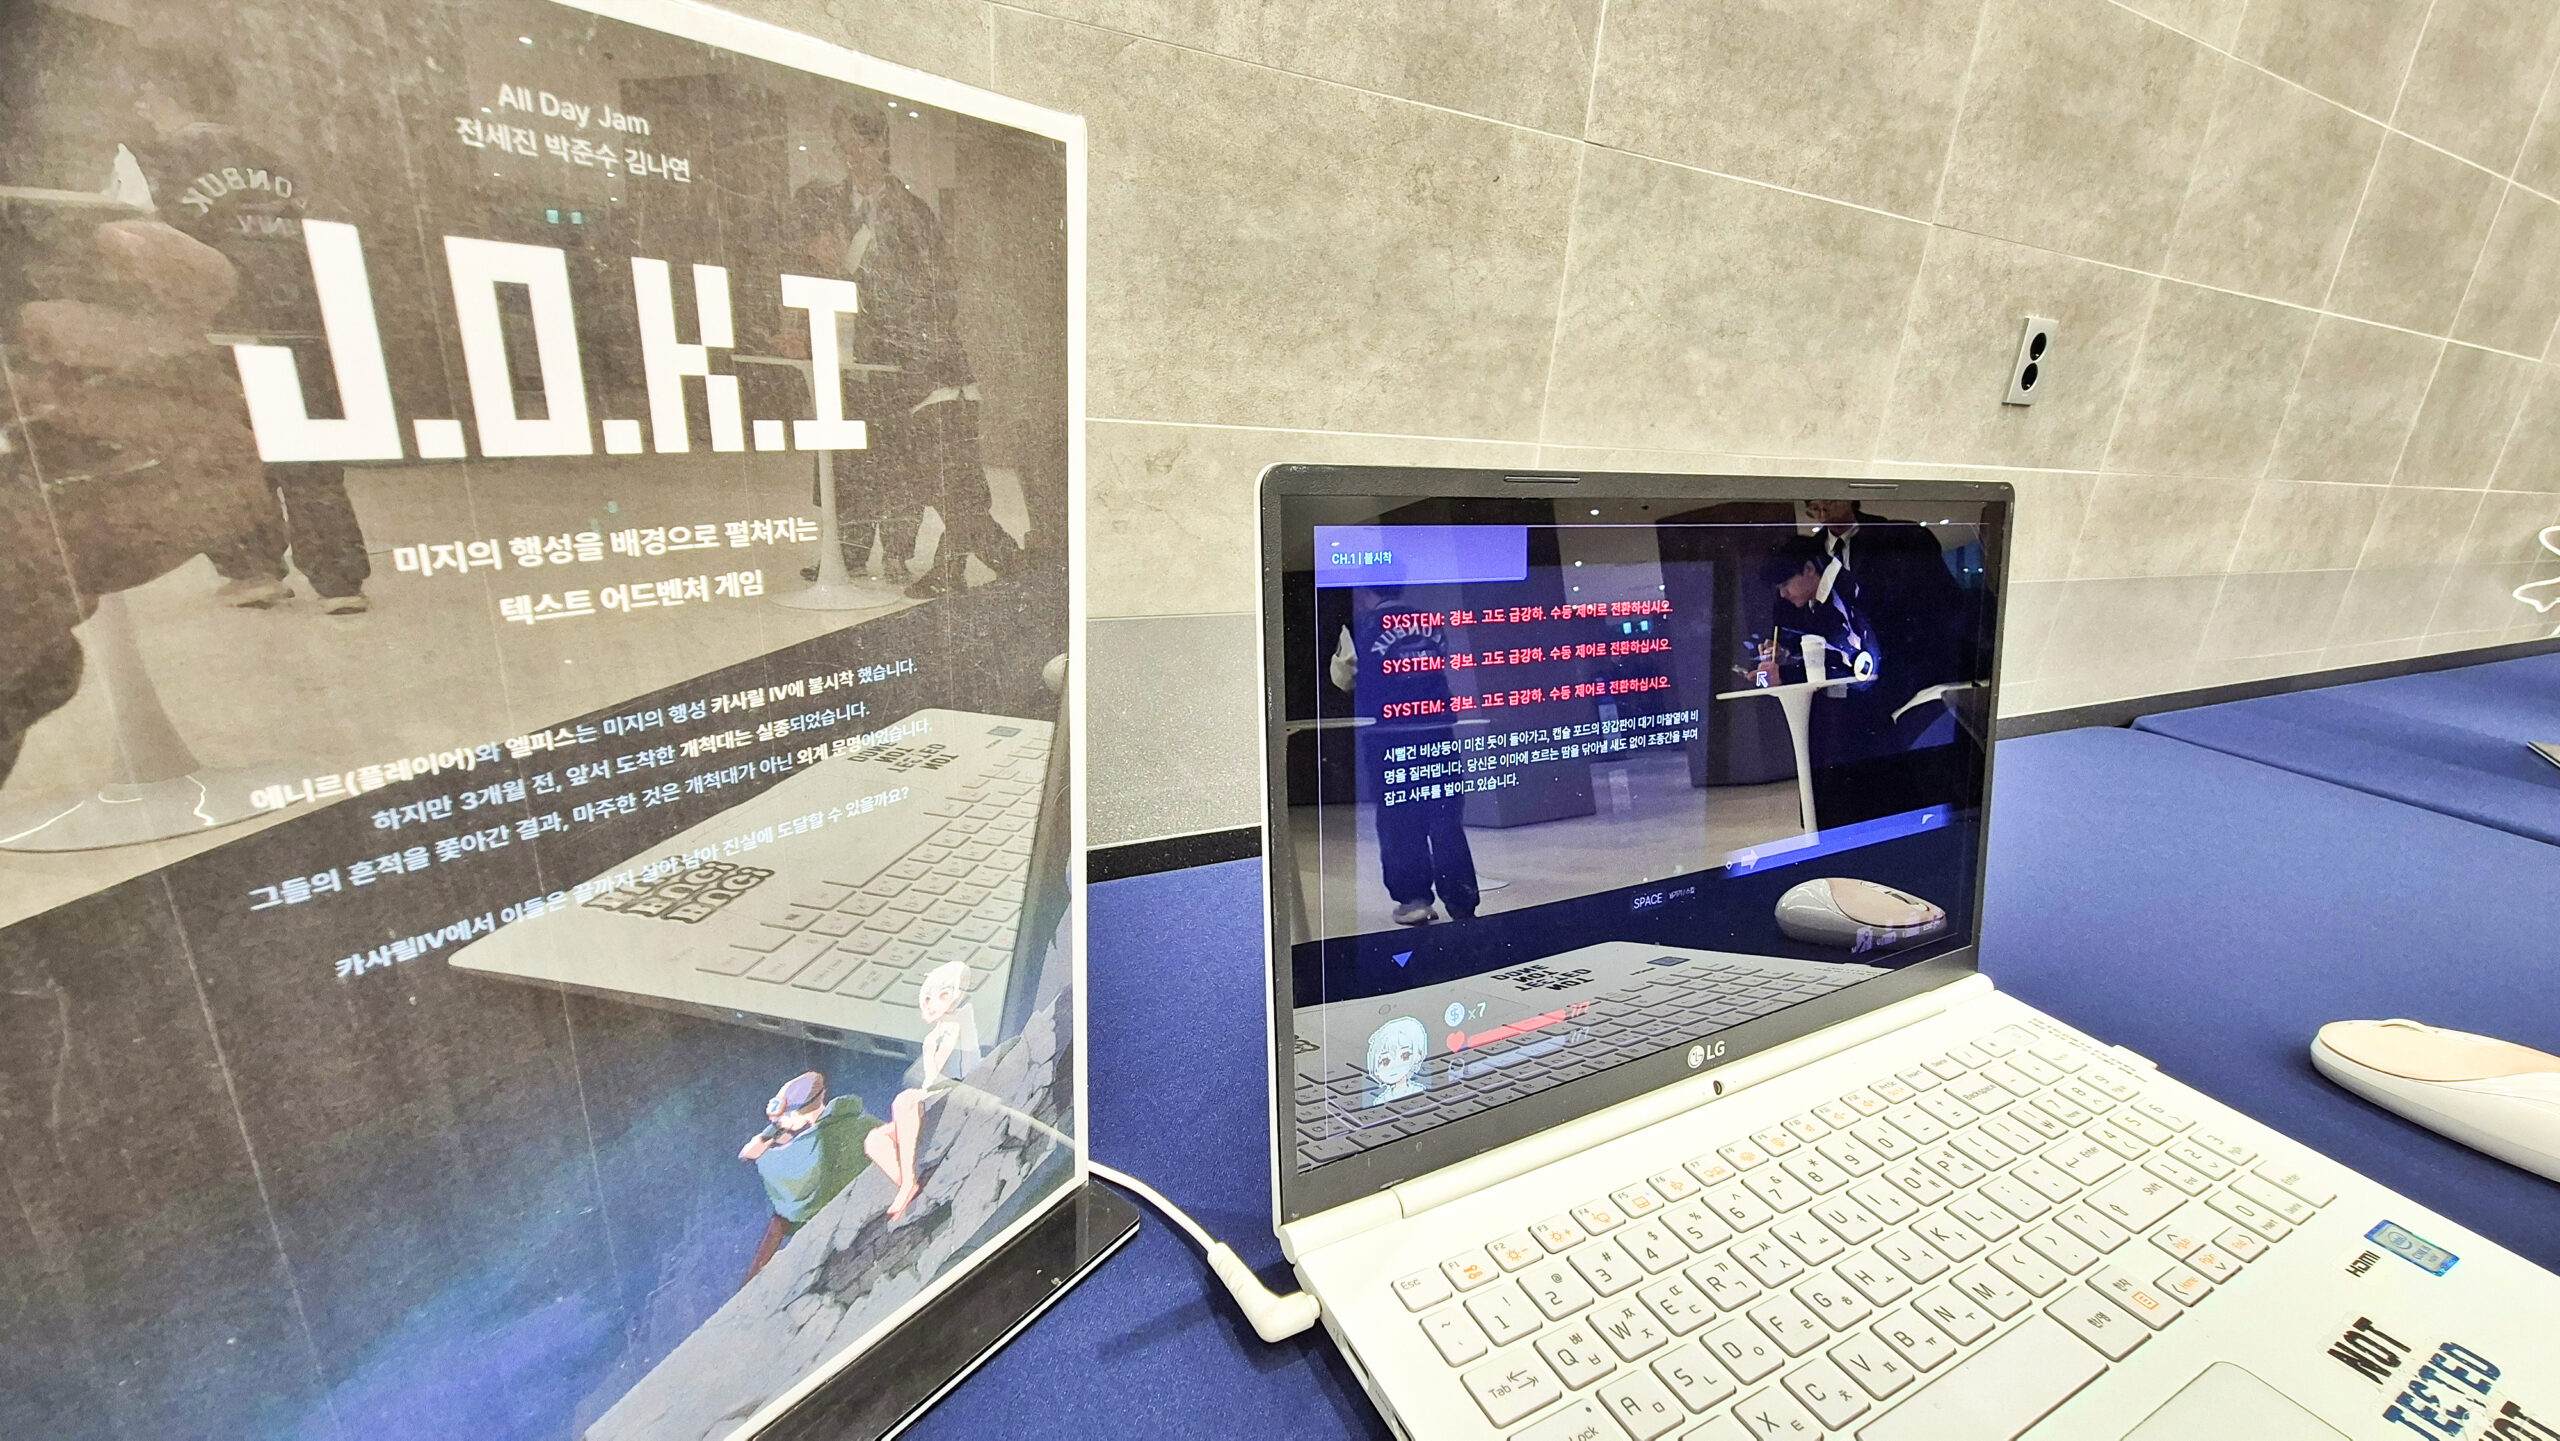
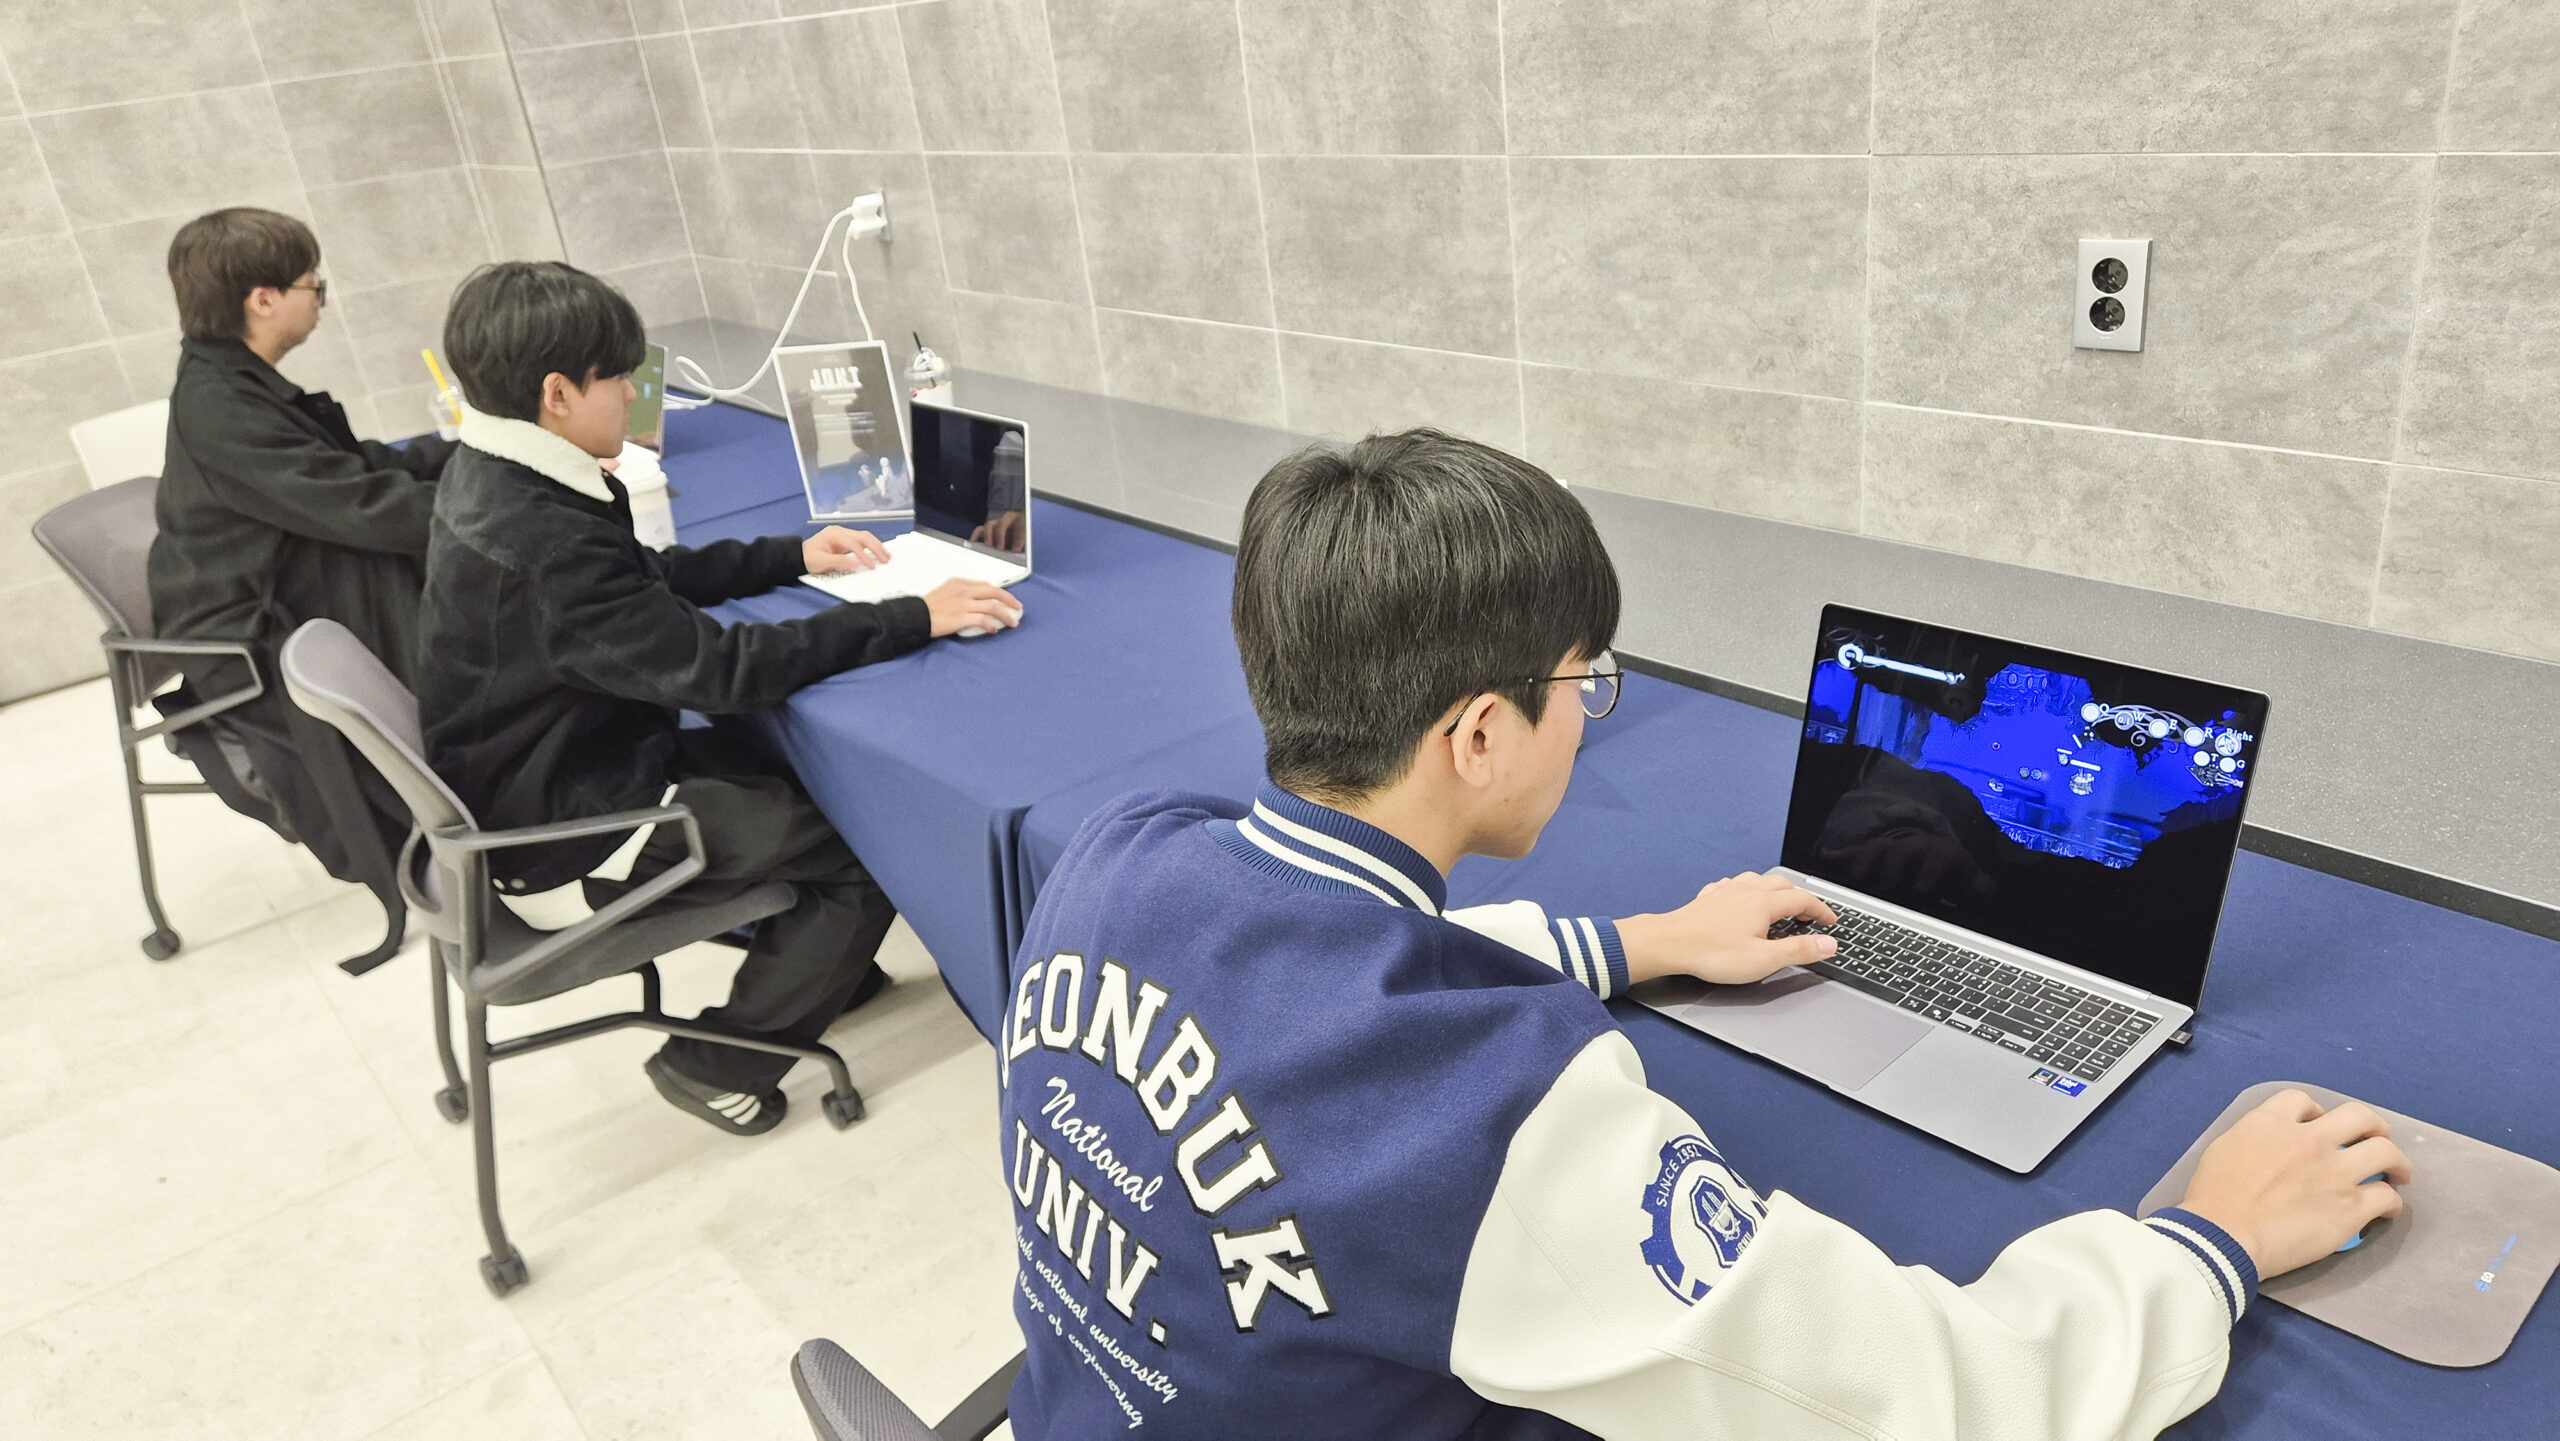
리셉션 옆쪽에는 대학생 게임 전시회 ‘유니콘(UNICON)’의 수상작들을 직접 플레이해볼 수 있는 시연대도 마련돼 있었다. 컨퍼런스가 시작되기 전, 키보드와 마우스를 잡고 게임을 직접 체험하는 참가자들도 있었다.
강연을 듣는 행사이면서 동시에 서로가 만든 결과물을 보여주고 경험을 나누는 자리. 본격적인 프로그램이 시작되기 전부터 ‘게임을 만드는 사람들의 행사’라는 분위기가 곳곳에서 느껴졌다.
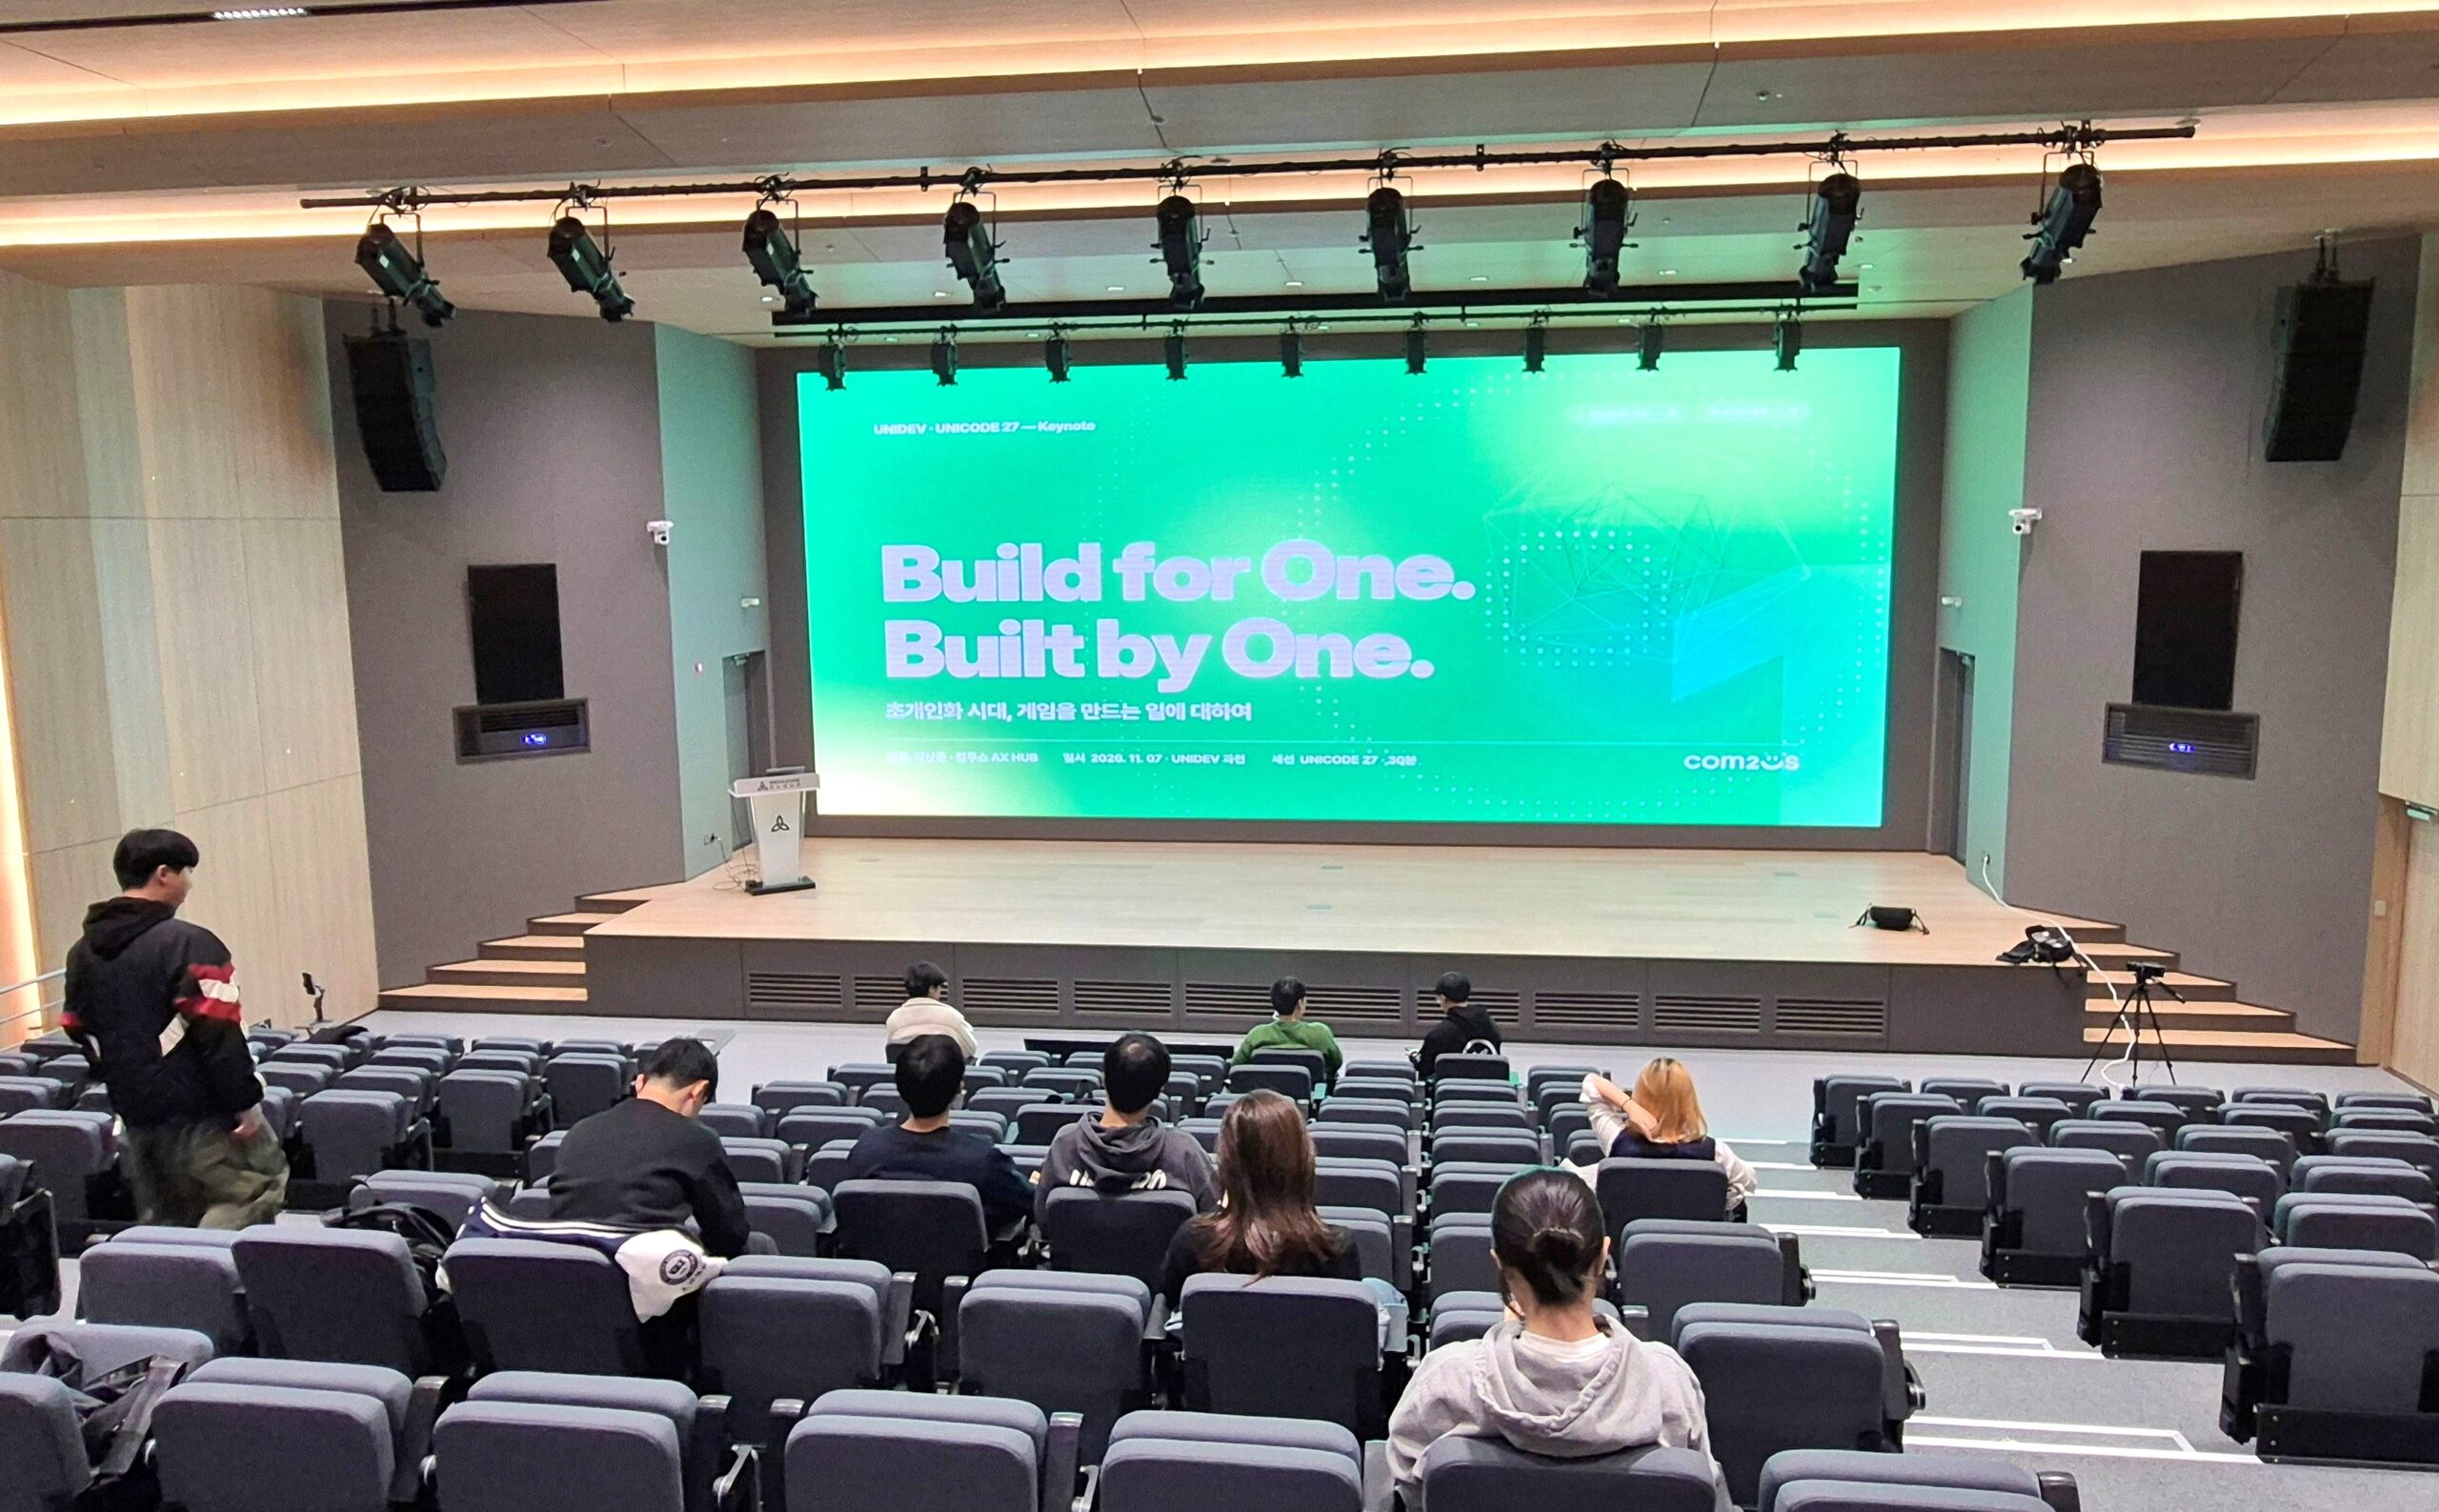
시간이 가까워지자 참가자들은 강연장으로 자리를 옮겼다.
이번 컨퍼런스에는 양일간 약 10여 명의 현업 개발자와 산업 전문가들이 연사로 나섰다. 그리고, 그 첫 번째 포문을 컴투스 AX HUB 리드인 박상준 이사가 열었다.
박상준 이사가 던진 질문은 단순했다.
“게임은 앞으로 누가, 몇 명이 만들게 될까?”
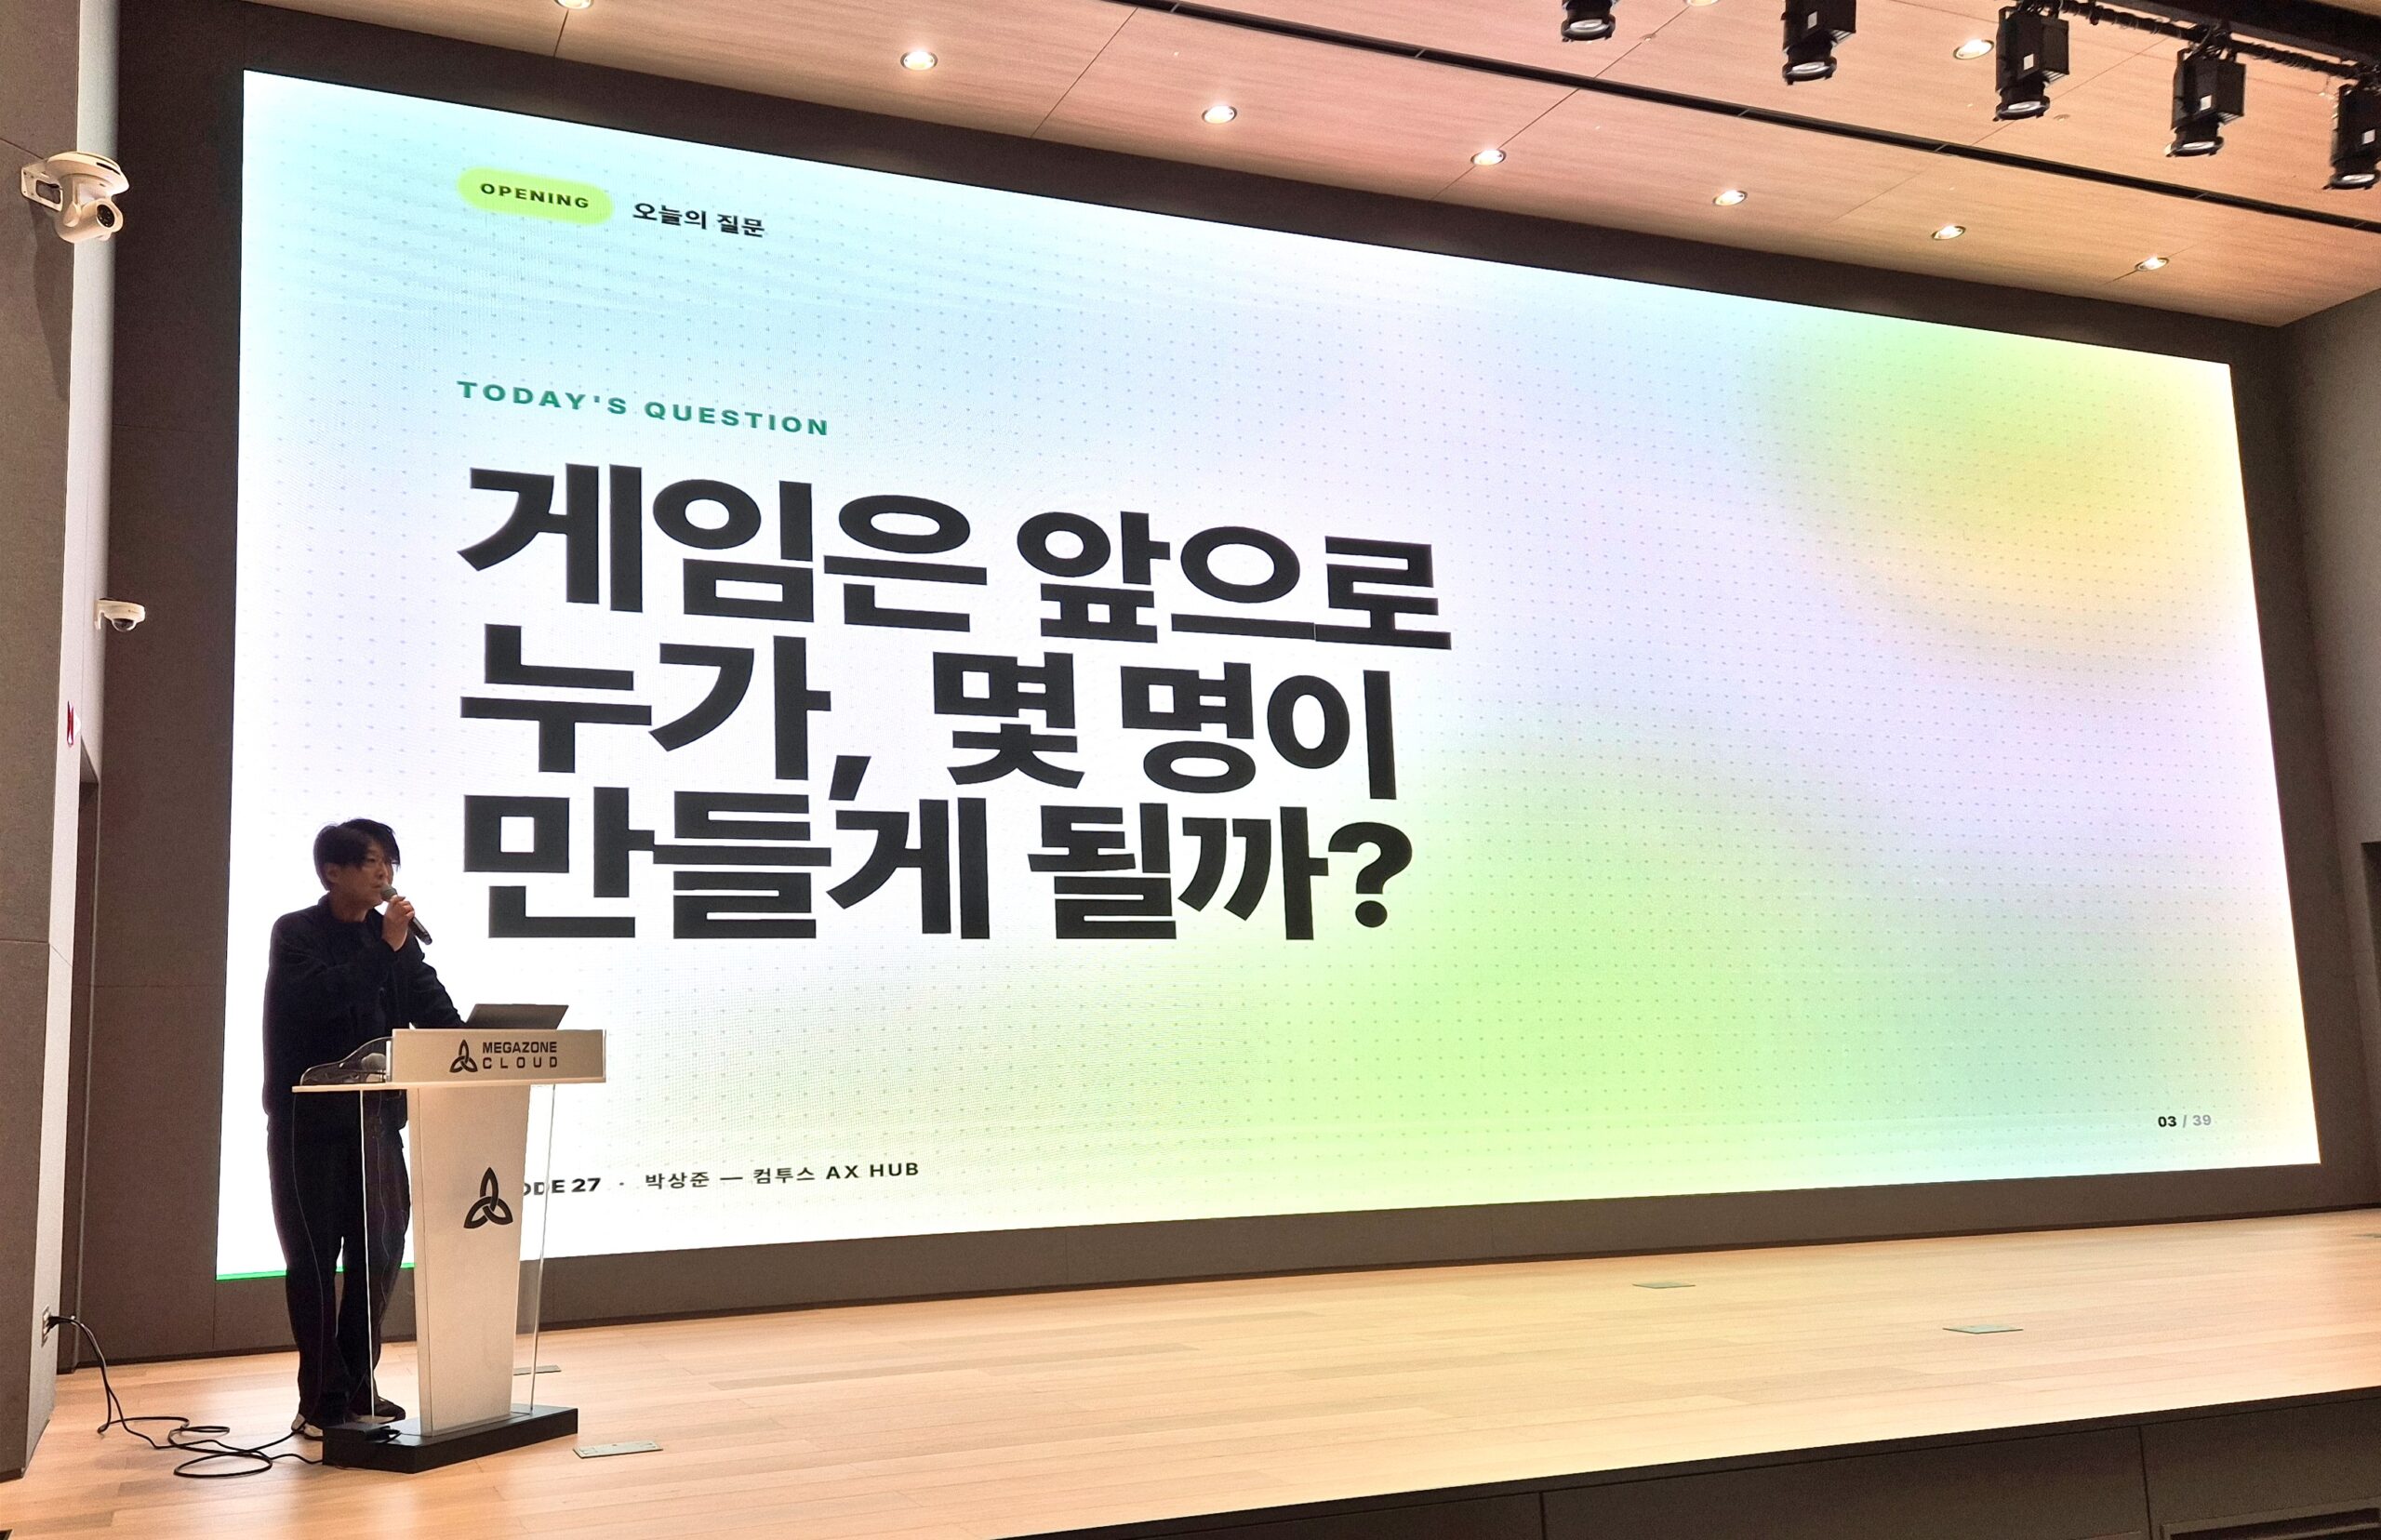
그리고 강연의 제목에는 그 질문에 대한 방향이 담겨 있었다.
Build for One. Built by One.
모두에게 같은 것을 보여주던 시대에서 ‘나를 위한 것’의 시대로
박상준 이사는 게임 이야기로 들어가기에 앞서, 콘텐츠가 만들어지고 소비되는 방식의 변화를 먼저 짚었다.
과거 방송은 정해진 시간에 모두에게 같은 콘텐츠를 전달하는 방식이었다. 만드는 쪽과 보는 쪽이 명확하게 나뉘어 있었고, 하나의 콘텐츠를 많은 사람이 함께 소비했다.
하지만 디지털 환경이 자리 잡으면서 상황은 달라졌다. 사용자의 취향과 경험, 맥락에 따라 서로 다른 콘텐츠를 접하는 ‘개인화’가 자연스러운 경험이 됐다.
강연에서는 이러한 변화의 한 사례로 코닥(Kodak)의 이야기도 등장했다. 기술의 변화 자체보다 중요한 것은 사진을 만들고 소비하는 방식이 변하고 있다는 사실을 읽는 것이라는 설명이다.
게임 역시 이 흐름에서 예외가 아니다.
개인의 취향에서 출발해 경험과 상황까지 반영하는 개인화가 점점 정교해지고 있다. 그리고 AI의 발전은 이 흐름을 콘텐츠를 ‘고르는 단계’에서 직접 ‘만드는 단계’까지 확장시키고 있다.
게임을 소비하던 팬이 직접 만드는 팬으로
이 변화는 이미 게임과 팬덤에서 빠르게 나타나고 있다.
강연에서는 ‘팬이 만든다(Fan Creation)’는 키워드와 함께 여러 사례가 소개됐다.
게임사가 배포한 캐릭터 3D 모델을 이용해 팬들이 새로운 콘텐츠를 만들어내는 사례부터, 캐릭터에 대한 팬들의 애정에서 출발한 2차 창작까지 다양했다.
‘승리의 여신: 니케’의 ‘도로롱’처럼 팬덤에서 탄생한 밈 캐릭터가 큰 인기를 얻고, 다시 게임을 만든 개발사와 연결되는 사례도 소개됐다. 팬들이 AI를 활용해 애니메이션을 만들거나, K팝 팬덤에서 AI로 음악과 영상을 제작해 자신들만의 콘텐츠를 만들어내는 현상도 등장했다.
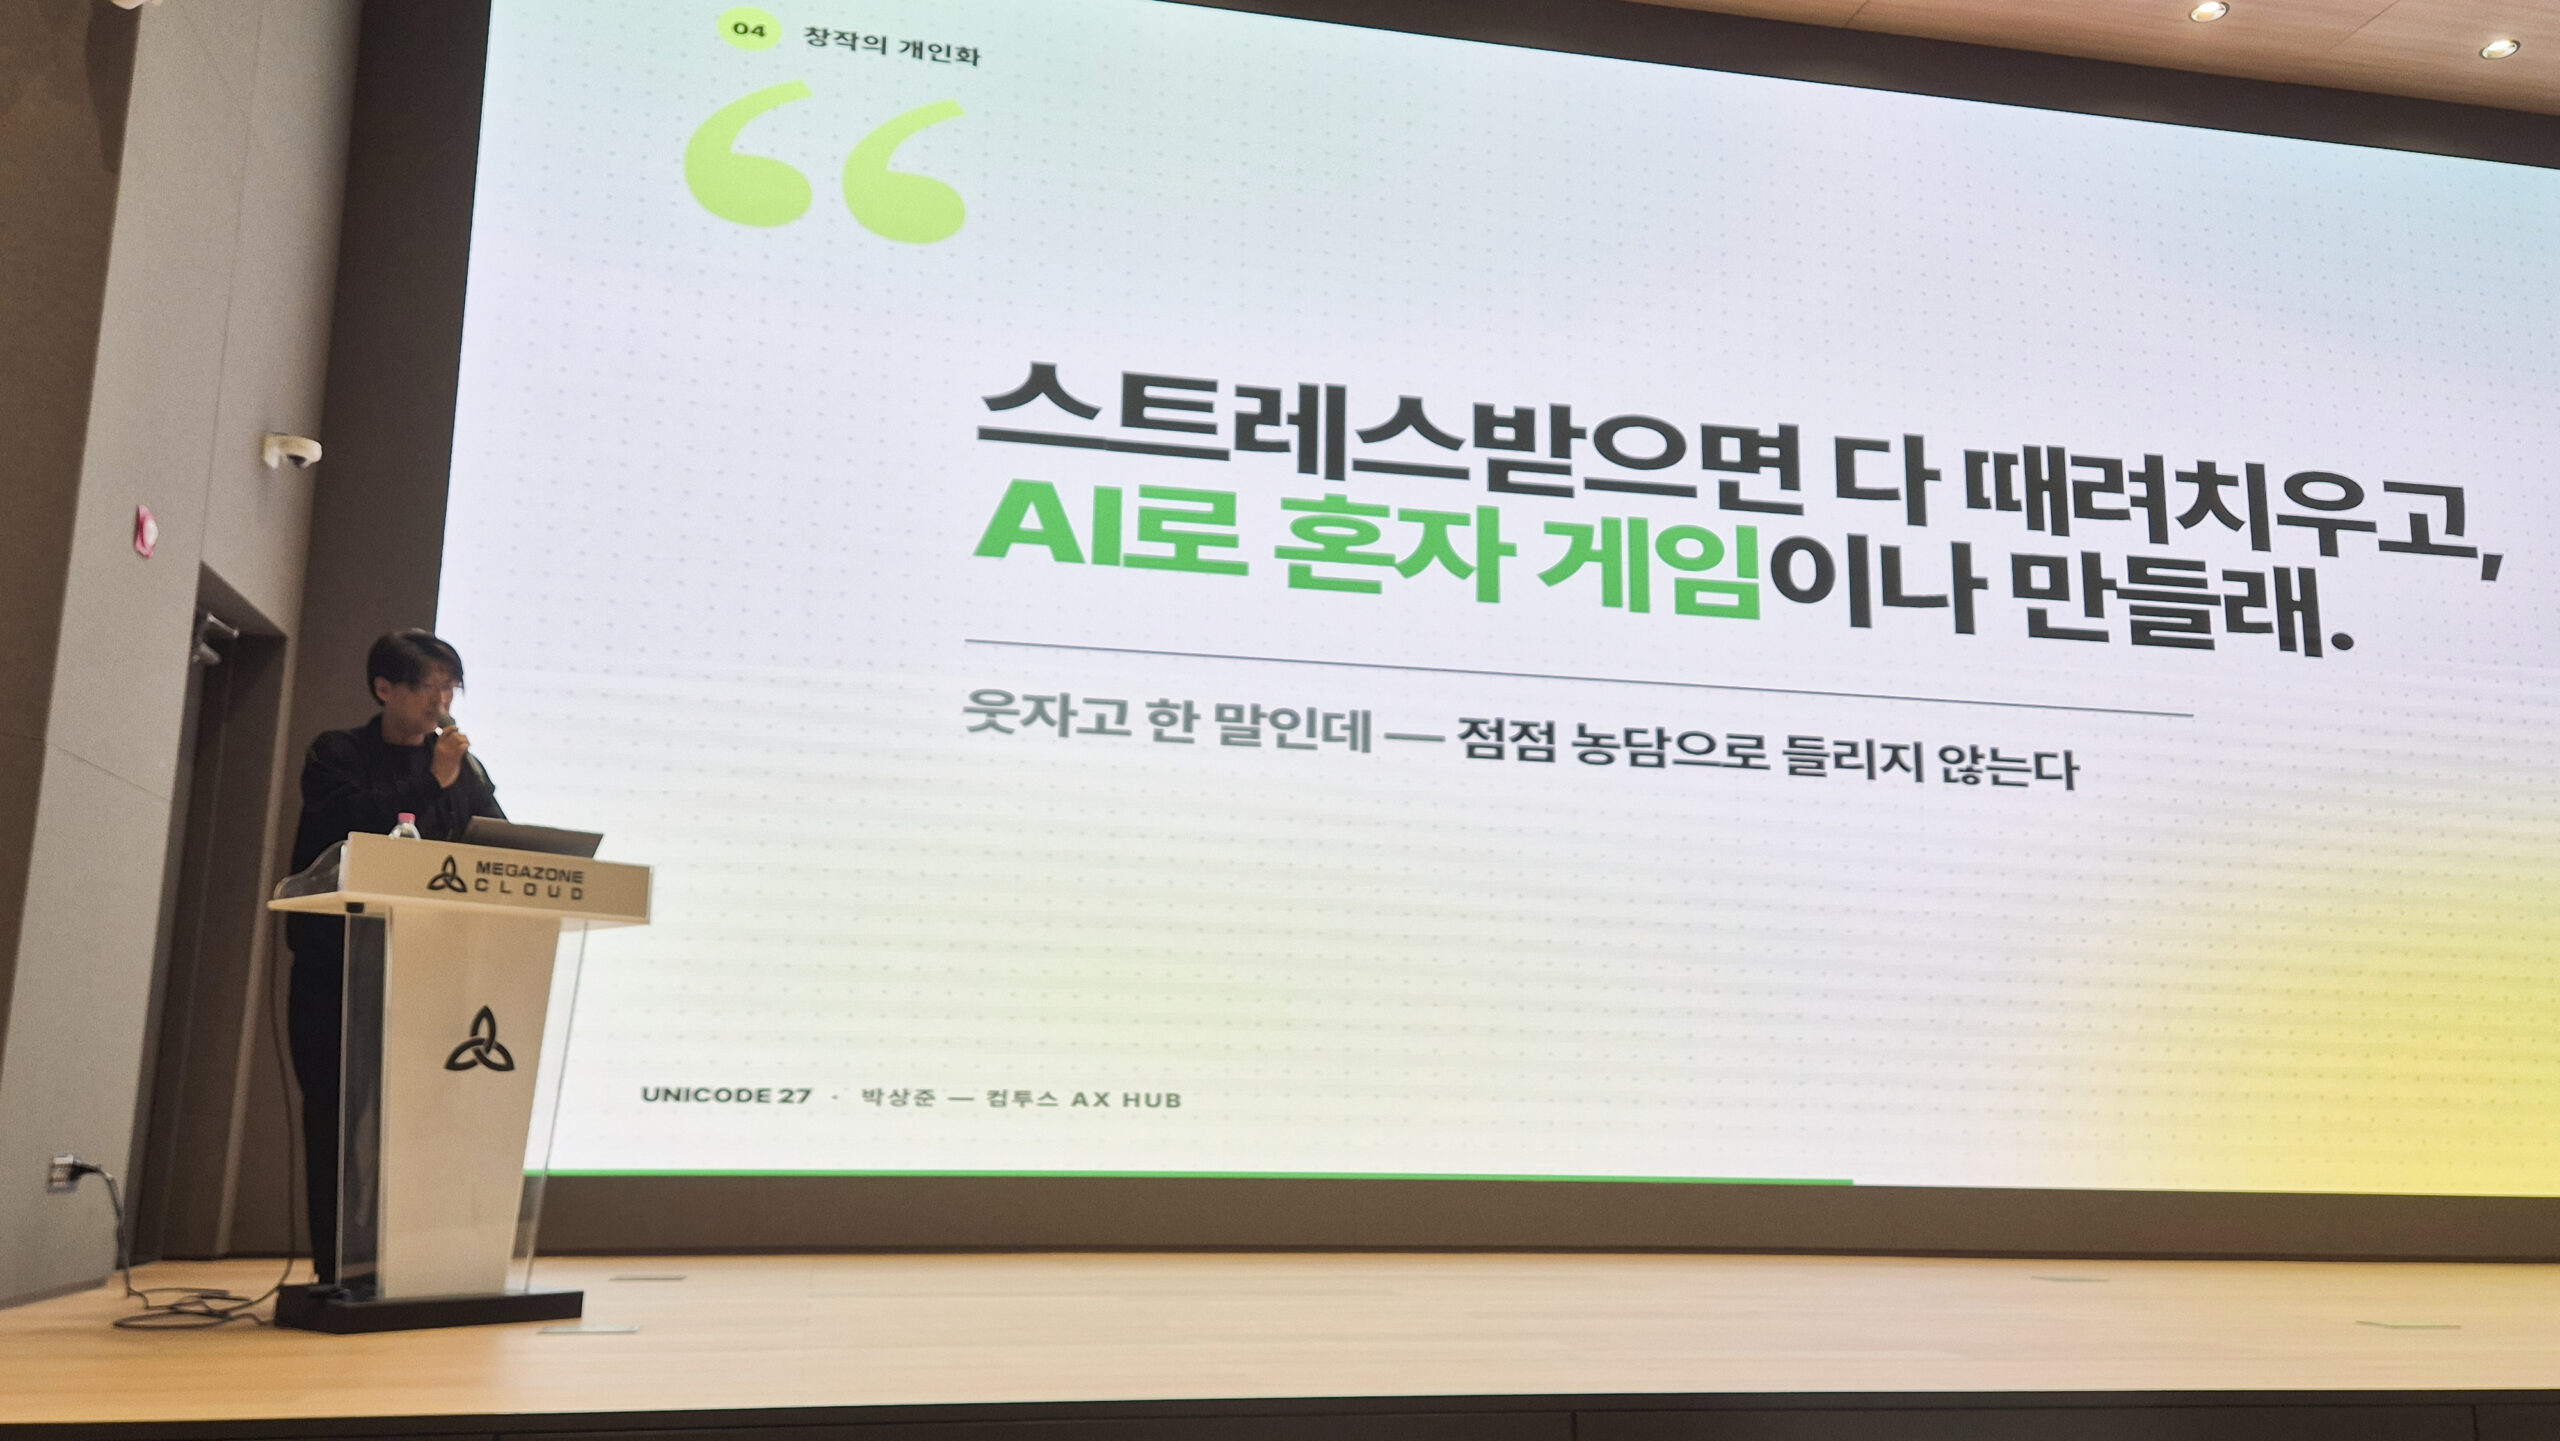
박상준 이사는 주변에서 ‘스트레스 받으면 다 때려치우고, AI로 혼자 게임이나 만들래’라는 농담을 듣곤 했다고 한다. 예전엔 웃자고 했던 말인데, 이제는 점점 농담으로 들리지 않는 시대가 됐다.
콘텐츠를 받아보기만 했던 이용자가 이제 직접 창작자가 되는 것이다.
AI가 생성 과정의 진입 장벽을 낮추면서 이전에는 전문적인 기술이나 많은 시간이 필요했던 작업도 훨씬 쉽게 시도할 수 있게 됐다.
박 이사의 강연은 여기서 한 단계 더 나아갔다.
개인에게 맞는 콘텐츠를 추천하는 ‘소비의 개인화’를 넘어, 개인이 원하는 콘텐츠를 직접 만드는 ‘창작의 개인화’가 시작되고 있다는 것이다.
두 사람이 만든 게임, 한 사람이 만드는 수십 개의 시스템
그렇다면 실제 게임 개발은 얼마나 달라지고 있을까.
강연에서는 소수 인원이 게임을 만드는 실제 사례가 이어졌다.
최근까지 큰 화제가 되고 있는 게임 ‘MECCHA CHAMELEON’의 사례에서는 개발 인원 2명이라는 숫자가 소개됐다. 대규모 조직이 아니더라도 자신의 아이디어를 게임으로 완성해 시장에 내놓는 일이 현실적으로 가능해지고 있다는 사례다.
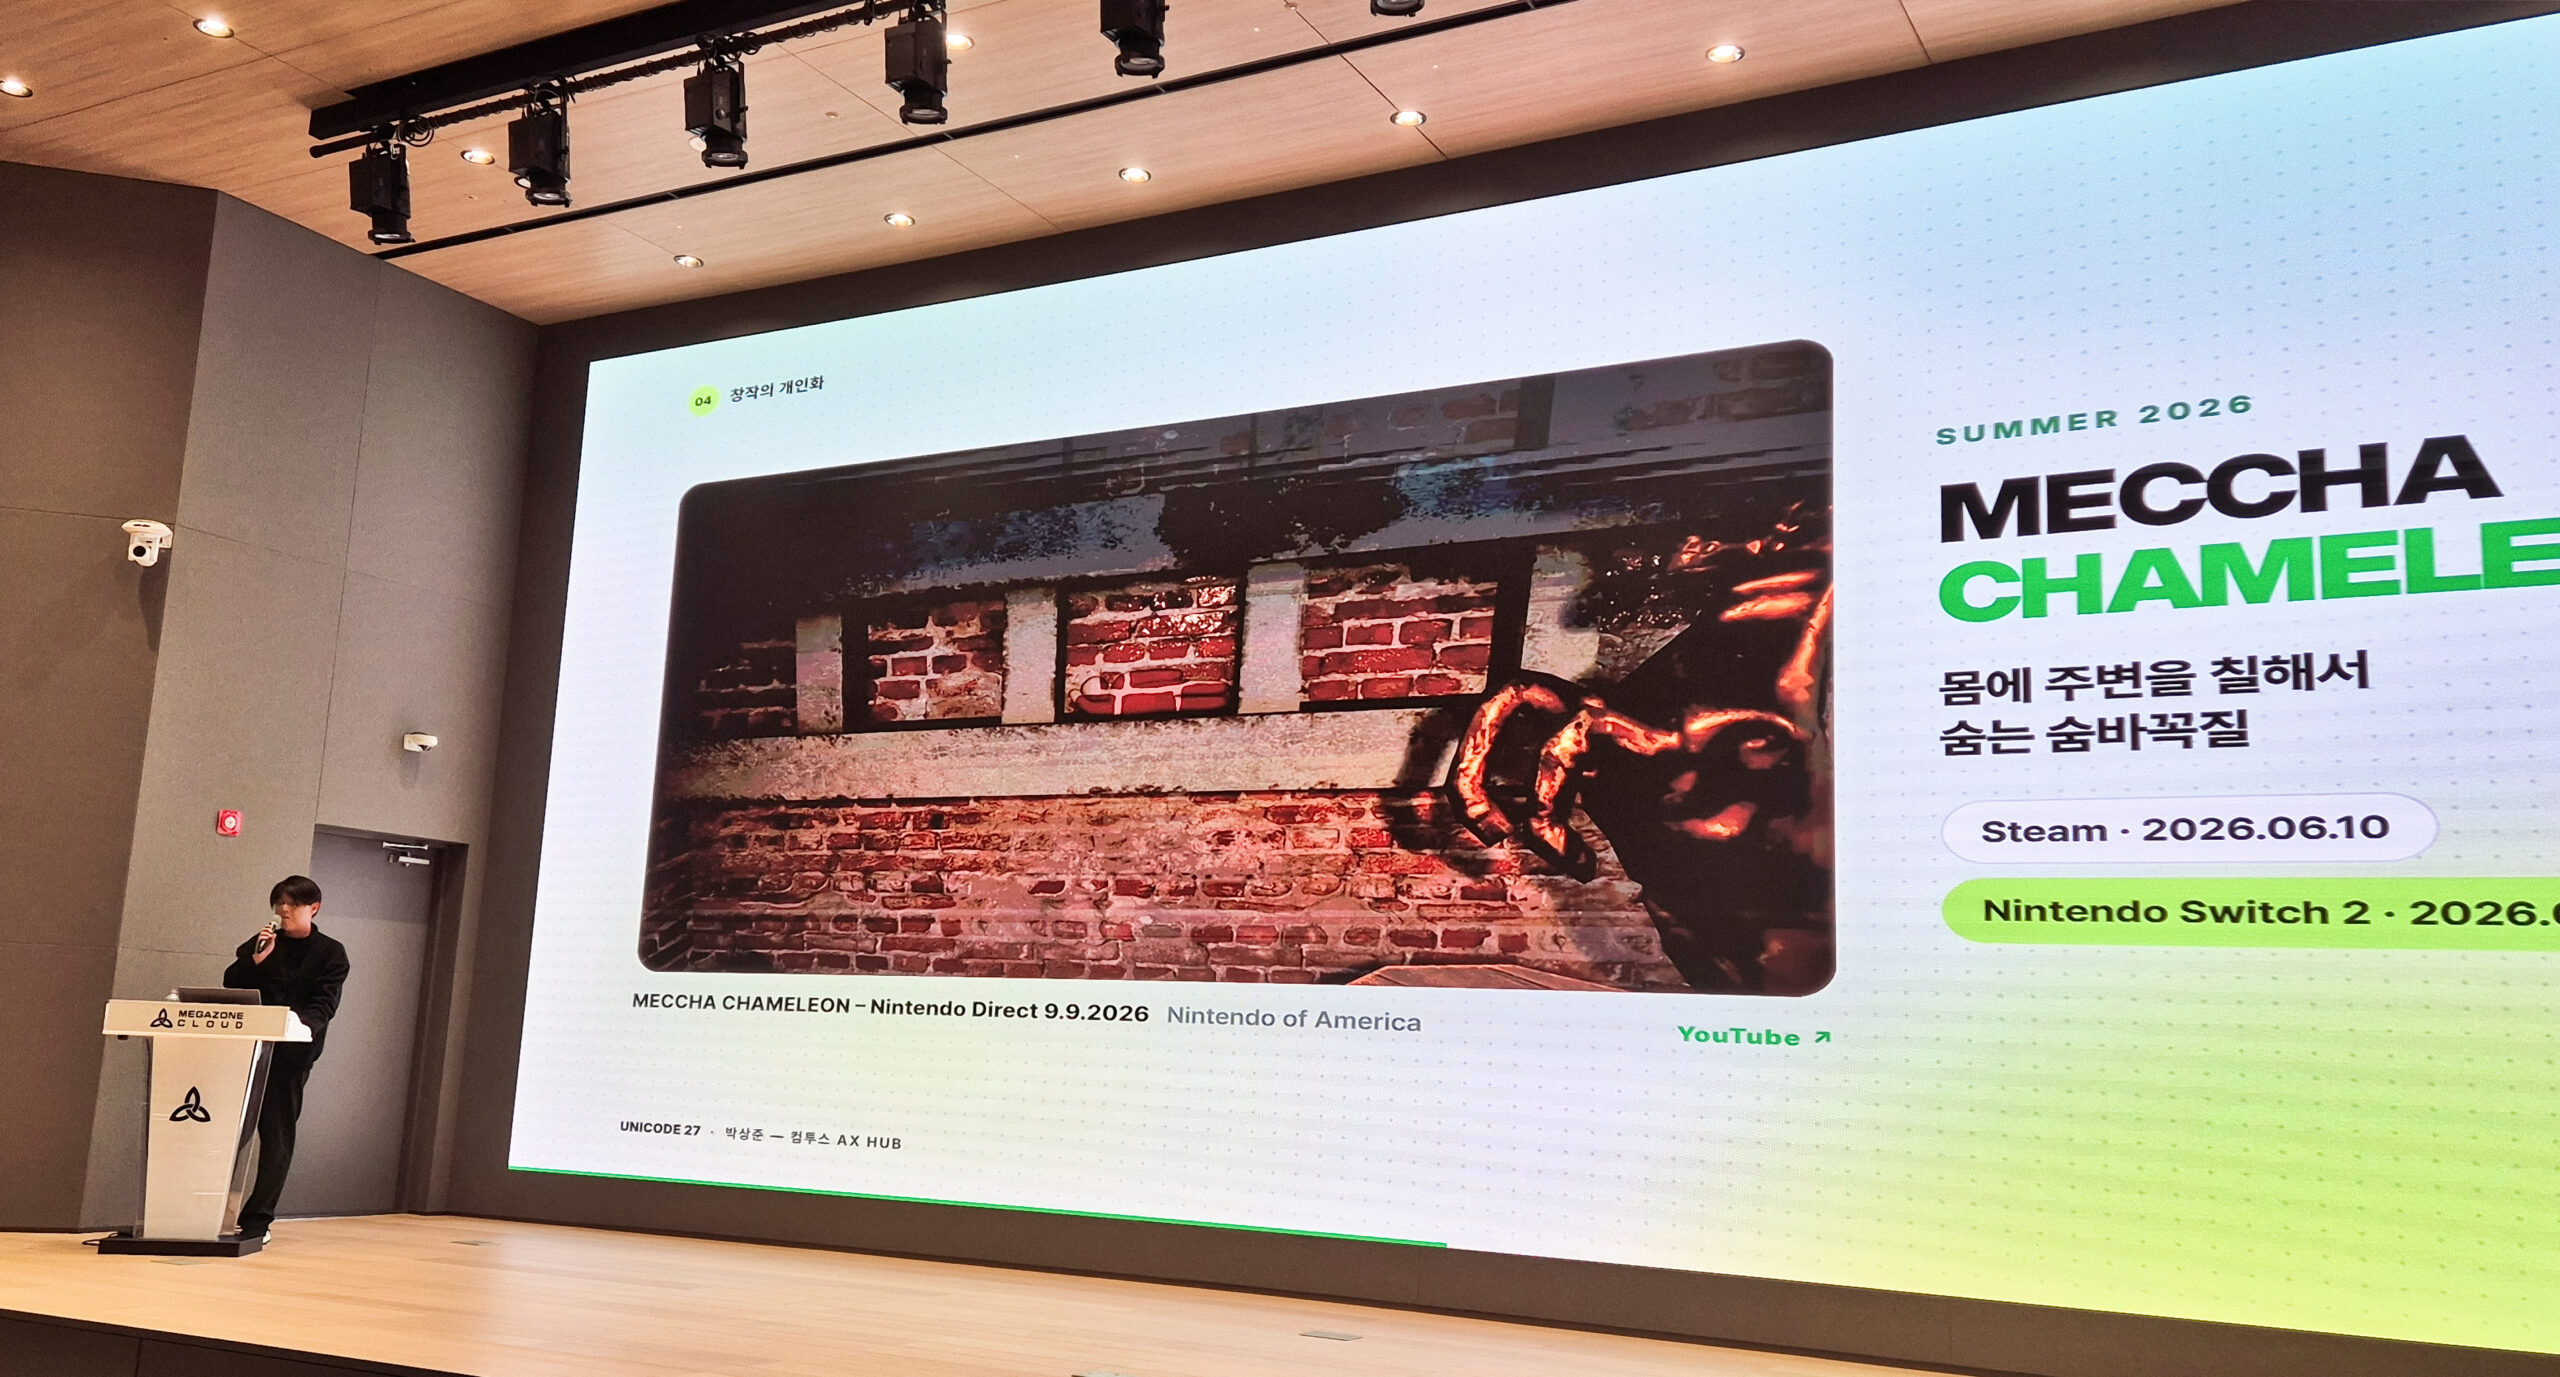
이어 박 이사는 실제 게임 개발 현장에서 AI를 활용한 R&D 사례들도 소개했다.
그중 눈에 띄는 숫자가 있었다.
개발자 1명, 66개의 게임 시스템, 425개의 애니메이션.
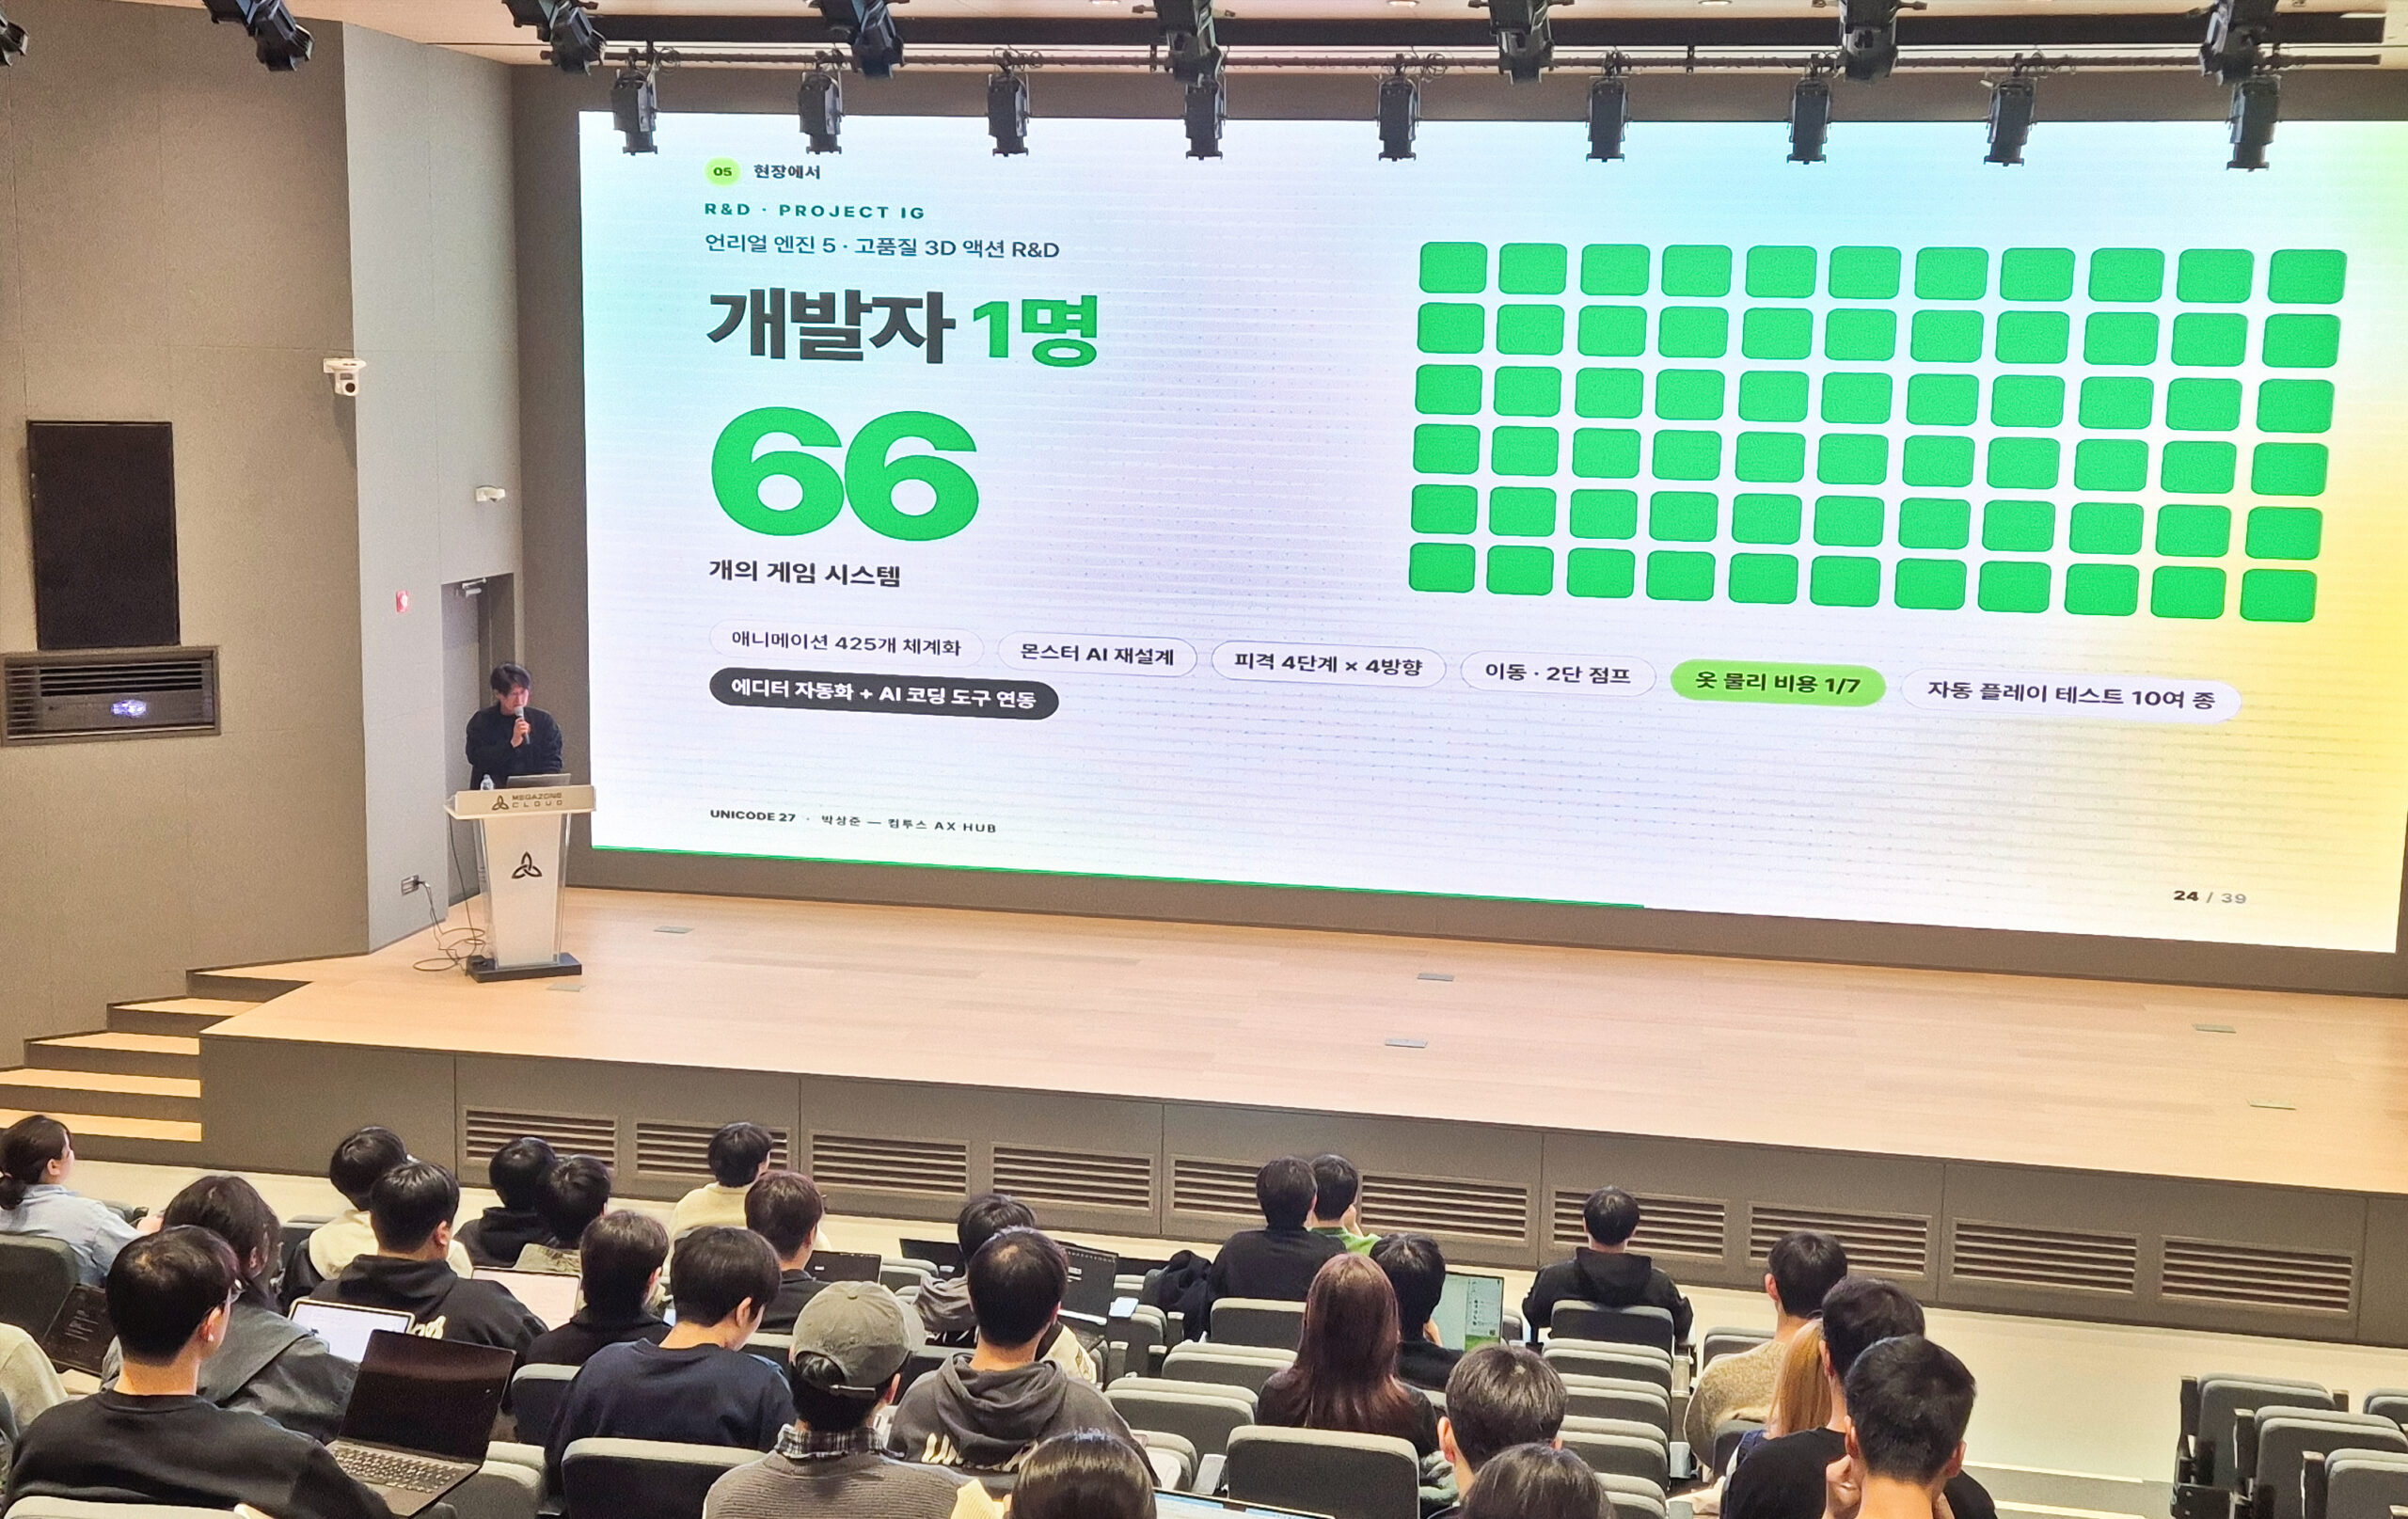
에디터 자동화와 AI 코딩 도구를 활용해 한 명의 개발자가 구현할 수 있는 범위를 크게 확장한 사례다.
AI를 활용한 오픈월드 제작이나 ‘유니티’ 기반의 전투·인벤토리 시스템 구현 사례도 이어졌다.
여기서 중요한 점은 AI가 게임을 알아서 만들어준다는 이야기가 아니다.
개발자가 명확한 목표와 아이디어를 가지고 있다면 AI를 활용해 프로토타입을 만들고 기능을 구현하며 반복 작업에 들어가는 시간을 줄일 수 있다는 것이다. 결국 한 사람이 테스트하고 구현할 수 있는 아이디어의 수와 속도가 이전과 달라지고 있는 셈이다.
“요청 한 줄”에서 영상까지
이러한 변화는 개발 영역에만 머물지 않았다.
박 이사는 게임 제작 과정에서 진행 중인 다양한 AI 활용 사례도 공개했다.
간단한 게임을 제작하고 알리는 과정부터, 캐릭터와 음식 이미지 등을 활용해 영상을 제작하는 AI 비디오 파이프라인까지 다양한 실험이 진행되고 있었다.
강연 화면에는 ‘요청 한 줄’이라는 표현도 등장했다.
간단한 요구사항을 시작점으로 스타일과 레이아웃 등을 설정하고 결과물을 만드는 과정이다.
‘서머너즈 워’ 캐릭터의 피규어 사진을 입력 이미지로 활용해 광고 형태의 콘텐츠를 제작하는 사례도 소개됐고, 게임 트레일러 제작에 AI를 활용하는 R&D 결과물도 함께 공개됐다.
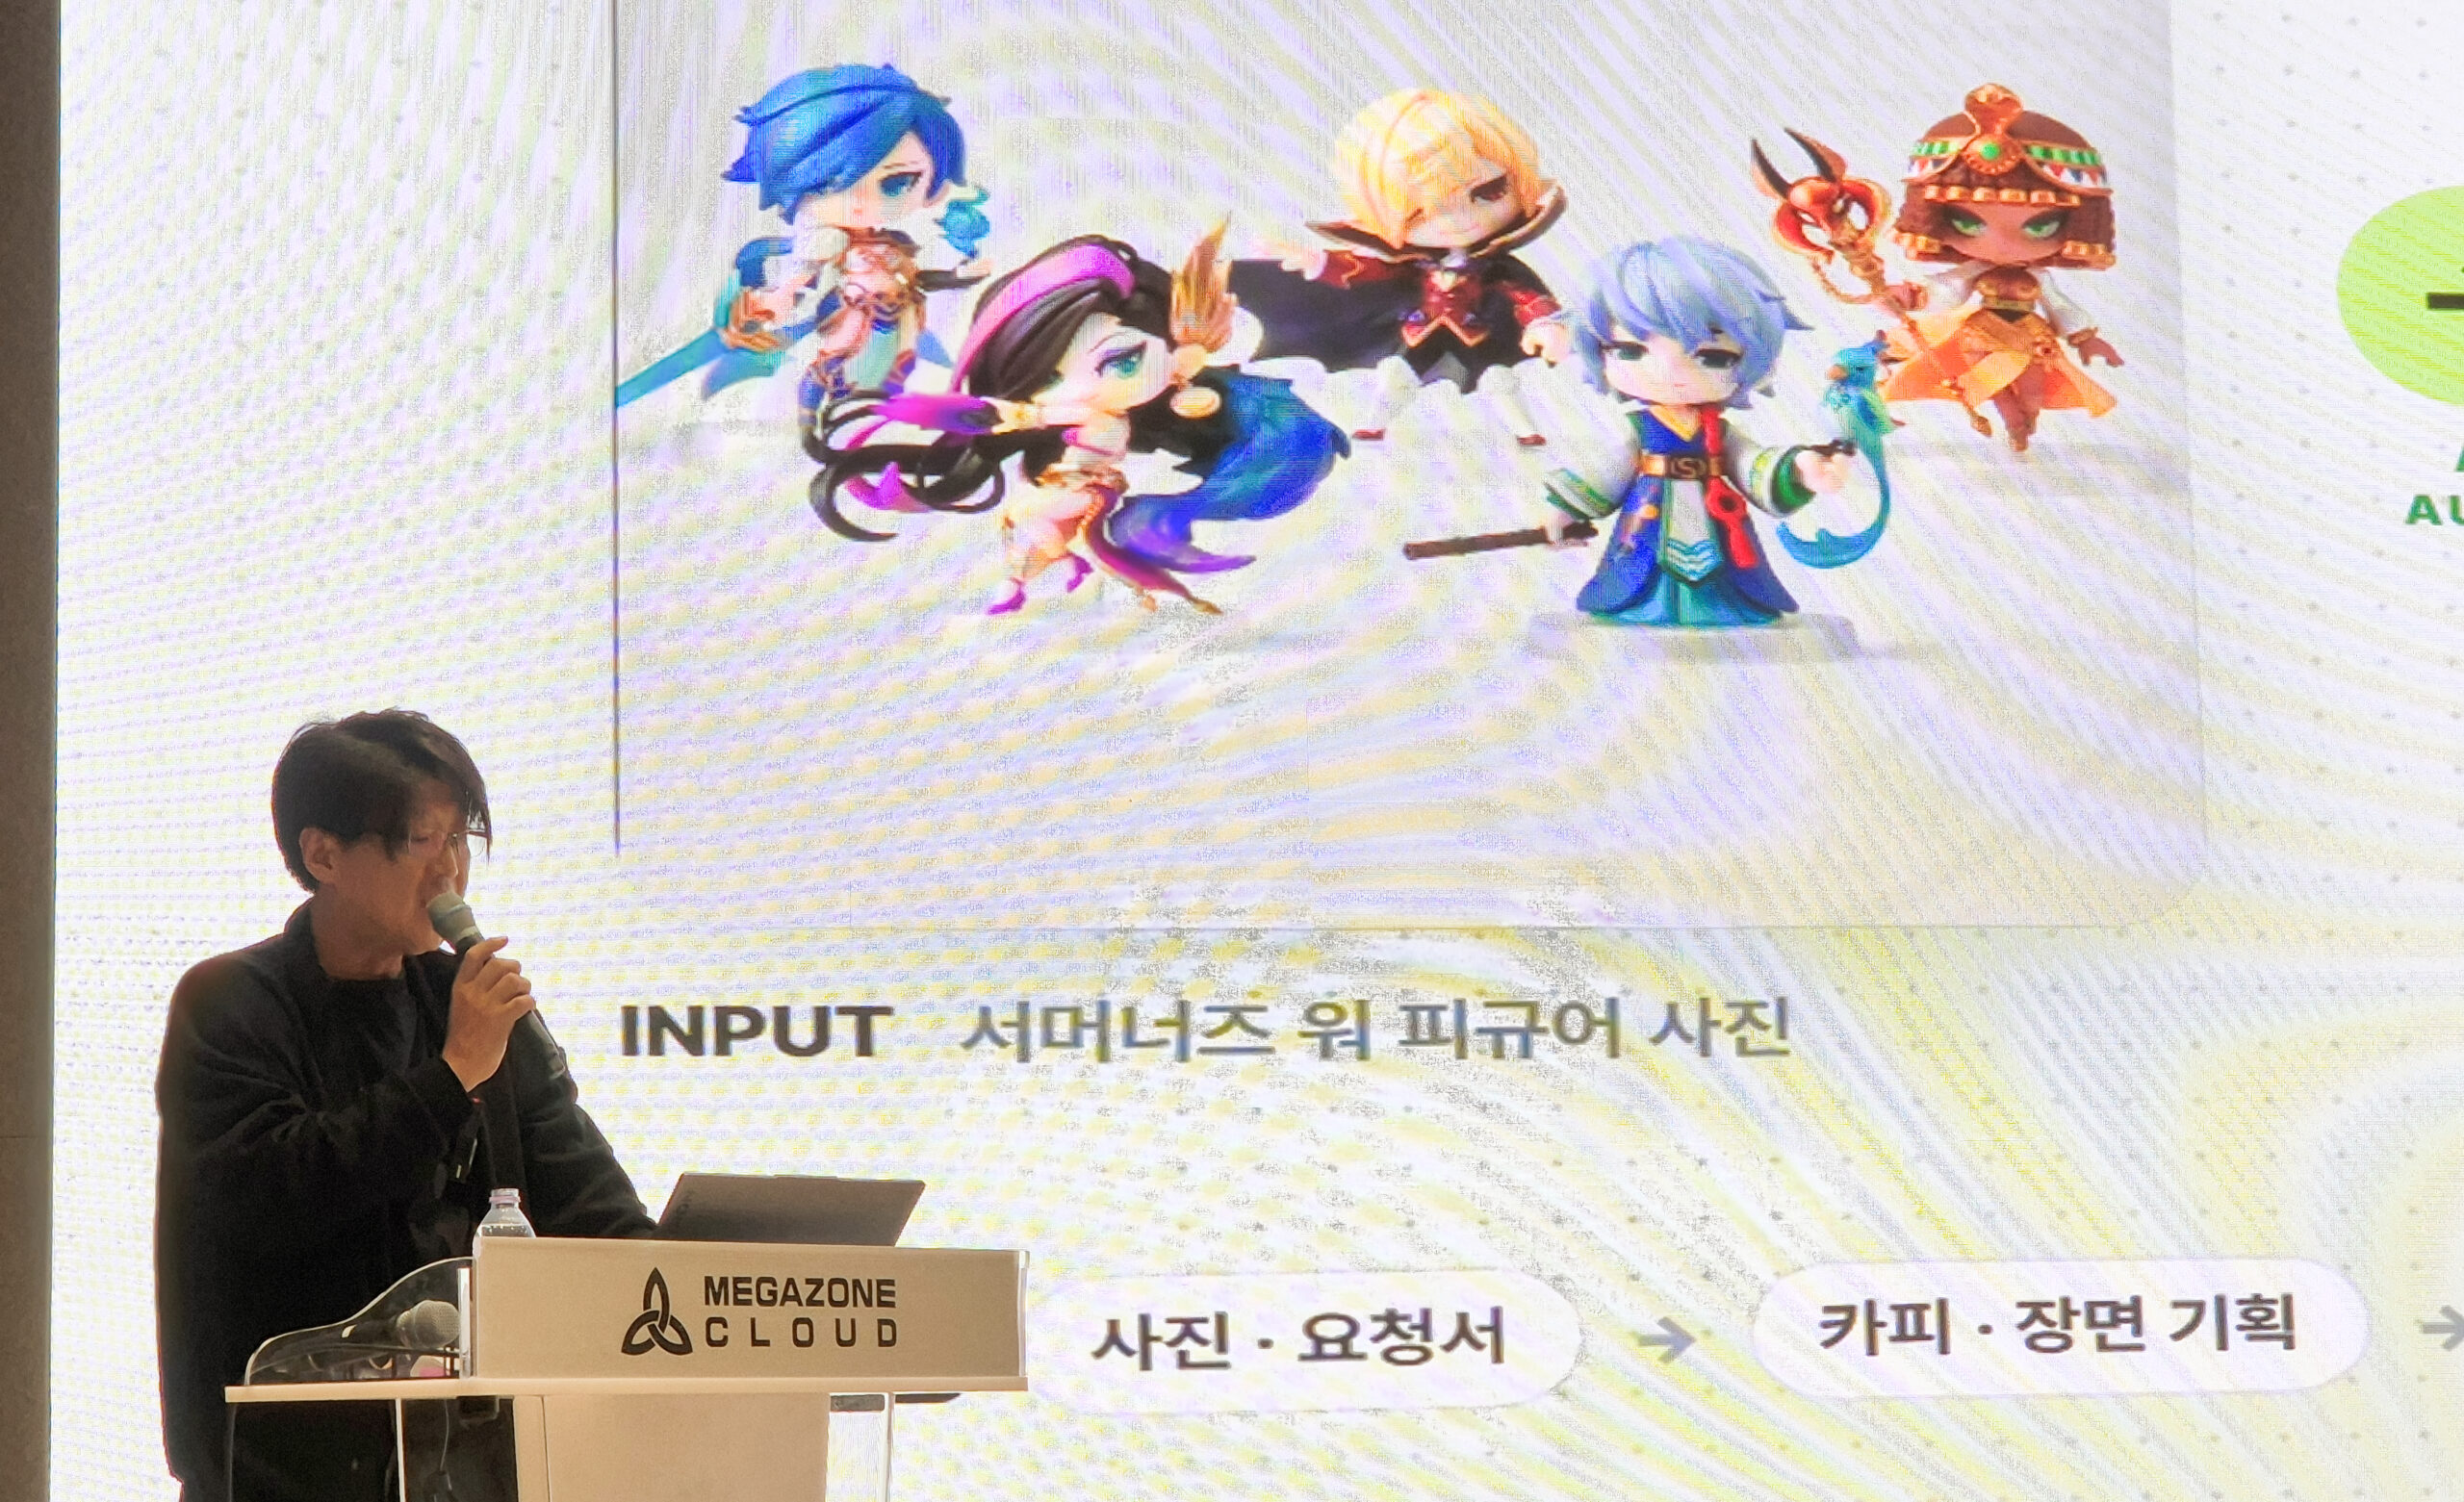
이미지를 만들고, 영상을 만들고, 코드를 작성하는 각각의 도구가 발전하면서 게임 개발자가 직접 다룰 수 있는 영역 역시 넓어지고 있는 것이다.
AI 시대, 오히려 더 중요해지는 ‘취향’
강연 후반부에는 ‘1인 스튜디오 세대’라는 키워드가 등장했다.
한 사람이 직접 만들 수 있는 범위가 계속 넓어진다면 앞으로는 자신이 만들고 싶은 게임을 직접 구현하는 개발자들이 더욱 늘어날 수 있다.
그렇다면 AI 시대를 준비하는 대학생 개발자들은 무엇을 해야 할까.
박 이사가 제시한 첫 번째 키워드는 의외로 기술이 아니었다.
“취향은 깊게.”
“가장 개인적인 게임이 가장 멀리 간다.”– 컴투스 AX HUB 박상준 이사 –
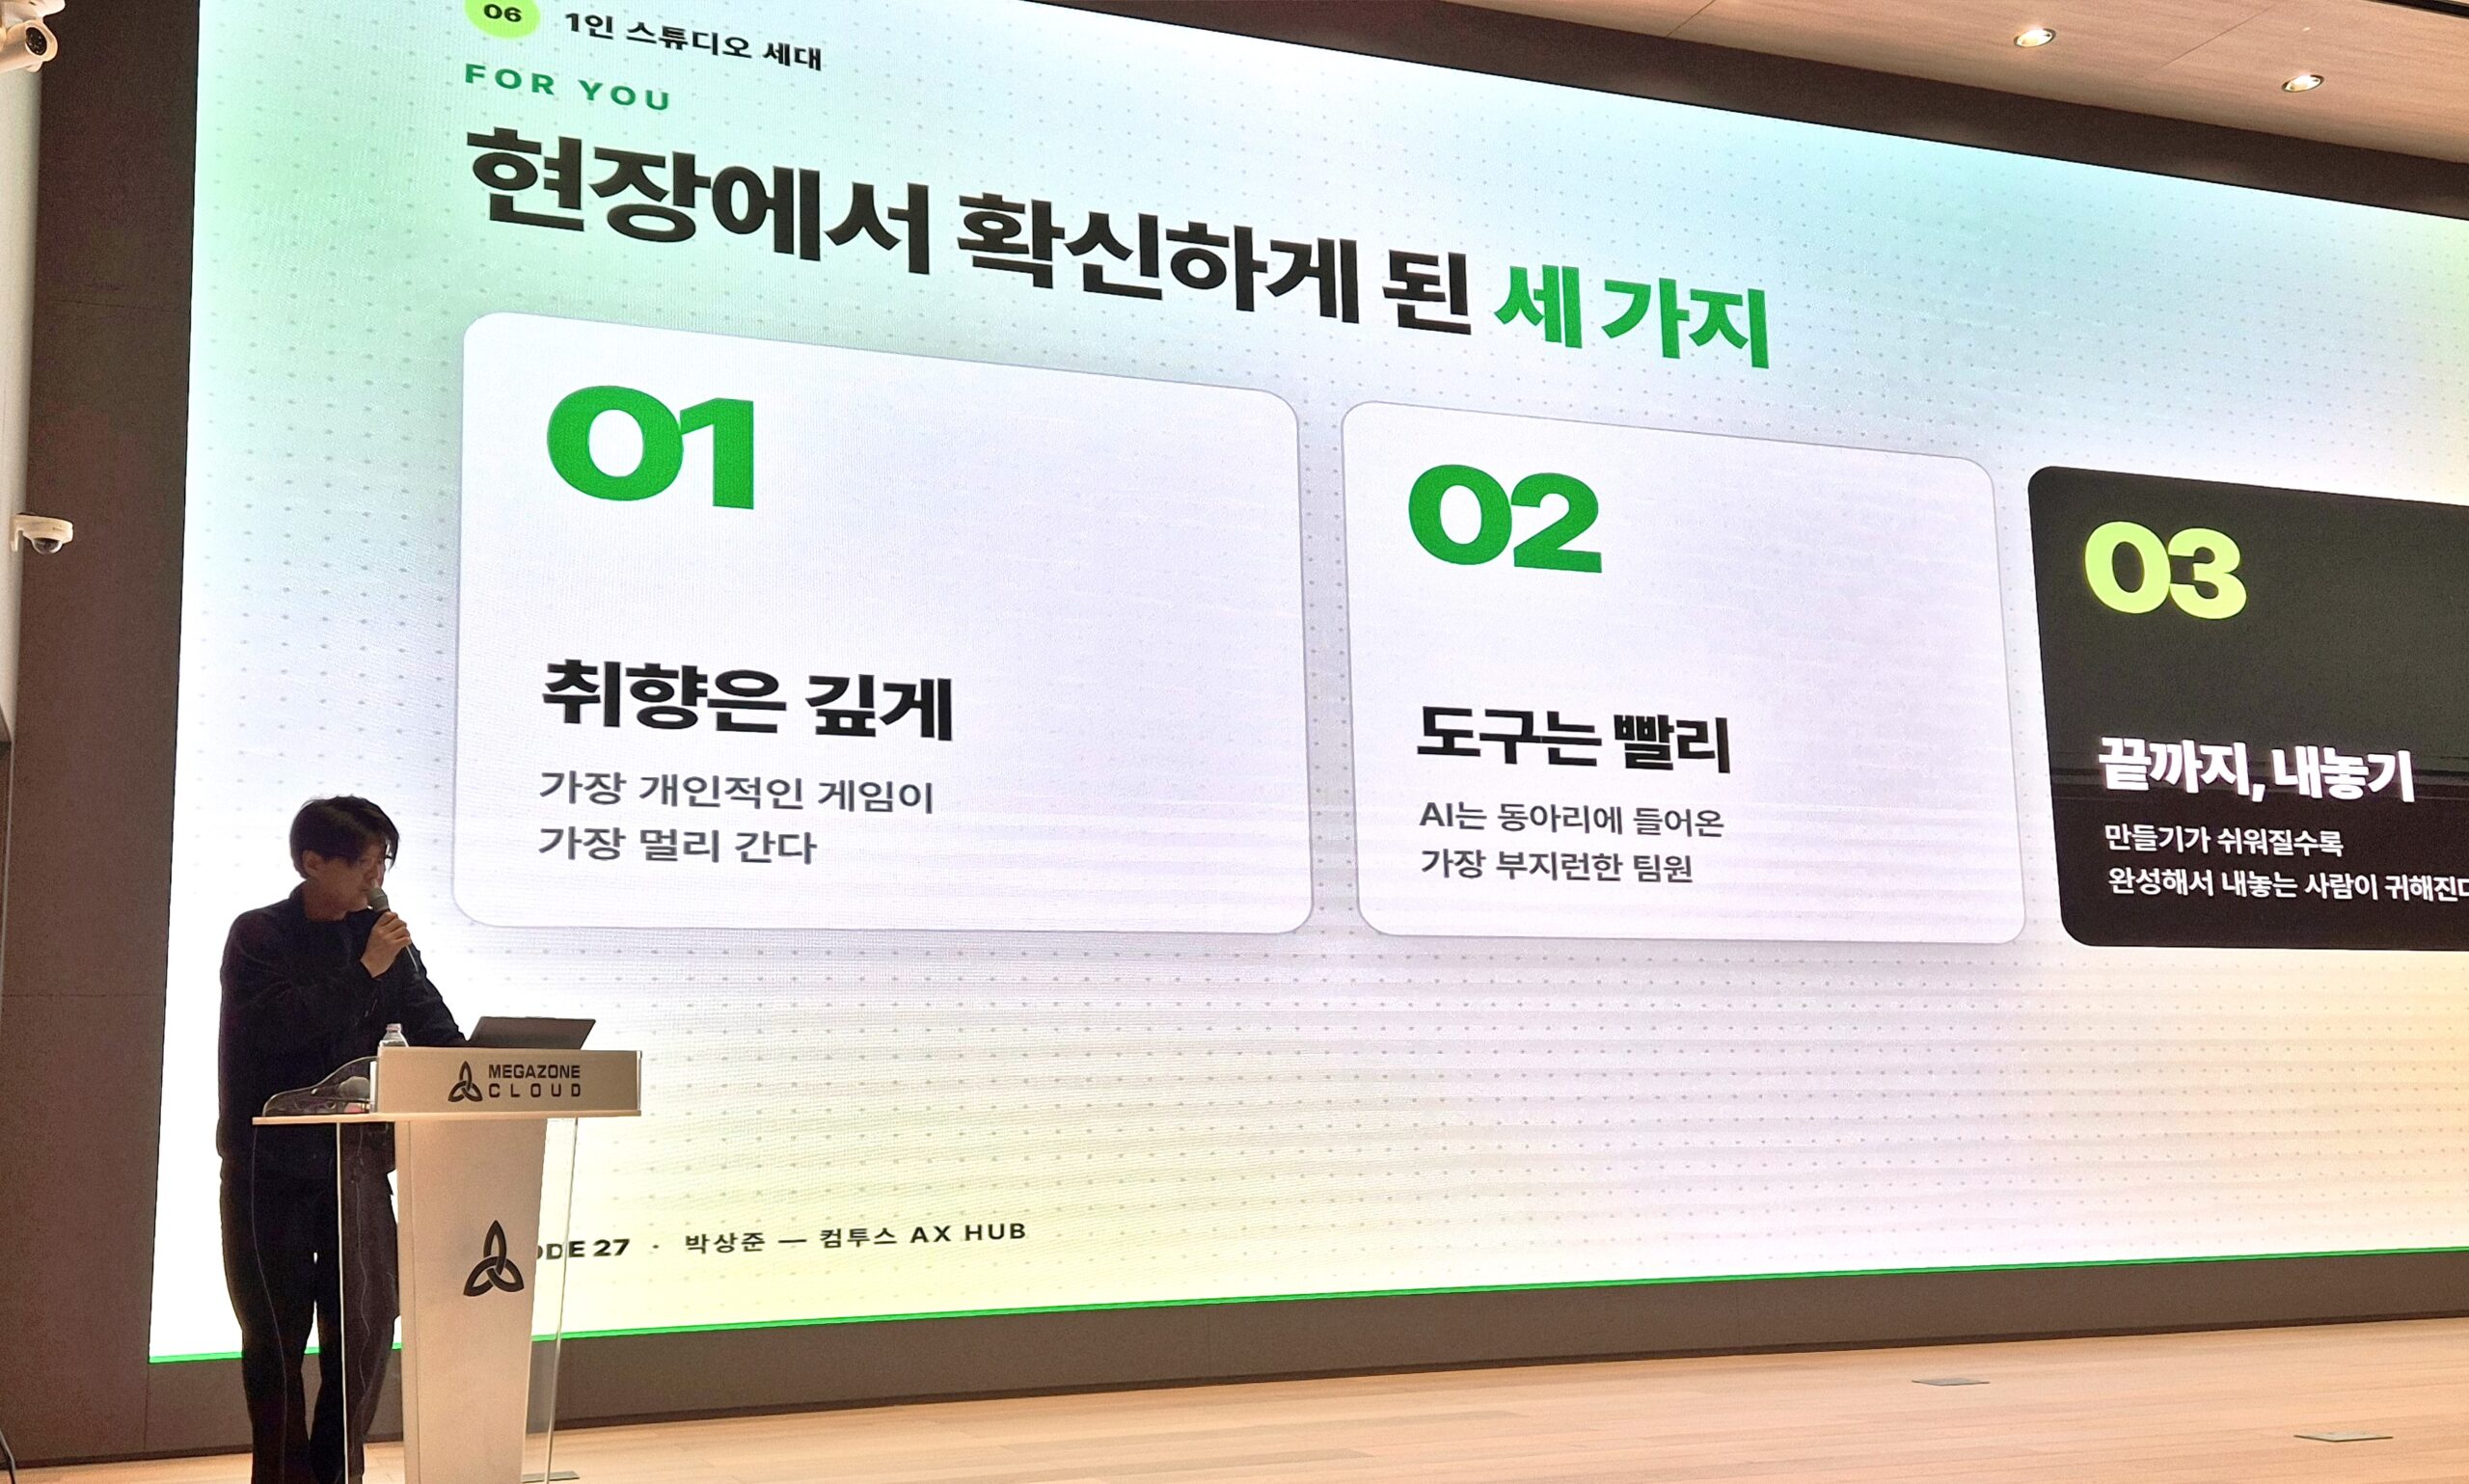
누구나 같은 AI 도구를 이용할 수 있게 될수록 어떤 게임을 만들고 싶은지, 무엇을 좋아하는지에 대한 개발자 자신의 답이 중요해진다는 의미로 읽혔다.
게임을 쉽게 만드는 것 자체가 목적이 아니라, 자신의 관심과 경험을 실제 결과물로 구현하는 데 AI를 활용하는 것이다.
강연 마지막에는 유니코드27의 기획 의도와 연결되는 메시지도 등장했다. 게임 개발에서는 아이디어를 실제 첫 프로토타입으로 구현해보는 경험이 중요하다는 내용이었다.
결국 AI 시대에도 출발점은 같다.
생각한 것을 직접 만들어보는 것.
다만 그 과정에서 한 사람이 할 수 있는 일이 이전보다 훨씬 많아지고 있을 뿐이다.
‘나도 게임을 만들어볼까’가 상상이 아닌 현실이 된 시대
AI가 발전하면서 게임 개발이라는 작업의 첫걸음을 내딛는 데 필요한 장벽은 계속 낮아지고 있다.
이날 박상준 이사의 강연 제목이었던 ‘Build for One. Built by One.’은 그래서 단순한 미래 전망이라기보다 이미 시작되고 있는 게임 개발 방식의 변화를 설명하는 문장처럼 느껴졌다.
게임은 앞으로 누가, 몇 명이 만들게 될까.
유니코드27 현장에서 확인한 답은 어쩌면 이렇다.
더 많은 사람이, 더 적은 인원으로, 자신이 정말 만들고 싶은 게임을 만들 수 있는 시대가 오고 있다.
분석에서 찾은 조건을 다시 확인하려면 측정값과 연산, 차원, 기간과 필터를 매번 같게 설정해야 한다. Hive Axyl Plugin을 이용하면 자연어로 차트 구성을 요청하고, 여러 차트를 하나의 대시보드로 구성할 수 있다. 생성·수정 전에는 적용할 내용을 먼저 보여주고 사용자가 승인한 뒤 실행하며, 1편에서 확인한 매출·ARPPU 감소 분석은 추천받은 지표 다섯 가지로 대시보드를 만들어 반복 확인할 수 있다.
분석 결과를 빠르게 대시보드로 구성하기
「자연어로 게임 지표를 조회하고 변화 확인하기: Hive Axyl Plugin 활용 1편」에서는 플러그인 설치 방법과 자연어로 KPI를 비교하고 국가와 마켓 등의 차원을 적용해 변화의 원인을 살펴봤다. 이번 편에서는 확인한 분석 조건을 차트로 저장하고, 여러 차트를 대시보드로 구성하는 방법을 알아본다.
분석을 통해 의미 있는 지표를 찾았더라도 같은 내용을 대시보드에서 확인하려면 측정값과 연산, 차원, 기간과 필터를 동일하게 적용해야 한다. 자연어로 전달하면 여러 차트와 대시보드의 구성을 한 번에 준비하고, 생성 전에 적용할 지표와 조건을 함께 검토할 수 있다.
Hive 애널리틱스의 자연어 기반 차트와 대시보드 생성
Hive Axyl Plugin을 이용하면 자연어로 측정값, 연산, 차원과 기간을 지정하고 Hive 애널리틱스의 Create > 차트를 생성할 수 있다. 생성한 차트 여러 개를 선택해 하나의 대시보드로 구성하는 작업도 이어서 요청할 수 있다.
차트를 생성하거나 수정할 때는 적용할 내용을 먼저 확인하고 사용자가 승인한 뒤 작업을 실행한다.
애널리틱스 기능은 Hive SDK v4와 Hive Axyl 중 게임에 적용된 SDK 버전과 관계없이 사용할 수 있다. 다만 ChatGPT에서 연결한 Hive 계정이 조직의 MCP 멤버로 등록되어 있어야 하며, 차트와 대시보드는 해당 조직에 연결된 프로젝트 내에서 생성할 수 있다.
- 분석 기준 정리: 반복해서 확인할 측정값, 연산, 차원과 조회 기간을 정한다.
- 차트 생성: 자연어로 차트 구성을 요청하고 저장 전에 설정과 결과를 검토한다.
- 대시보드 구성: 함께 확인할 차트를 선택하고 분석 목적에 맞게 한 화면에 배치한다.
- 구성 보완: 필요한 차트나 조건을 추가하고 기존 콘텐츠의 구성을 조정한다.
플러그인 설치와 조직의 MCP 멤버 설정 과정은 1편에서 확인할 수 있다.
매출 분석 대시보드 구성해보기
1편에서 매출과 ARPPU 감소가 크게 나타난 국가와 마켓, 상품을 단계적으로 확인했다. 이번에는 해당 변화를 지속적으로 확인할 지표를 추천받고, 추천 결과를 하나의 대시보드로 구성해본다.
확인할 지표 추천받기
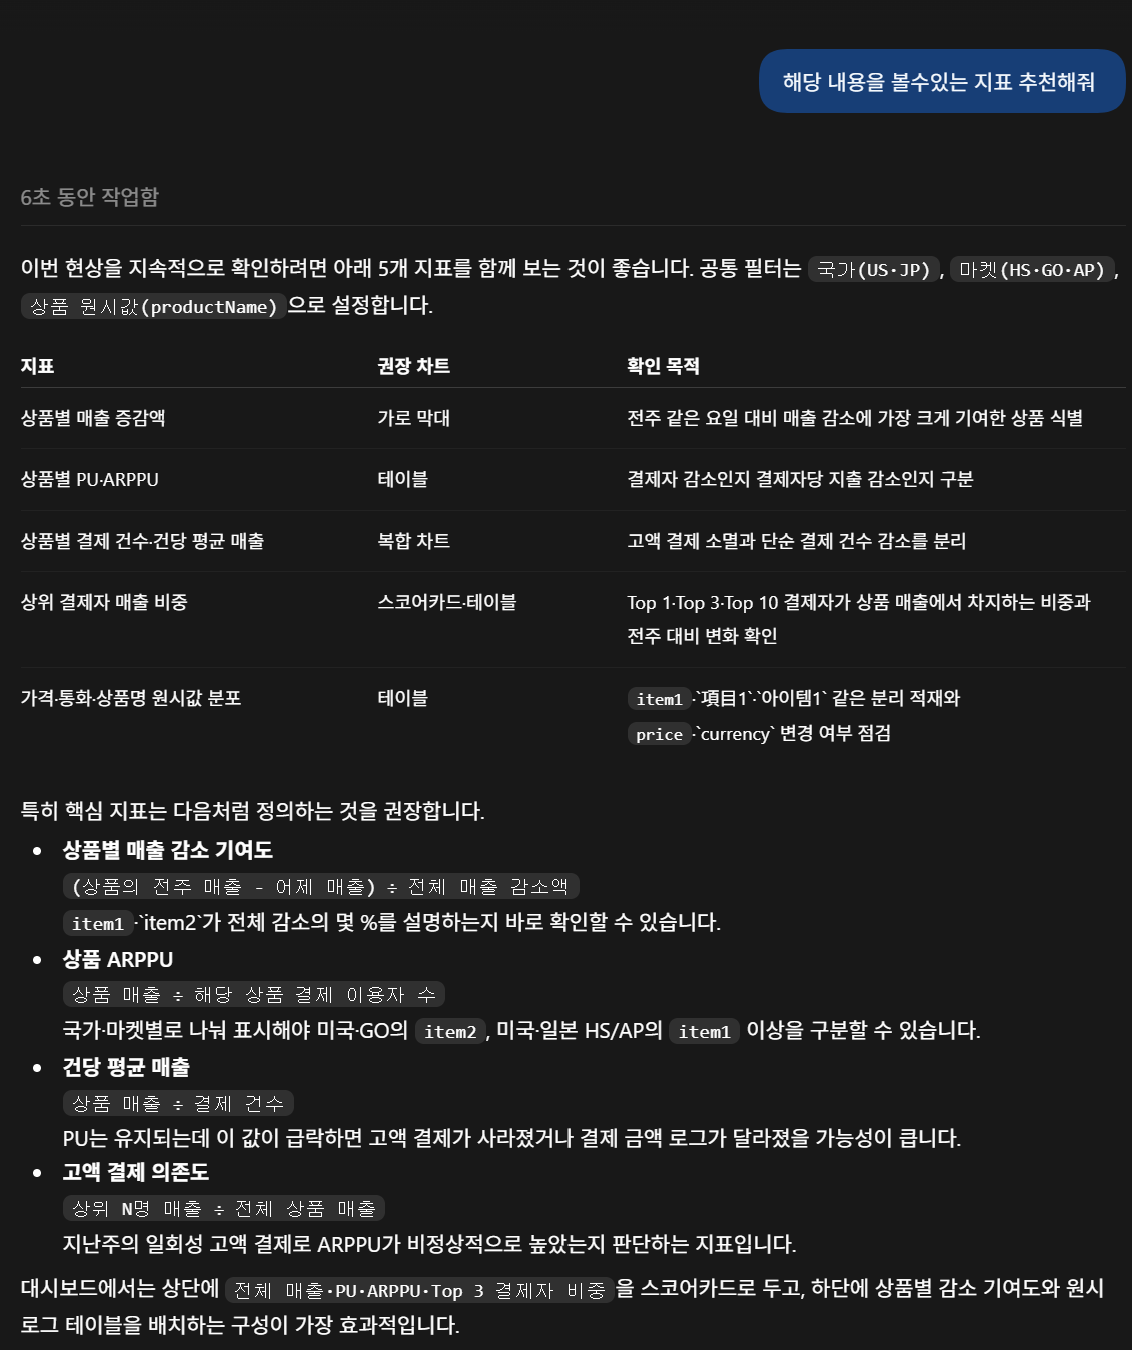
해당 내용을 볼 수 있는 지표 추천해줘.
Hive Axyl Plugin은 앞선 분석 맥락을 바탕으로 상품별 매출 증감액, 상품별 PU·ARPPU, 상품별 결제 건수와 건당 평균 매출, 상위 결제자 매출 비중, 가격·통화·상품명 원시값 분포를 추천한다. 각 지표의 확인 목적과 권장 차트 유형도 함께 제시하므로 대시보드에 필요한 구성을 구체화할 수 있다.
추천받은 지표로 대시보드 생성하기
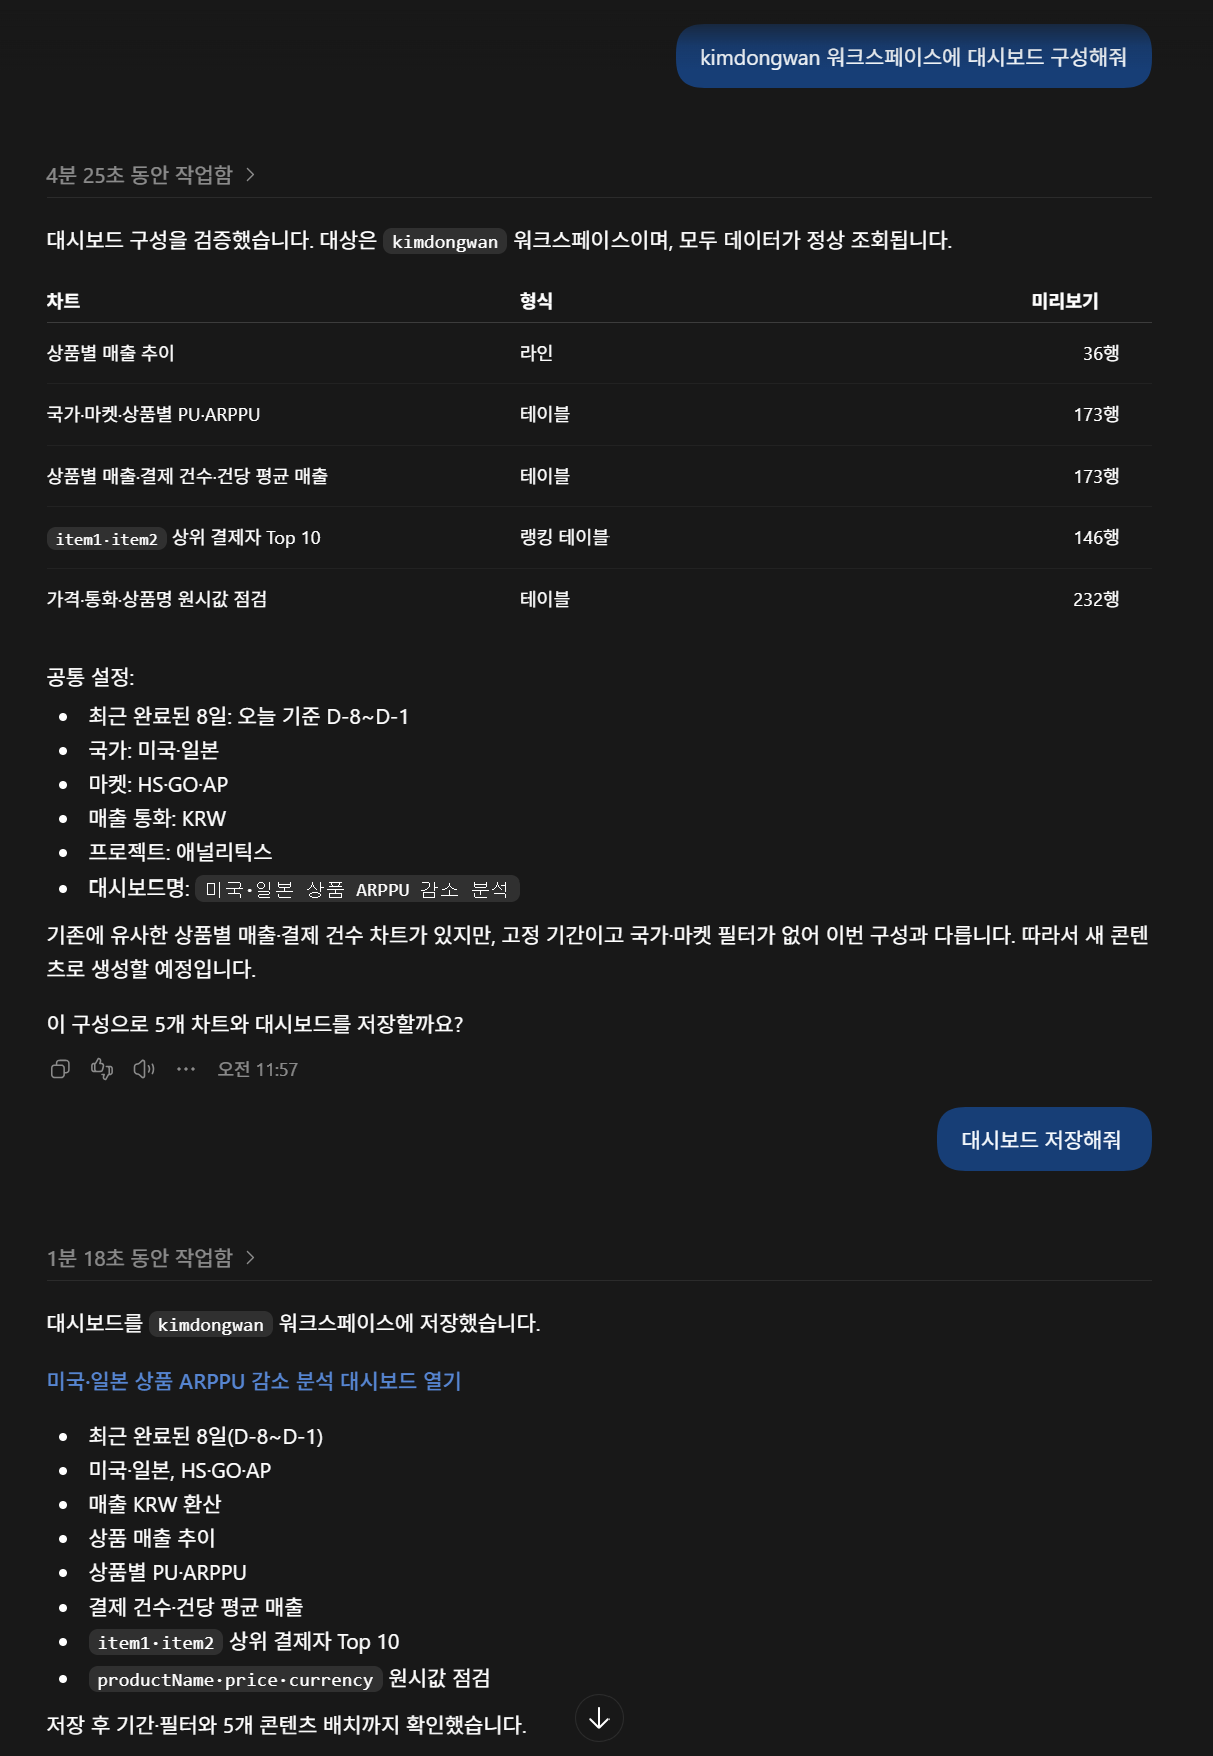
선택한 워크스페이스에 대시보드 구성해줘.
Hive Axyl Plugin은 동일한 차트나 대시보드가 있는지 확인한 뒤 생성할 내용을 미리 보여준다. 다음 화면에서는 추천받은 다섯 가지 지표와 기간, 국가·마켓 필터, 매출 통화, 대시보드 이름을 검토했다. 차트와 대시보드는 새 콘텐츠로 저장되므로 구성을 확인하고 승인한 뒤 생성을 요청한다.
생성된 대시보드 확인하기
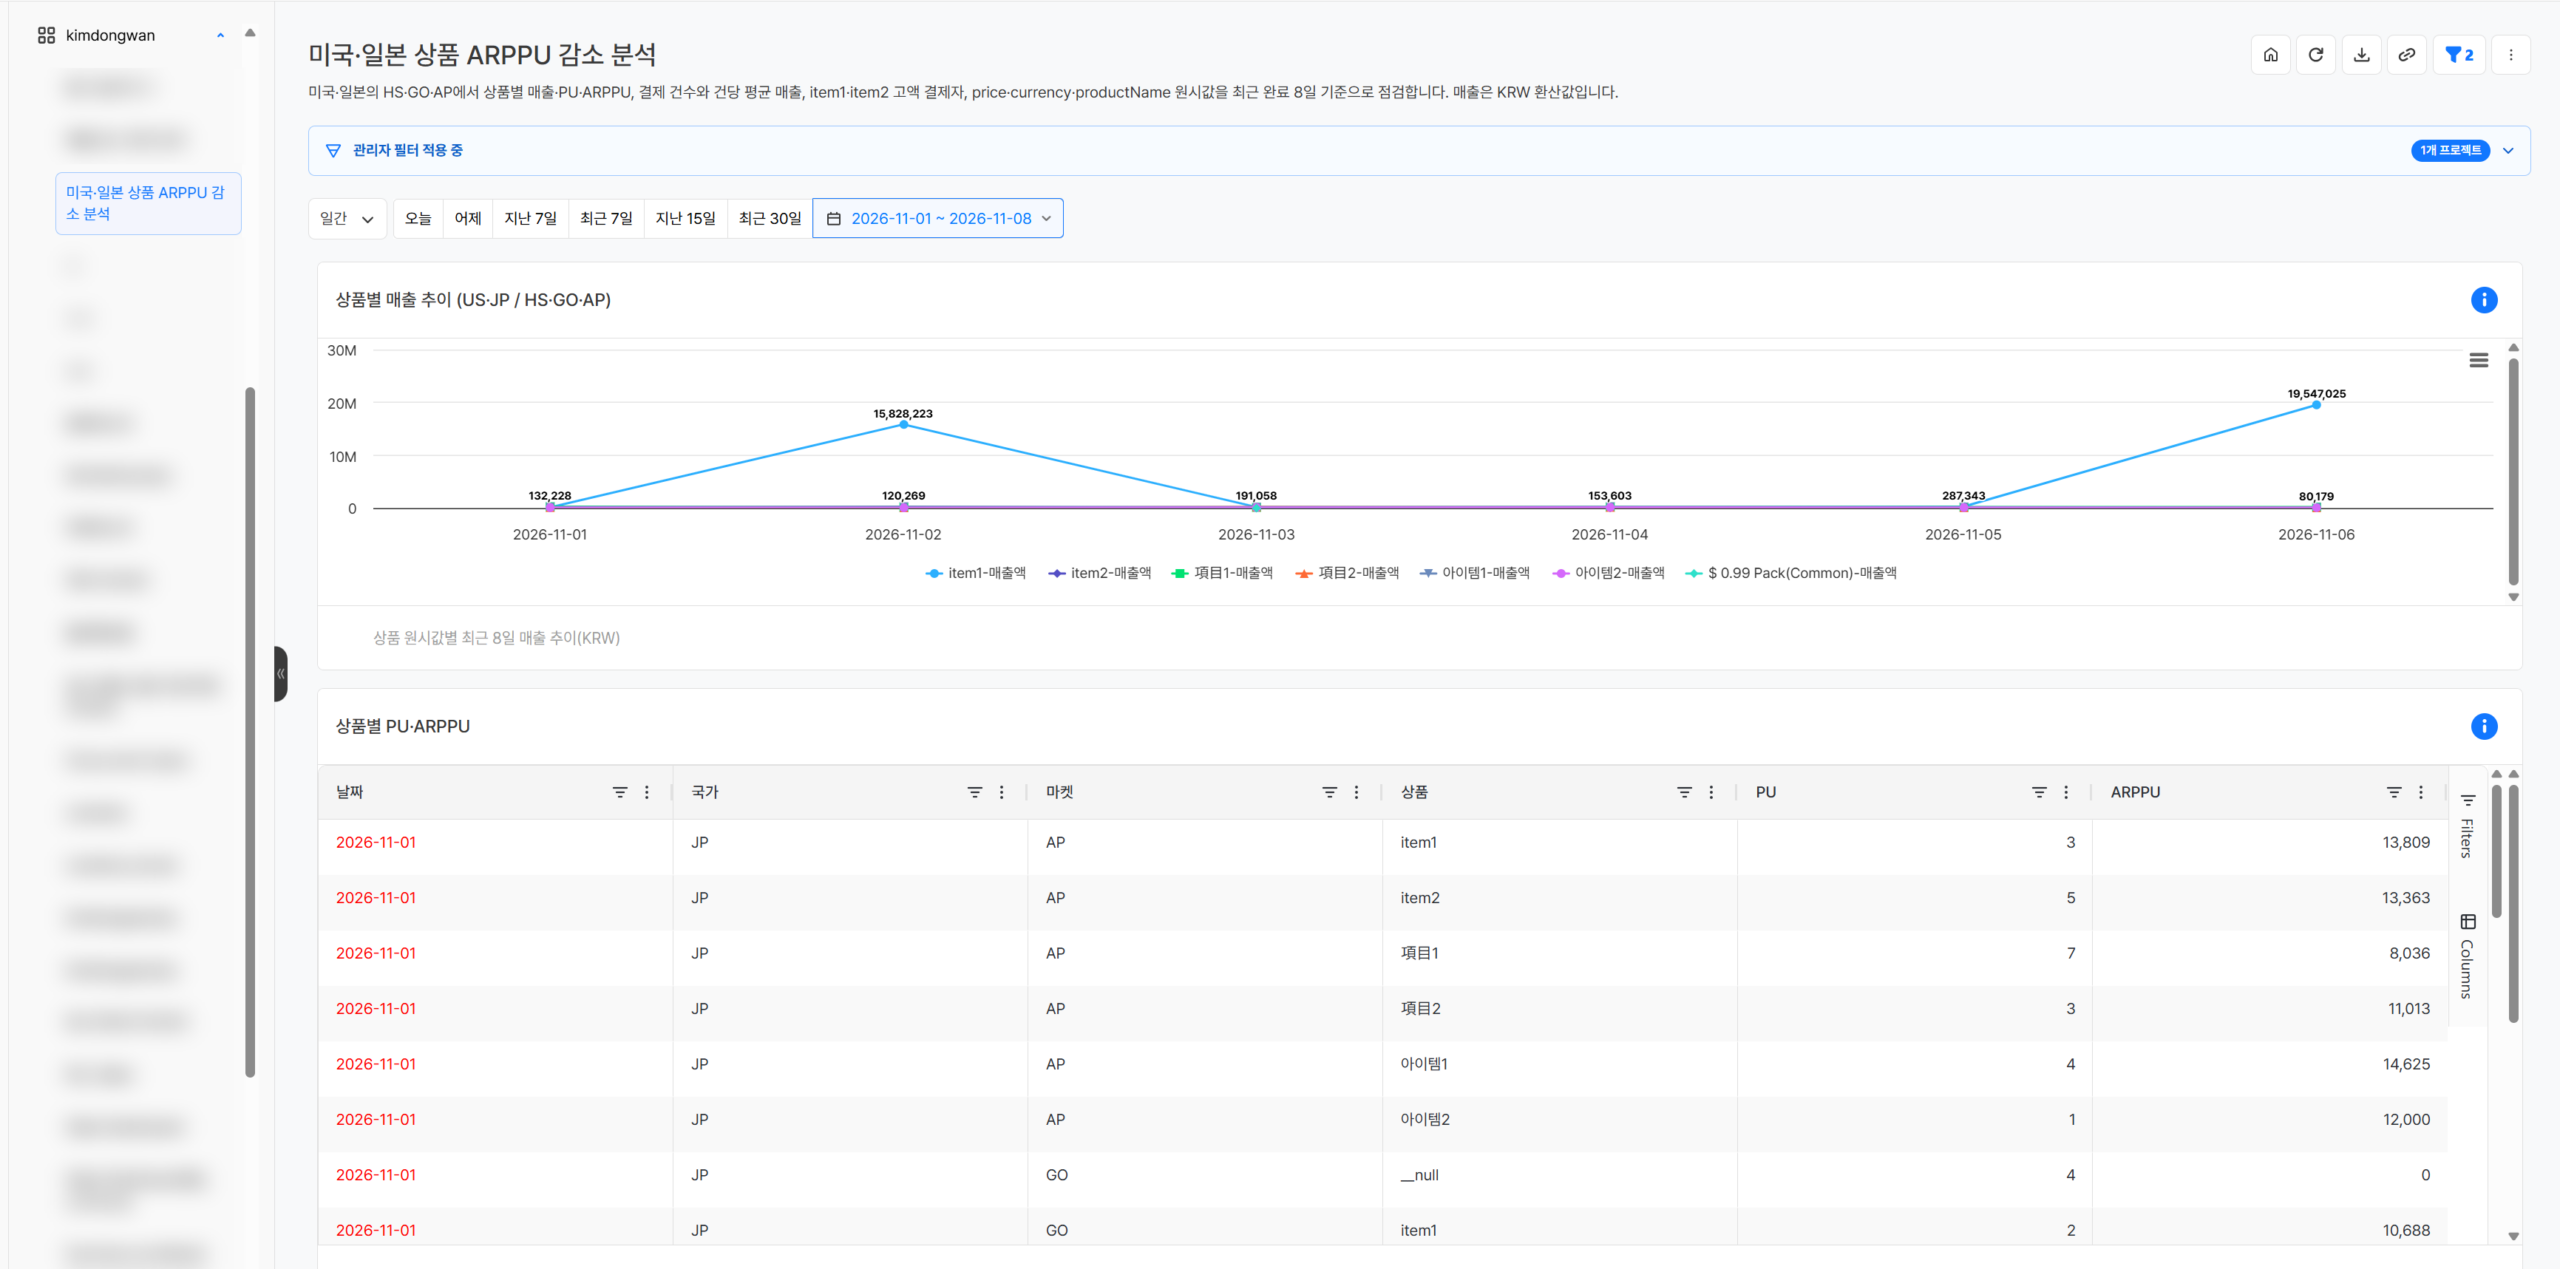
생성이 완료되면 제공된 링크를 열어 대시보드 이름과 설명, 조회 기간, 통화와 포함된 차트를 확인한다. 다음 대시보드에는 상품별 매출 추이와 국가·마켓·상품별 PU·ARPPU를 비롯해 추천받은 다섯 가지 차트가 최근 완료된 8일 기준으로 구성되어 있다.
각 차트가 의도한 지표와 차원을 사용하고 있는지, 관리자 필터와 날짜 조건이 분석 기준에 맞는지도 함께 점검한다. 필요한 경우 수정할 차트와 변경 내용을 자연어로 요청하고, 적용 내용을 확인한 뒤 수정할 수 있다.
Hive 애널리틱스 시작해보기
Hive Axyl Plugin을 활용하면 분석 결과를 자연어로 차트에 반영하고, 반복해서 확인할 지표를 대시보드로 구성할 수 있다.
Hive 애널리틱스는 Hive SDK를 통해 수집된 이벤트를 기반으로 자연어로 차트를 생성하고 여러 차트를 대시보드로 구성할 수 있는 게임 전문 애널리틱스 솔루션이다. 지금 ChatGPT에 Hive Axyl Plugin을 설치해 Hive 애널리틱스에서 차트와 대시보드를 자연어로 구성해보자.
ChatGPT에 Hive Axyl Plugin을 설치하면 Hive 애널리틱스의 지표를 자연어로 조회하고, 이전 질문의 맥락을 이어 국가·마켓·상품 순서로 분석 범위를 좁힐 수 있다. 사용하려면 애널리틱스 관리자가 조직에 프로젝트와 멤버를 등록하고, 플러그인을 쓸 계정을 조직의 MCP 멤버로 설정해야 한다. 분석 결과는 변화가 집중된 구간과 원인 후보를 보여주며, 해당 상품의 고액 주문·가격·프로모션 변경 여부는 추가로 점검한다.
반복 설정을 줄이는 자연어 분석
게임 지표를 분석하려면 먼저 확인할 지표와 기간, 비교 기준, 차원과 필터를 정해야 한다. “어제 매출이 왜 줄었는가”라는 질문이 있더라도 분석 화면에서는 매출과 결제 이용자 지표를 선택하고, 지난주 같은 요일과 비교한 뒤 국가와 마켓 등의 조건을 차례로 적용해야 한다.
생성형 AI를 활용하면 이러한 분석 목적을 자연어로 전달할 수 있다. 부족한 조건은 대화를 통해 정하고, 첫 번째 분석 결과를 바탕으로 국가·마켓별 비교나 상품별 분석을 연속해서 요청할 수 있다. 이전 질문의 맥락이 유지되므로 분석 조건을 매번 처음부터 설명하거나 화면에서 다시 구성하는 과정을 줄일 수 있다.
어떤 지표를 추가로 확인해야 할지 명확하지 않을 때에는 현재 결과를 바탕으로 다음 분석 기준을 추천받을 수도 있다. 자연어 분석을 활용하면 업무 질문을 실제 분석 조건으로 구체화하고, 앞선 결과에서 새로운 분석 관점으로 빠르게 확장할 수 있다.
Hive 애널리틱스의 자연어 기반 데이터 분석
ChatGPT에 Hive Axyl Plugin을 설치하면 자연어로 Hive 애널리틱스의 지표를 조회하고 분석할 수 있다. 확인하려는 지표와 기간을 문장으로 요청한 뒤 국가, 마켓, 앱 등의 차원을 추가하여 변화에 영향을 준 조건을 살펴볼 수 있다.
Hive Axyl Plugin의 애널리틱스 기능은 게임에 적용된 SDK 버전과 관계없이 사용할 수 있다. Hive SDK v4 또는 Hive Axyl을 사용하는 프로젝트 모두에서 조직과 계정에 부여된 권한 범위의 애널리틱스 데이터를 분석할 수 있다.
- 플러그인 설치: ChatGPT의 플러그인 목록에서 Hive Axyl Plugin을 찾아 설치한 뒤 새 대화를 시작한다.
- 조직 설정: 애널리틱스 관리자가
계정 > 조직 관리에서 사용할 프로젝트와 멤버를 조직에 등록한다. - MCP 권한 설정: 플러그인을 사용할 계정을 조직의 MCP 멤버로 설정한다.
- 분석 시작: ChatGPT에서 Hive 계정을 연결하고 사용할 조직, 프로젝트와 상용·샌드박스 환경을 확인한다.
조직별 프로젝트 접근 범위
MCP 멤버로 등록된 계정은 해당 조직에 연결된 프로젝트의 데이터만 조회할 수 있다.
Hive Axyl Plugin의 설치 방법과 이를 활용한 애널리틱스 활용 사례는 각각 Hive Axyl Plugin 설치 및 Hive Axyl AI 소개에서 살펴볼 수 있다.
KPI 변화와 원인 분석해보기
예를 들어 어제 이용자와 매출 지표가 지난주 같은 요일보다 어떻게 달라졌는지 확인한다고 가정해보자. 첫 질문에서 전체 변화를 확인한 뒤 국가와 마켓, 상품 순서로 질문을 이어가면 매출 감소의 영향 범위를 단계적으로 좁힐 수 있다.
첫 번째 질문: 이용자와 매출 지표는 얼마나 달라졌을까?
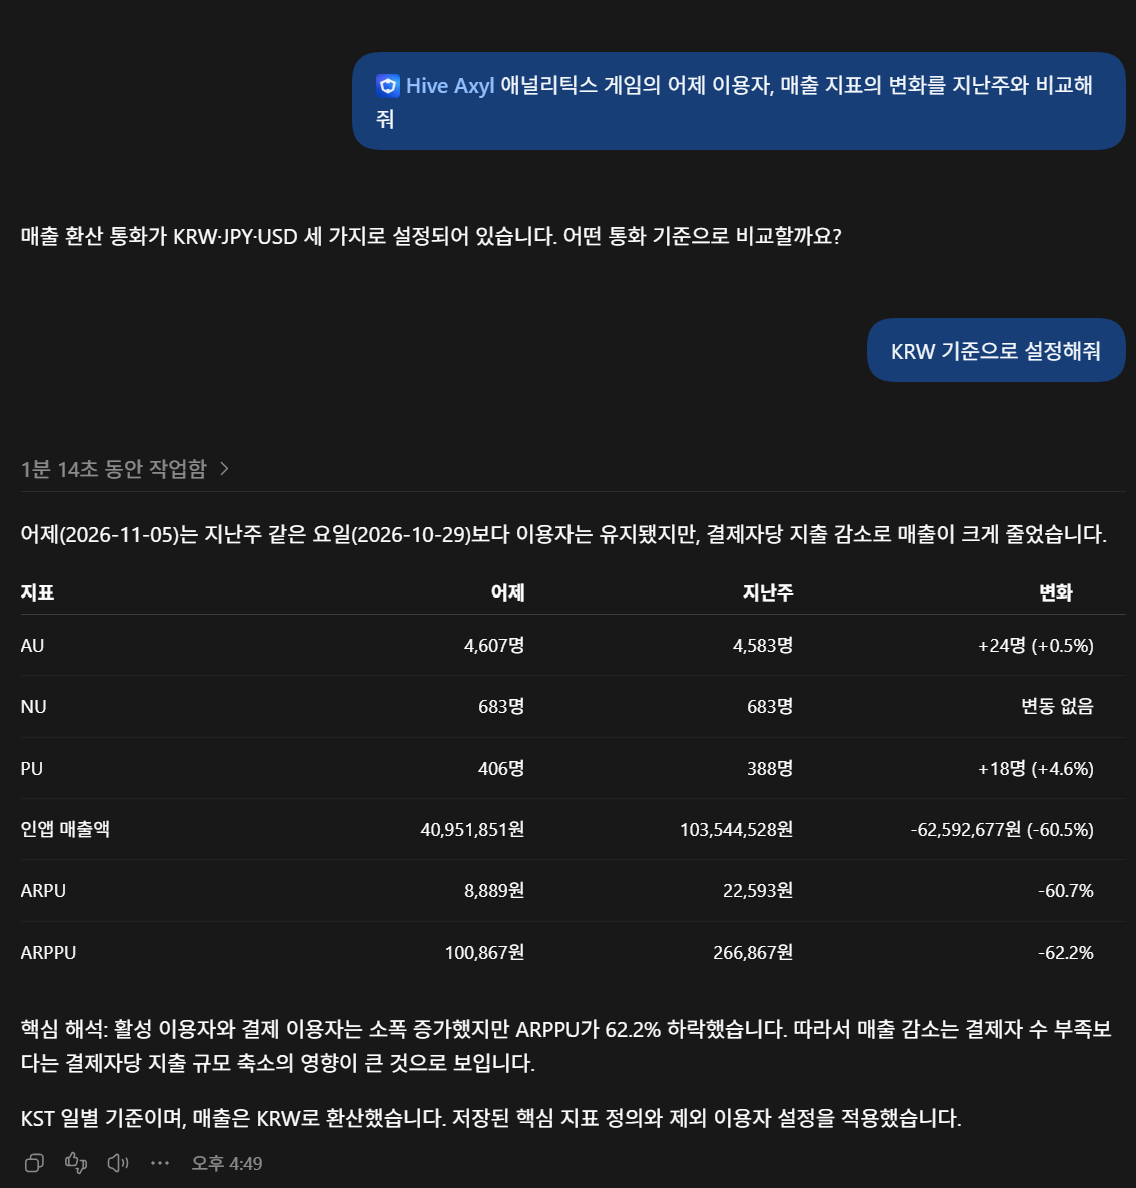
게임의 어제 이용자, 매출 지표의 변화를 지난주와 비교해줘.
매출 환산 통화가 여러 개 설정되어 있다면 비교에 사용할 통화를 먼저 선택한다. KRW를 기준으로 지정하면 어제와 지난주 같은 요일의 활성 이용자(AU), 신규 이용자(NU), 결제 이용자(PU), 인앱 매출액, 이용자당 평균 매출(ARPU)과 결제 이용자당 평균 매출(ARPPU)을 같은 기준으로 비교할 수 있다.
다음 결과에서는 활성 이용자와 결제 이용자의 변화는 크지 않았지만 매출액과 ARPPU가 크게 감소한 것을 확인했다. 이를 통해 매출 감소가 결제 이용자 수보다 결제자당 지출 규모의 변화와 더 관련이 있다는 가설을 세울 수 있다.
두 번째 질문: ARPPU 감소가 크게 나타난 국가와 마켓은 어디일까?
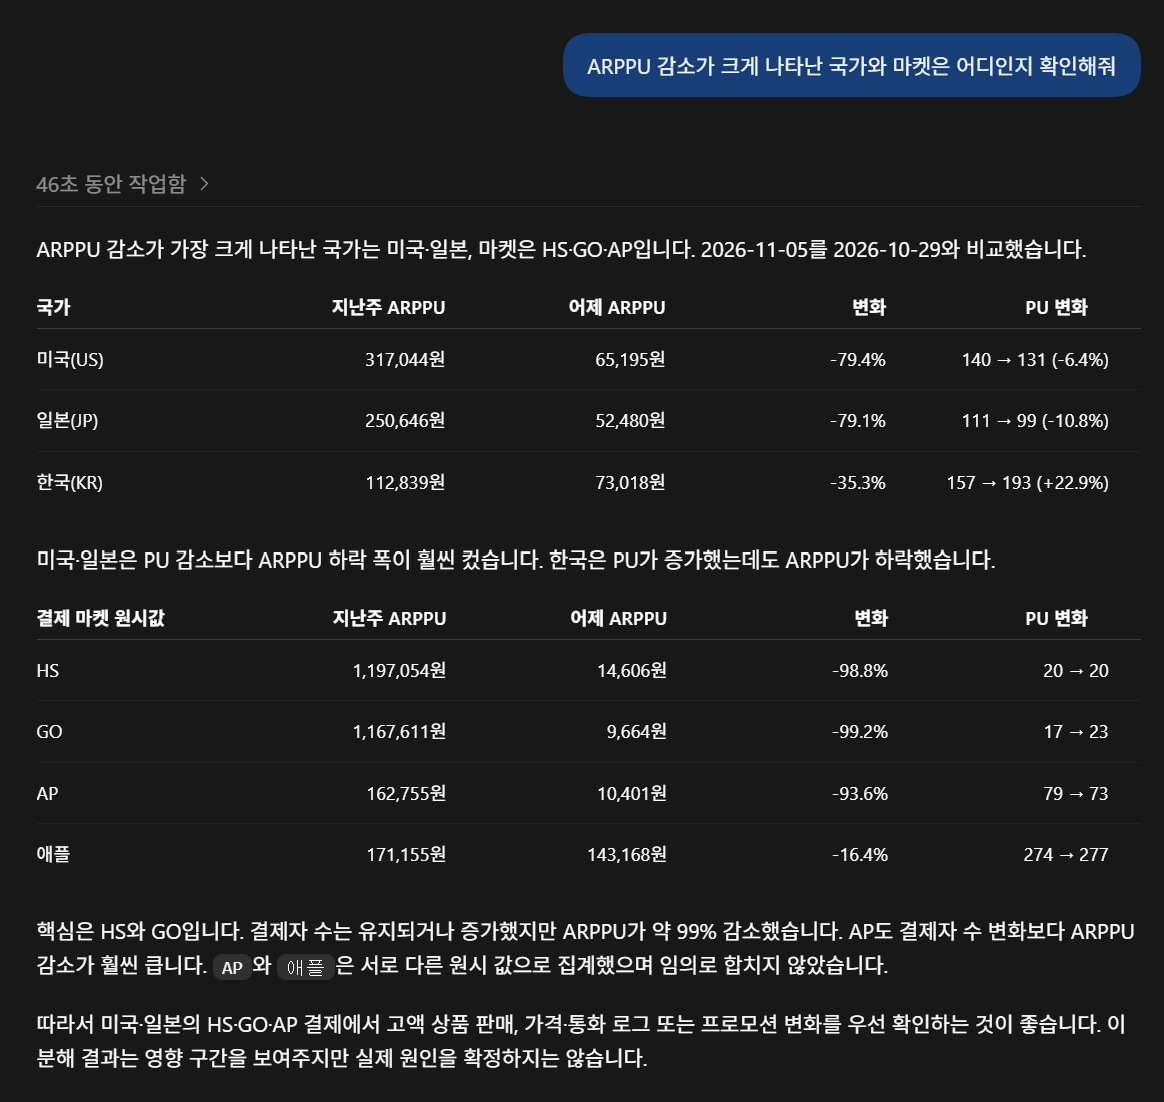
ARPPU 감소가 크게 나타난 국가와 마켓은 어디인지 확인해줘.
국가와 마켓별 ARPPU와 PU 변화를 함께 비교하면 결제 이용자 수의 변화보다 결제자당 지출 규모의 감소가 크게 나타난 구간을 찾을 수 있다. 다음 결과에서는 미국과 일본의 ARPPU 하락 폭이 컸으며, 마켓별로는 HS, GO와 AP를 우선 확인할 수 있었다.
마켓 값에 서로 다른 표기가 함께 수집되고 있다면 임의로 합산하지 않고 원시값을 구분해 살펴본다. 이 결과를 바탕으로 감소 폭이 큰 국가와 마켓의 상품 판매를 다음 질문에서 확인한다.
세 번째 질문: 어떤 상품이 ARPPU 감소에 가장 크게 영향을 주었을까?
미국·일본의 HS·GO·AP에서 어떤 상품이 ARPPU 감소에 가장 크게 영향을 주었는지 분석해줘.
감소 폭이 큰 국가와 마켓을 대상으로 상품별 매출, PU와 상품 ARPPU를 비교하면 변화에 크게 영향을 준 상품을 구체화할 수 있다. 다음 결과에서는 item1과 item2의 매출 감소가 대부분의 감소액을 설명했으며, 일부 구간에서는 PU가 유지되거나 증가했는데도 상품 ARPPU가 크게 하락한 것을 확인했다.
같은 상품이 서로 다른 원시 상품명으로 수집되고 있다면 값을 임의로 합치지 않고 구분해 확인한다. 분석 결과를 바탕으로 해당 상품의 고액 주문, 가격과 통화 로그, 프로모션 변경 여부를 추가로 점검할 수 있다.
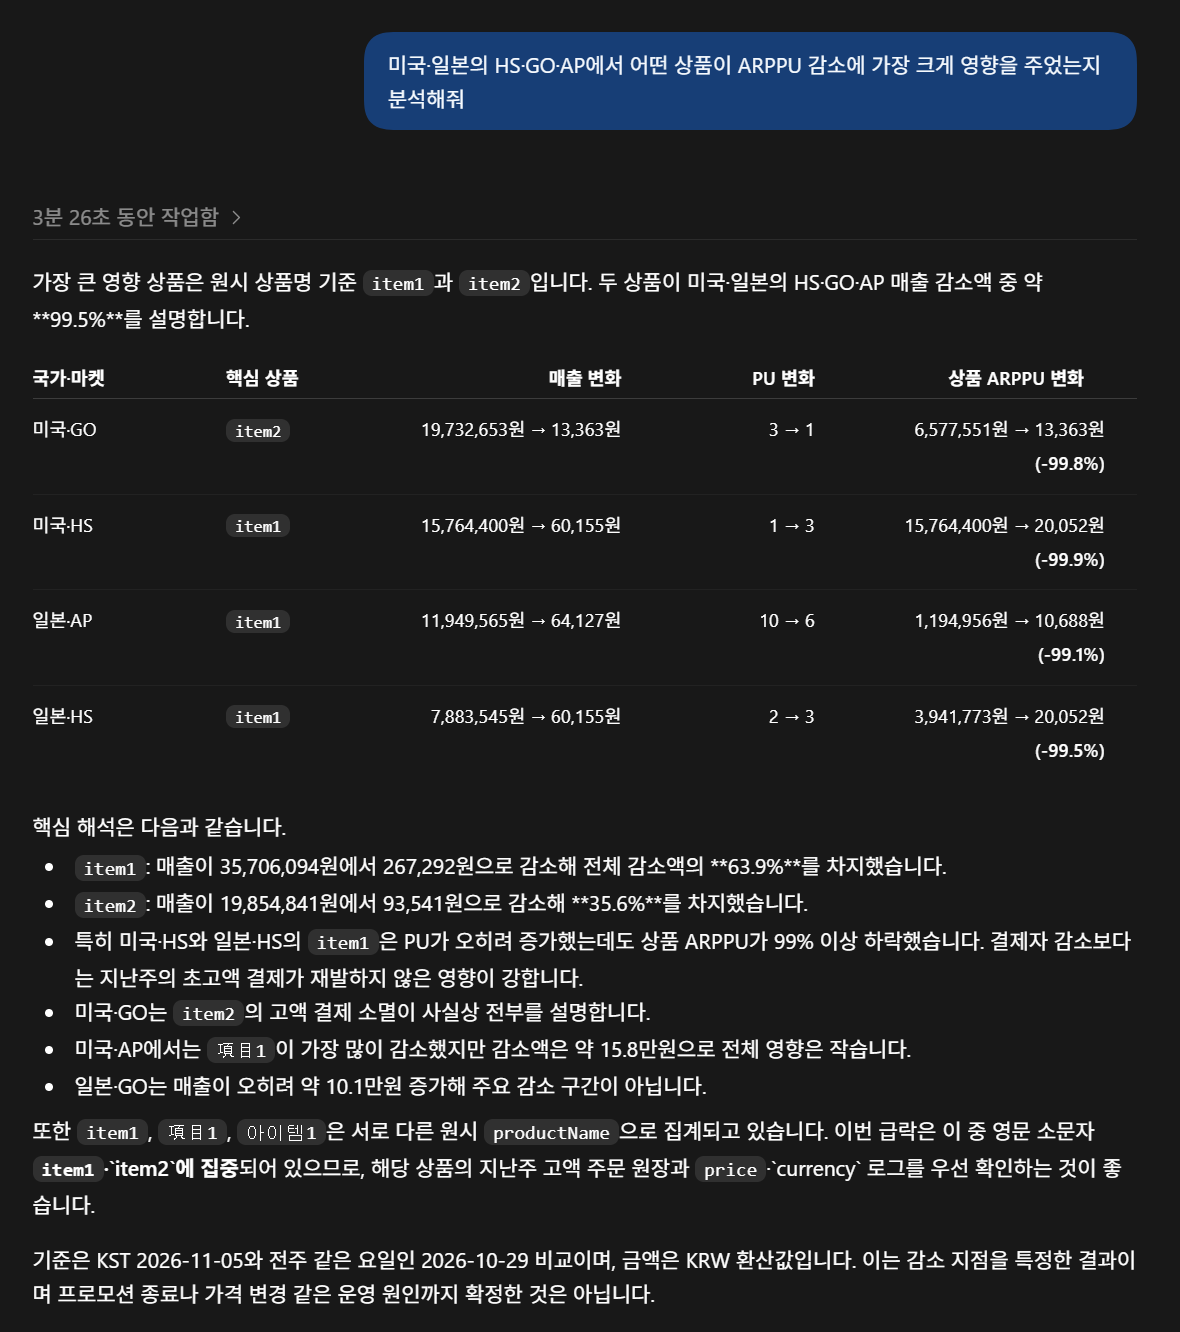
자연어로 후속 질문을 이어가면 전체 KPI의 변화에서 국가와 마켓, 상품 단위까지 분석 범위를 단계적으로 좁혀 원인 후보를 구체화할 수 있다. 분석 결과를 반복해서 확인할 차트와 대시보드를 구성하는 방법은 다음 편인 「자연어로 차트와 대시보드 구성하기: Hive Axyl Plugin 활용 2편」에서 확인할 수 있다.
Hive 애널리틱스 시작해보기
Hive Axyl Plugin을 활용하면 확인하려는 KPI를 자연어로 비교하고, 세부 차원을 적용해 변화의 원인을 단계적으로 살펴볼 수 있다.
Hive 애널리틱스는 Hive SDK를 통해 수집된 이벤트로 주요 KPI와 이용자 행동의 변화를 분석할 수 있는 게임 전문 애널리틱스 솔루션이다. 지금 ChatGPT에 Hive Axyl Plugin을 설치해 Hive 애널리틱스의 게임 데이터를 자연어로 분석해보자.
11월 4일, 사내 식당 Cooking에 특별한 손님이 찾아왔다. <흑백요리사2>의 중식 대가, 후덕죽 셰프다.
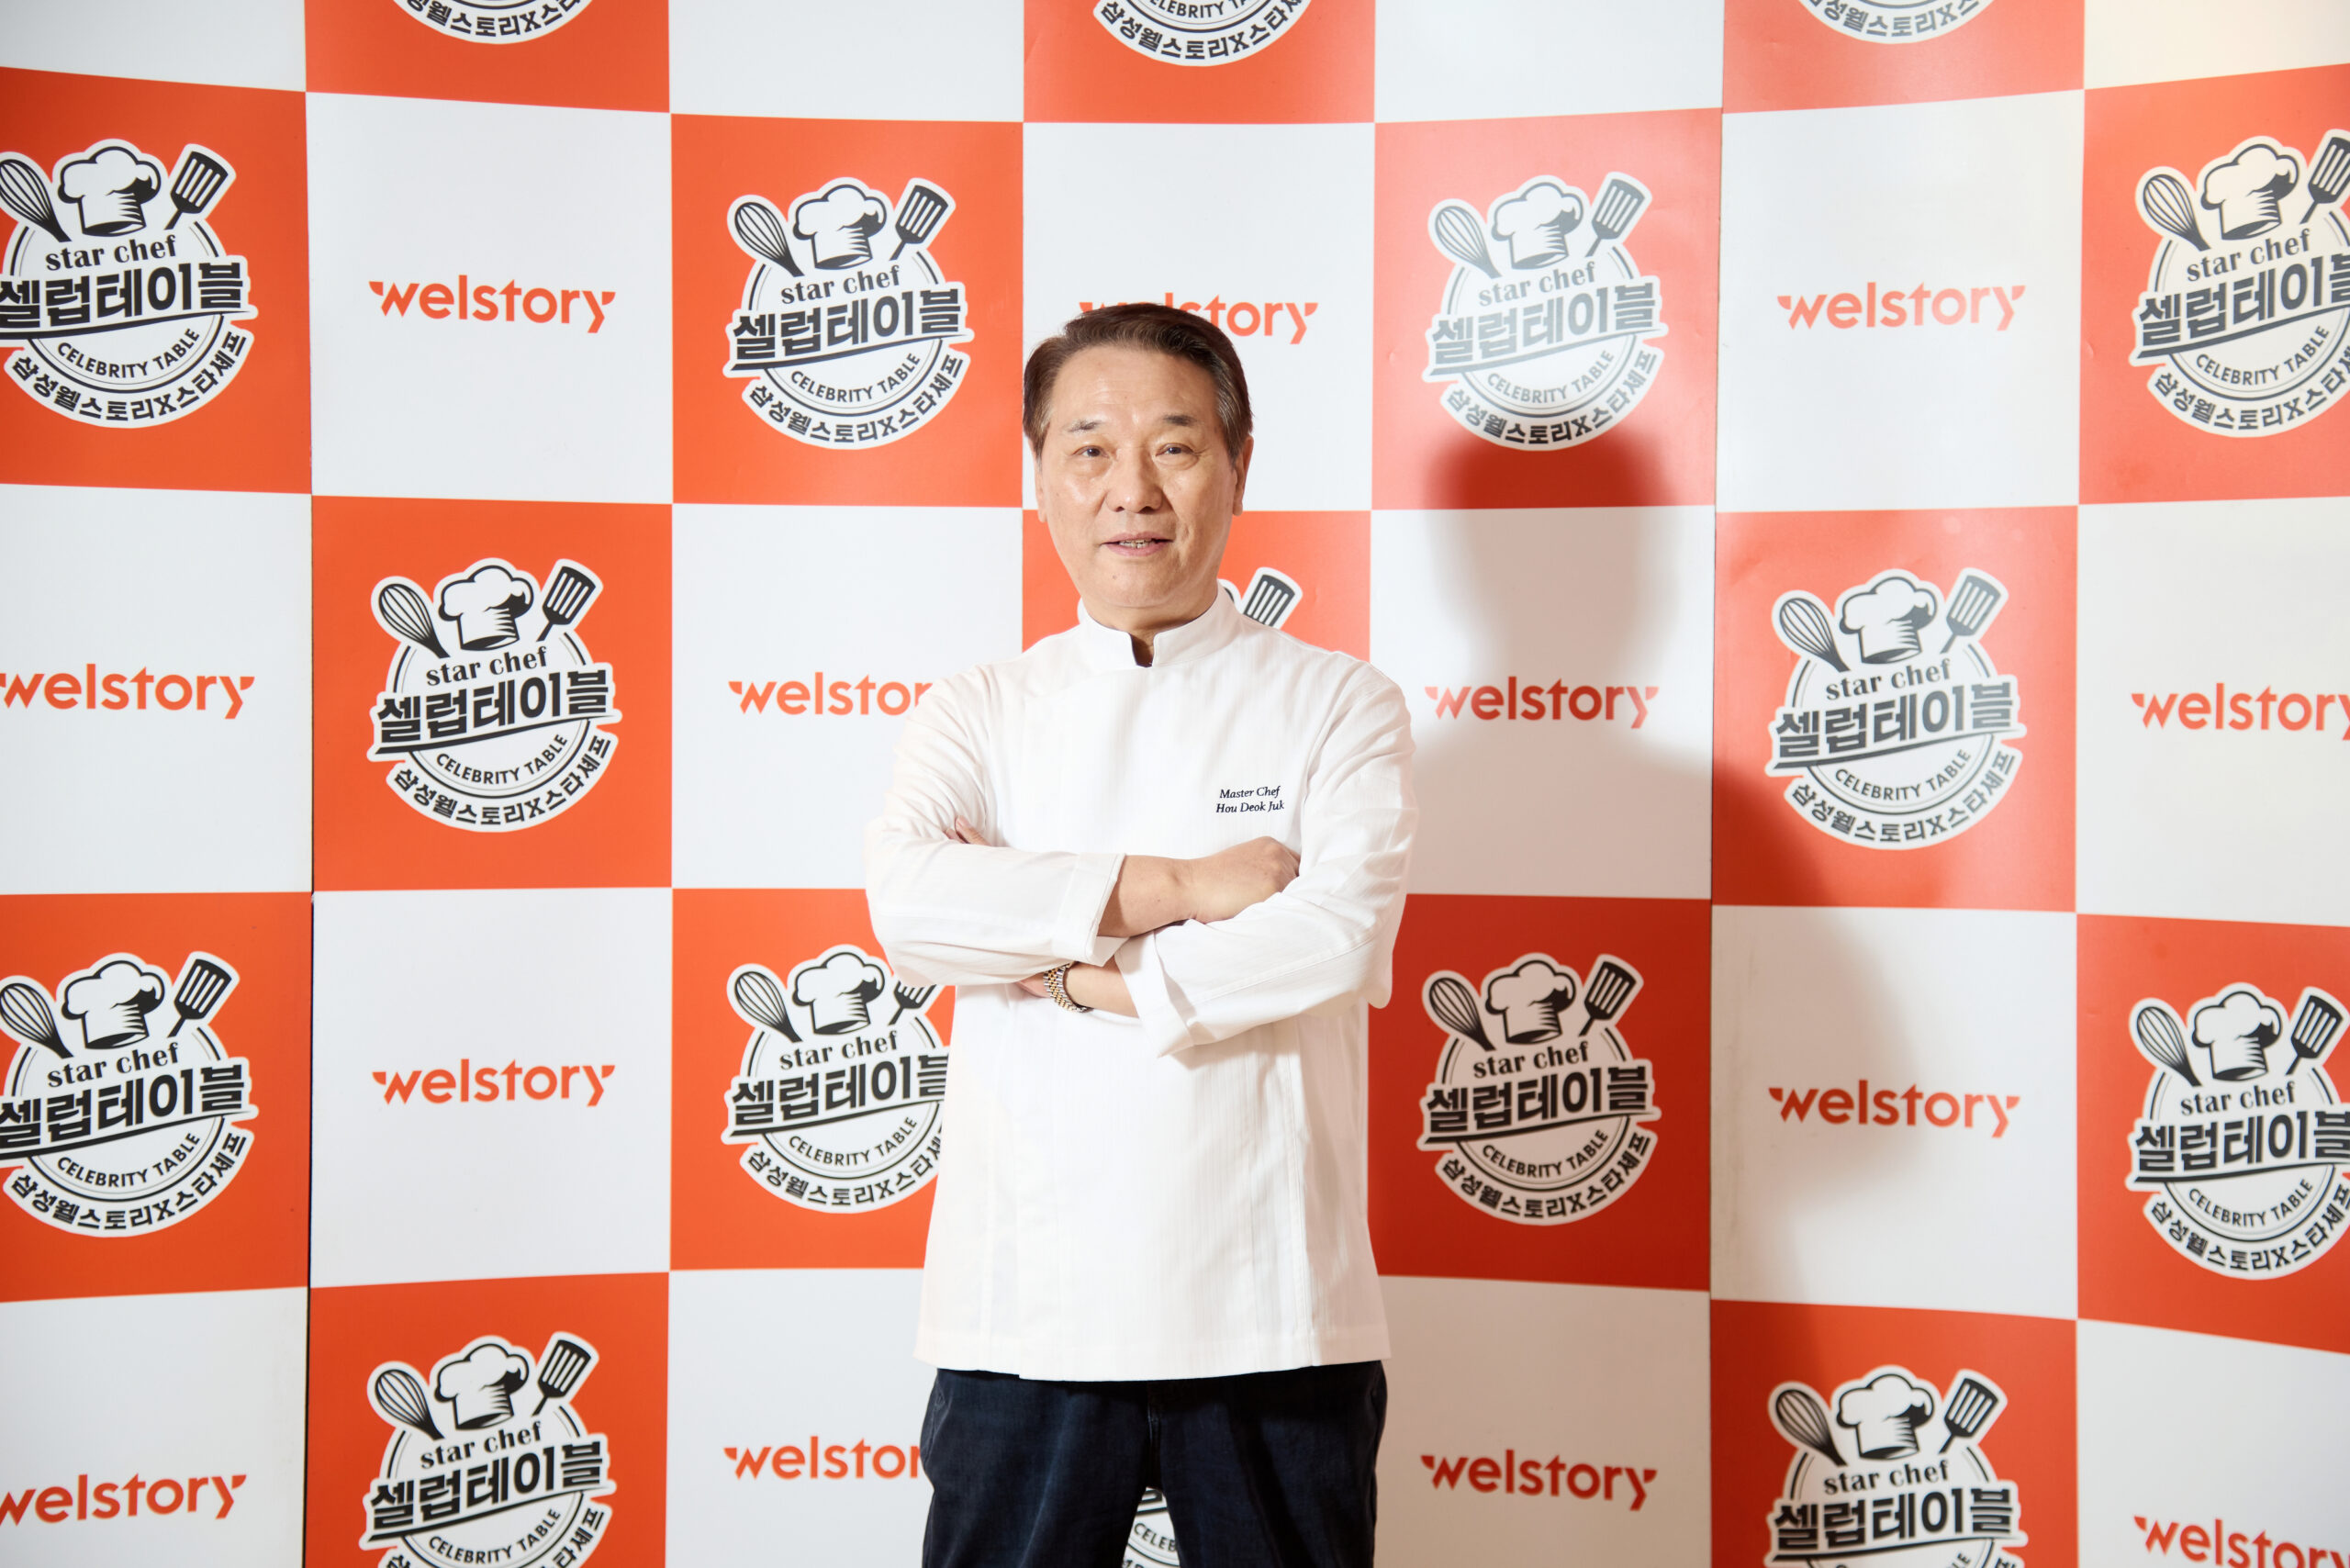
지난해 <흑백요리사> 시즌1의 여경래 셰프에 이어 올해는 시즌2의 후덕죽 셰프까지, 두 해 연속 중식 대가의 손맛을 사내 식당에서 맛보게 된 셈이다.
컴투스 사내 식당 ‘셀럽 테이블’이란?
셀럽 테이블은 사내 식당에서 부담 없이 인기 맛집의 메뉴를 즐겨보자는 취지로 삼성웰스토리가 운영하는 프로그램이다. 유명 셰프가 자신의 인기 레시피를 단체 급식에 맞게 개발해 사내 식당에서 선보인다. 컴투스에서는 이원일, 정호영, 여경래 셰프에 이어 후덕죽 셰프가 네 번째 주인공으로 나섰다.
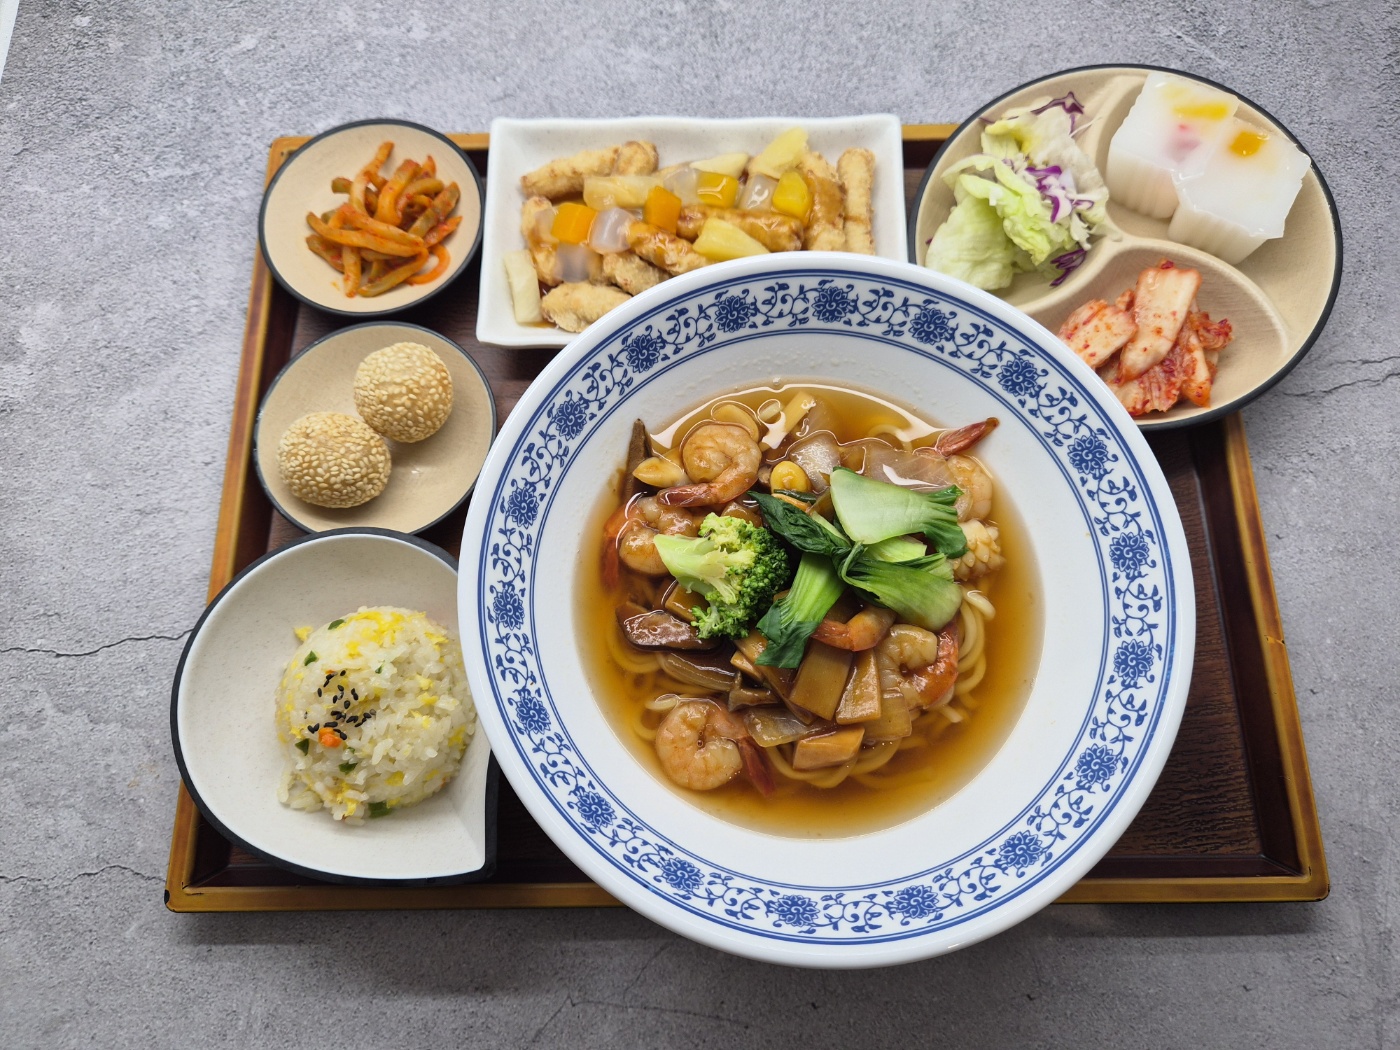
오늘의 메뉴, 후덕죽 셰프의 팔진탕면
이날의 메인 메뉴는 팔진탕면이다. 삼성웰스토리와 후덕죽 셰프가 함께 개발한 메뉴로, 새우와 버섯 등 8가지 재료의 맛이 국물 하나에 어우러진다. 여기에 계란볶음밥과 후르츠탕수육, 짜사이채, 참깨 경단 디저트 지마구가 곁들여 나와 중식 한 상이 차려졌다.
메뉴 상세
메인팔진탕면
곁들임계란볶음밥, 후르츠탕수육, 지마구, 짜사이채
맛있는 한 끼 뒤에는
셰프의 레시피를 단체 급식으로 옮긴 사람들은 사내 식당 조리사들이다. 조리사들은 준비 기간 동안 후덕죽 셰프의 레시피를 그대로 구현하는 데 공을 들였다. 사내 식당 Cooking의 이영아 영양사는 행사를 마친 뒤 조리사들의 노고부터 챙겼다.
“후덕죽 셰프님의 레시피를 그대로 구현해 주신 조리사님들도 준비 기간 동안 정말 고생 많으셨는데, 직원분들의 칭찬 피드백으로 피로가 녹으셨을 것 같네요.”
– 이영아 영양사 –
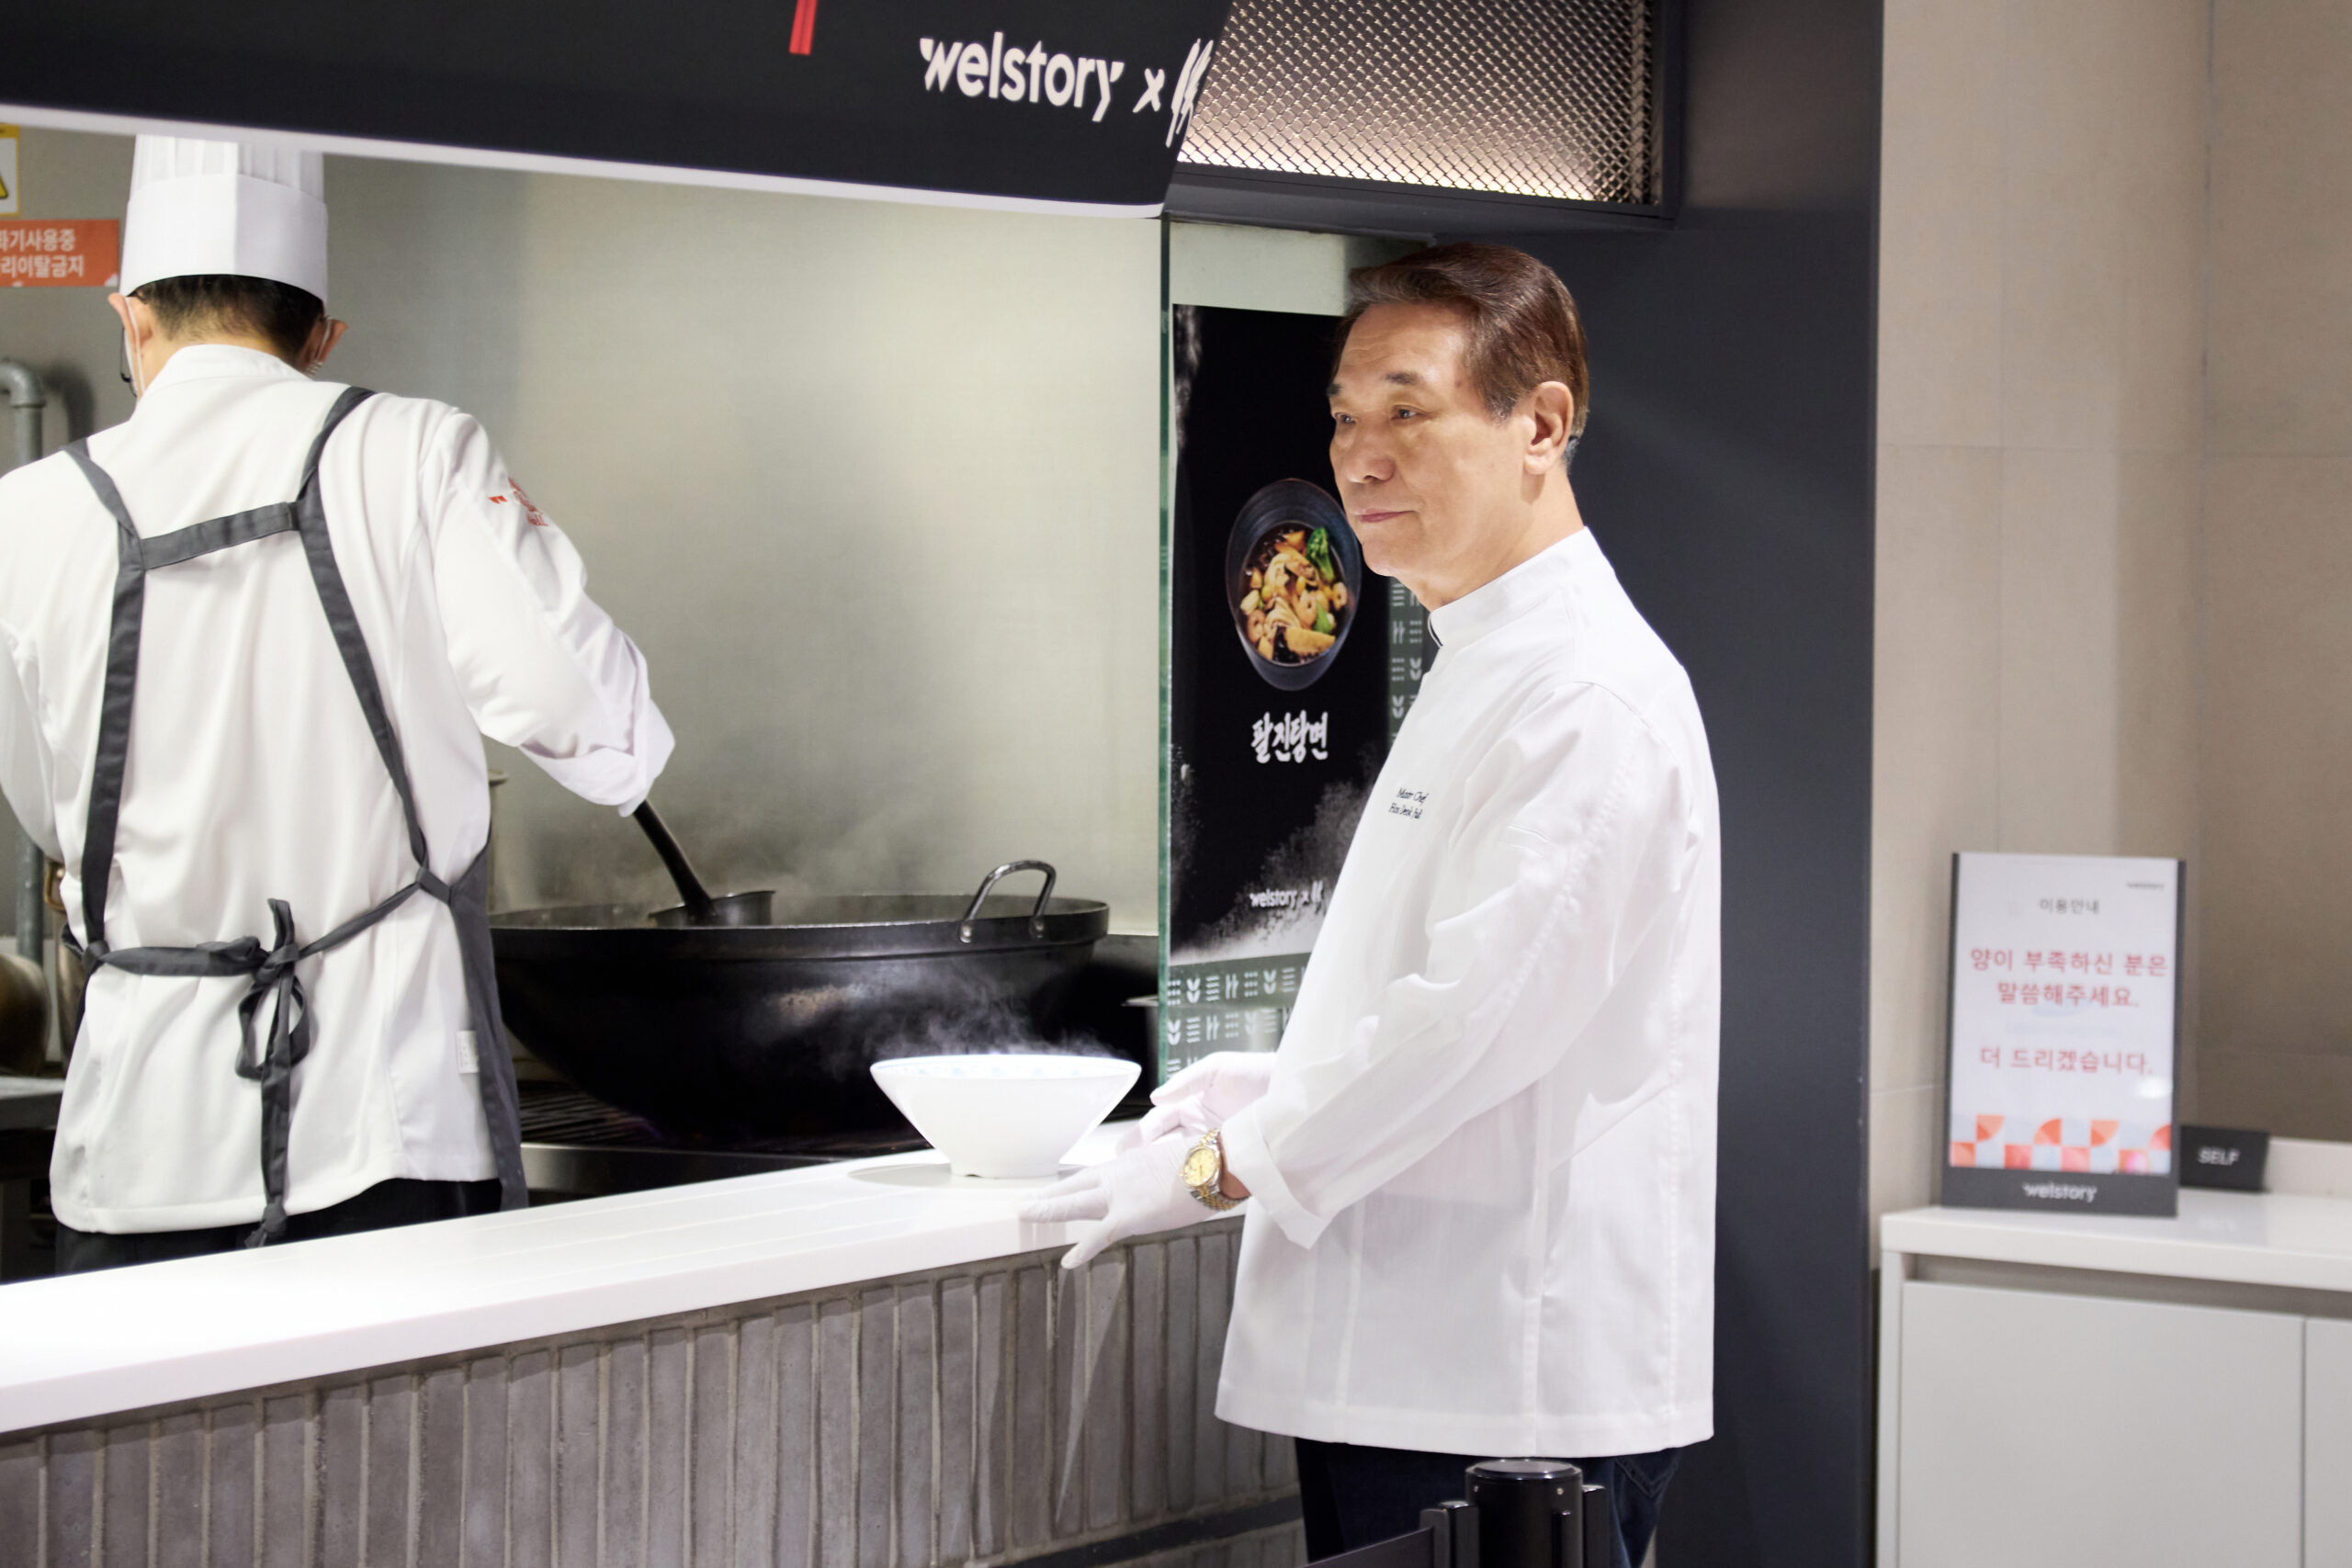
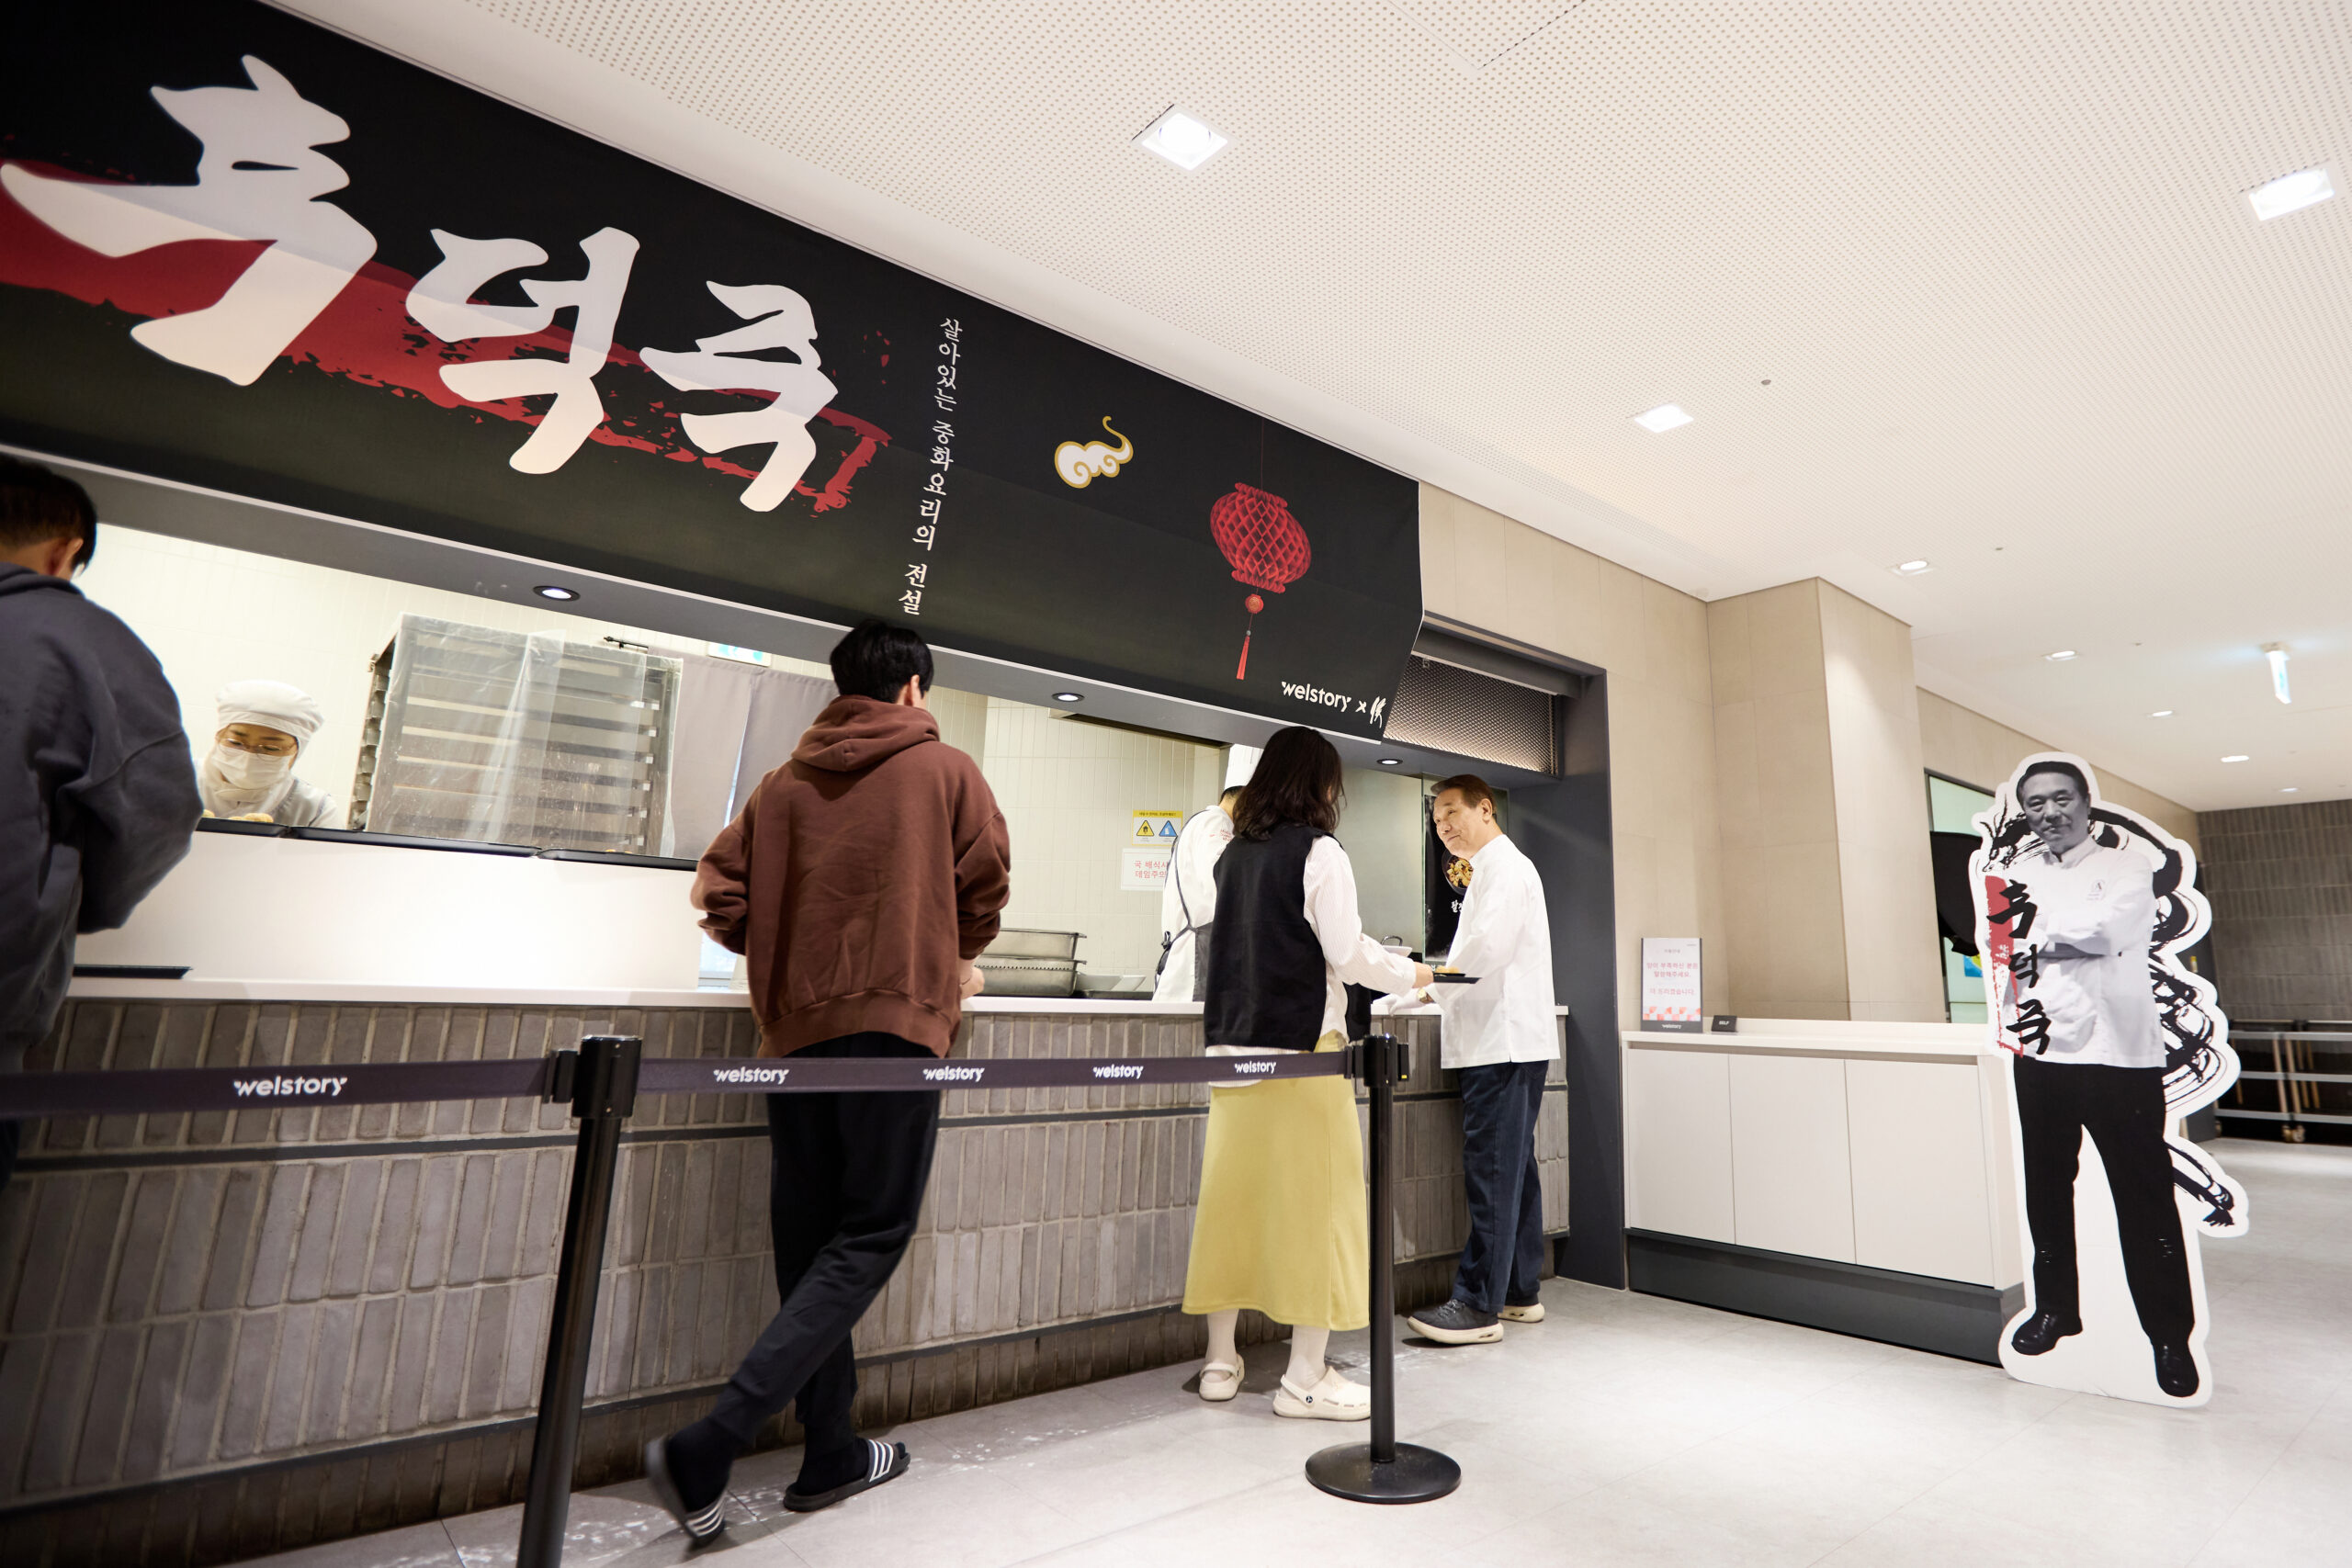
배식대에 선 후덕죽 셰프
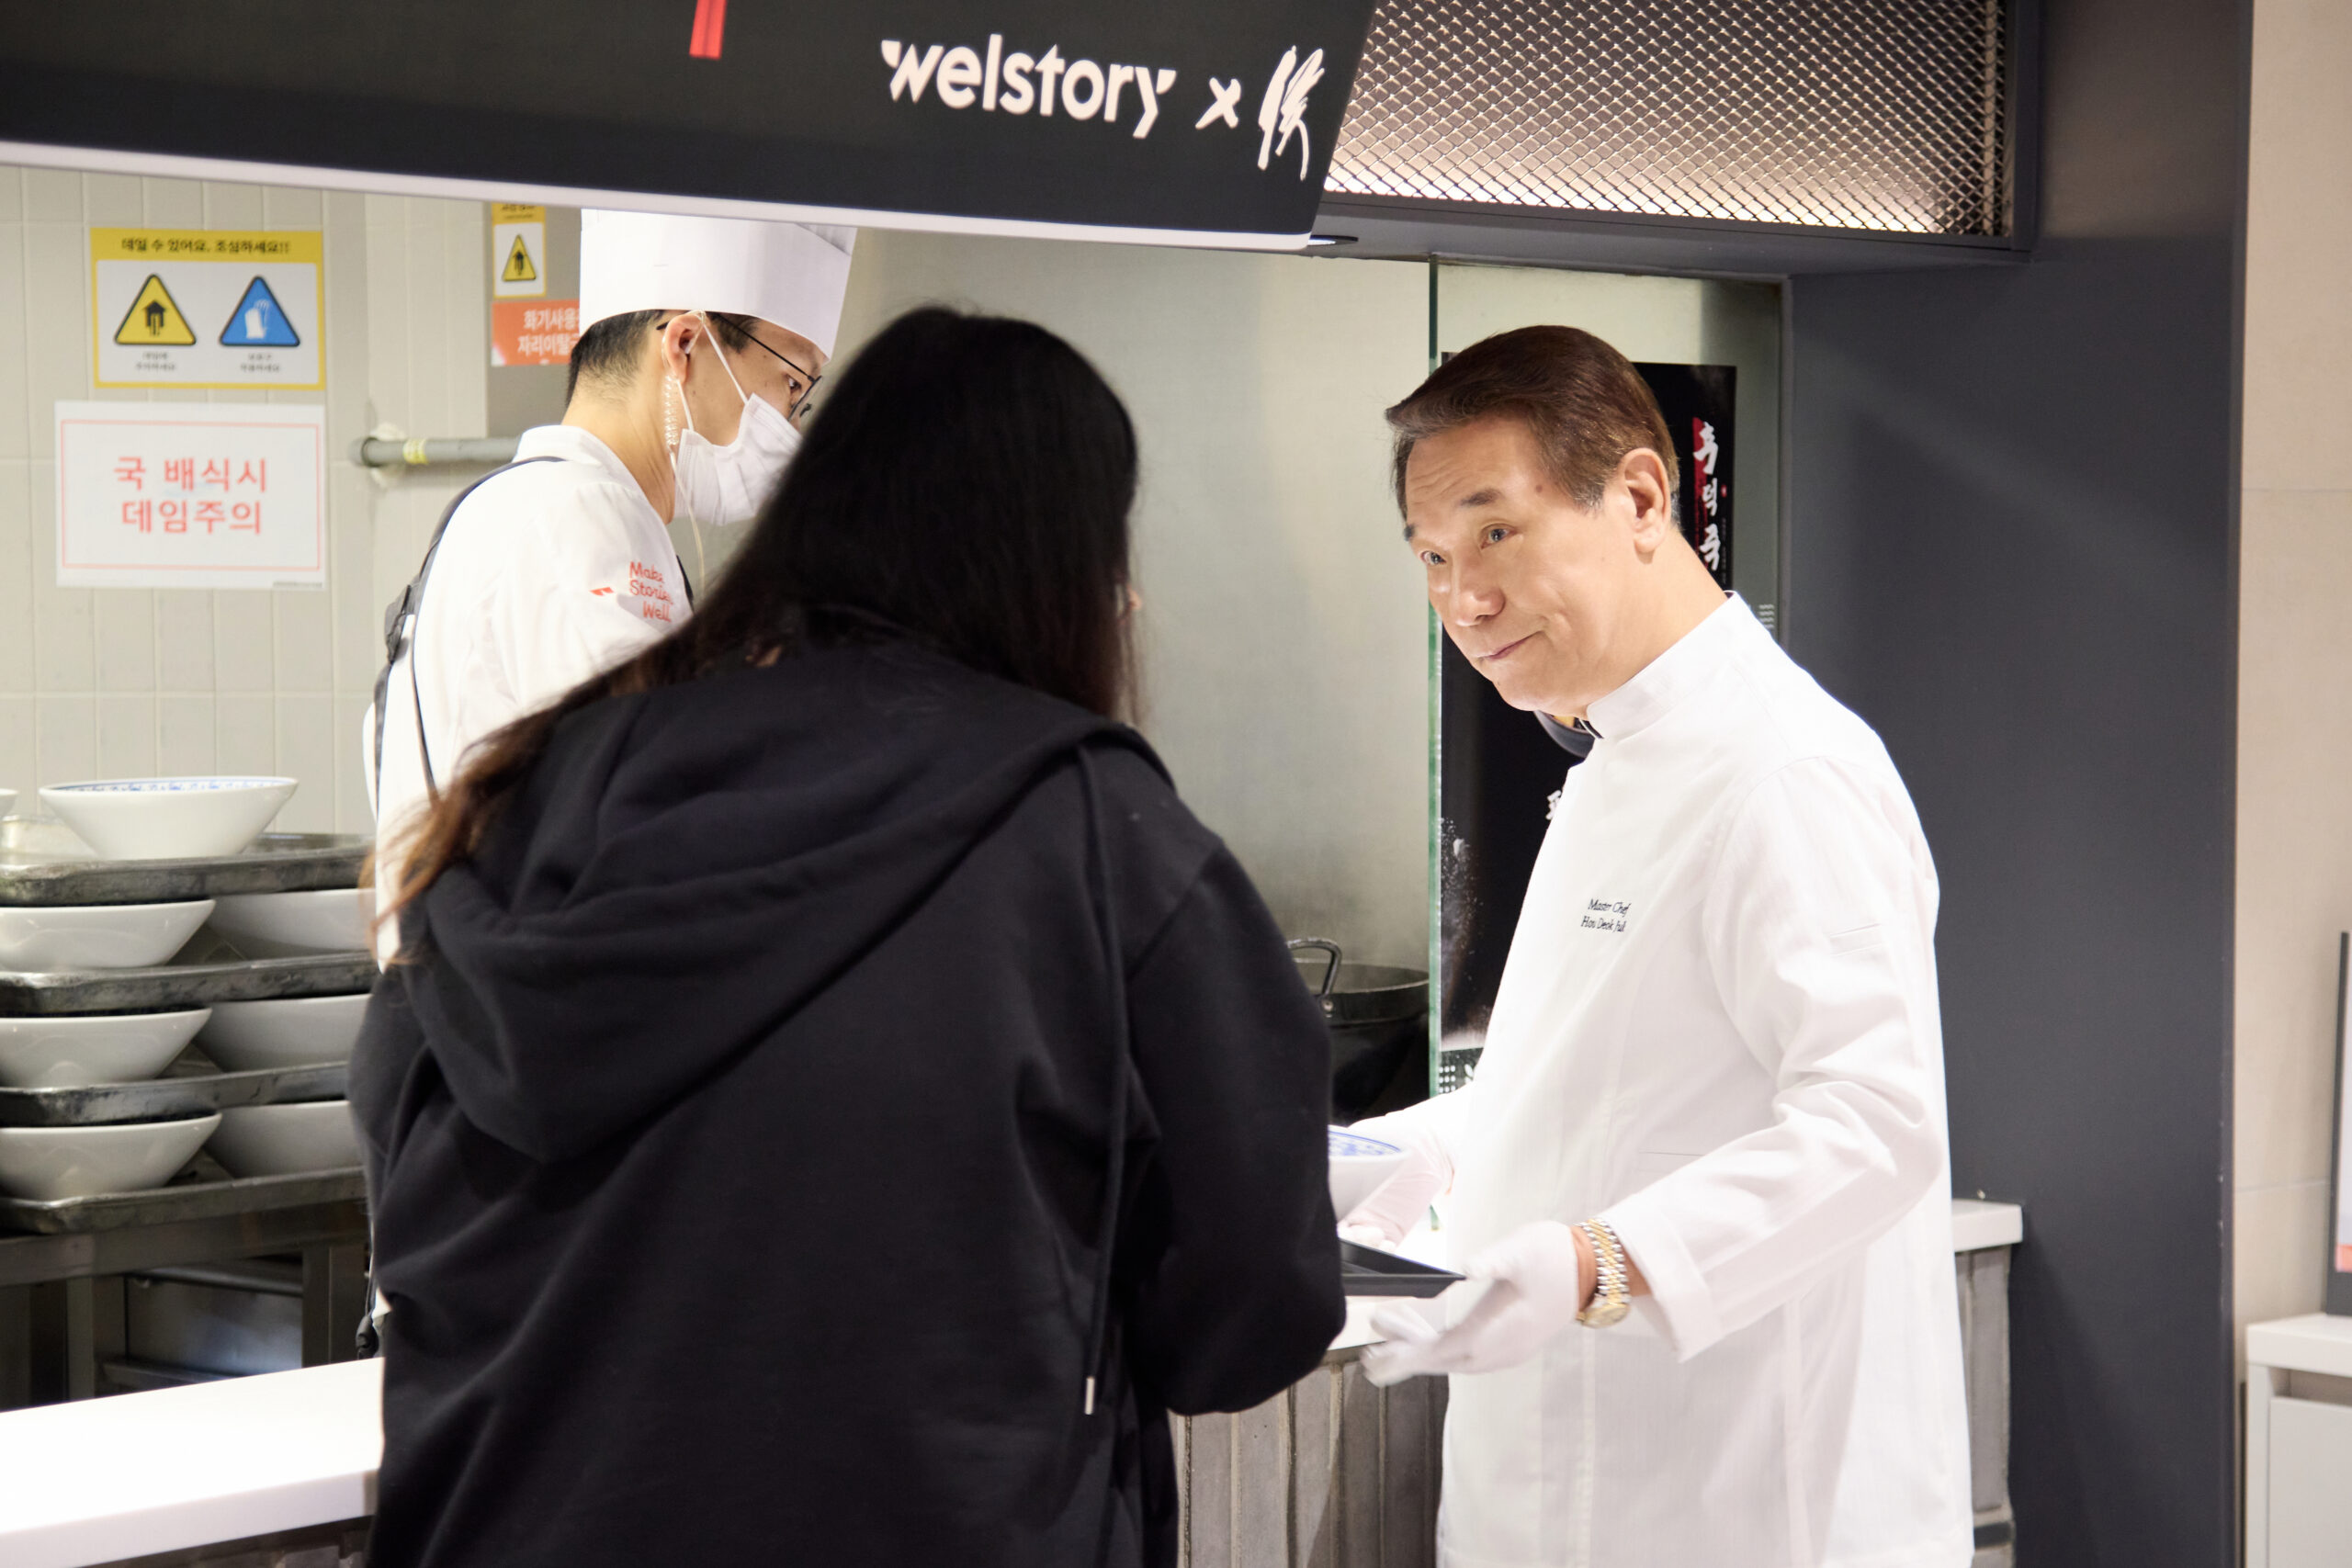
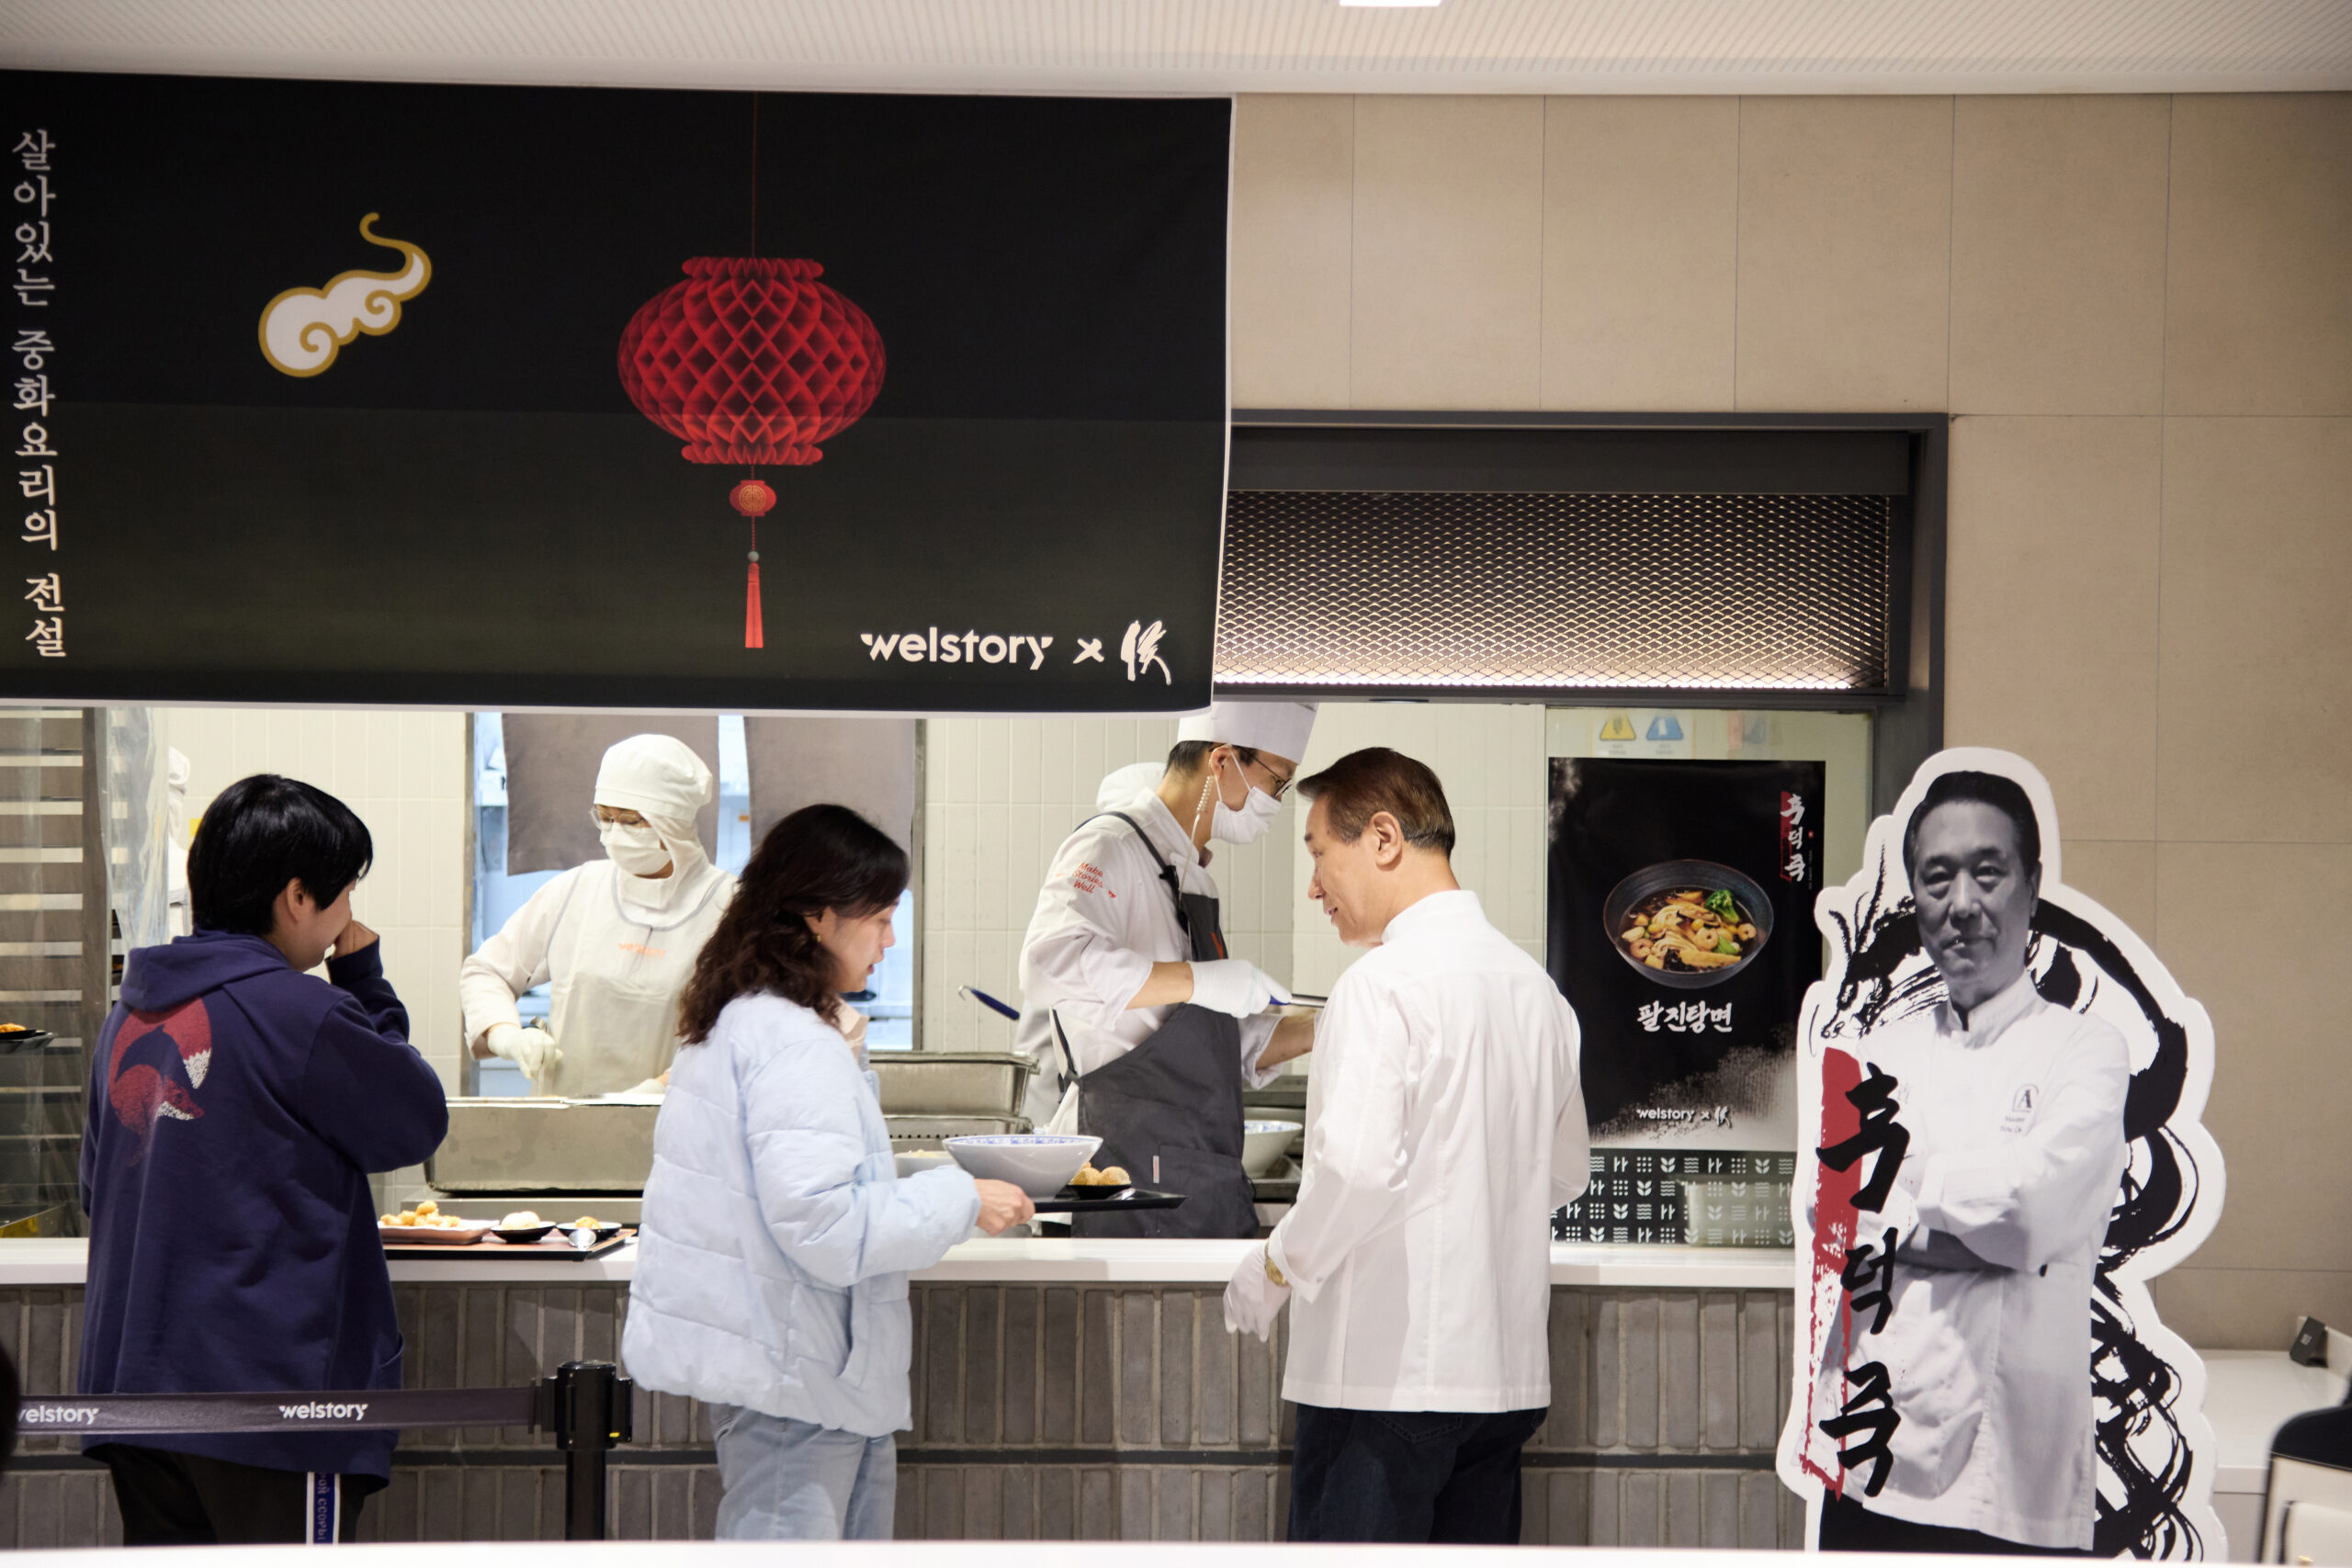
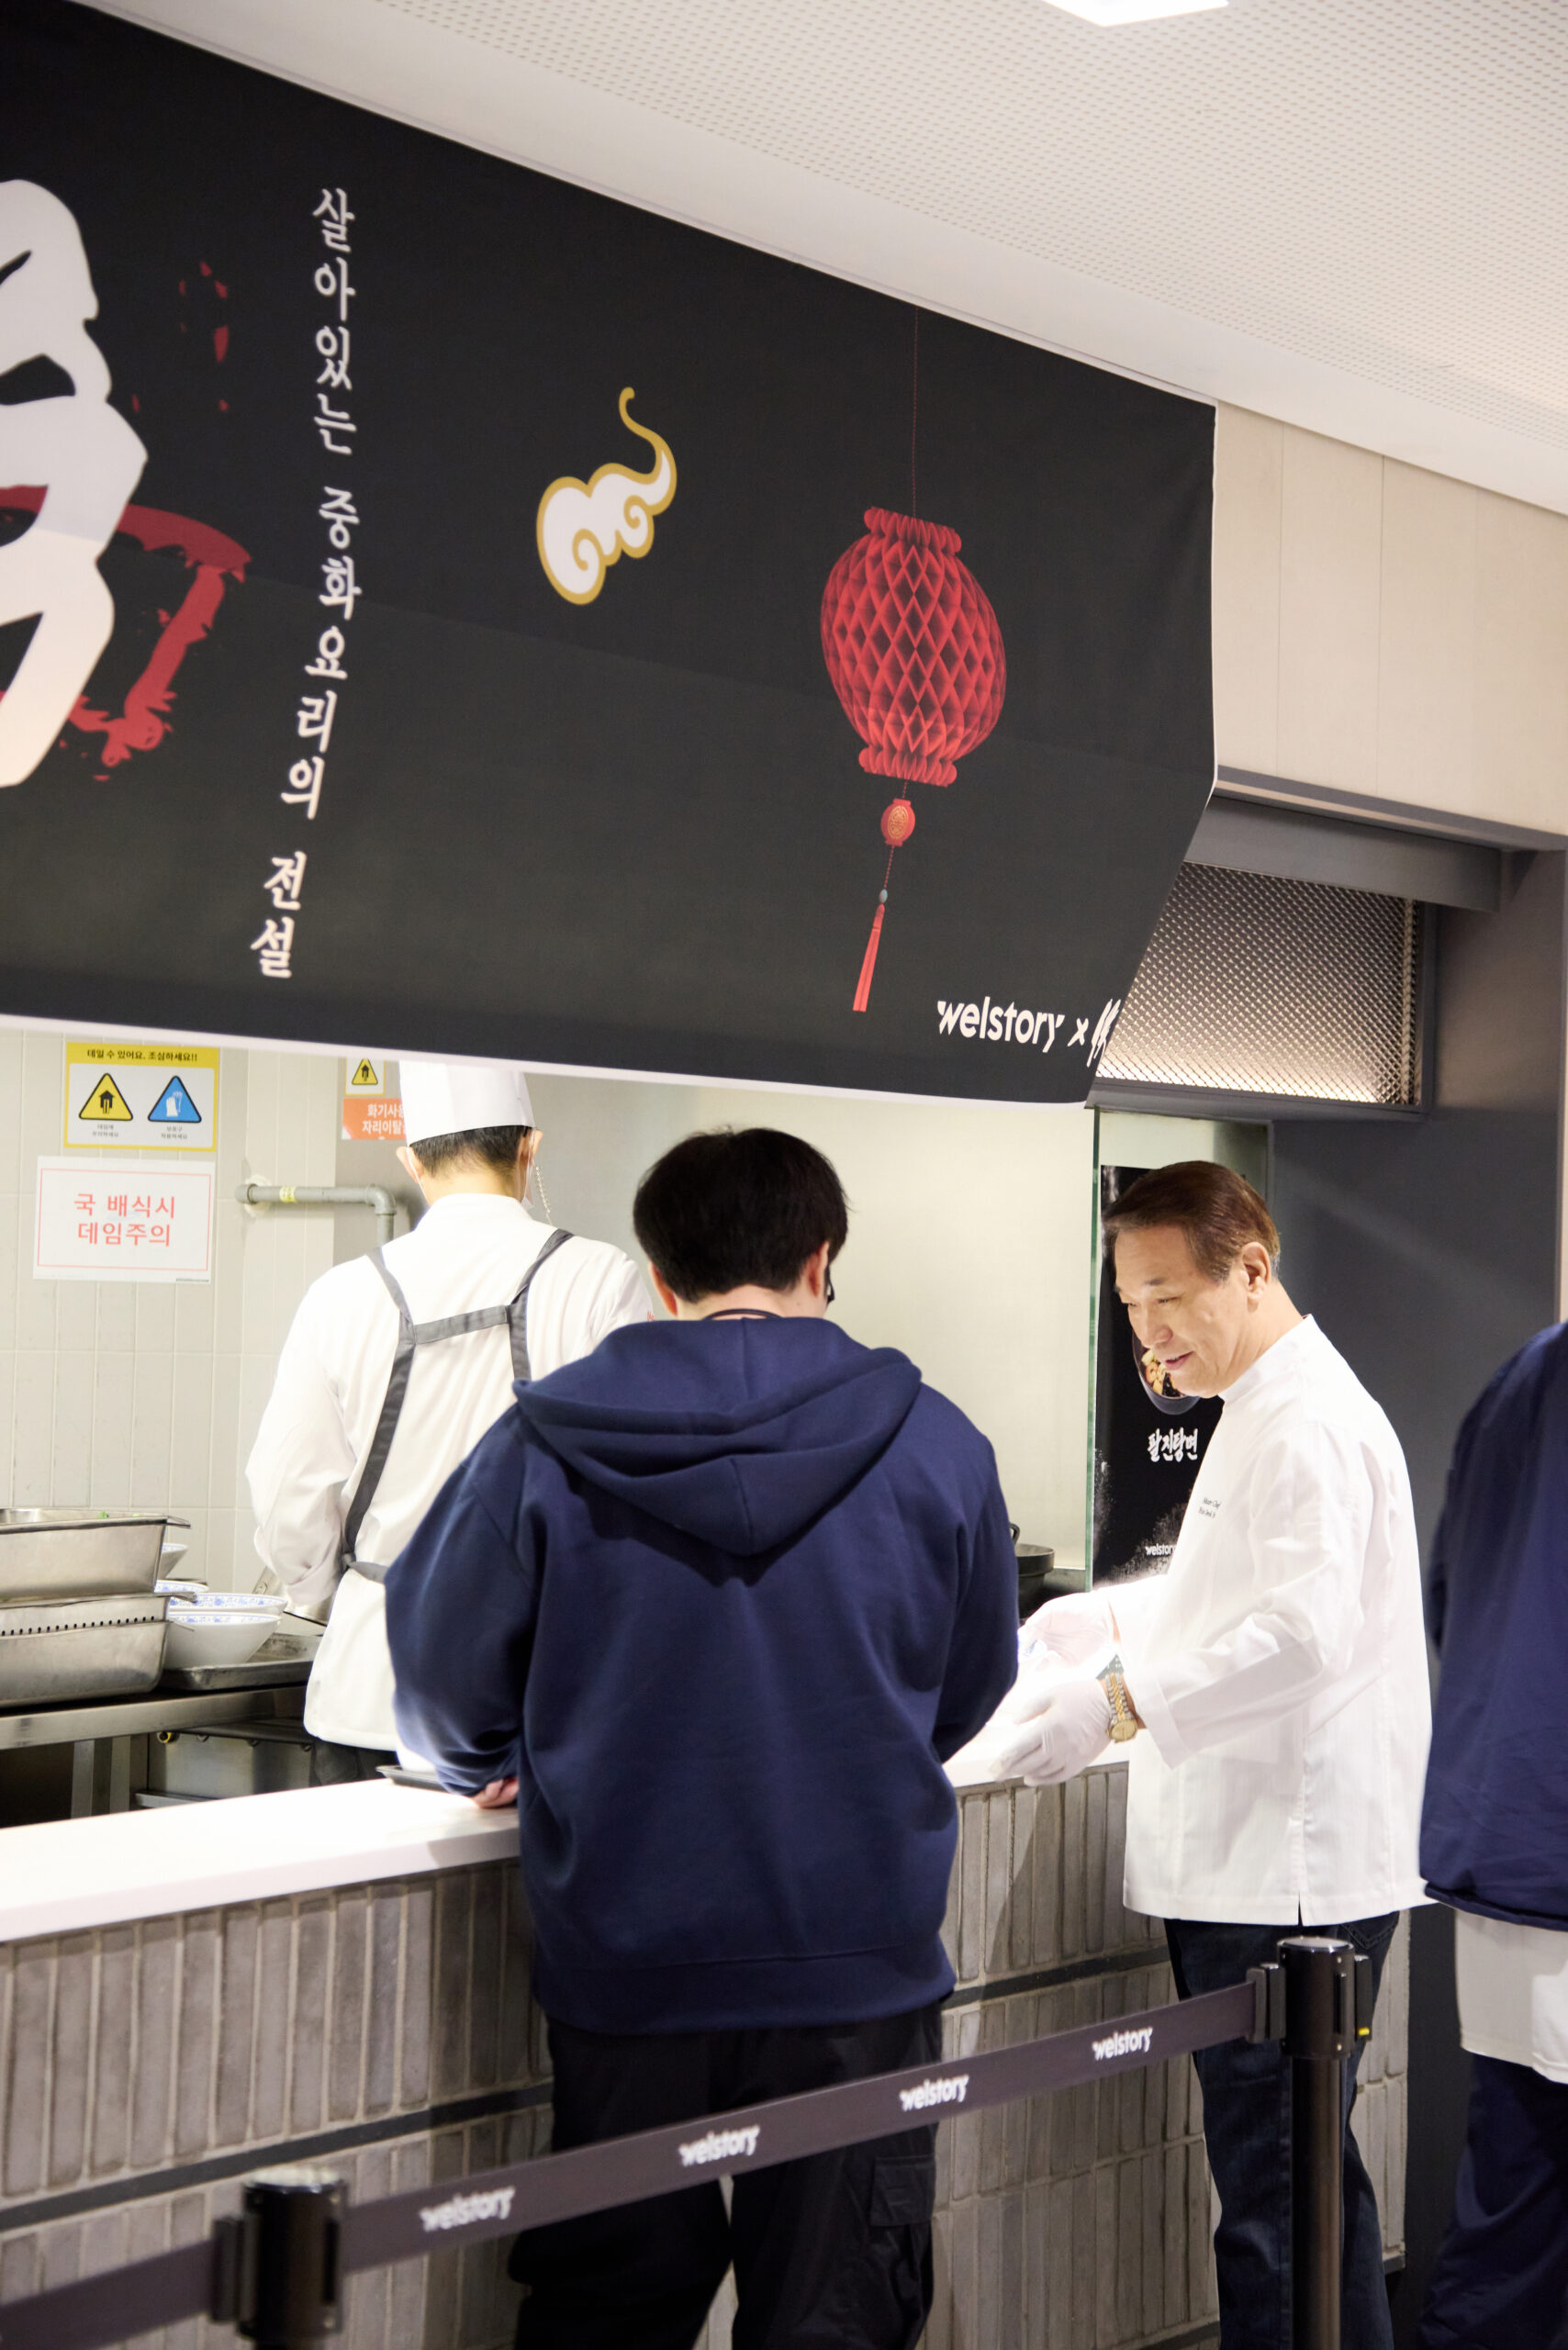
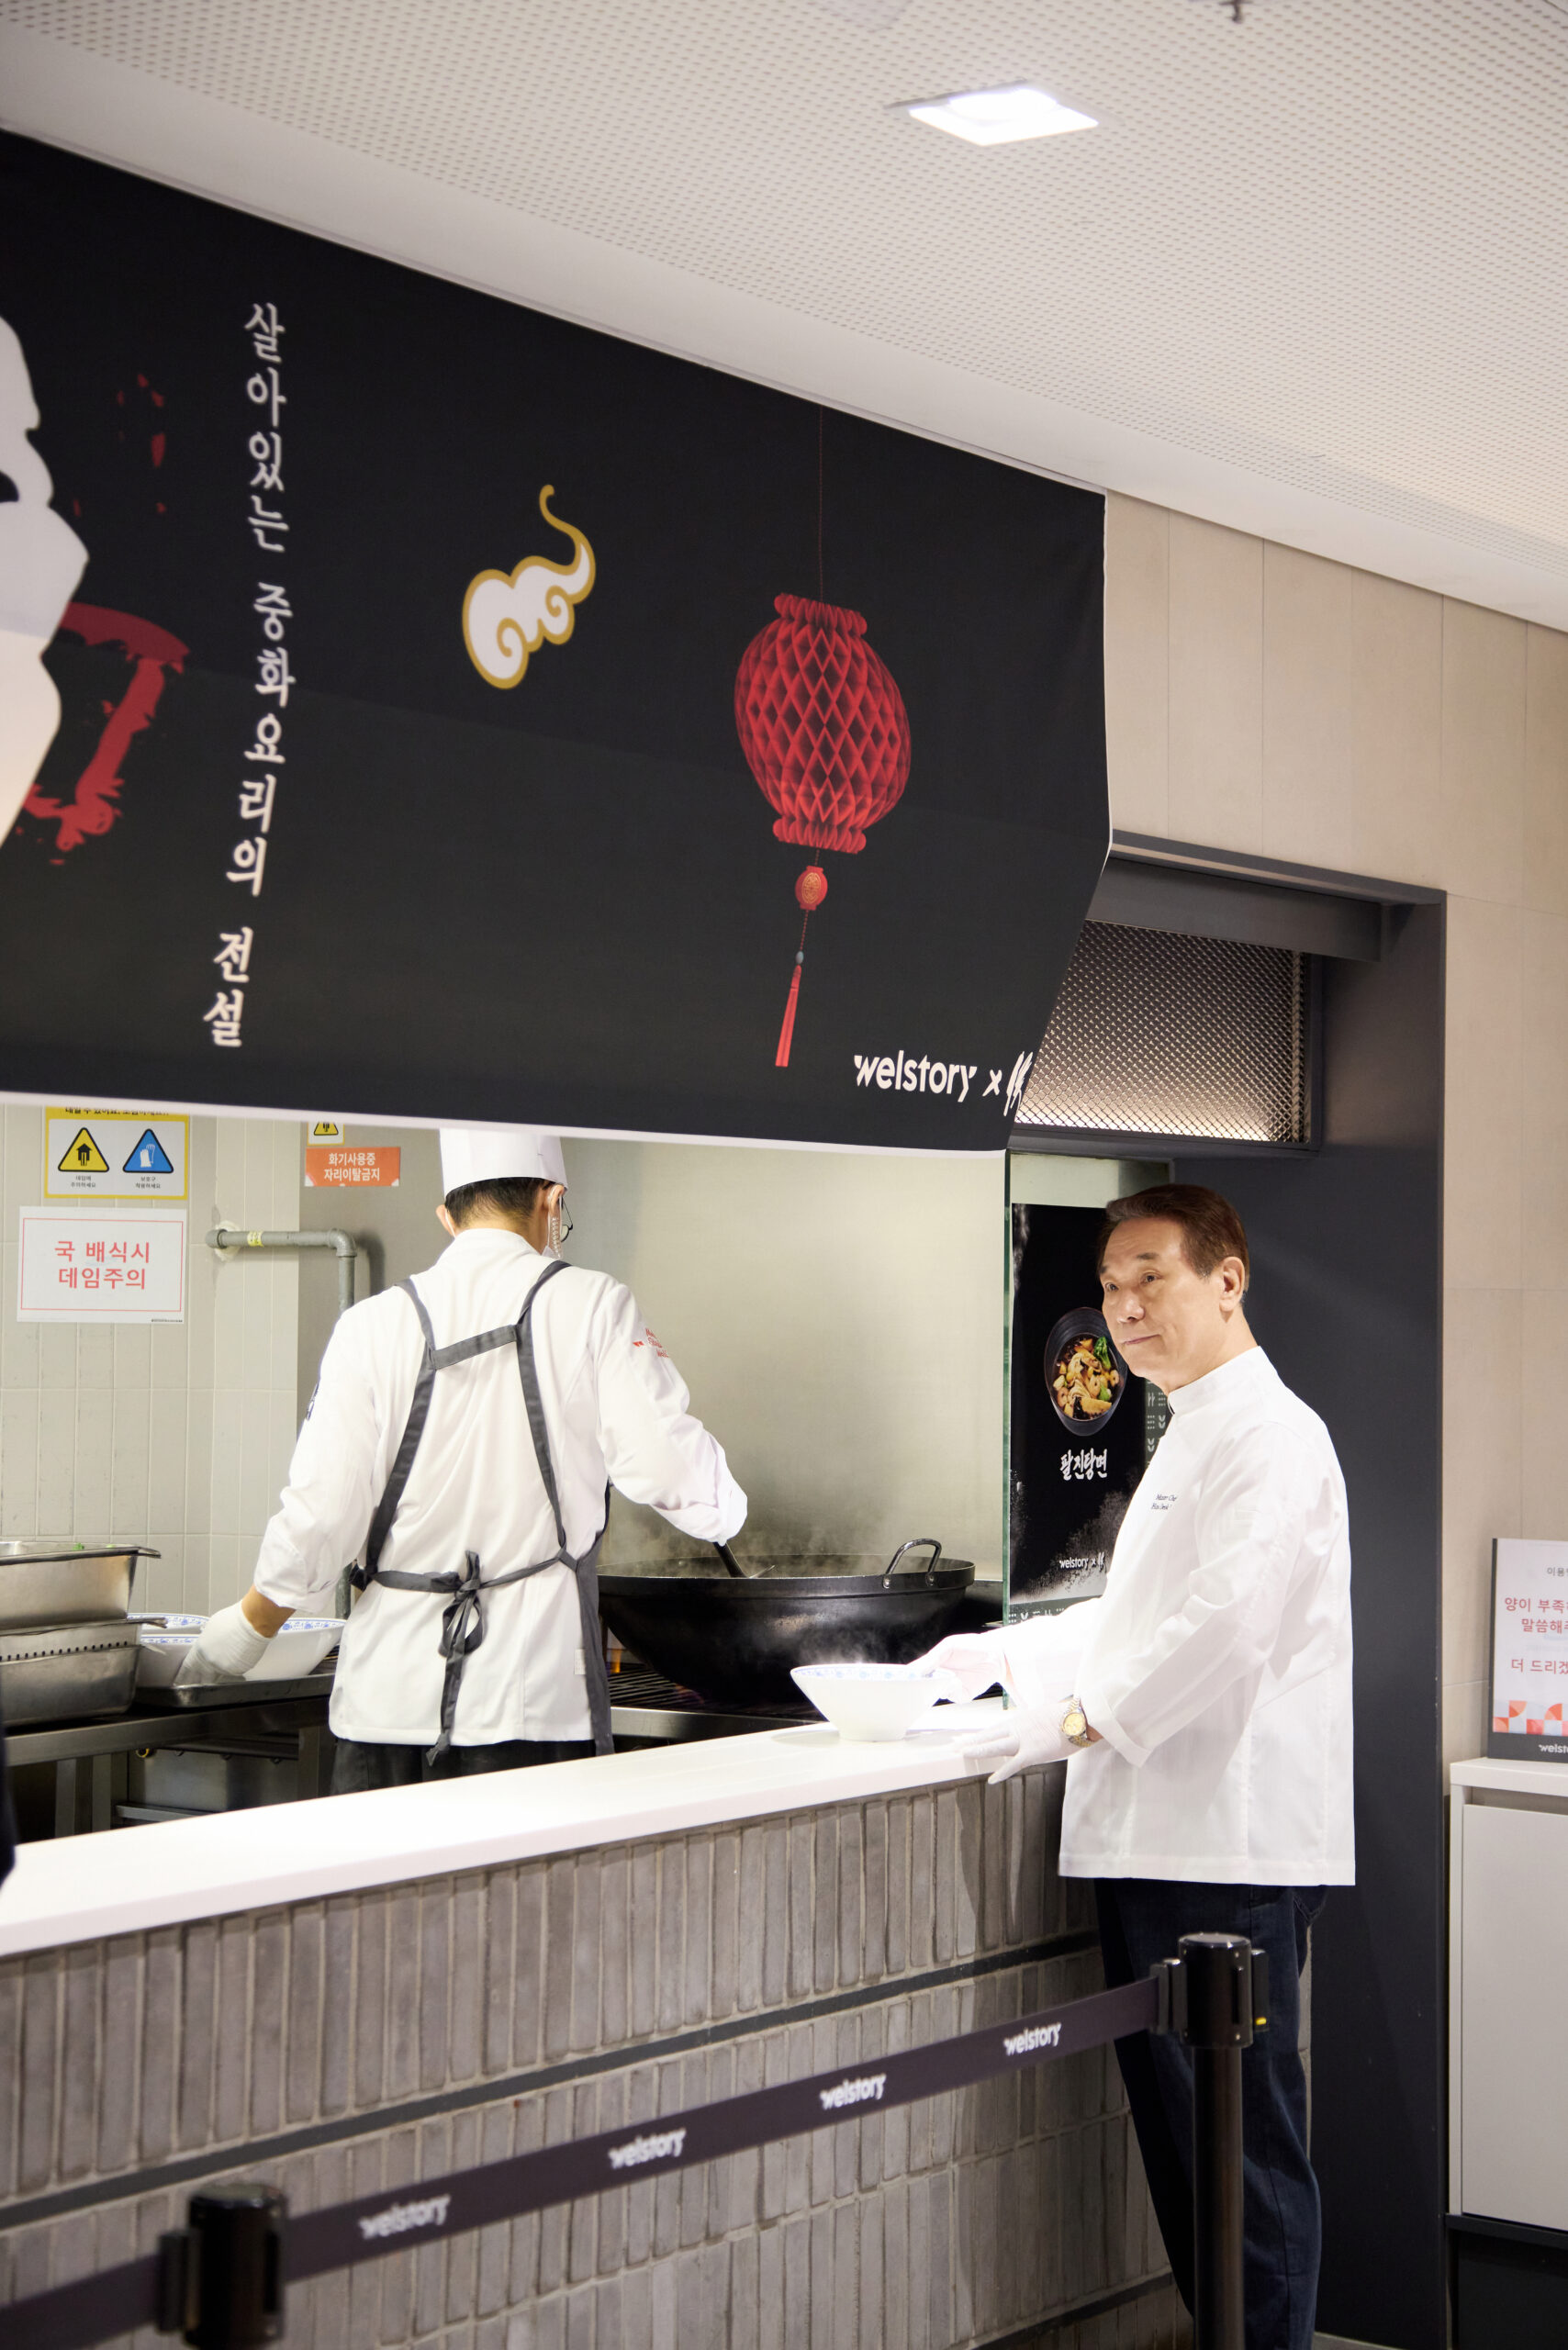
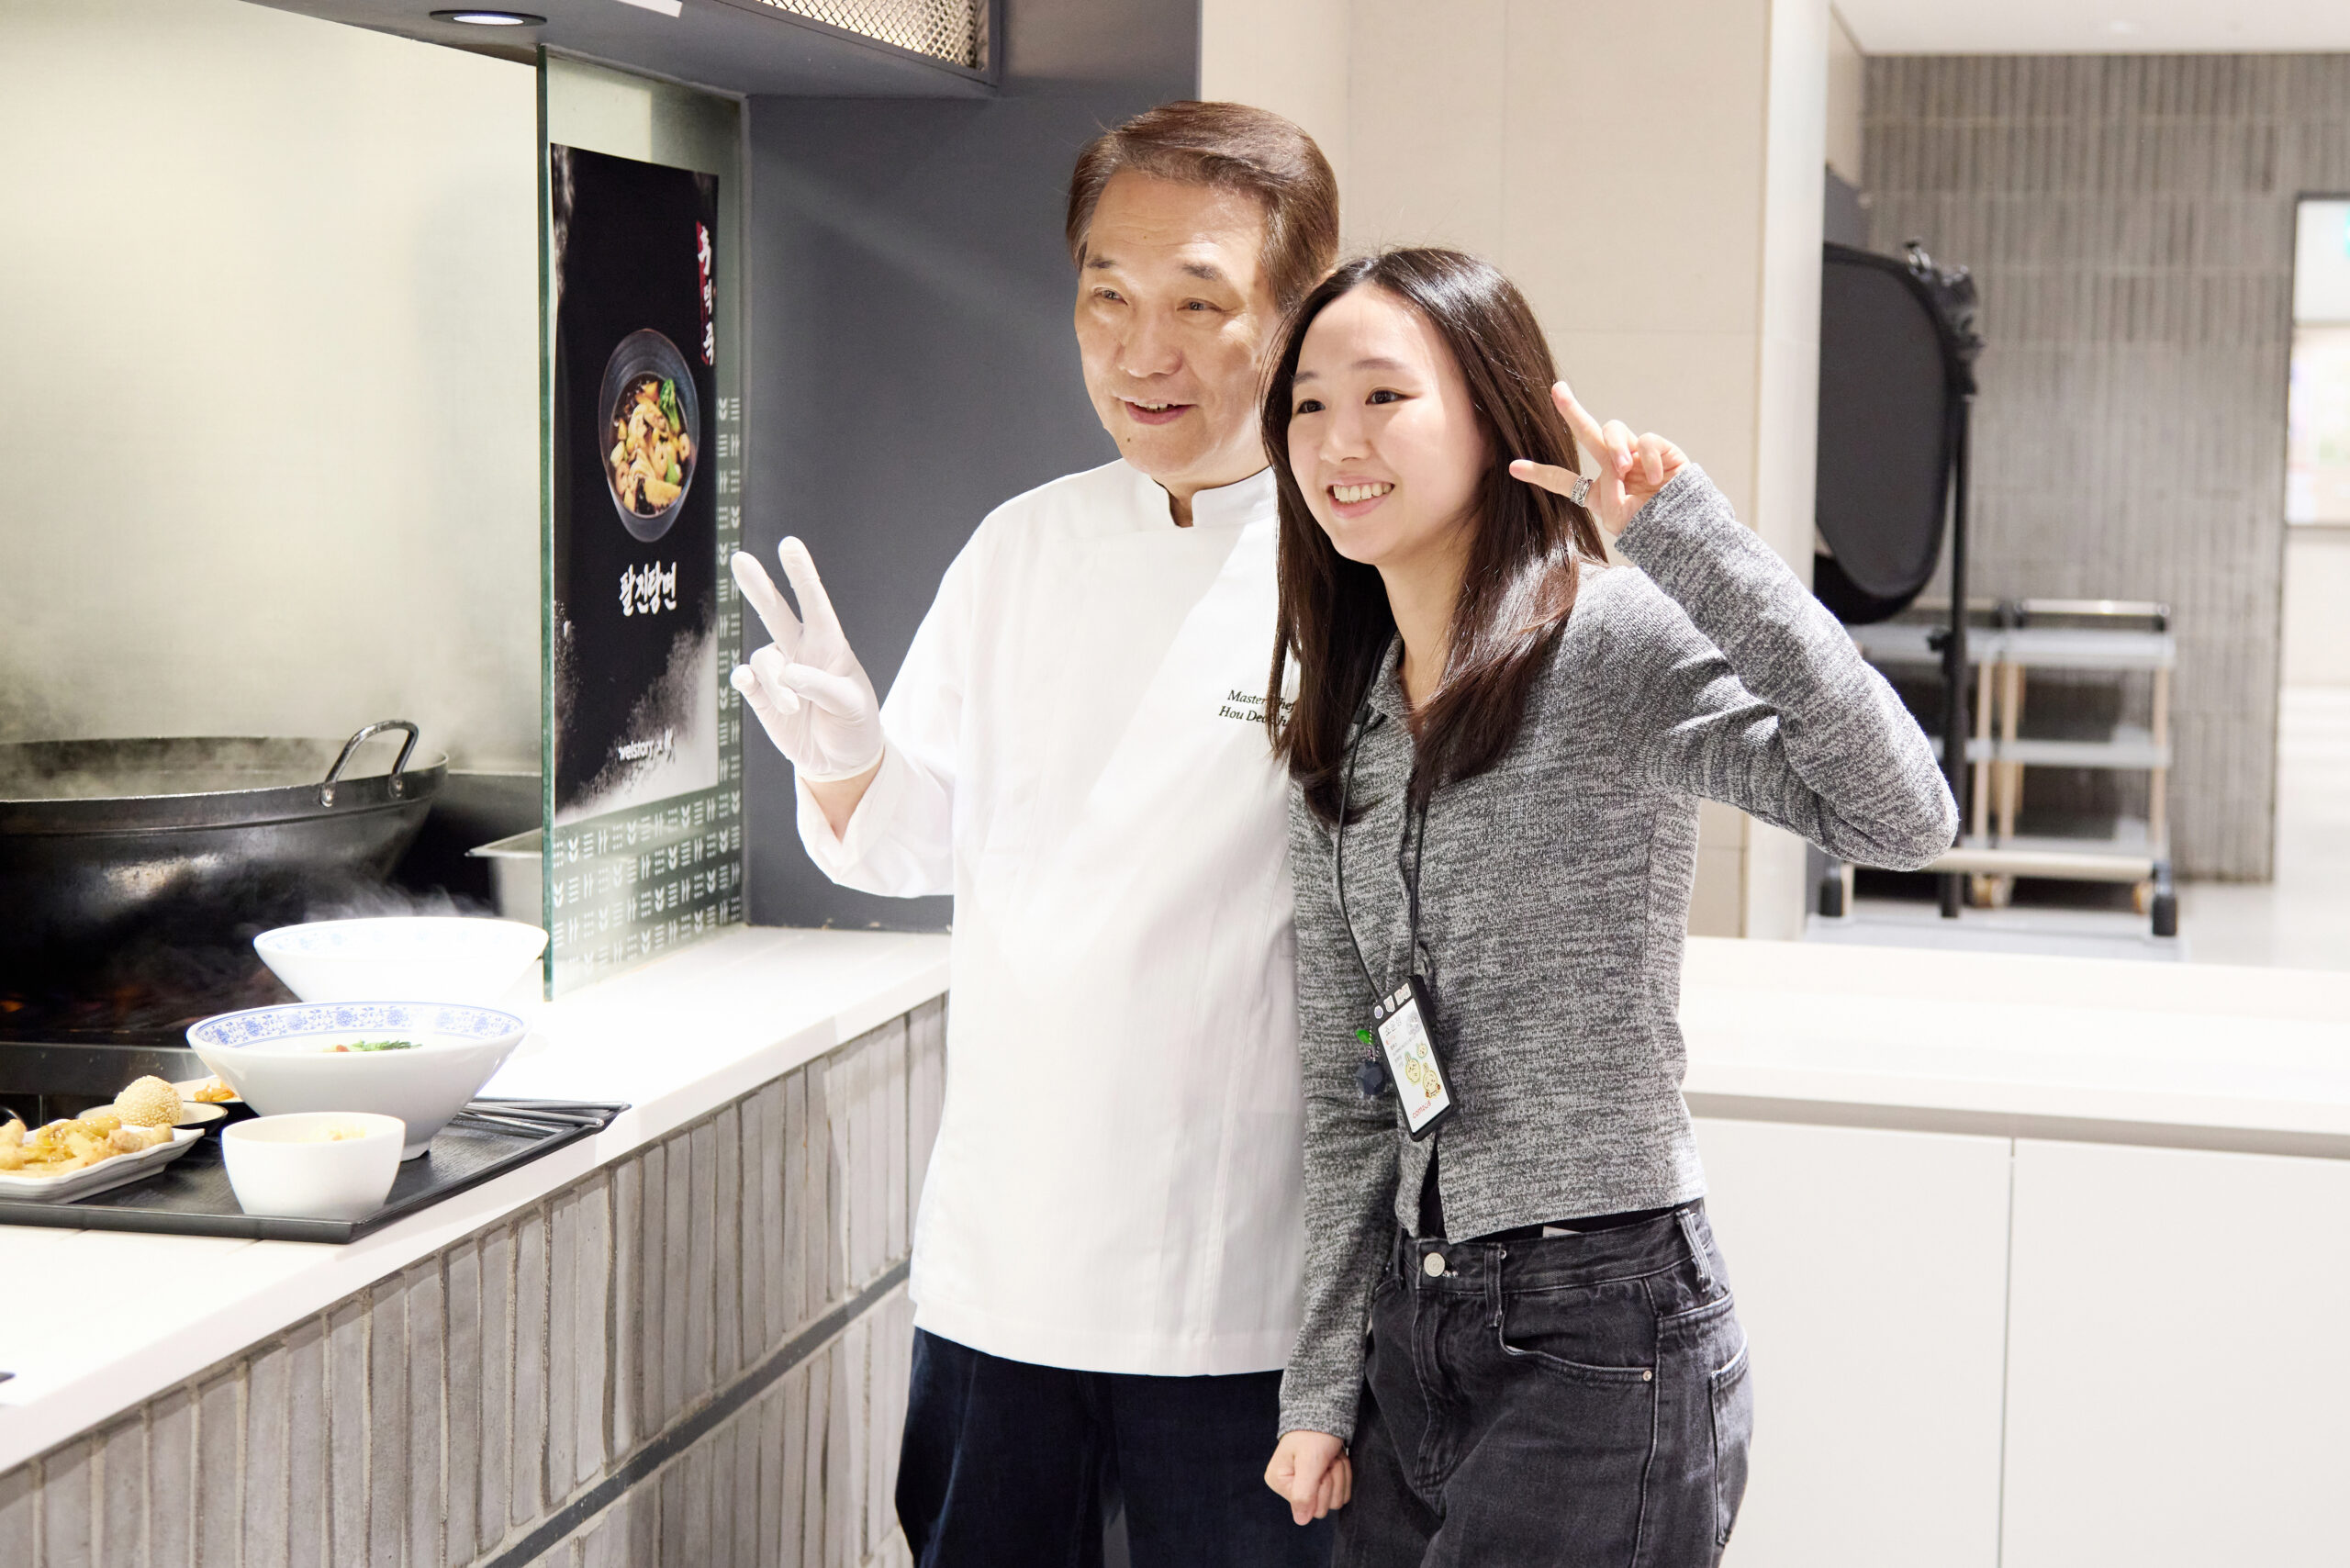
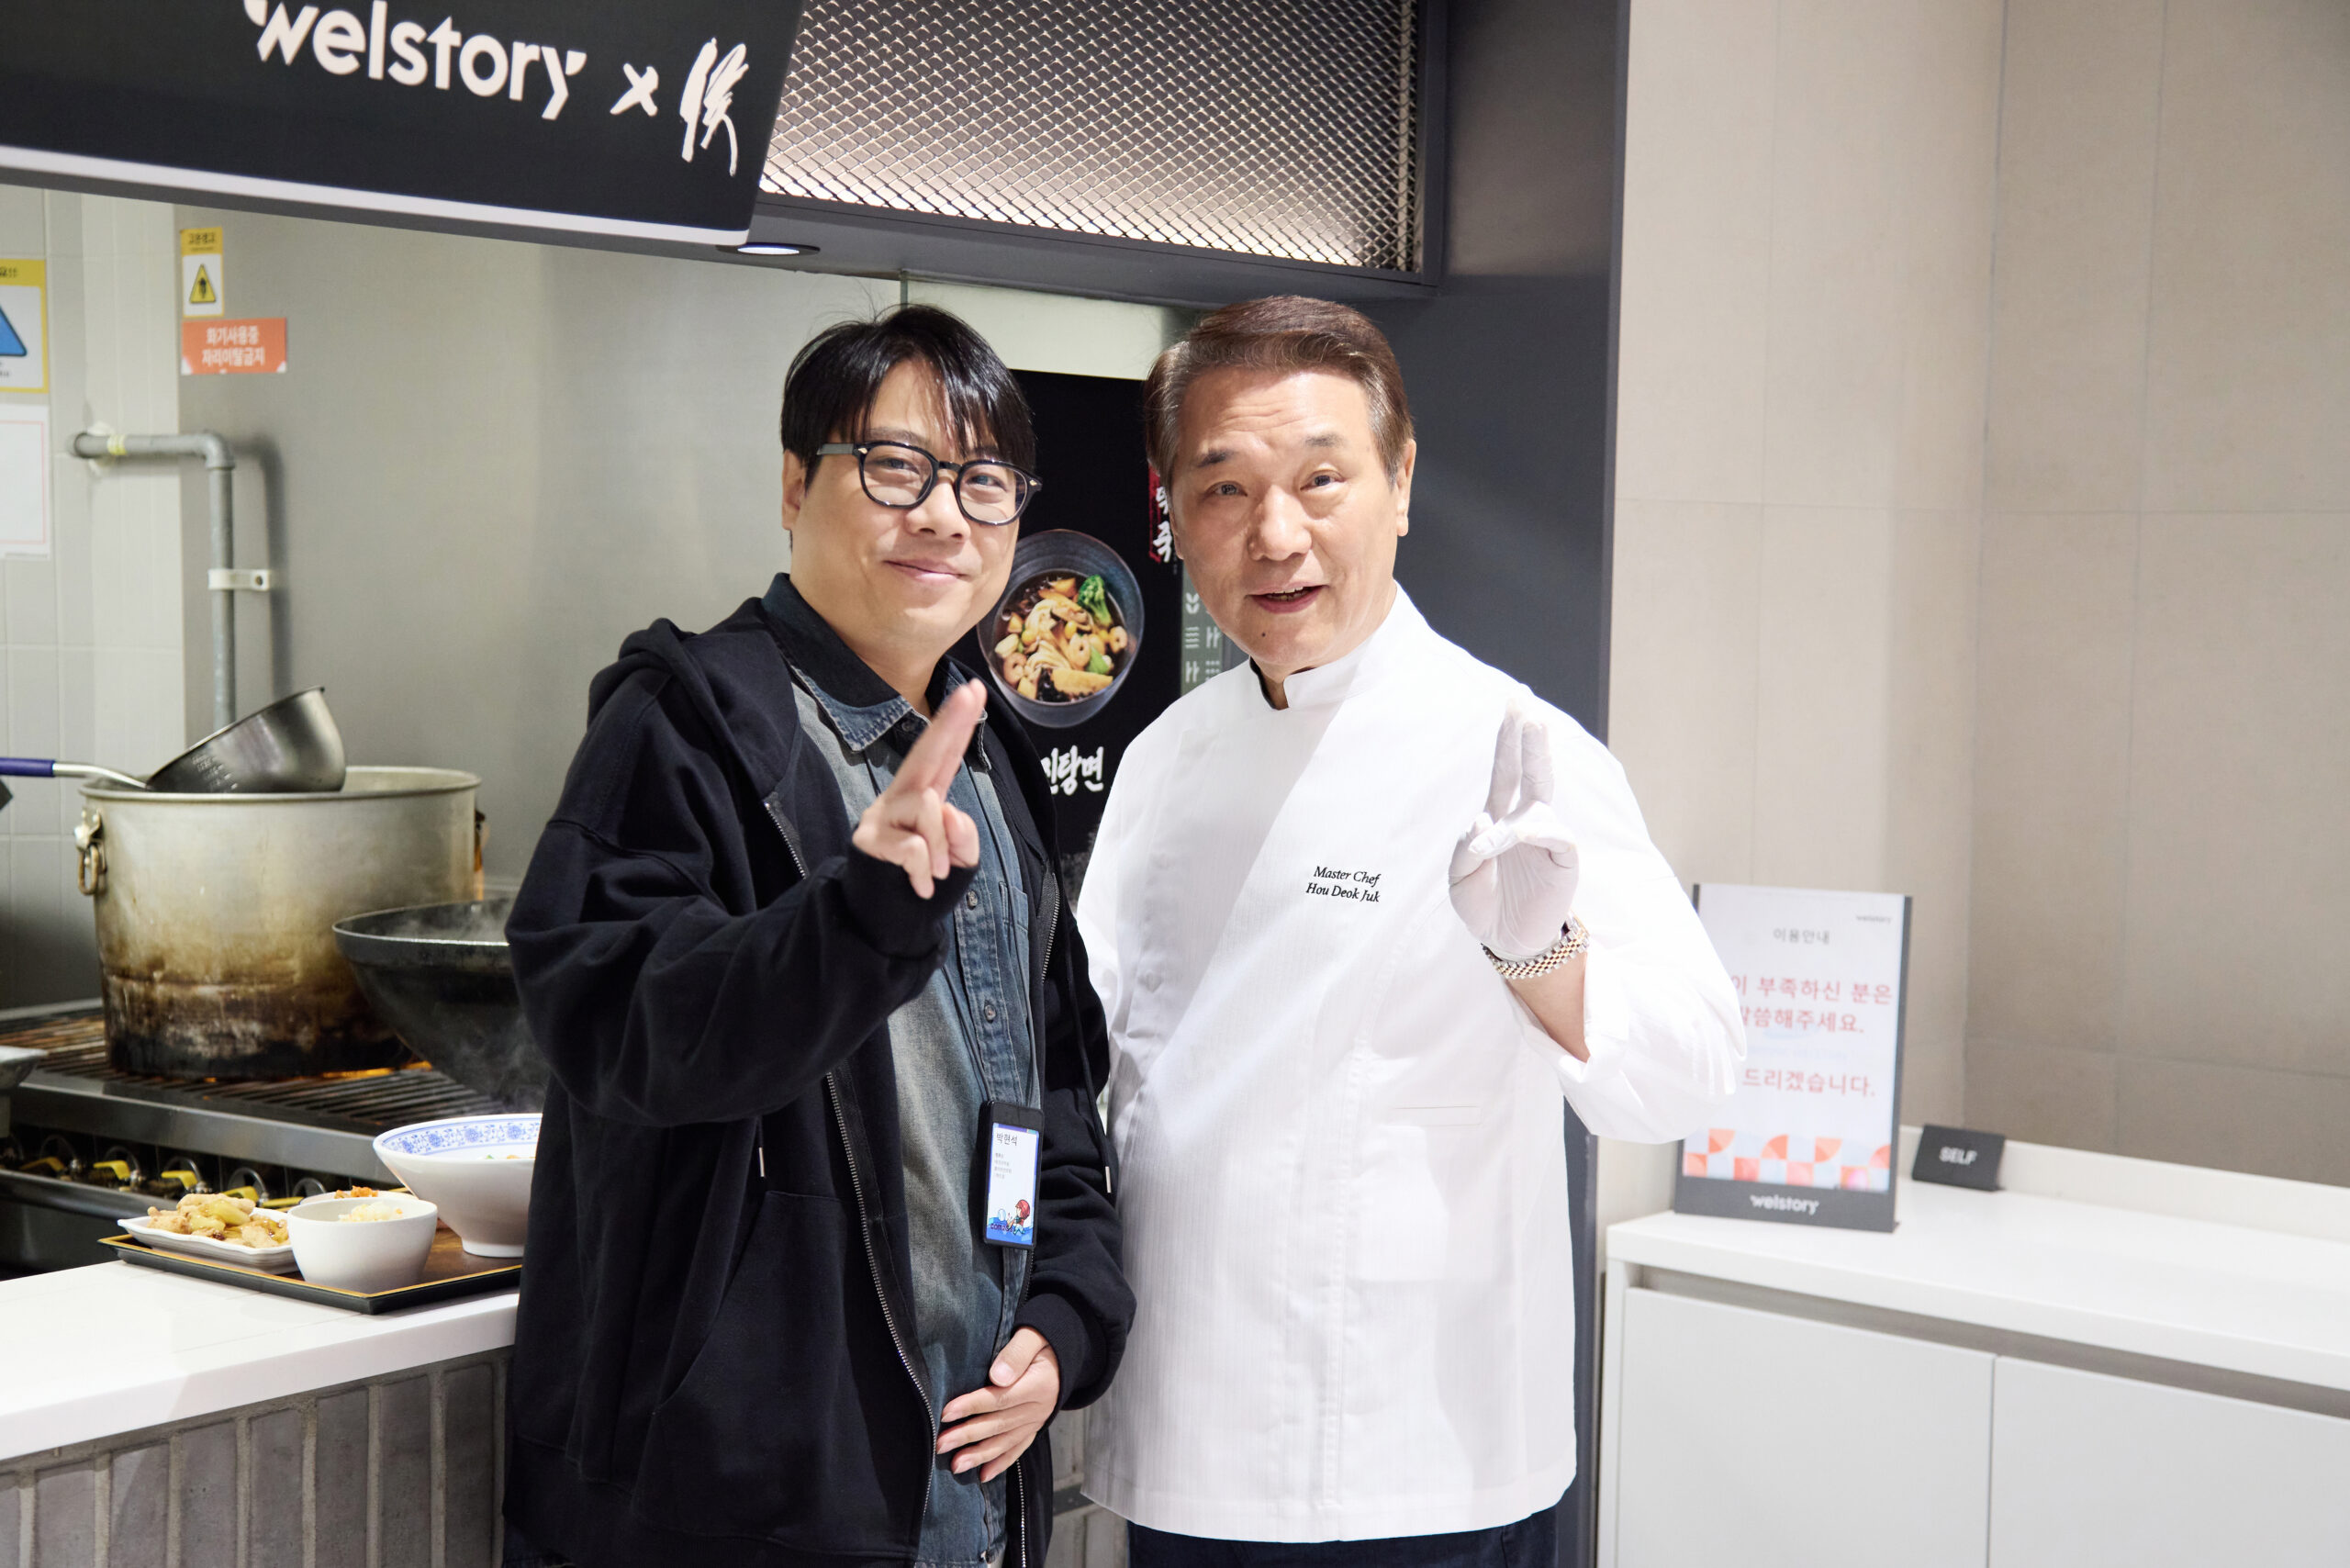
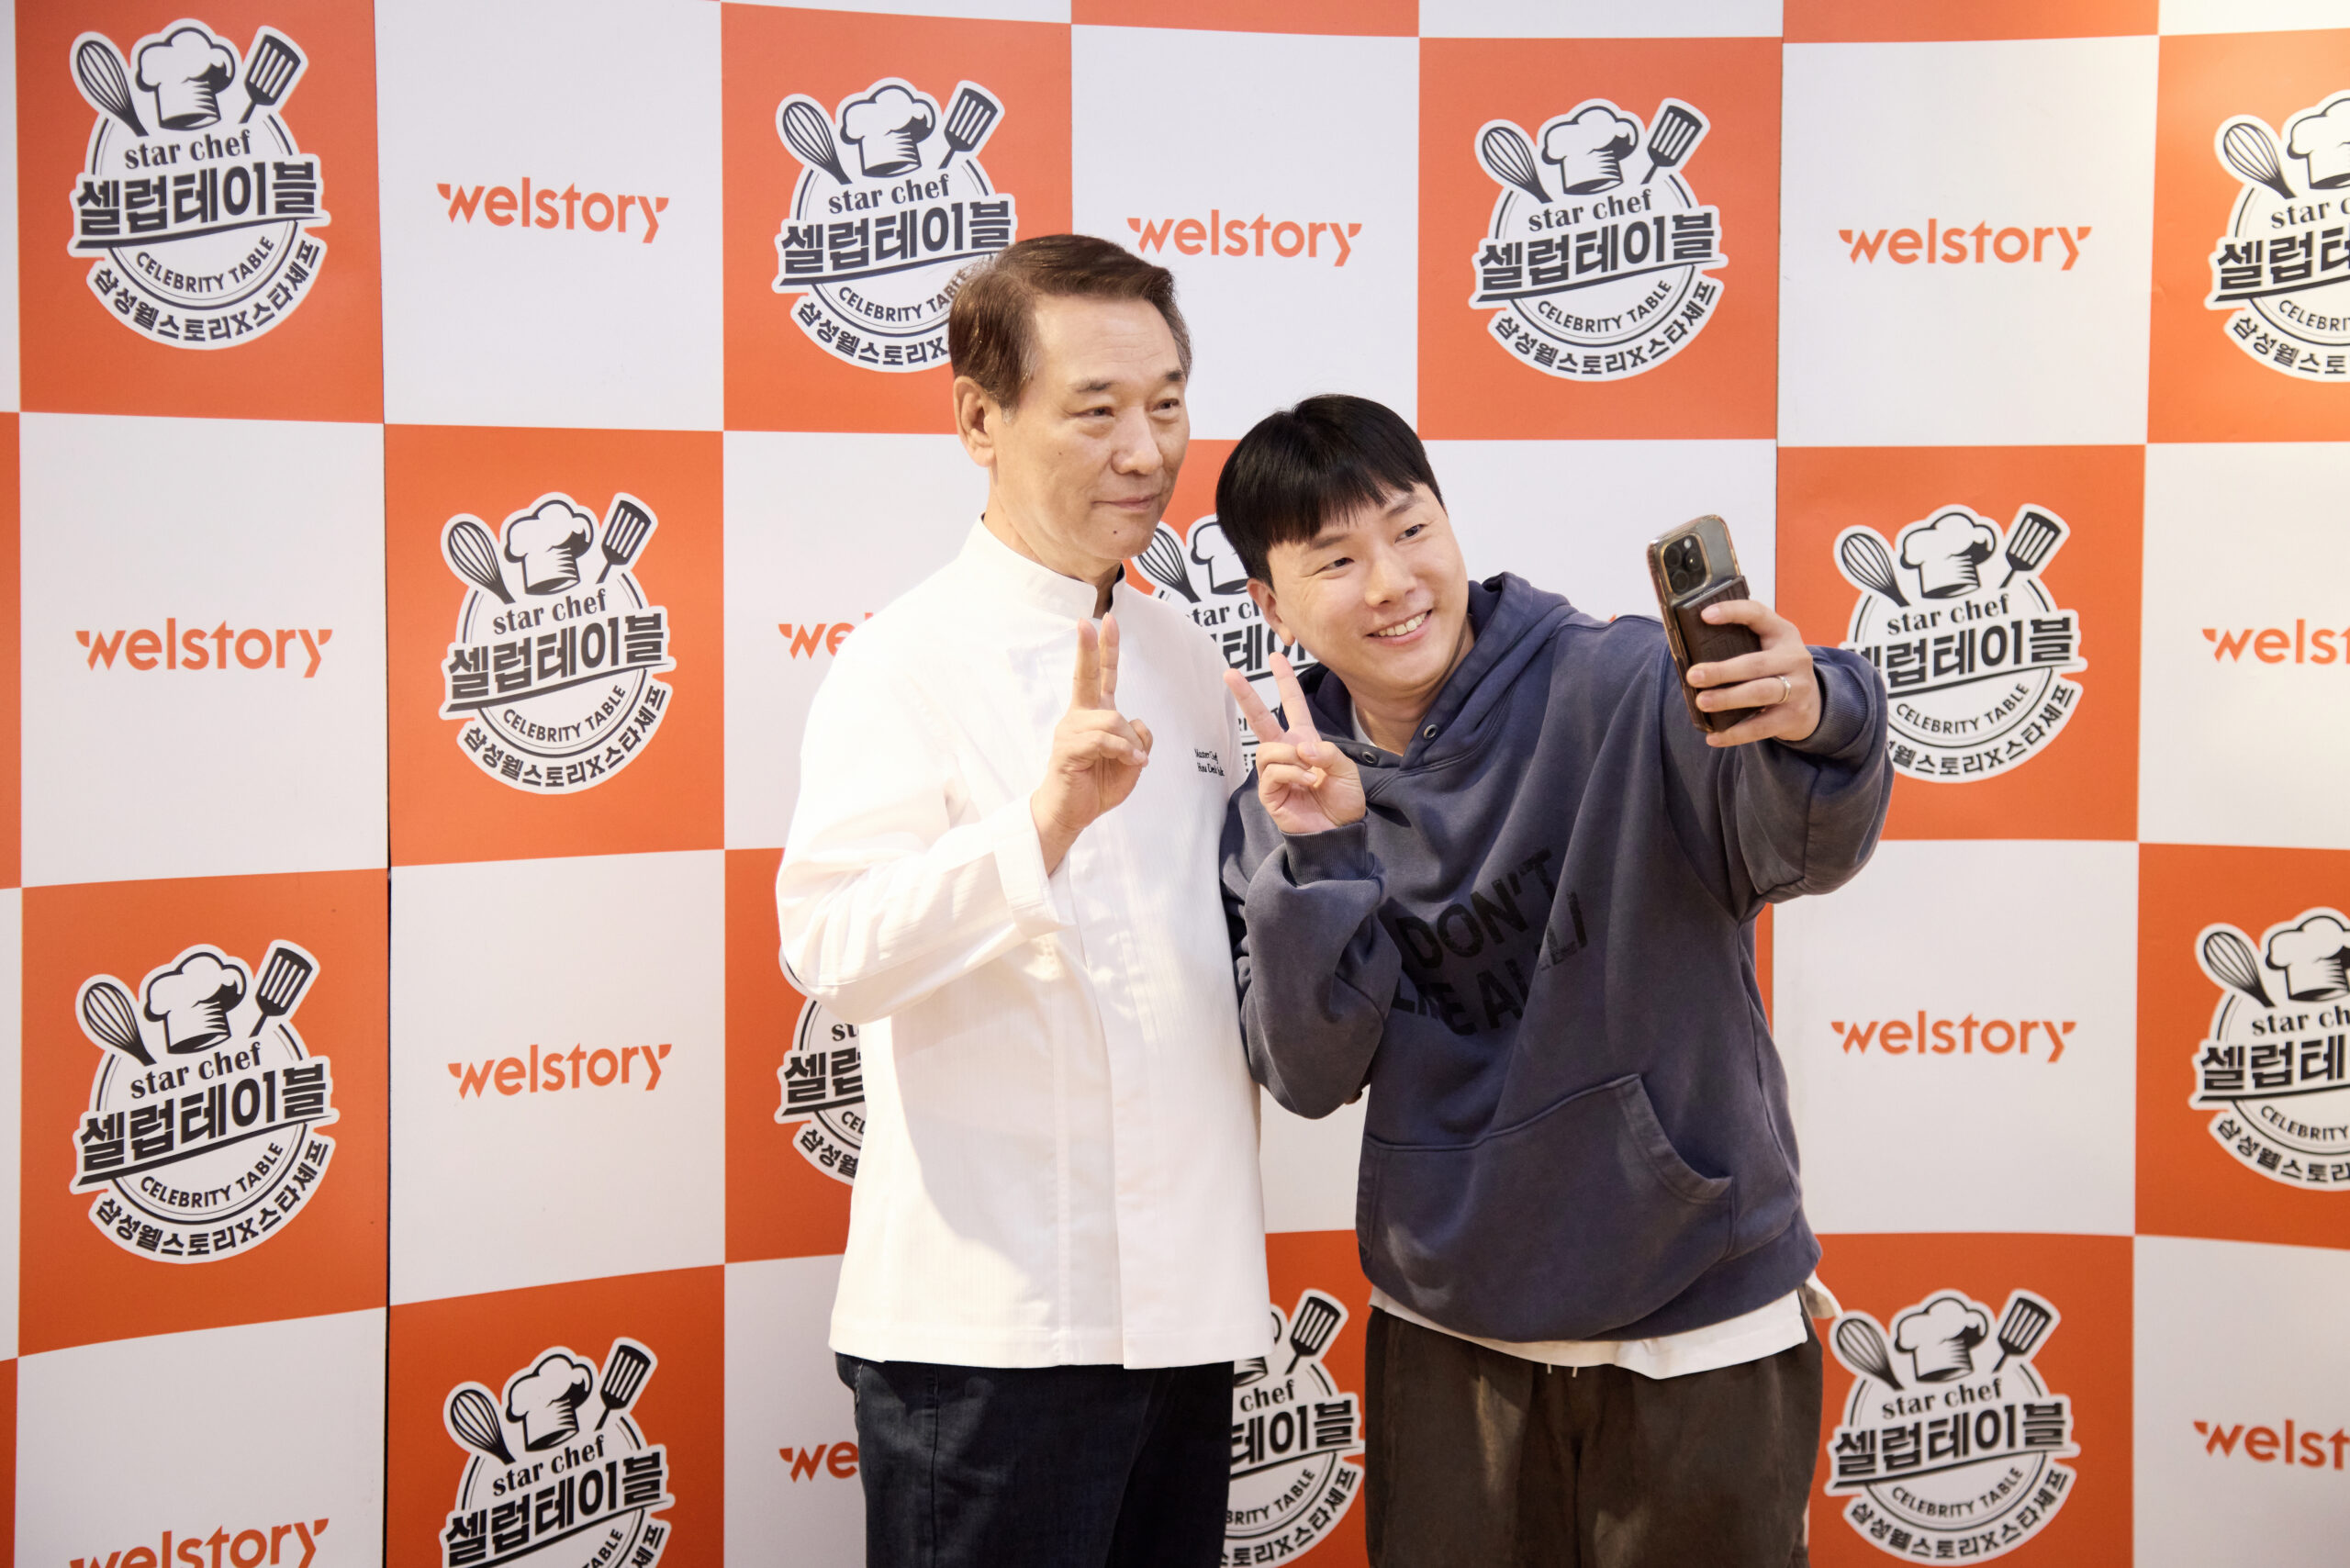
후덕죽 셰프는 배식대 앞에 서서 사우들을 직접 맞았다. 식판을 받아 든 사우들과 눈을 맞추며 인사를 건넸고, 사진 요청에도 흔쾌히 응했다.
 |  |
 |  |
 |  |
사우들의 한 줄 평
가장 반응이 좋았던 건 국물이었다. 맛있다는 이야기가 줄을 이었고, 탕면 국물에 밥까지 말아 먹었다는 사우도 적지 않았다.
“많은 분들이 맛있다고 해 주시고 밥까지 말아 드셨다는 피드백을 들으니 기분이 좋았어요.”
– 이영아 영양사 –
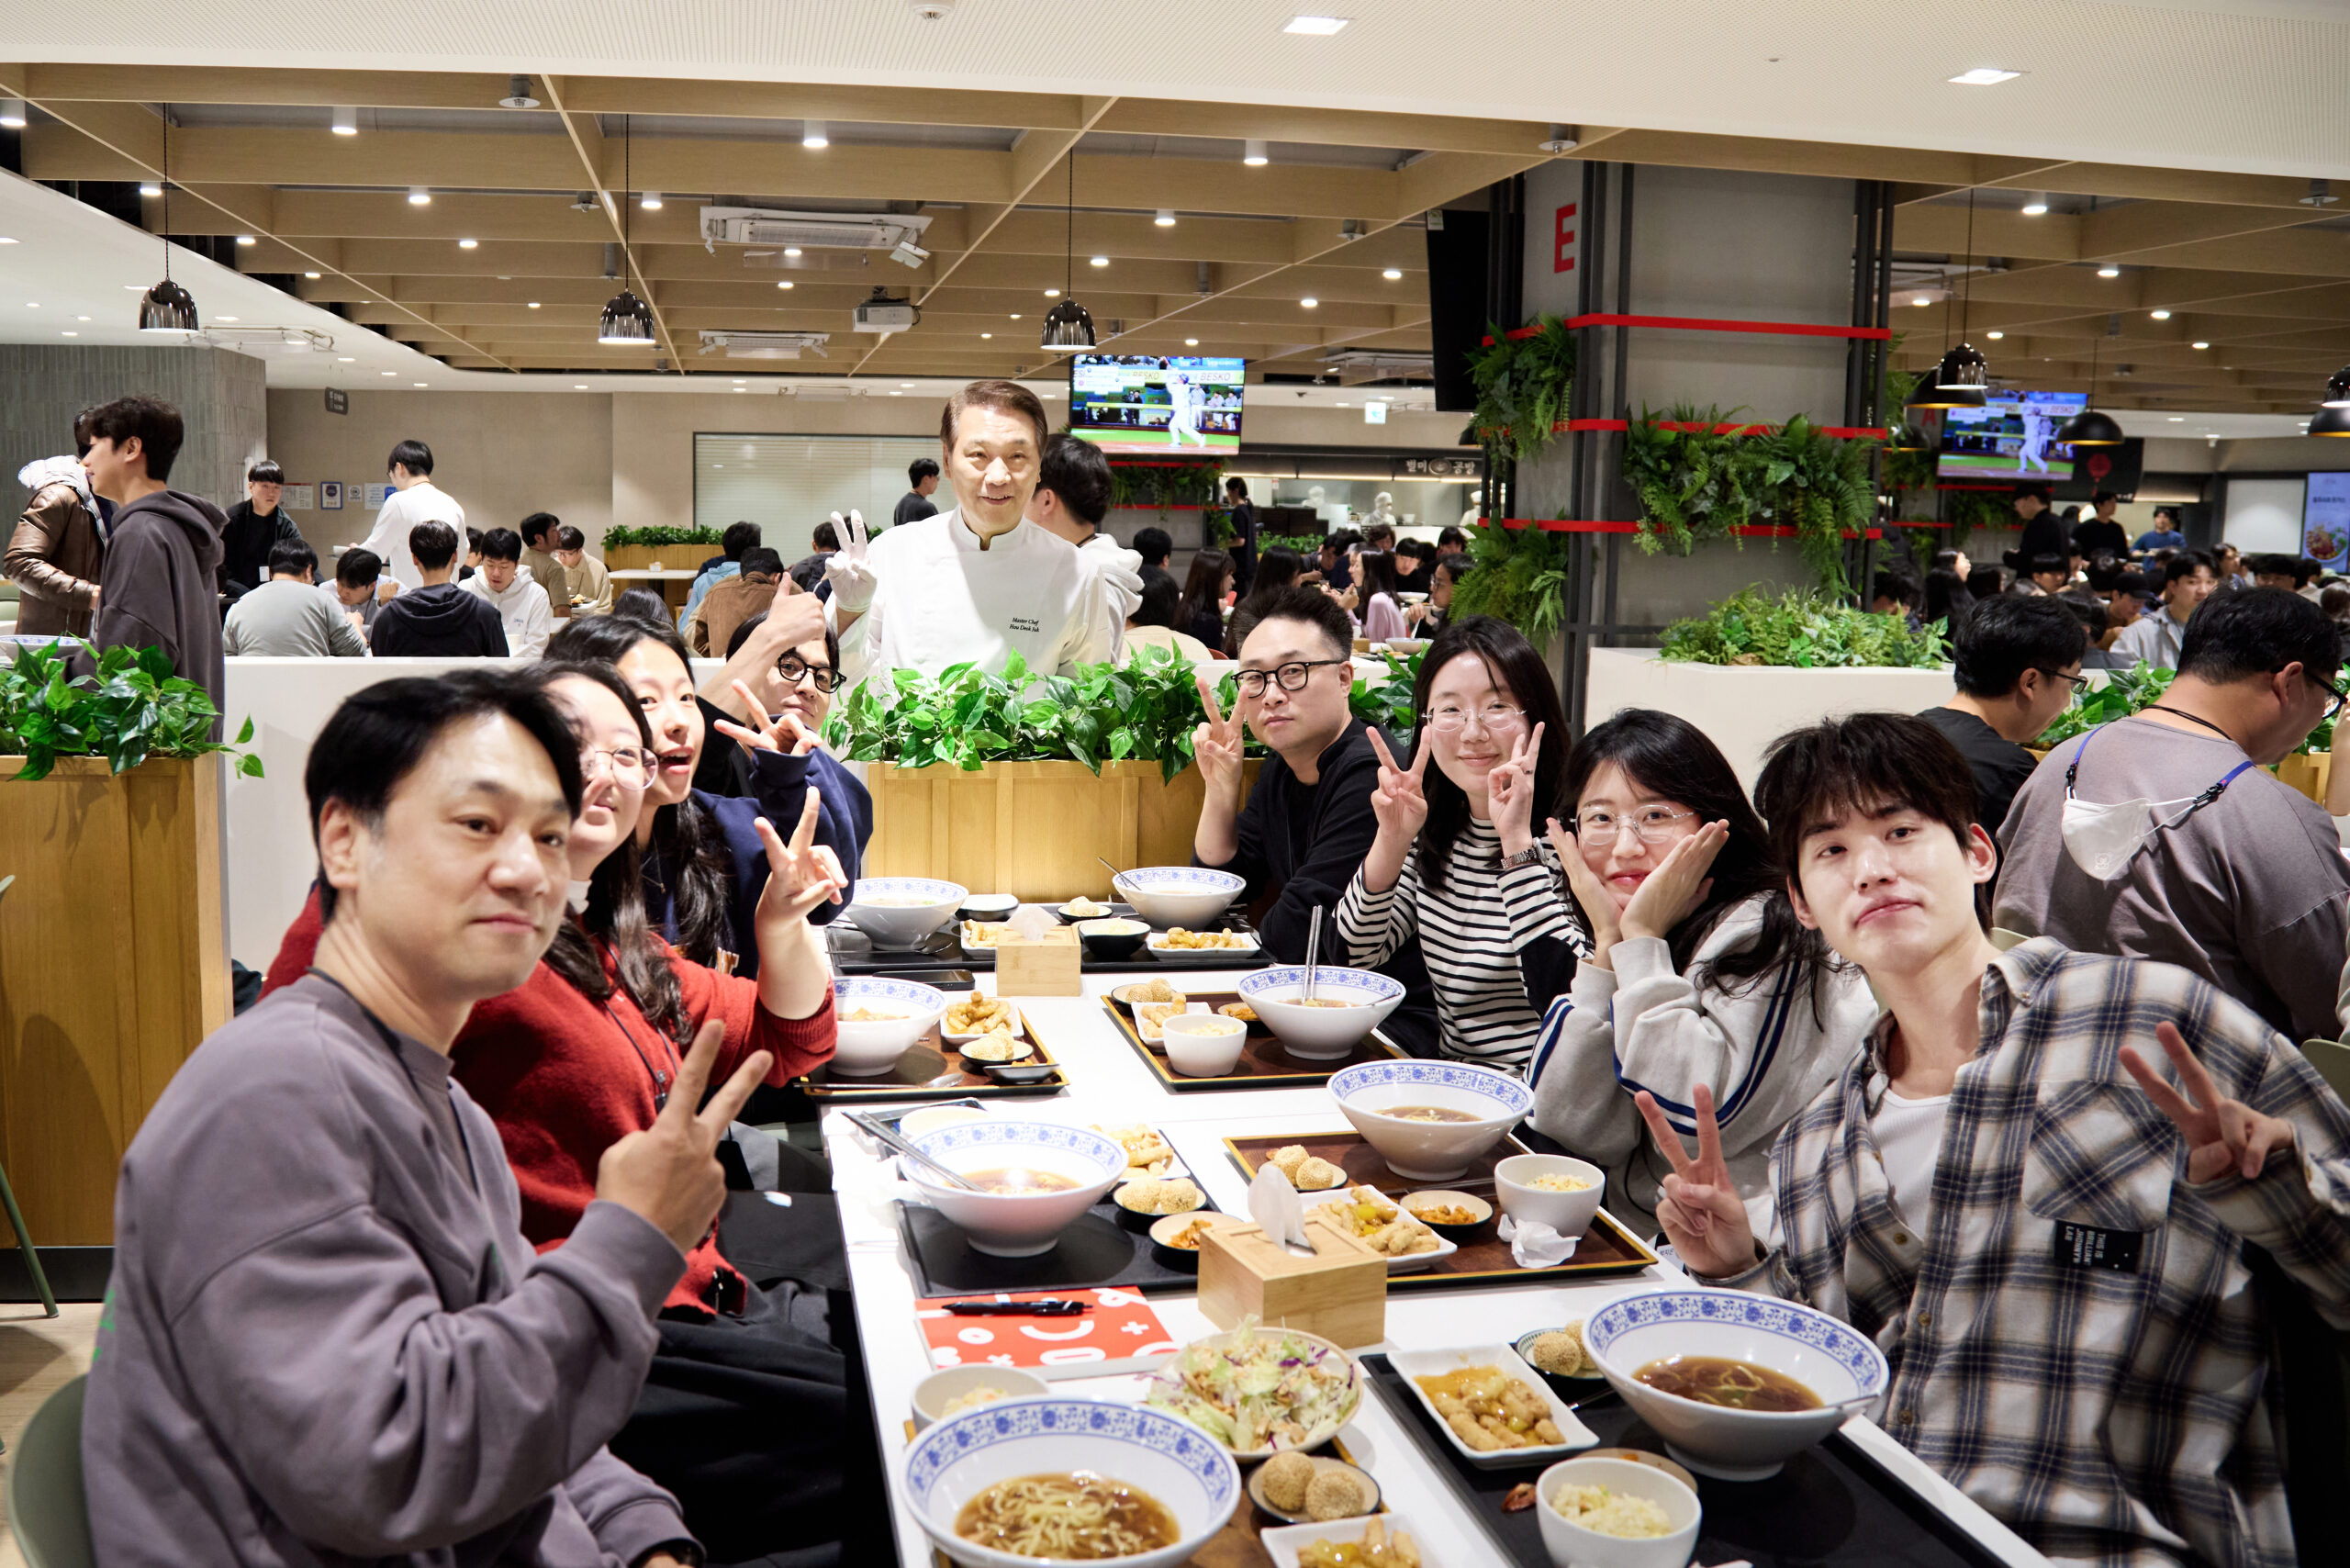
“다양한 해산물과 채소가 들어가 보기부터 먹음직스러웠고, 풍부한 국물 맛이 정말 인상적이었어요. 오랜 내공이 느껴지는 셰프님의 요리를 직접 맛볼 수 있어 특별하고 감사한 시간이었습니다. 깨 범벅 찹쌀팥떡은 몇 개 더 가져가서 간식으로 먹고 싶더라고요!”
“셰프님의 레시피로 맨들어 주신 팔진탕면, 참 맛이가 있었습니다(셰프님 말투 따라 해 보기). 멋진 문장을 생각해 내고 싶었지만 ‘맛있었다’밖에 떠오르지 않는 내 문장 구사력…”
“오랜만에 마음까지 따뜻해지는 맛이었습니다. 버섯과 죽순의 짭조름한 맛이 일품이었고, 면과도 잘 어우러졌어요. 지마구는 처음 먹어 보는 것 같은데 튀긴 완자 같고 맛있었어요.”
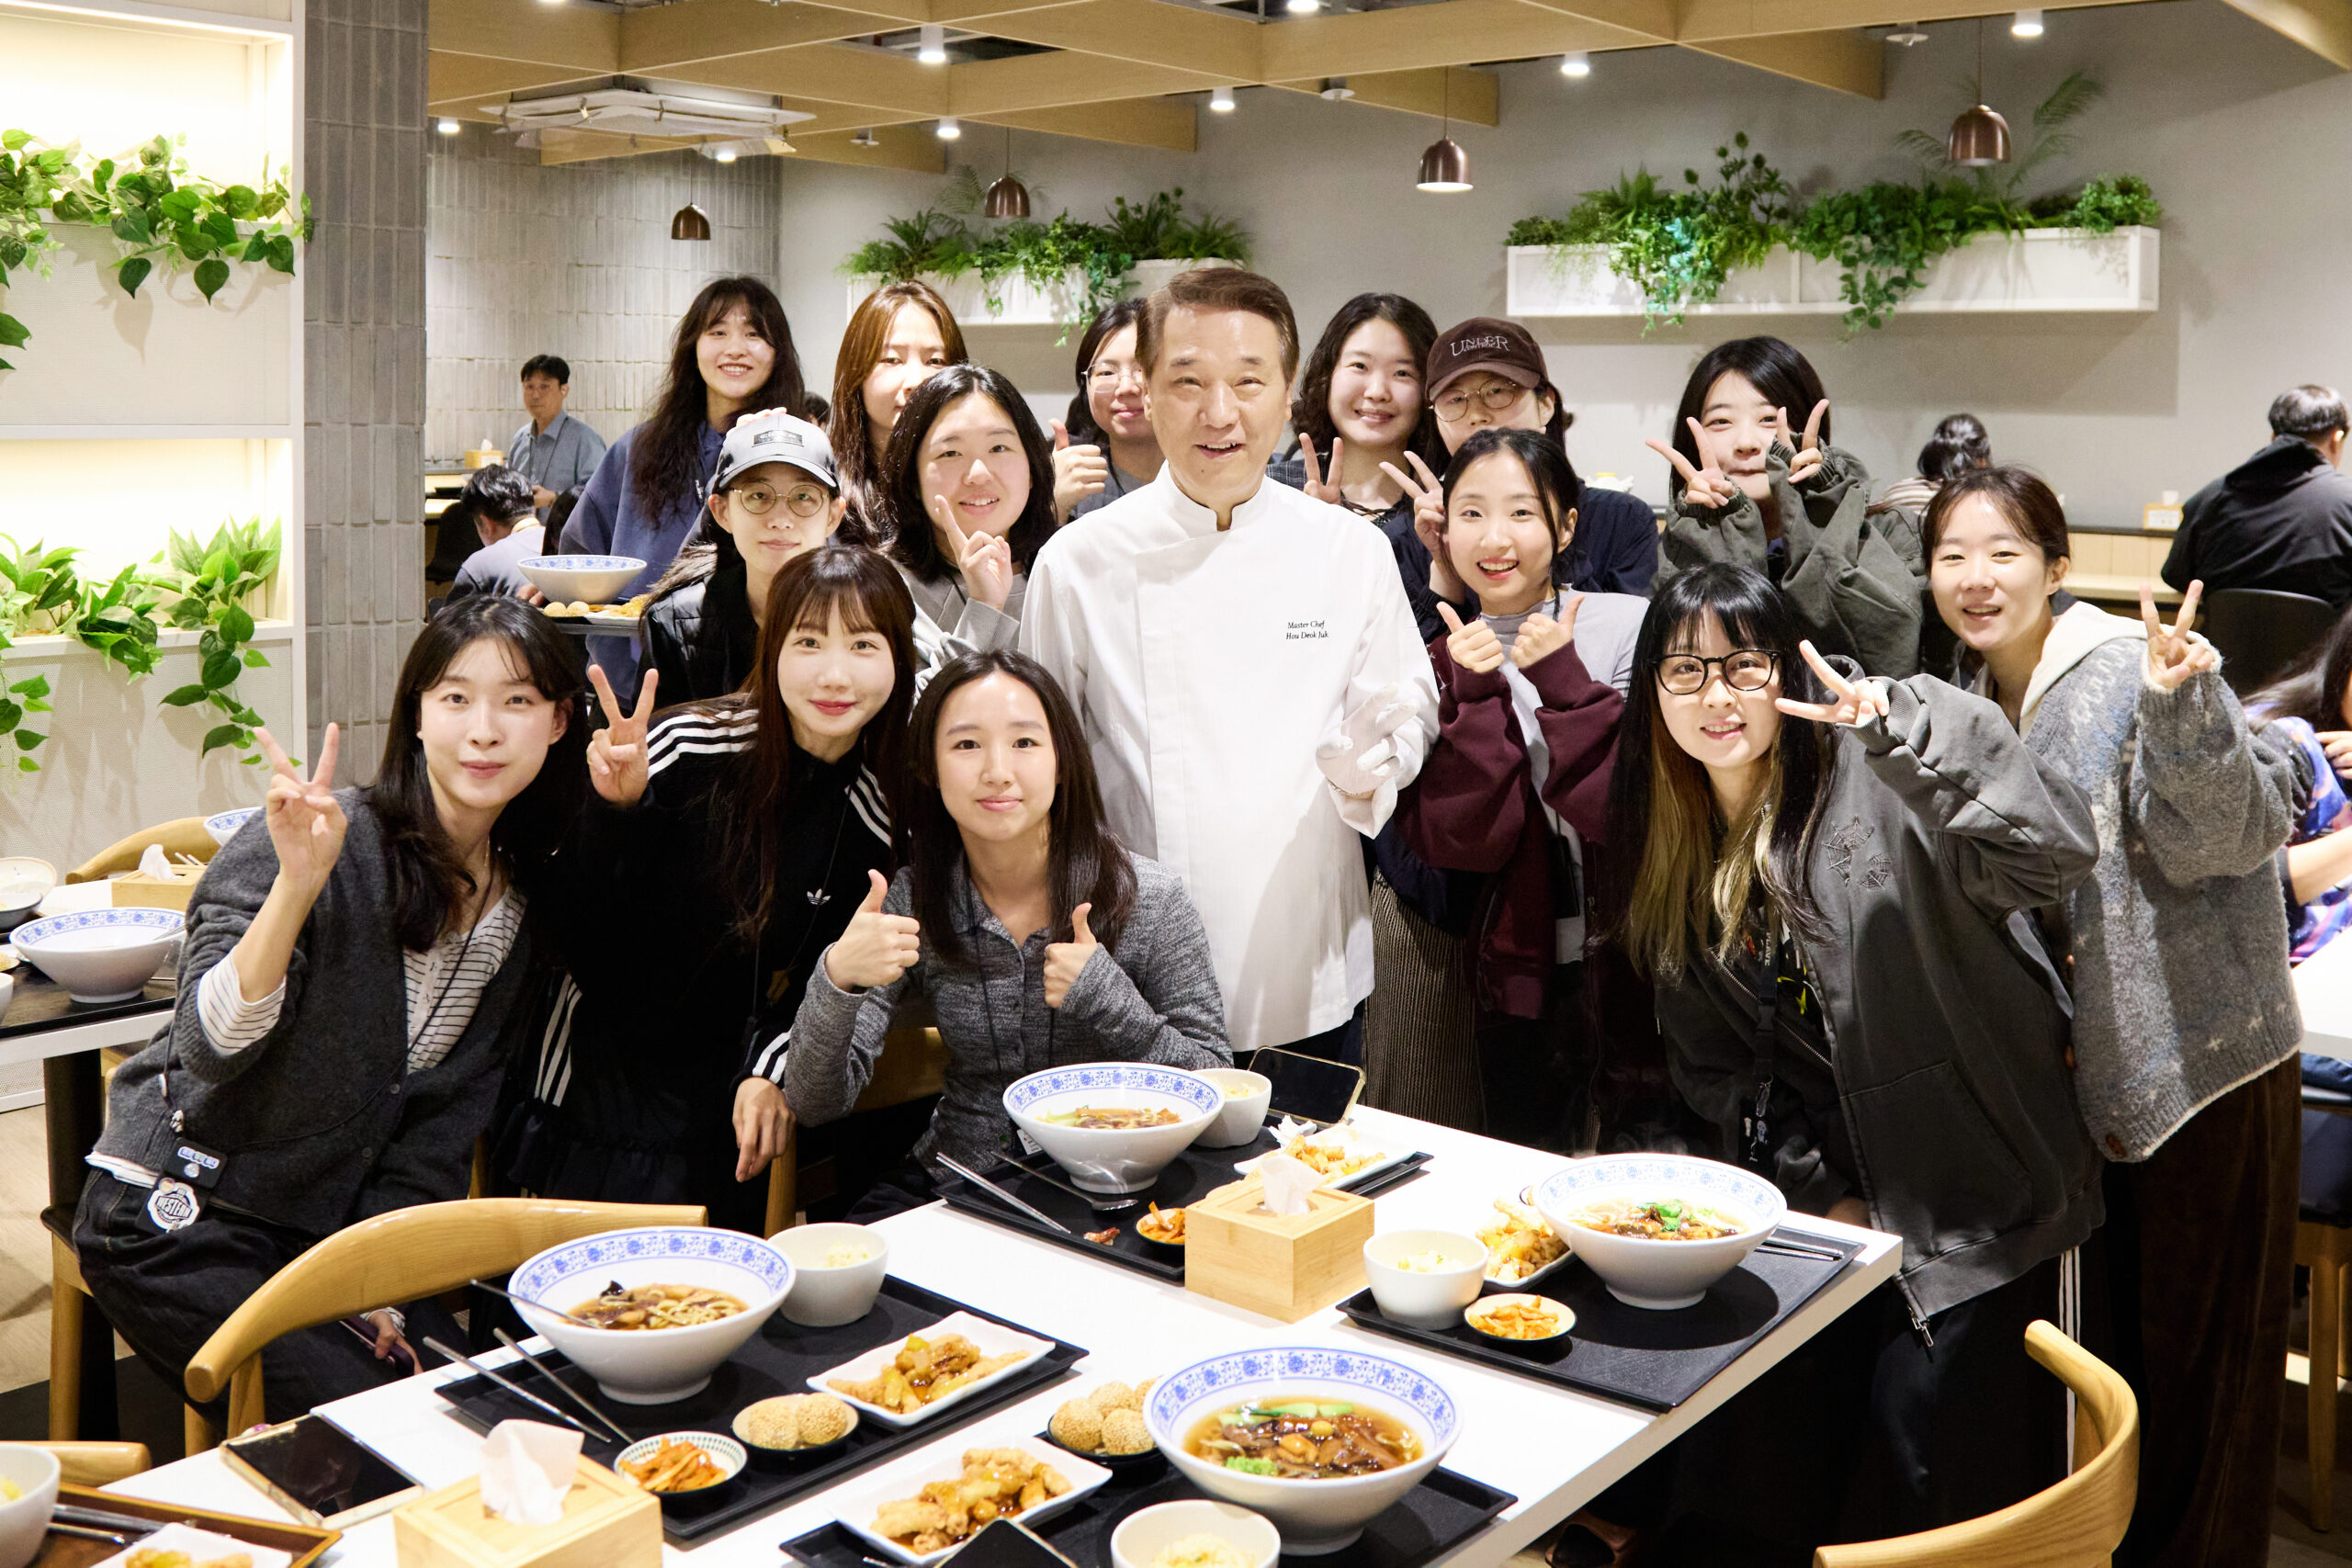
“동료들과 중식 외식을 나온 기분으로 행복하게 먹었습니다. 하루 종일 행복할 것 같은 따스한 맛이었어요.”
“셰프님 실물이 더 멋있으세요. 덕분에 너무 맛있는 식사였습니다.”
 |  |
포토타임
삼성웰스토리가 마련한 포토존에도 사우들의 발길이 이어졌다. 셰프와 나란히 서서 기념사진을 남기는 사우도, 휴대폰을 들고 함께 셀카를 찍는 사우도 있었다. 후덕죽 셰프는 사인 요청에도 웃으며 펜을 들었다.
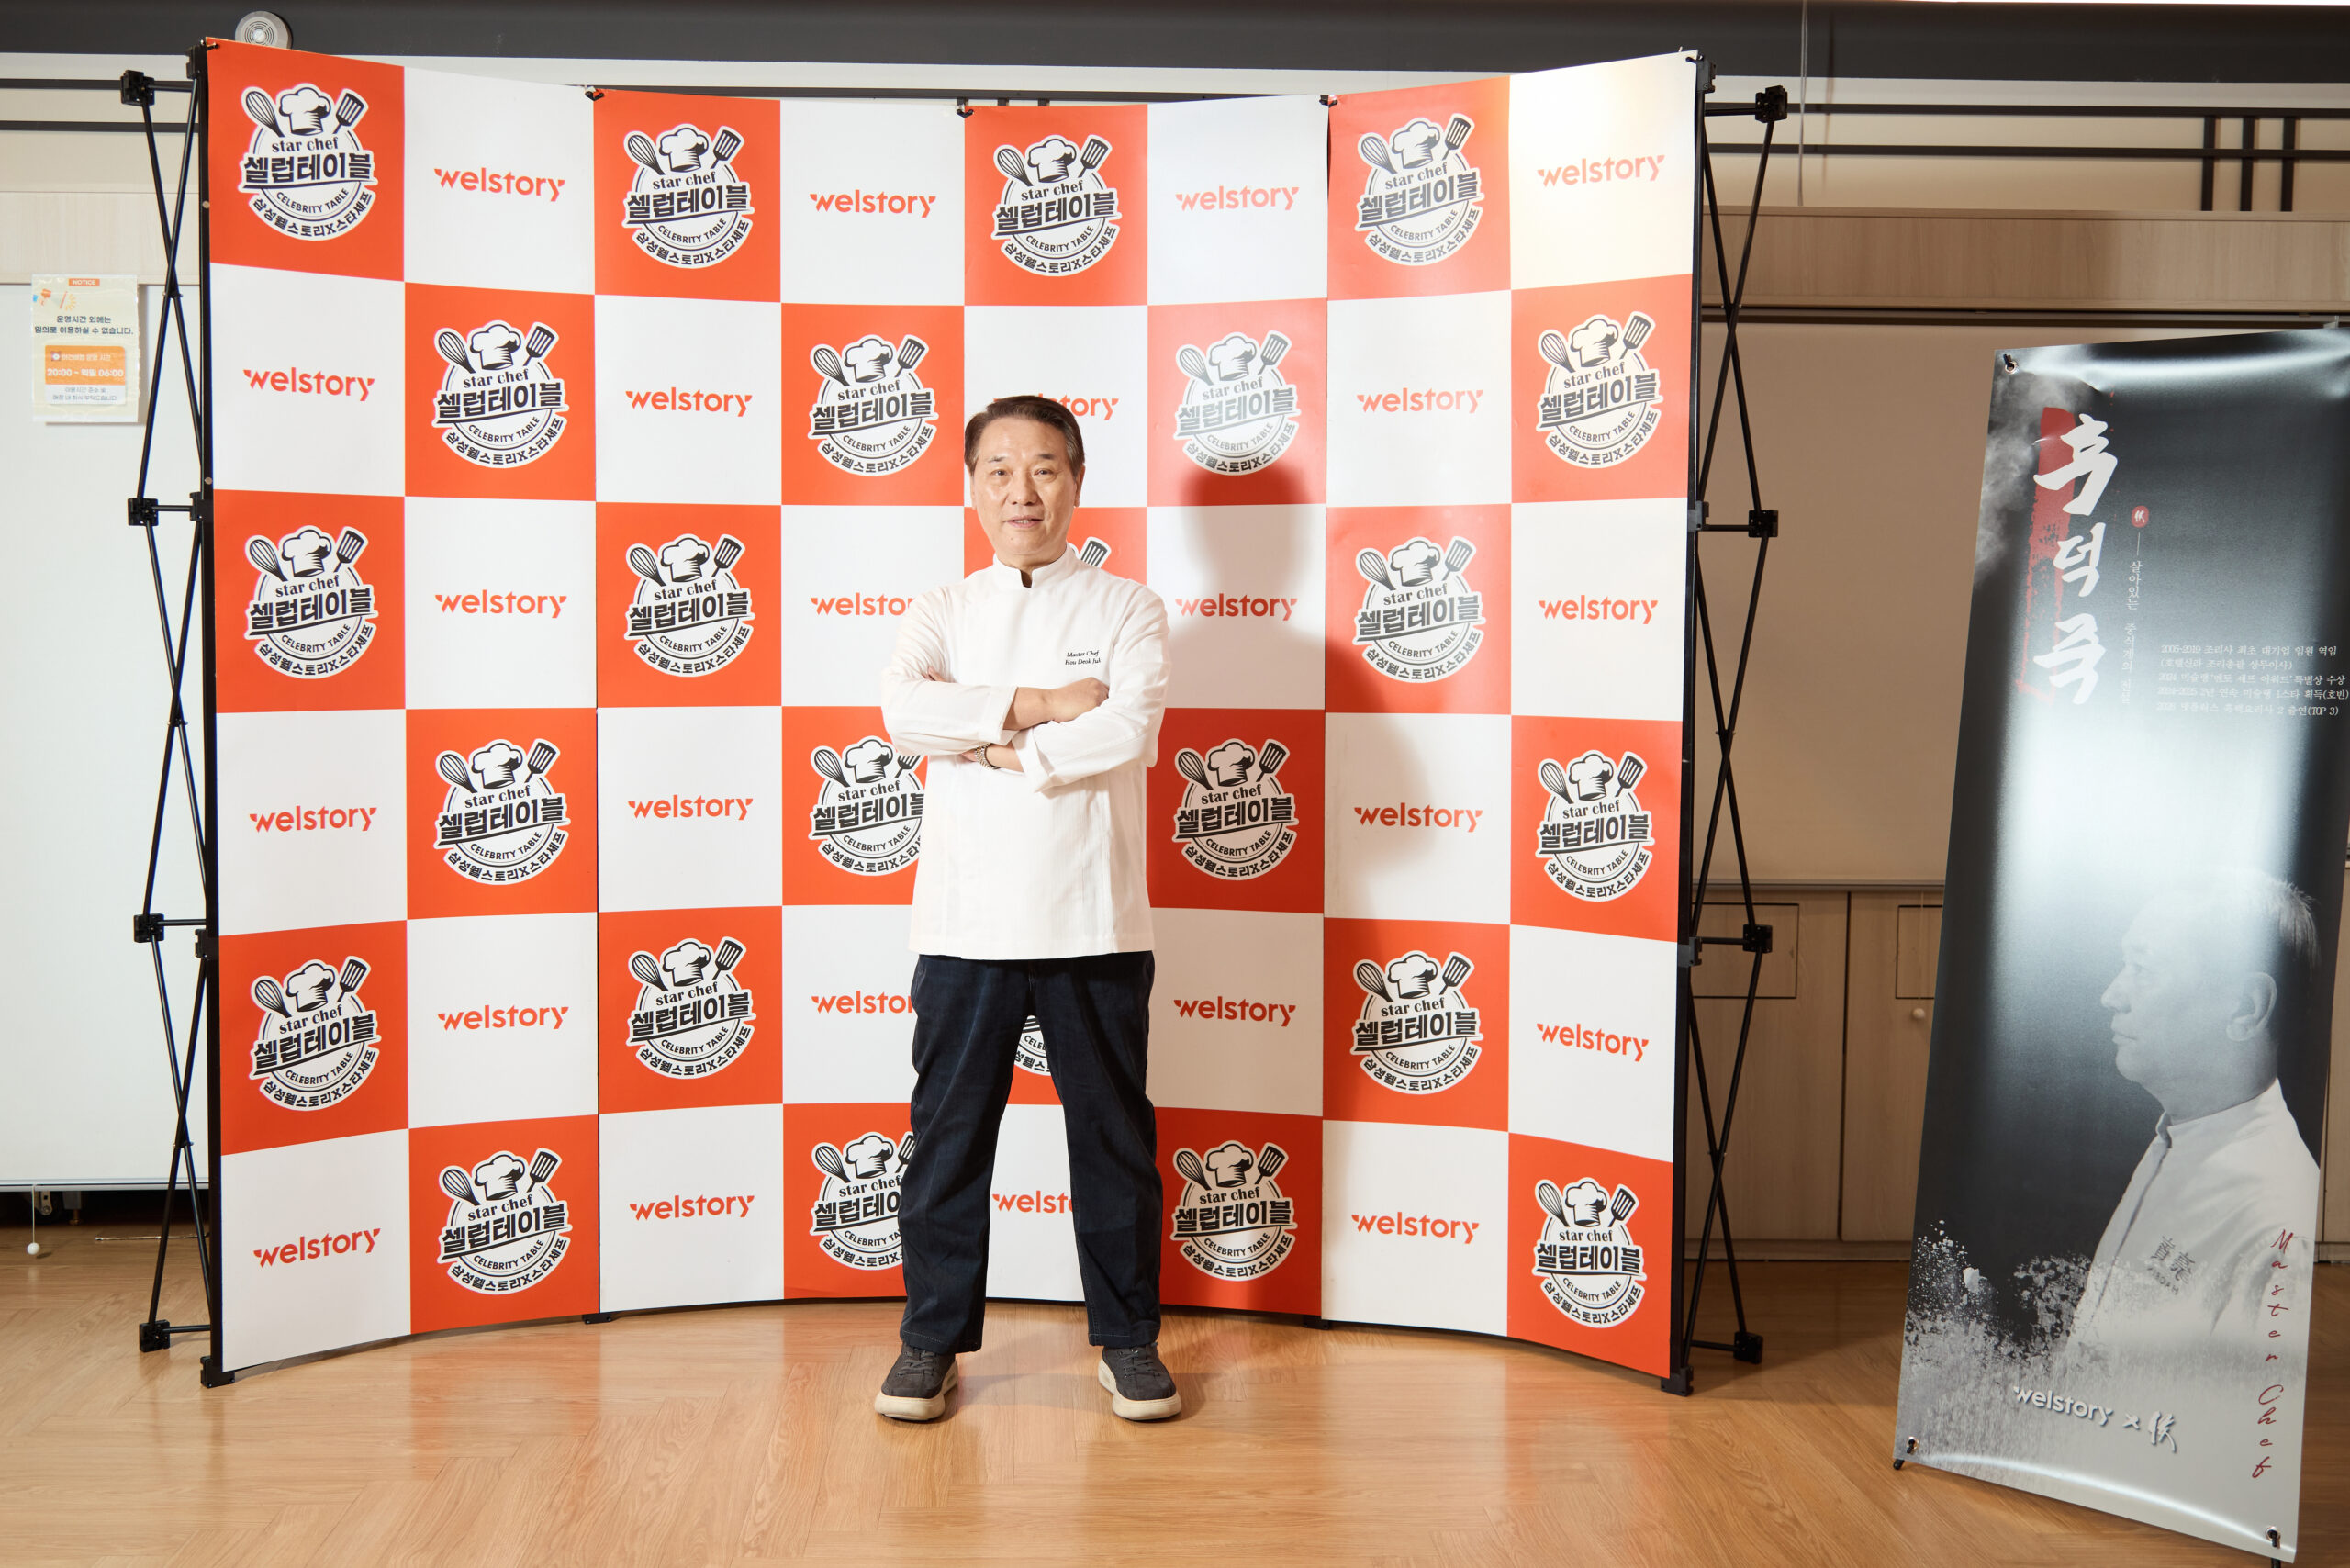
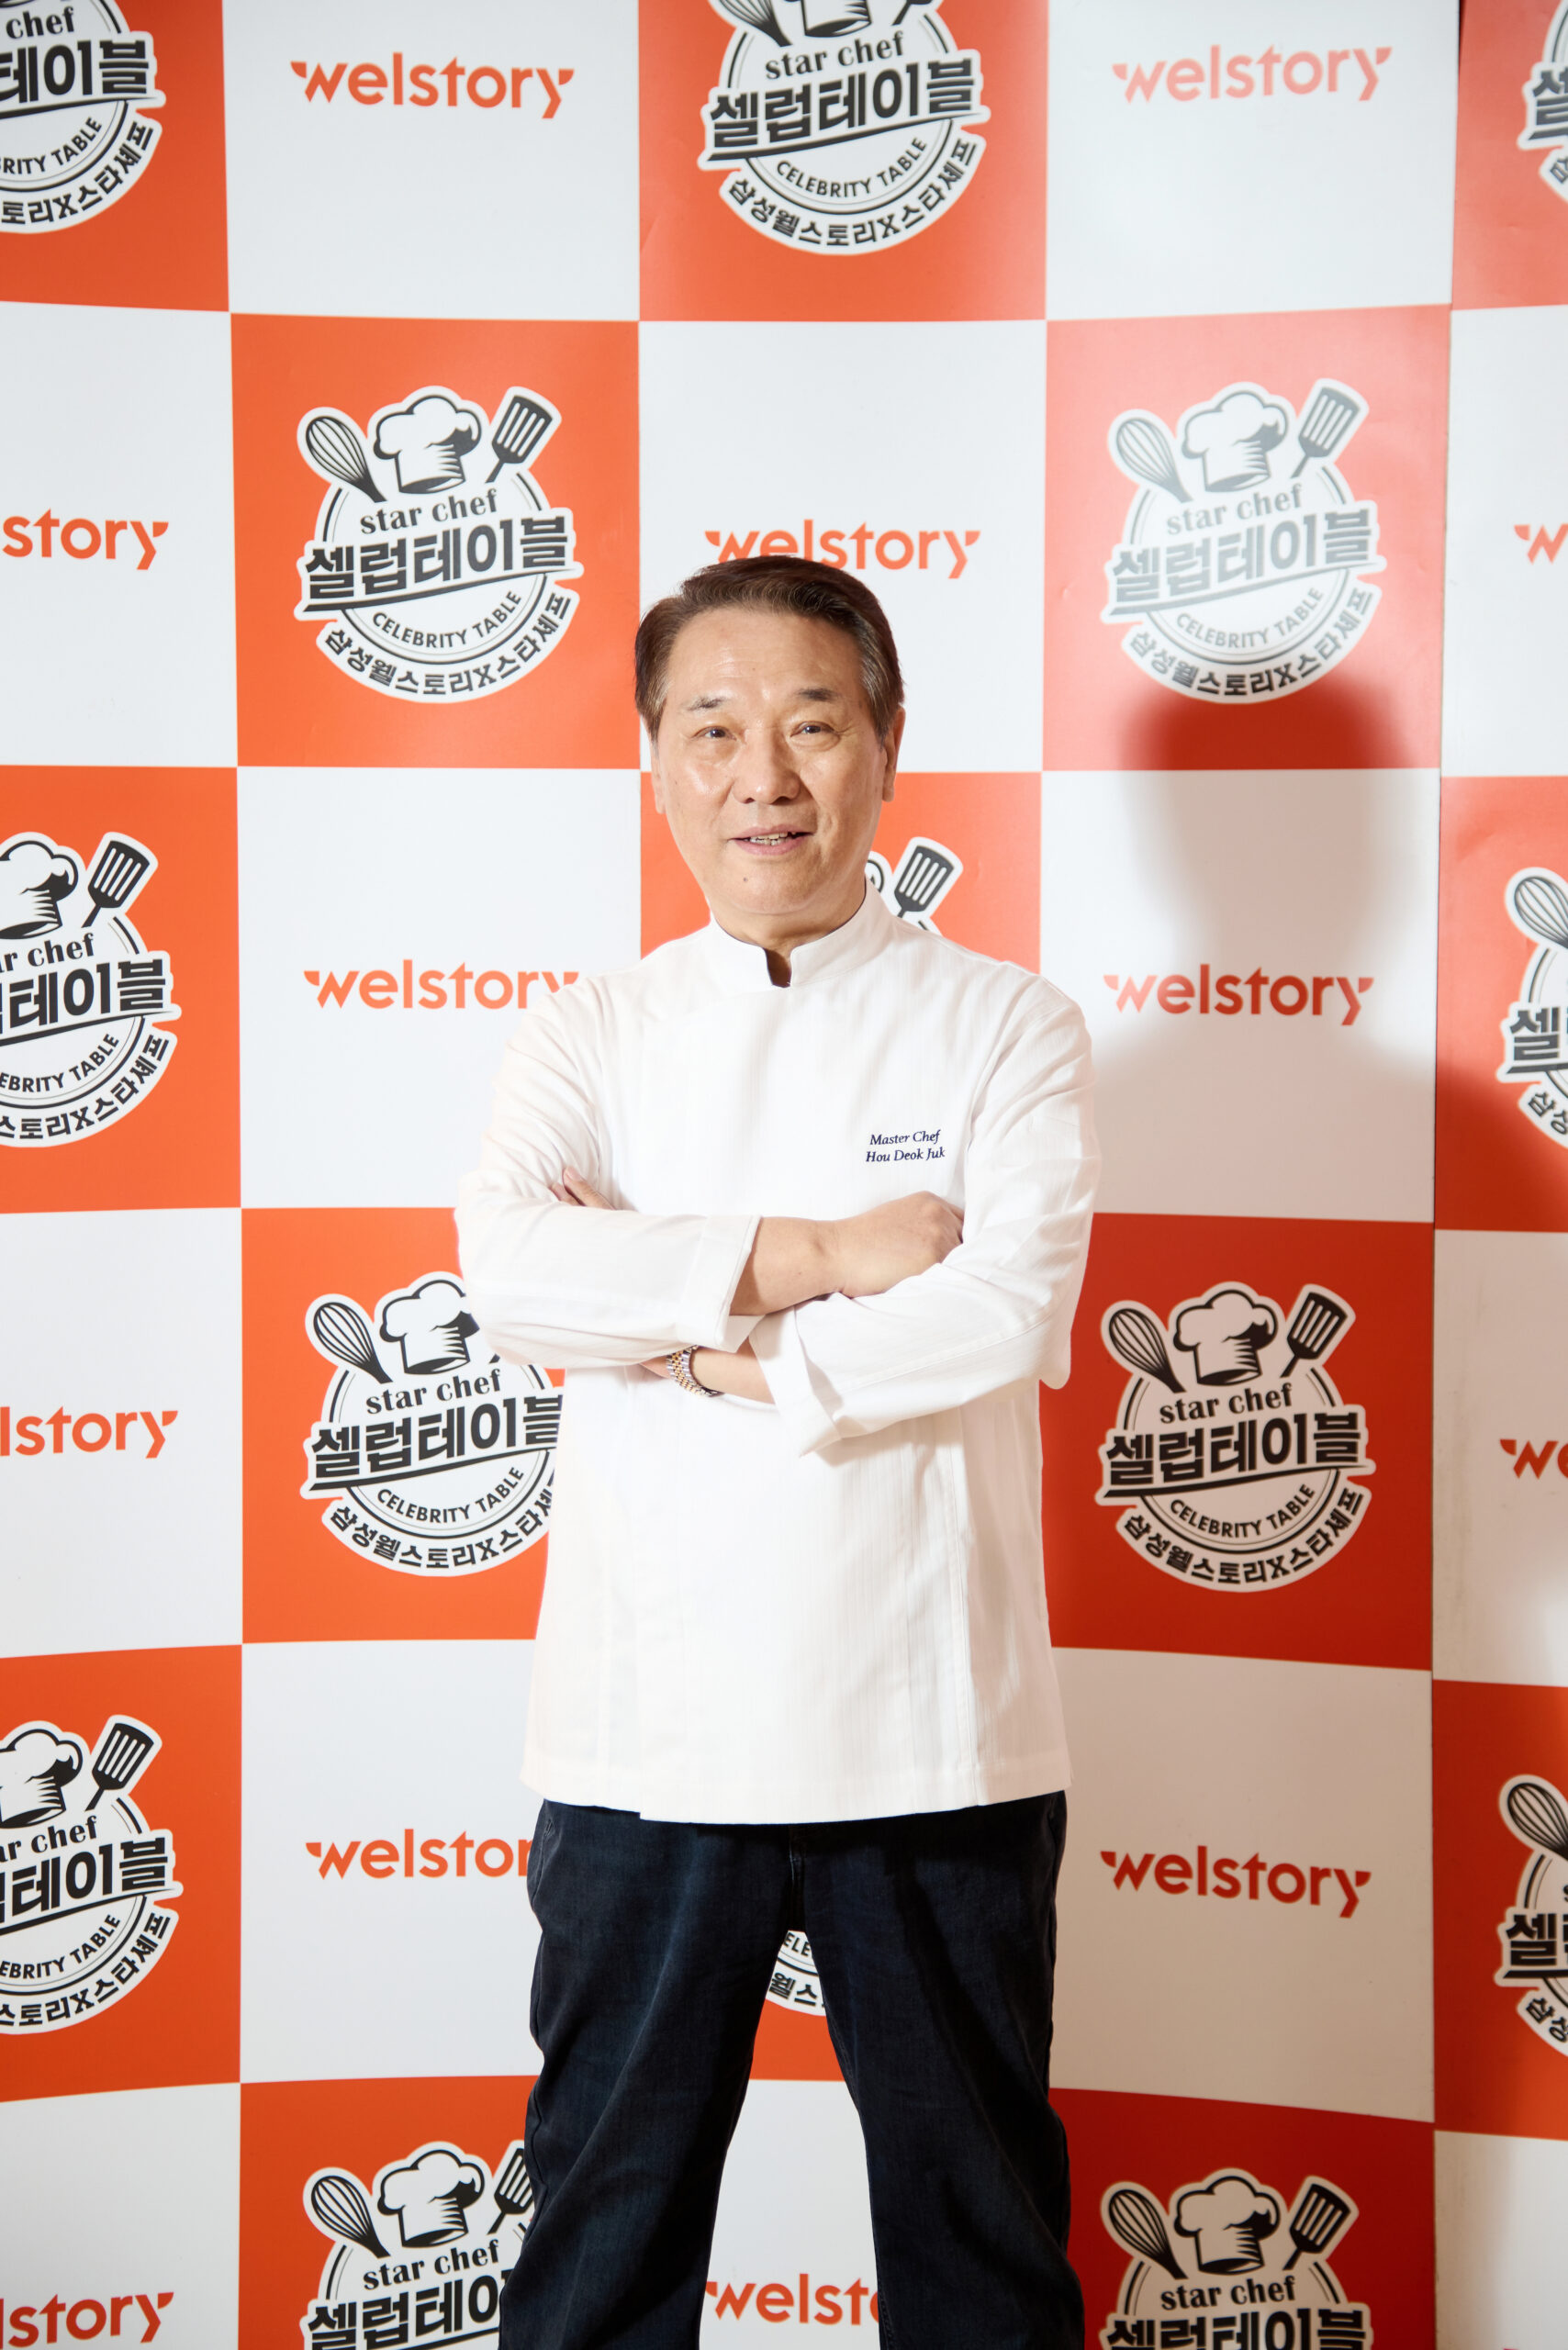
후덕죽 셰프는 누구?
1977~2019년서울신라호텔 중식당 ‘팔선’ 창립 멤버, 총주방장
최초국내 호텔업계 중식 조리사 최초로 임원(상무) 승진
불도장중국 보양식 ‘불도장’을 국내에 처음 소개
현재앰배서더 서울 풀만 호텔 중식당 ‘호빈’ 총괄(미쉐린 가이드 서울 1스타)
2025~2026년<흑백요리사2> 백수저 출연, TOP3
<흑백요리사2>에서 그는 백수저 최연장자였지만, 팀전에서는 권위를 내려놓고 후배들의 의견을 따랐다. 승부가 끝나면 상대를 먼저 다독였다. 이런 모습에서 ‘후덕죽 사고’라는 신조어까지 생겨났다.
58년 동안 주방을 지켜 온 그는 한 인터뷰에서 요리를 “먹는 사람의 하루와 몸을 책임지는 일”이라고 말했다. 이날 컴투스 사우들에게 차려 준 팔진탕면 한 그릇에도 그 마음이 고스란히 담겼다.
다음 셀럽 테이블을 기다리며
셀럽 테이블은 이번으로 벌써 네 번째를 맞았다. 이영아 영양사는 다음 셀럽 테이블도 기대해 달라는 말을 전했다.
“이번이 벌써 네 번째 셀럽 테이블이었어요. 다음 셀럽 테이블도 기대해 주세요. 항상 고민하고 노력하는 웰스토리가 되겠습니다.”
– 이영아 영양사 –
사내 식당 직원들은 건강하고 맛있는 식사를 위해 매일 최선을 다하고 있다. 식당에 바라는 점이나 궁금한 점이 있으면 식당 출구의 화이트보드나 카카오톡 채널 ‘컴투스 그룹 사내식당’으로 남기면 된다. 사내 식당은 가능한 부분을 최대한 운영에 반영할 계획이다. 다음 셀럽 테이블에서는 어떤 셰프가 Cooking을 찾을지 벌써부터 기대된다.
컴투스 그룹 사내 식당 Cooking의 이야기는 앞으로도 계속된다.
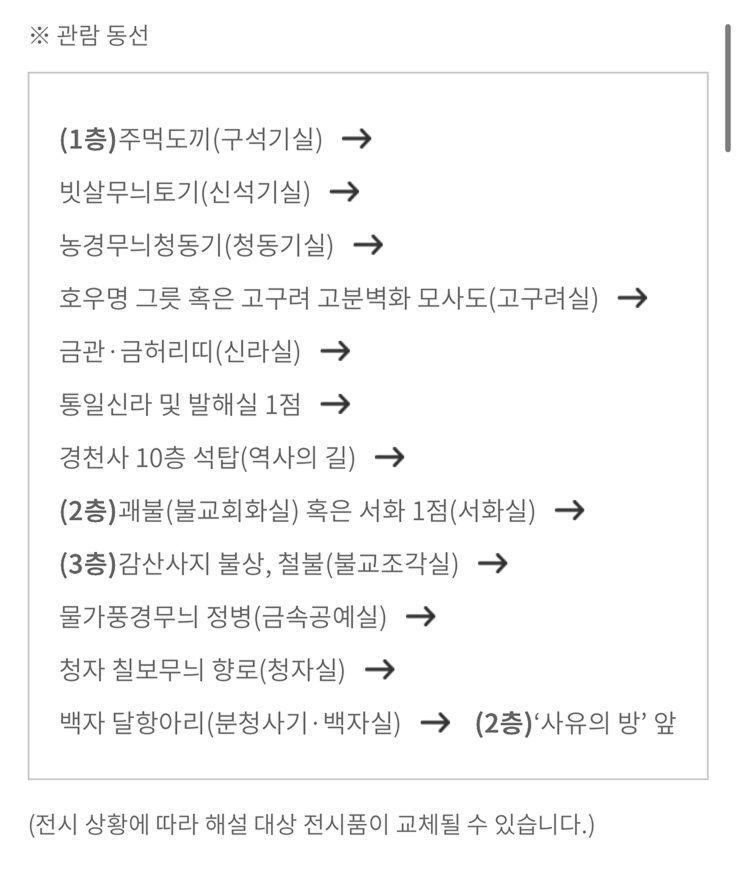
리커버리데이를 맞아 국립중앙박물관을 찾았다. 워낙 다양한 유물이 모여 있는 곳이라 혼자 둘러보기는 쉽지 않다. 이럴 때는 박물관이 무료로 운영하는 정기해설 가운데 ‘대표유물해설’을 활용해 보자. 해설사님이 꼭 봐야 할 유물을 골라 1시간 동안 그 사연을 들려준다. 해설을 따라 걸으며 들은 이야기를 동선 순서대로 정리해 본다.
국립중앙박물관, 건물부터 다시 보기
대표유물해설은 전시실보다 건물 이야기로 먼저 시작한다.
국립중앙박물관은 뒤로 남산을, 앞으로 한강을 둔 ‘배산임수’ 자리에 있다. 박물관 계단 위 열린마당에 서면 건물 사이로 남산서울타워가 액자처럼 걸린다.
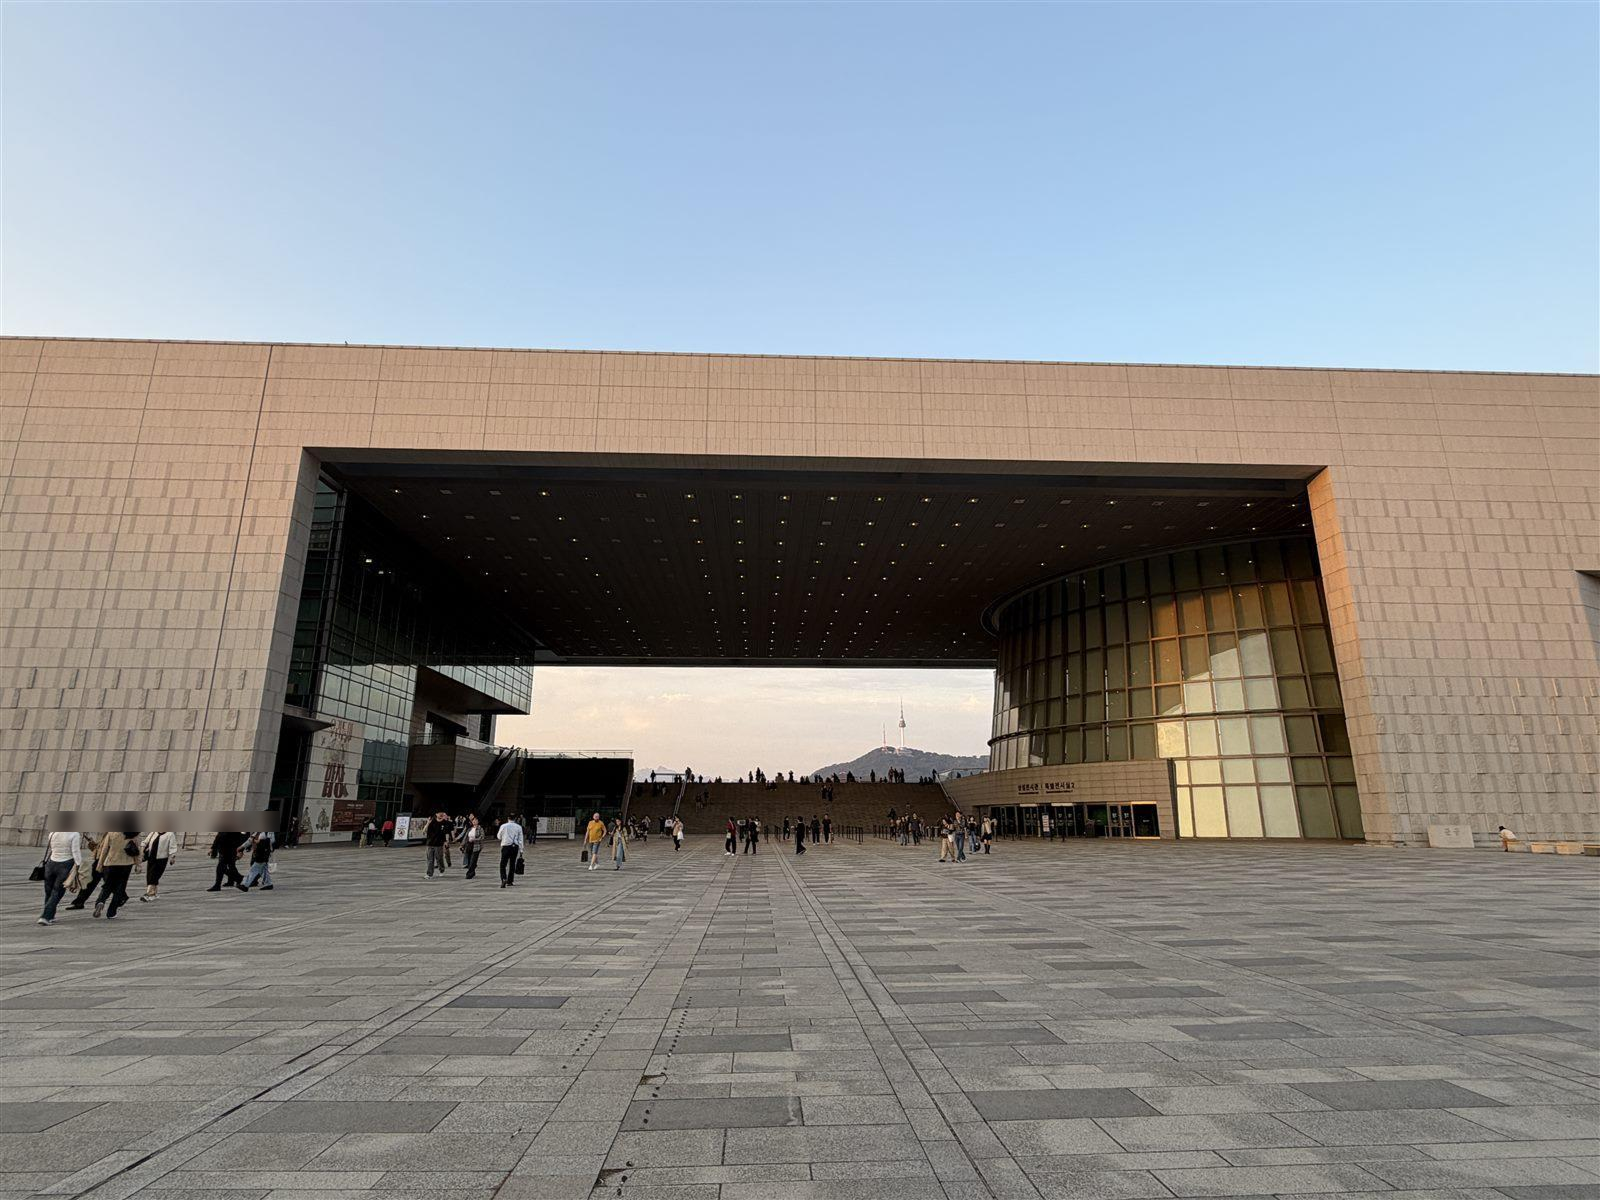
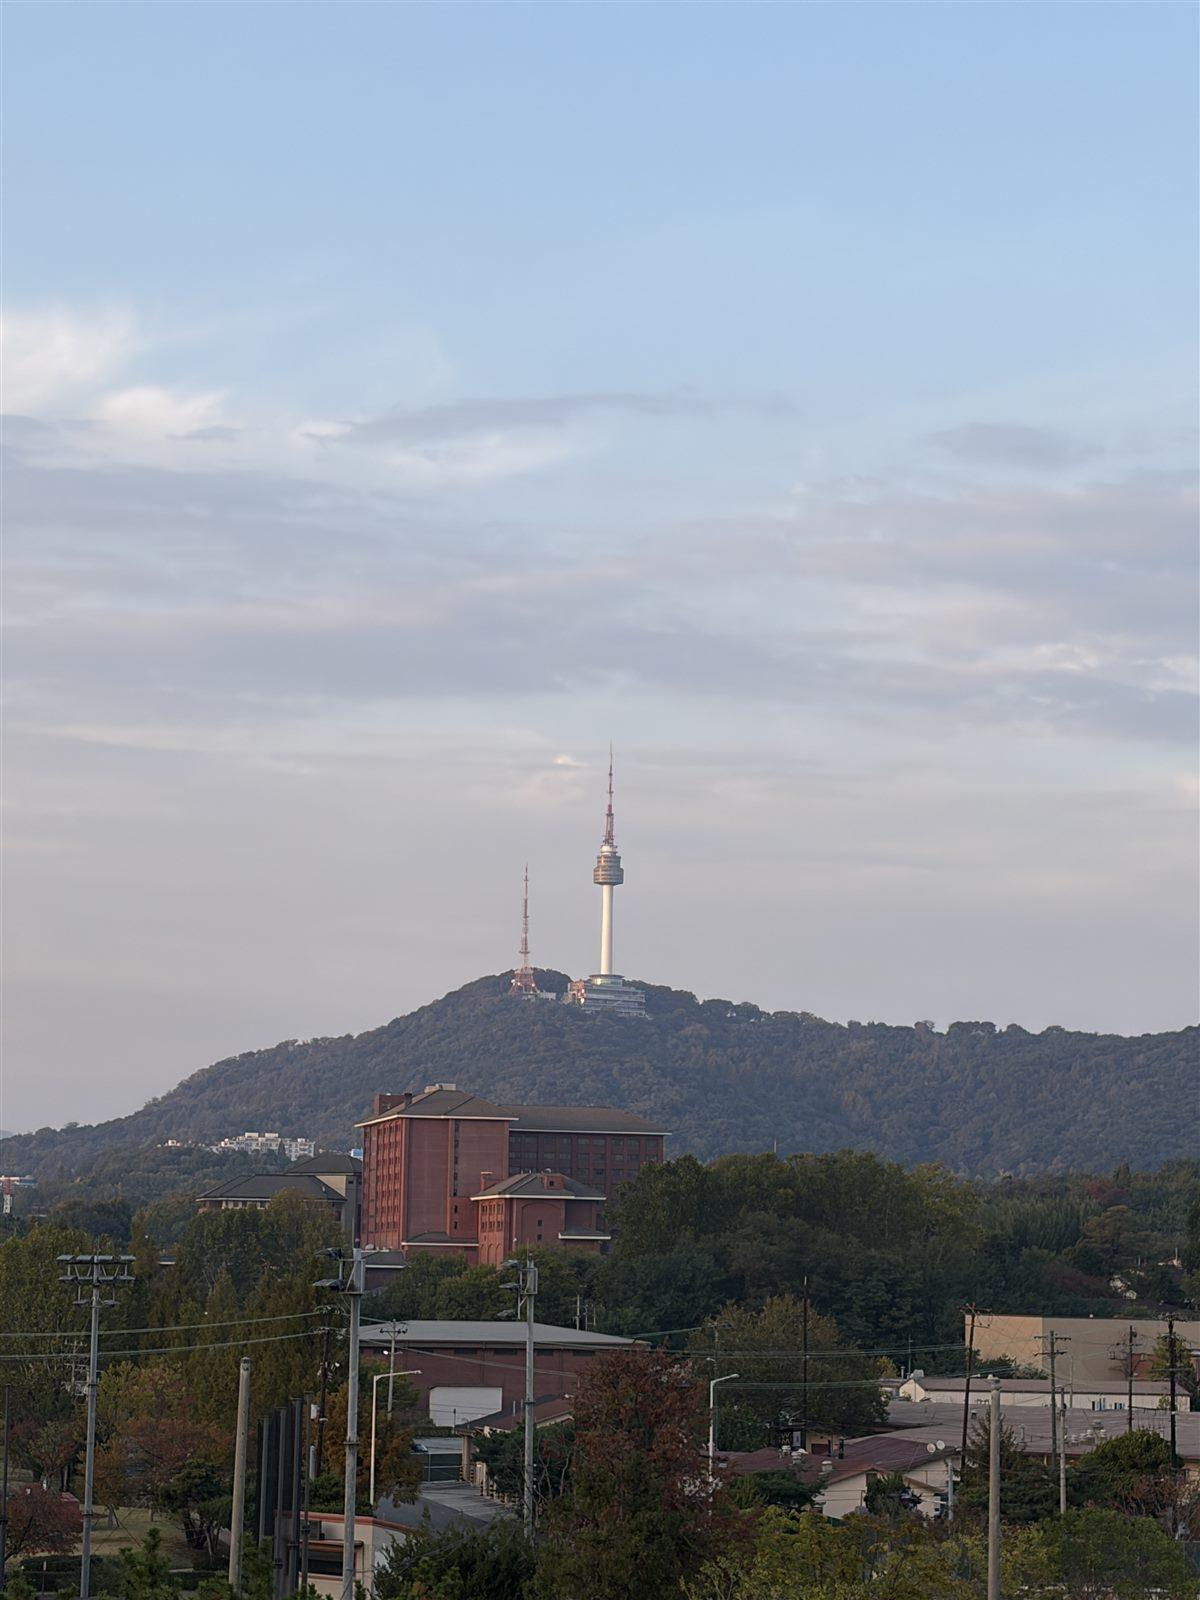
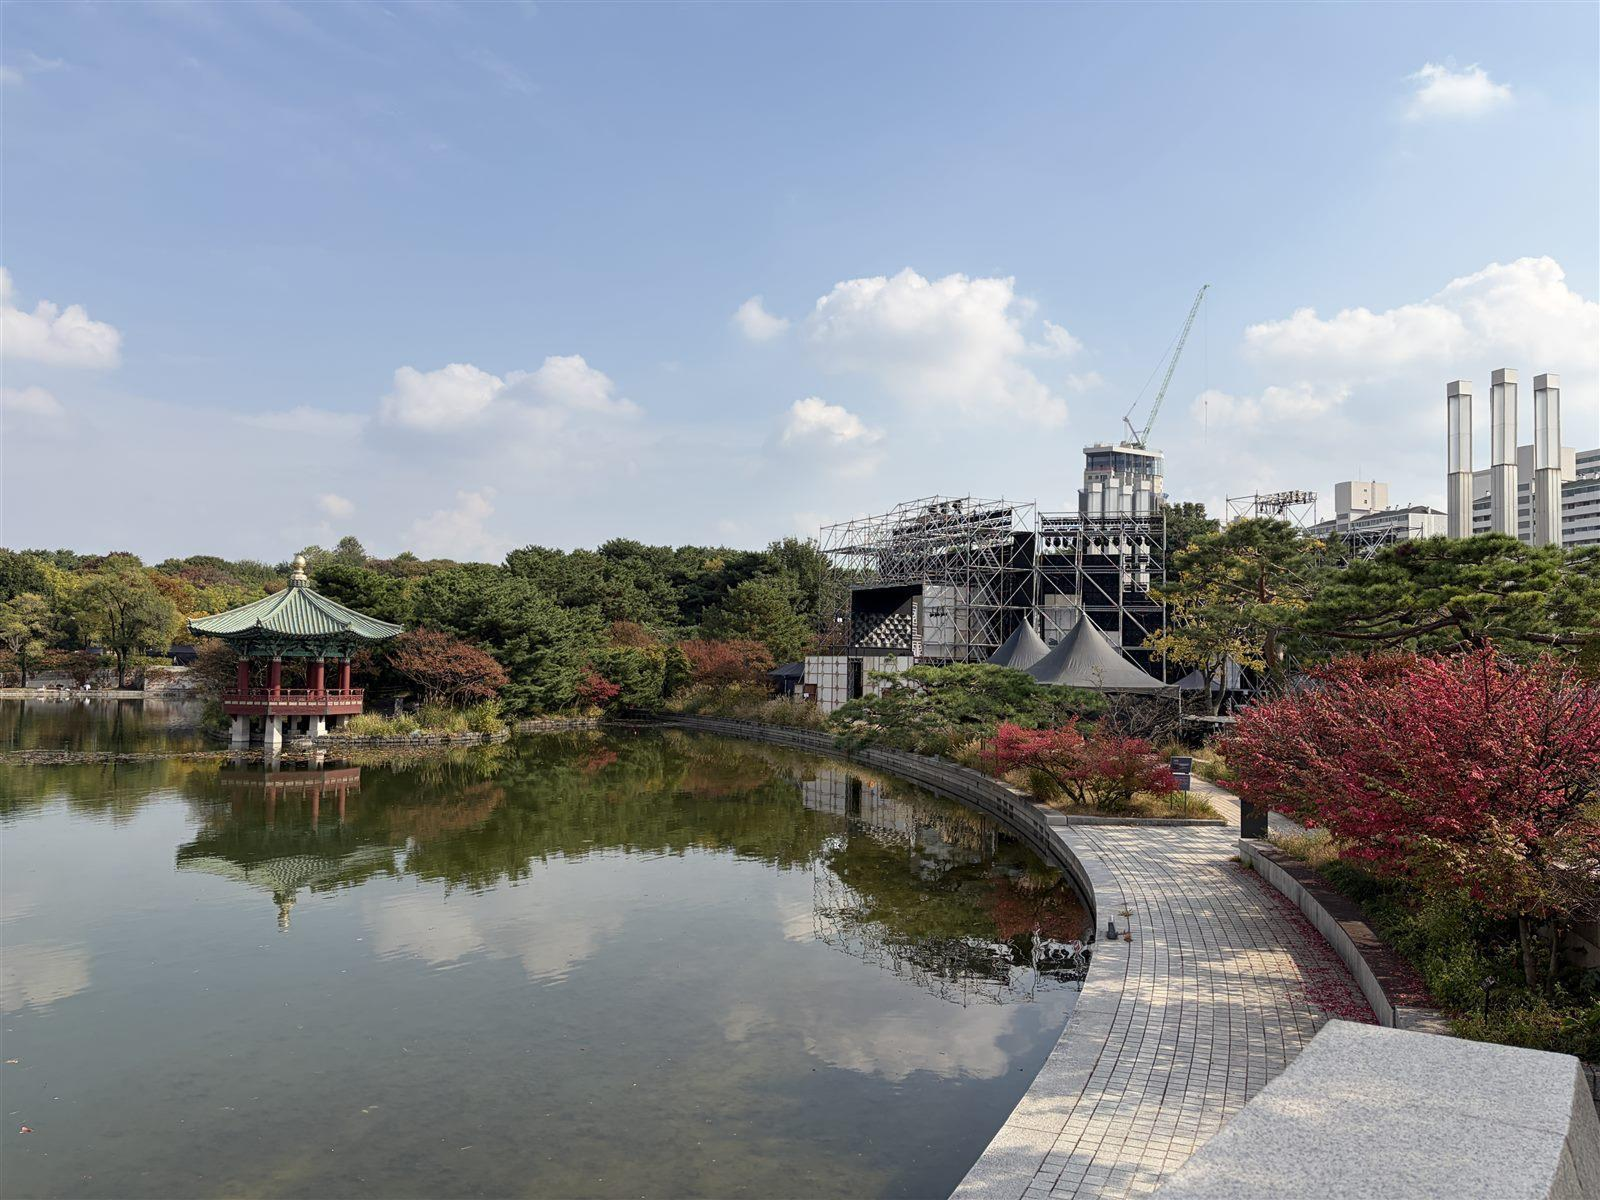
전시장 건물이 길게 둘러싼 모습은 성곽을 닮았다. 해설사님은 우리나라가 ‘성곽의 나라’여서 그 모습을 건물에 담았다고 설명했다. 박물관 앞 연못 거울못에 떠 있는 정자 ‘청자정’은 이름처럼 지붕에 청기와를 얹었다. 청기와는 우리 전통 건축에서 귀하게 여긴 기와다.
청자정 지붕의 청자 기와 7,452장은 2009년 국립중앙박물관회 젊은 친구들(YFM, Young Friends of the Museum)이 기증했다. YFM은 젊은 경영인들이 모여 국립중앙박물관을 후원하는 모임이다. 송병준 컴투스 의장도 YFM 멤버로 활동하고 있으며, 2022년부터 2024년까지는 위원장을 맡아 모임을 이끈 바 있다. 거울못 위 정자 하나에도 박물관을 아끼는 후원자들의 마음이 담겨 있다.
해설사님이 강조한 말이 하나 더 있었다. 박물관의 첫 번째 목적은 ‘보존’이라는 것이다. 그래서 빛과 습도에 약한 미술 유물은 약 3개월마다 바꿔 전시한다. 3개월에 한 번씩 찾아오면 매번 새로운 작품을 만날 수 있다는 뜻이다.
대표유물해설, 참여하는 방법
- 모이는 곳 상설전시관 1층 ‘대한제국’ 전시실 앞
- 해설 시간 평일 10:30 / 11:00 / 13:00 / 15:00, 주말 11:00 / 13:00 / 15:00
- 신청 방법 별도 예약 없이 시간에 맞춰 모이면 된다(무료)
- 해설 대상 주먹도끼, 빗살무늬토기, 금관, 경천사 십층석탑, 청자, 달항아리, ‘사유의 방’ 등(전시 상황에 따라 바뀔 수 있다)
건물 이야기를 마친 해설사님은 관람객들과 함께 상설전시관 1층 로비로 향했다.
1층에서 시작하는 시간 여행
보물 대동여지도 목판
대표유물해설의 출발점은 상설전시관 1층 로비에 놓인 대동여지도였다. 대동여지도는 김정호가 목판에 새겨 찍어낸 지도다. 전국을 한 장에 그리지 않고 남북으로 나눠 여러 첩으로 접는 ‘분첩절첩식’으로 만들어, 필요한 부분만 펼쳐 들고 다닐 수 있게 했다. 김정호는 군사기관과 규장각에 있던 지도를 바탕으로 이 지도를 완성했다. 남아 있는 목판 12장 가운데 1장은 숭실대학교에 있다.
가까이 들여다보면 한 폭의 그림을 보는 듯하다. 길과 역참, 봉수 같은 정보는 기호로 정리했고, 백두대간의 높은 산은 진하게, 산줄기는 끊기지 않게 이어 그렸다. 산을 땅의 뼈대로 여긴 조상들의 생각이 지도에 그대로 드러난다.
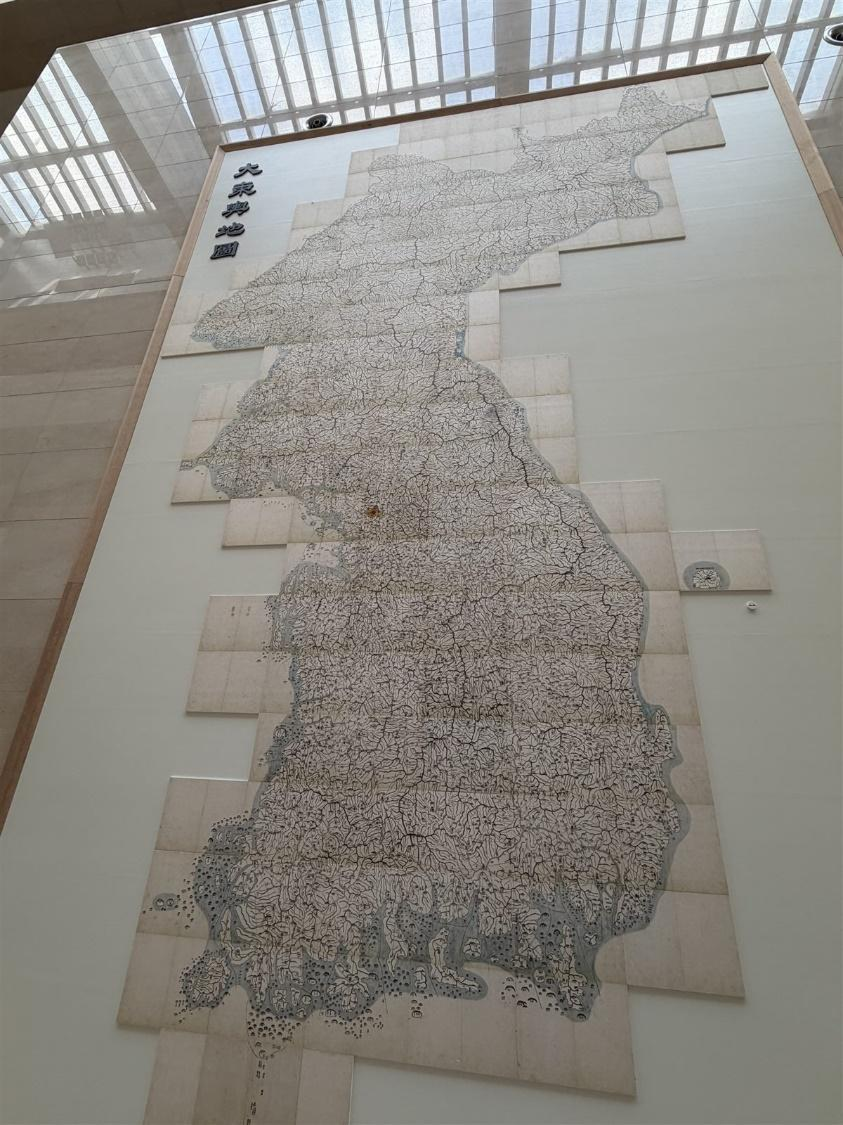
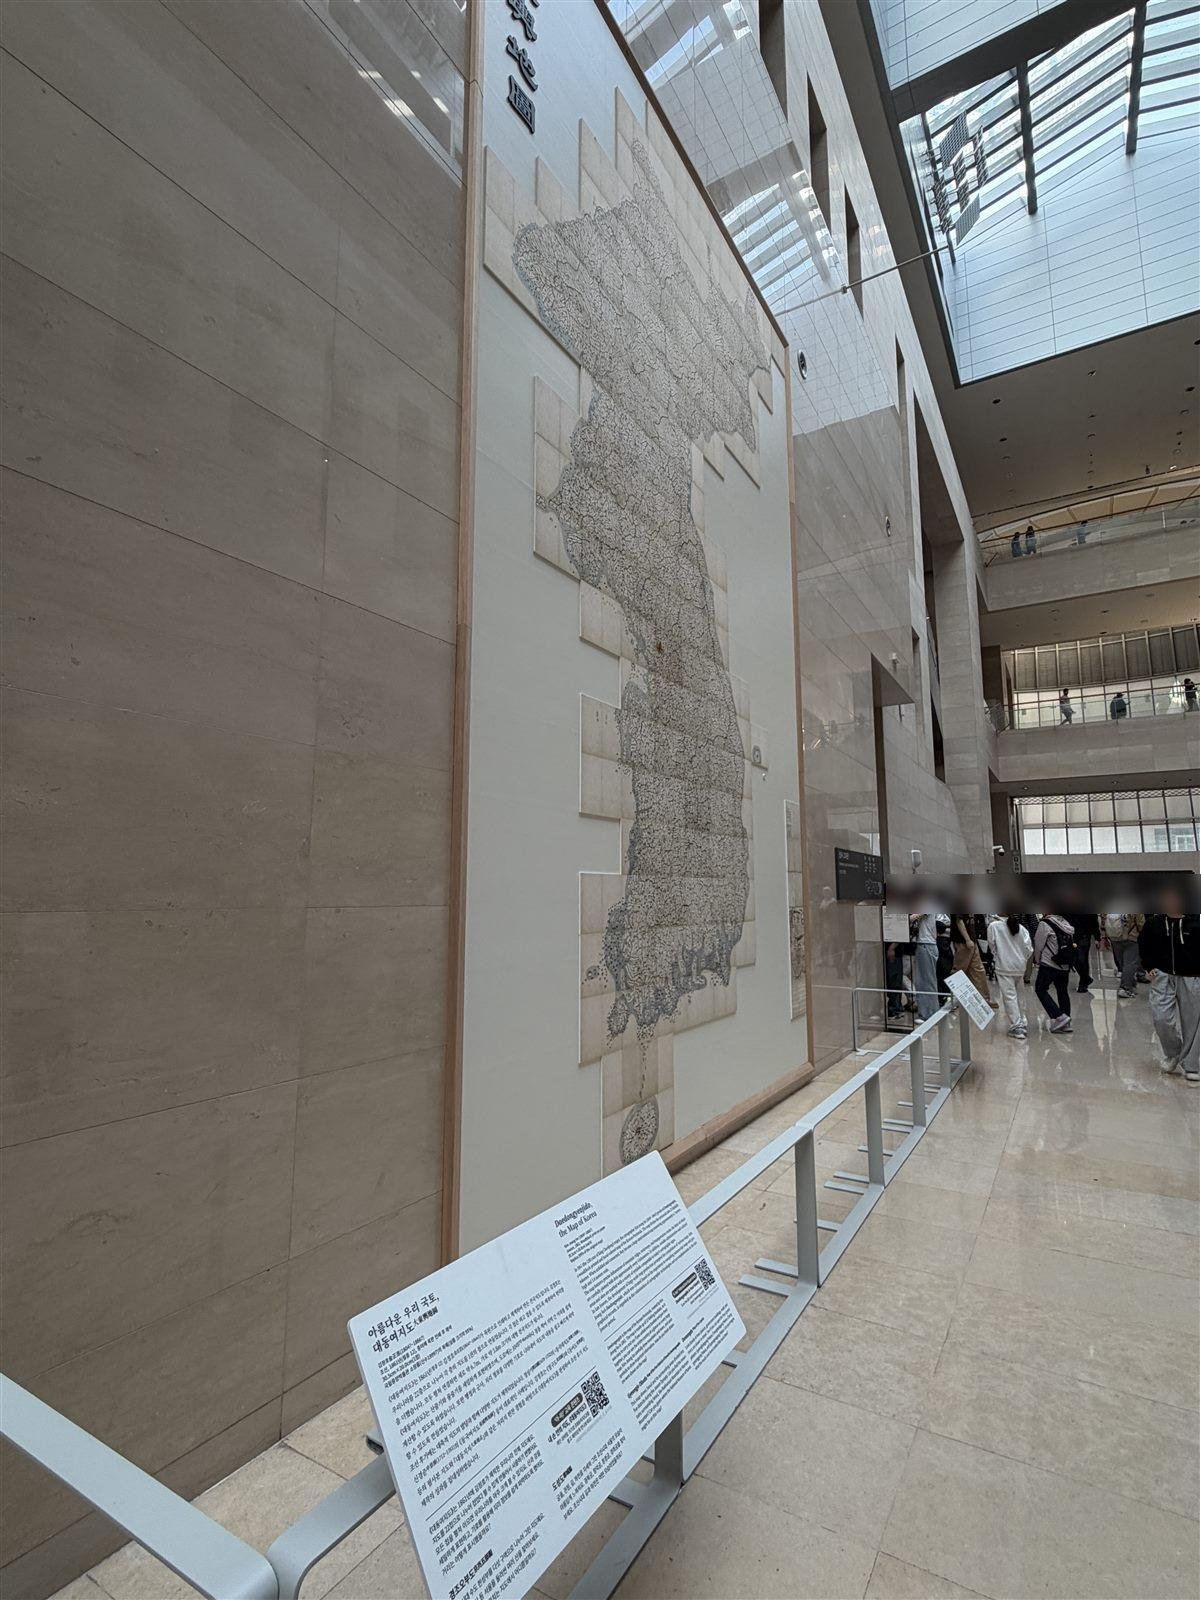
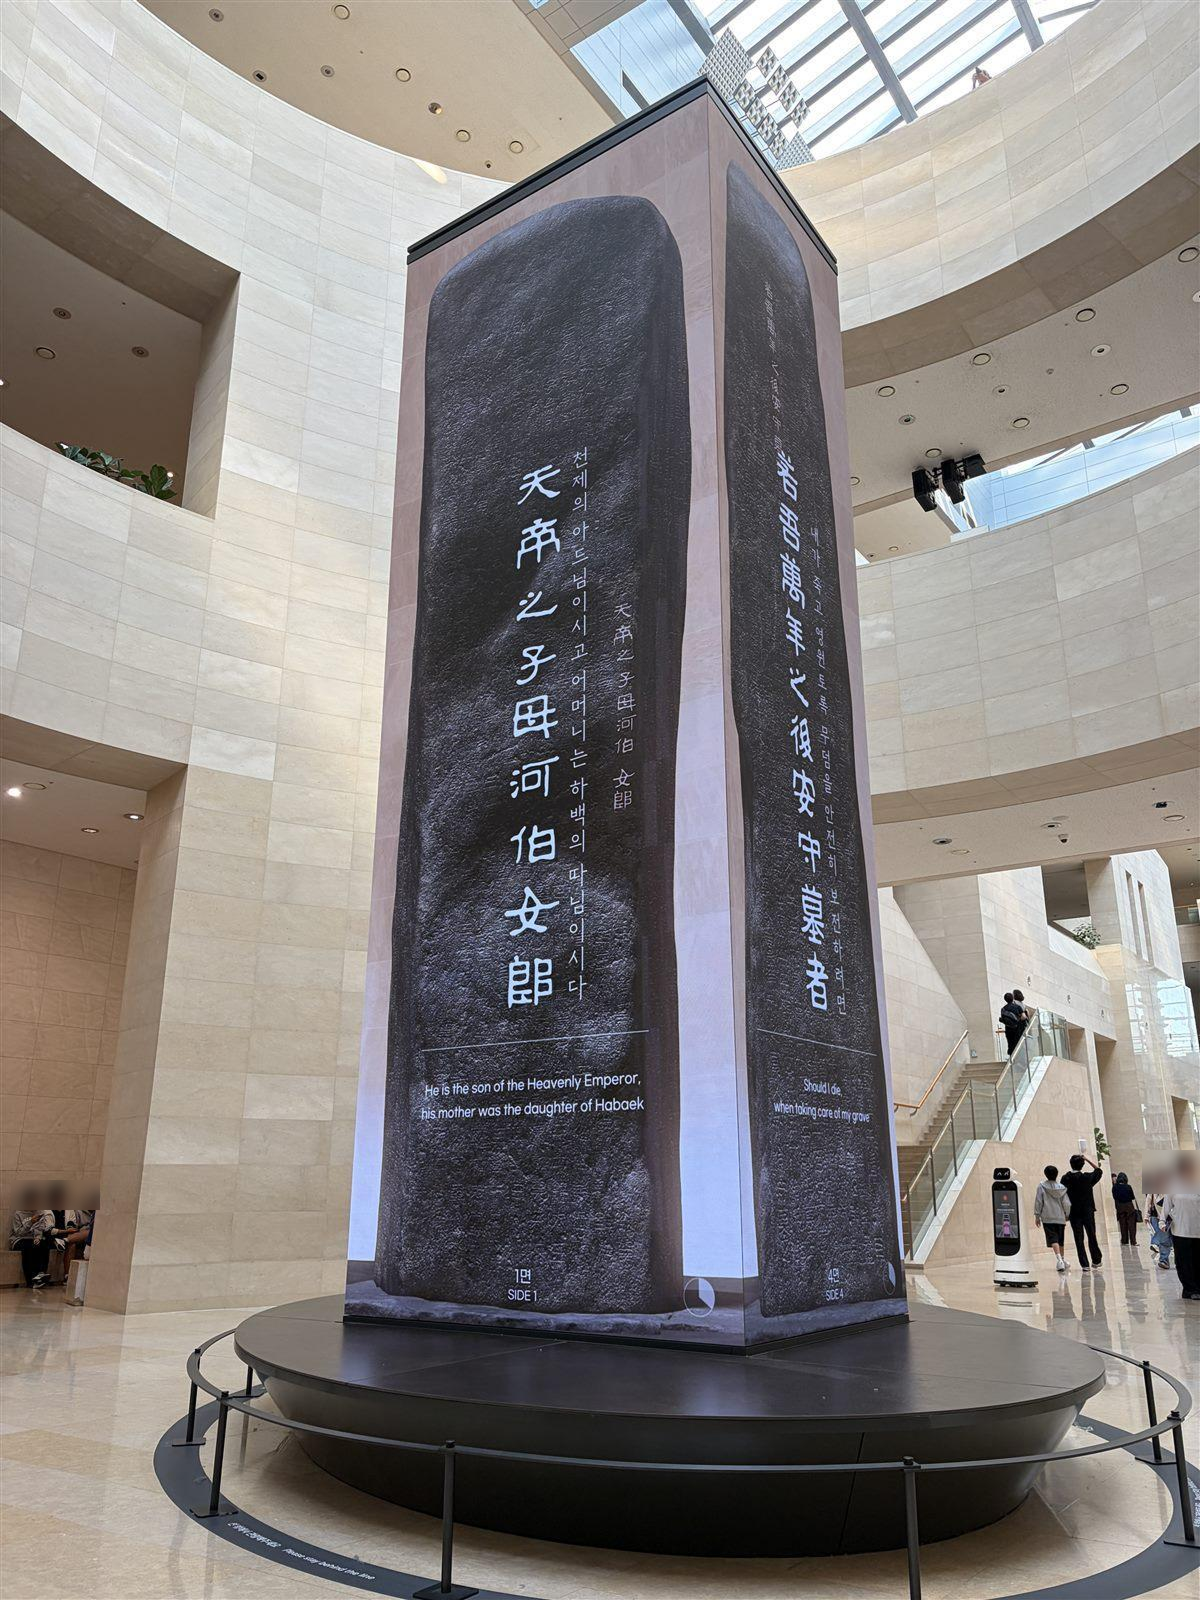
광개토대왕릉비
로비 한가운데에는 거대한 광개토대왕릉비가 서 있다. 실물이 아니라 네 면을 모두 화면으로 만든 디지털 비석이다. 광개토대왕릉비는 큰 돌 하나의 네 면을 다듬어 글자를 새긴 ‘4면비’라는 점이 특징이다. 디지털 비석 주위를 한 바퀴 돌면 비석의 네 면을 차례로 볼 수 있다.
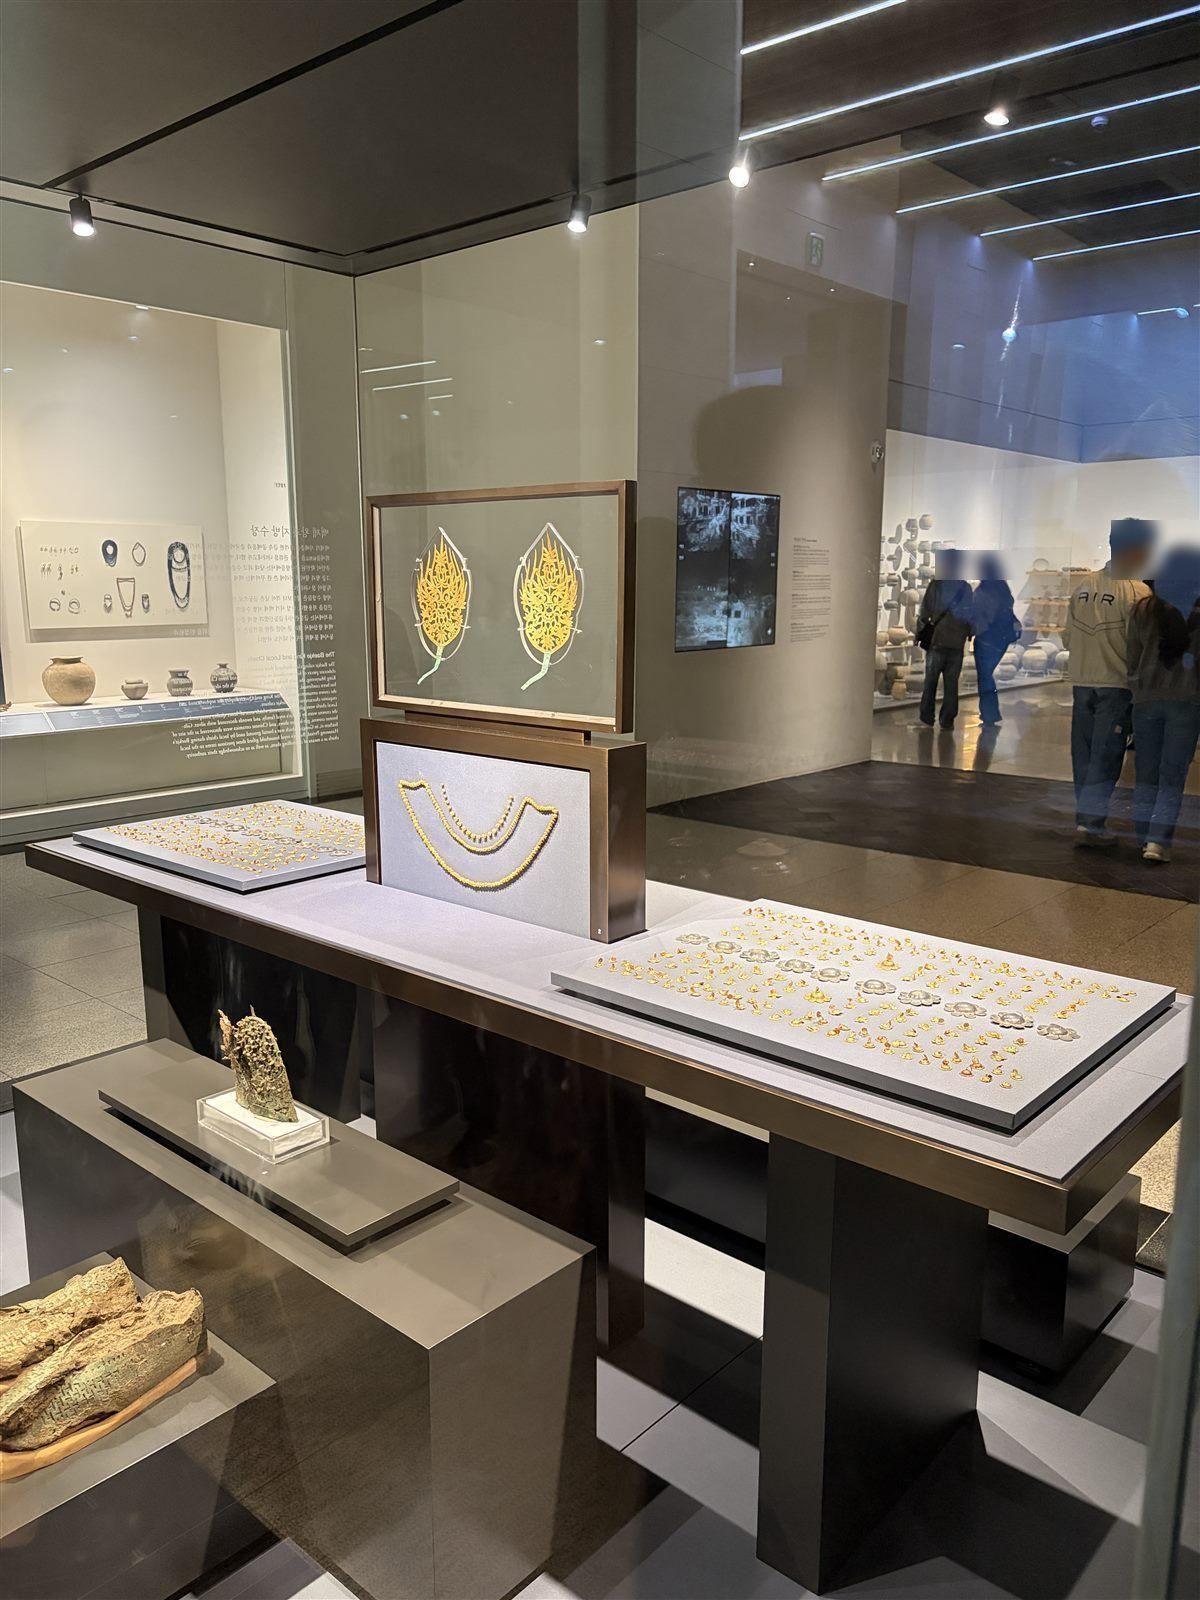
로비를 지나 전시실로 들어서자 금빛 유물들이 본격적으로 모습을 드러냈다.
백제·가야·신라, 금빛으로 남은 왕국들
국보 무령왕비 금제 관식
무덤은 주인을 알면 ‘능’, 모르면 ‘총’이라고 부른다. 무령왕릉은 무덤 안에서 묘지석이 나와 주인을 알 수 있었던 무덤이다. 이곳에서 나온 무령왕비 금제 관식은 검은 비단 모자에 꽂던 금관 꾸미개로, 모양만 보고도 주인의 신분을 알 수 있다. 왕의 관식은 불꽃 모양이 화려하게 뻗어 나가고 좌우가 대칭이 아니다. 반면 왕비의 관식은 반듯한 좌우 대칭이다. 장식을 모자에 꽂는 부분은 합금으로 만들어 튼튼하게 했다고 한다. 백제의 금속 기술이 얼마나 앞서 있었는지 짐작할 수 있는 부분이다.
백제 금동대향로
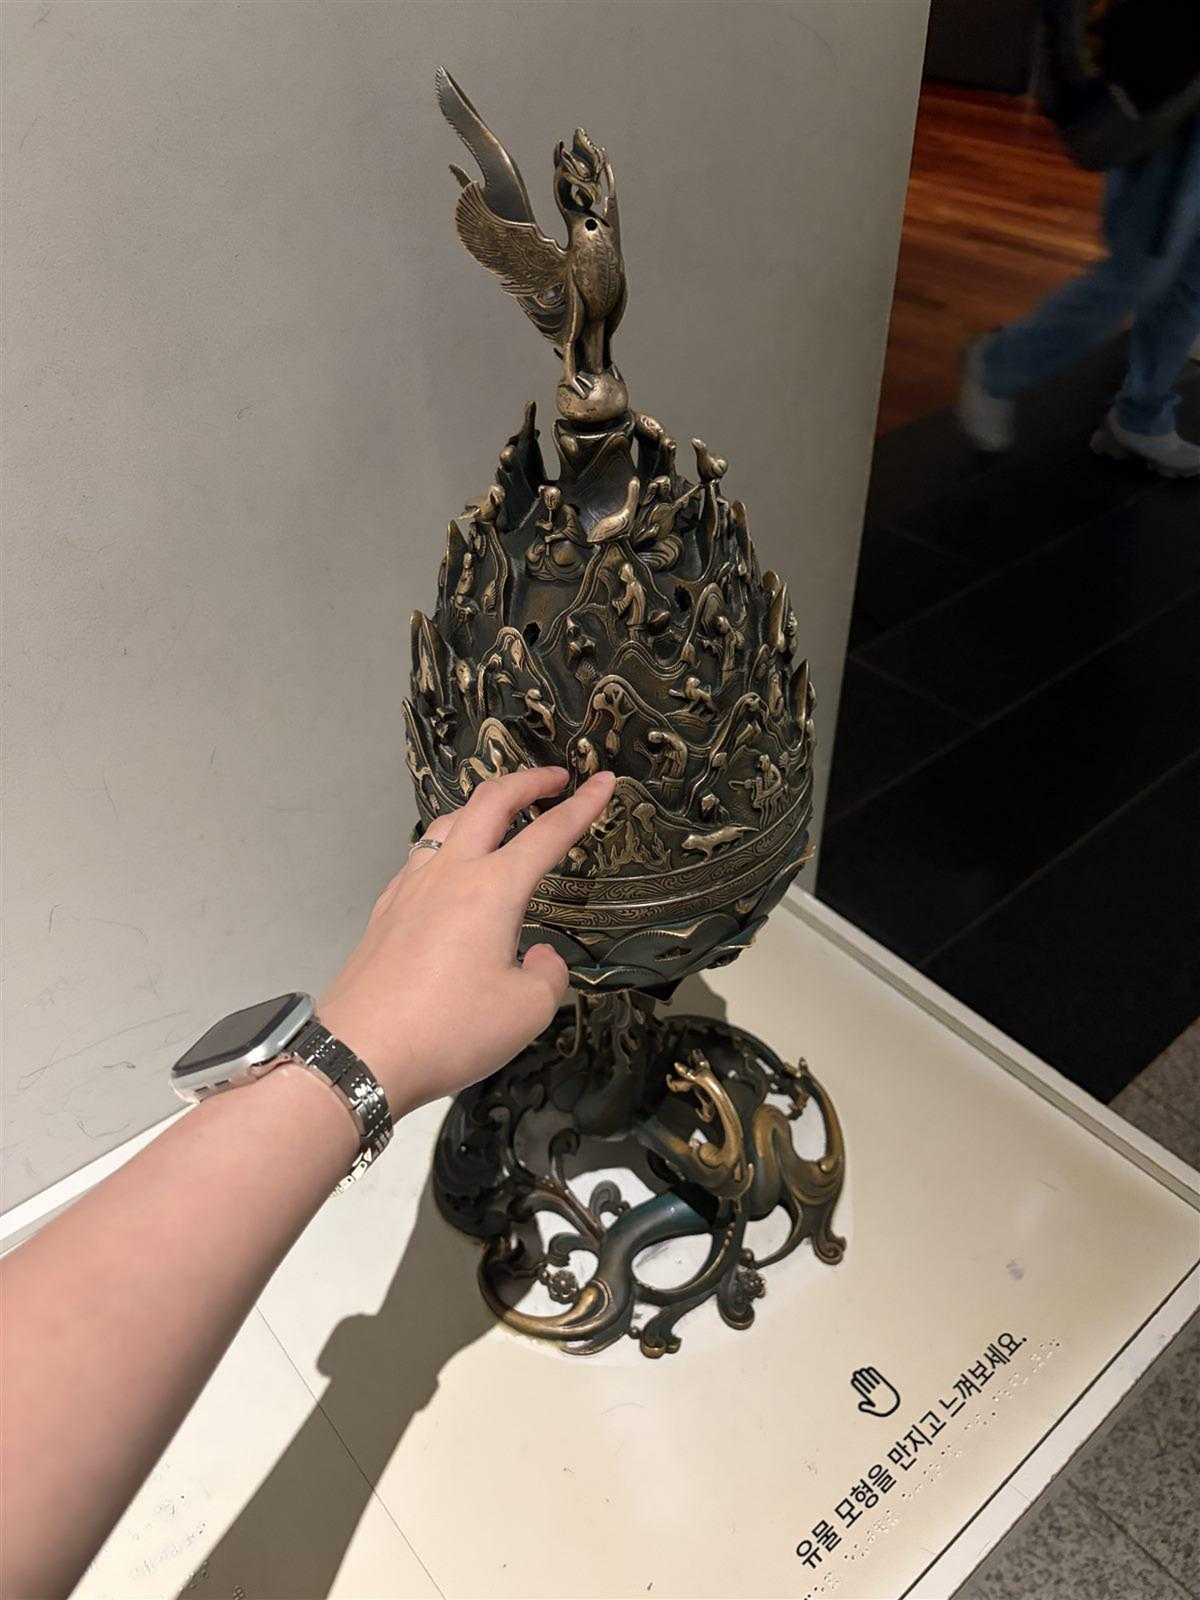
백제 금동대향로는 뚜껑 위 봉황부터 받침의 용까지, 신선이 사는 세상을 향로 하나에 담았다. 향을 피우면 12개의 구멍으로 연기가 피어올랐다. 산 사이사이에는 악기를 연주하는 신선 다섯 명이 숨어 있다. 연꽃 모양의 몸체에는 불교가, 신선 세계에는 도교가 담겨 있어 두 사상이 하나로 녹아든 작품으로 평가받는다. 전시실에는 직접 만져 볼 수 있는 모형이 있어 손끝으로 세밀한 조각을 느껴 볼 수 있었다.
가야와 신라의 금관
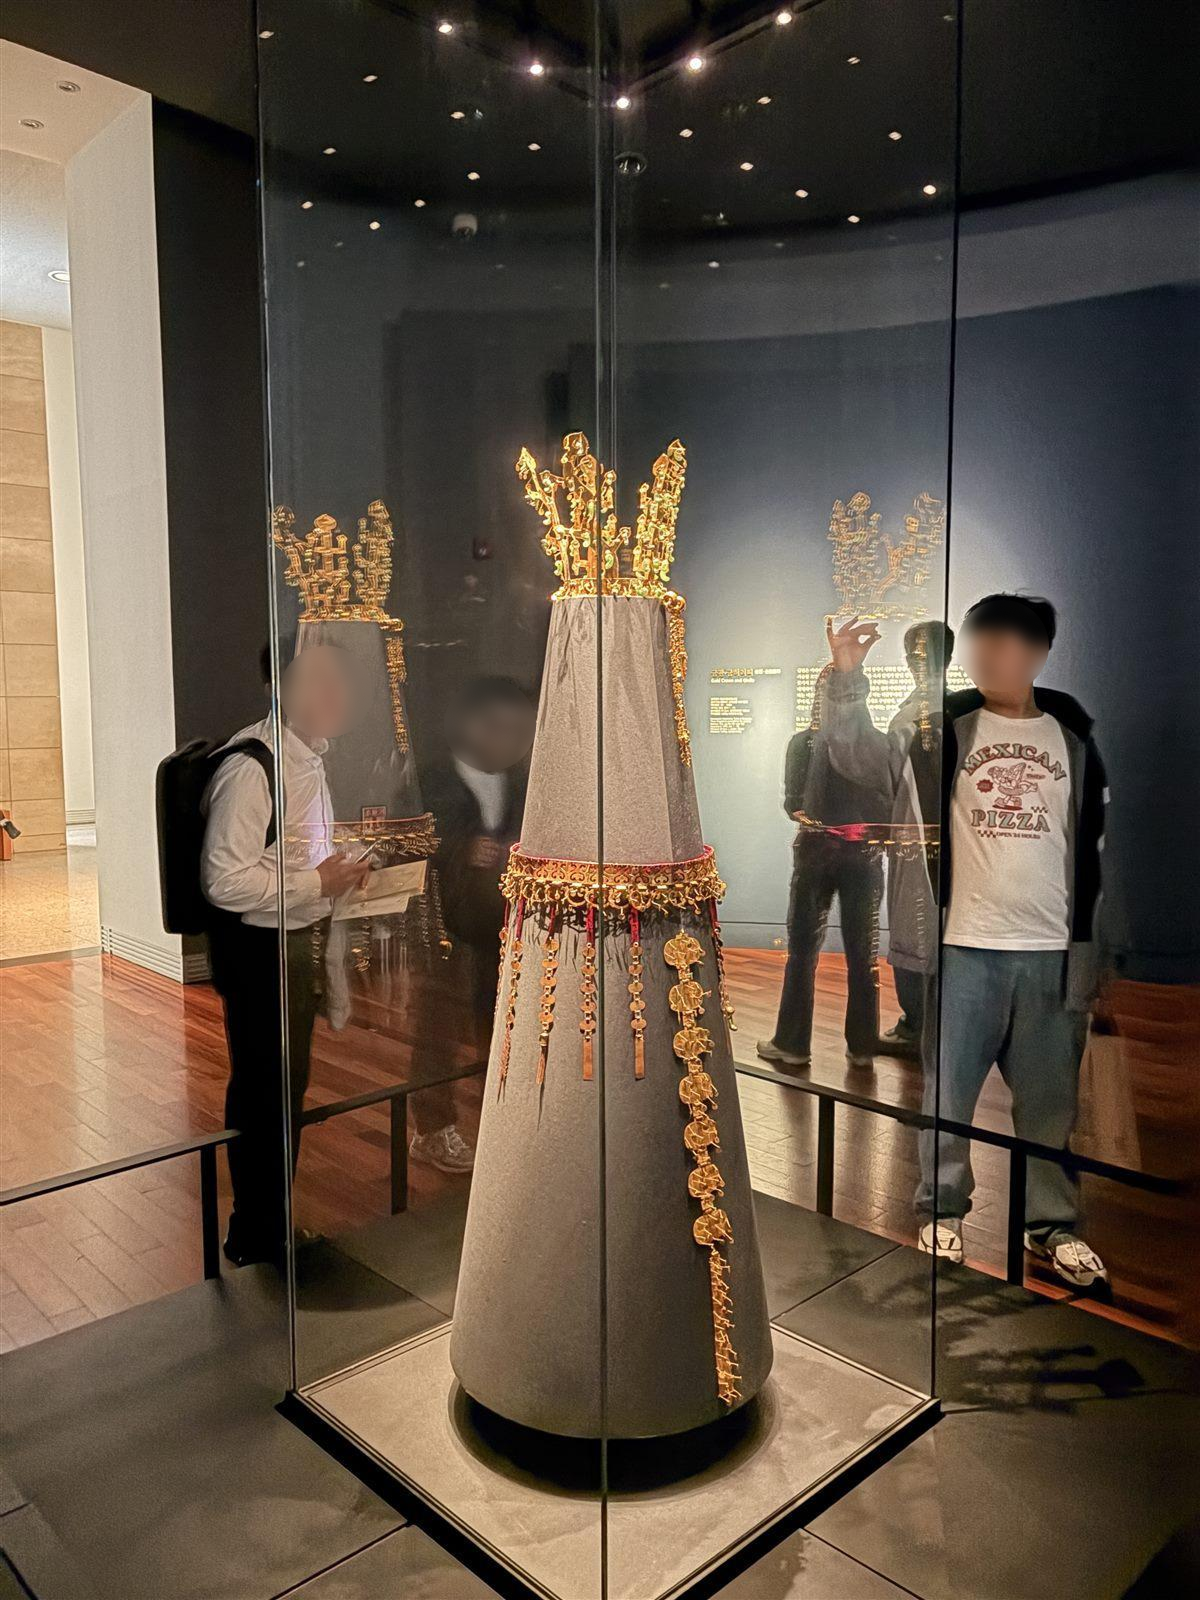
가야가 몇 나라로 이루어졌는지는 지금도 연구가 이어지고 있다. 경북 고령 일대에서는 대가야 무덤이 많이 발견됐다. 해설사님에 따르면 지금까지 출토된 고대 금관은 13점이며, 이 가운데 가야 금관이 2점, 신라 금관이 6점이다. ‘왕관’이 아니라 ‘금관’이라고 부르는 이유는 왕만 쓴 것이 아니기 때문이다. 실제로 신라 금관 중에는 여성의 것도 있다.
신라 금관은 나무에 열매가 달린 듯한 모양이다. 위로 솟은 사슴뿔 장식은 하늘과 땅을 잇는 메신저를 뜻한다. 굵은 고리 귀걸이(태환식 귀걸이)는 여성이 하던 장신구다. 일제강점기에는 고분에 번호를 붙여 관리했는데, ‘155호분’을 나중에 발굴해 보니 천마총이었다. 섬세한 금 공예를 보고 있으면 1,000년 가까이 이어진 신라 왕조의 저력이 느껴진다.
금빛 왕국들을 지나 ‘역사의 길’을 따라 걷다 보면, 저 끝에서 거대한 석탑 하나가 시야를 채운다.
‘역사의 길’ 끝에 선 국보 개성 경천사지 십층석탑
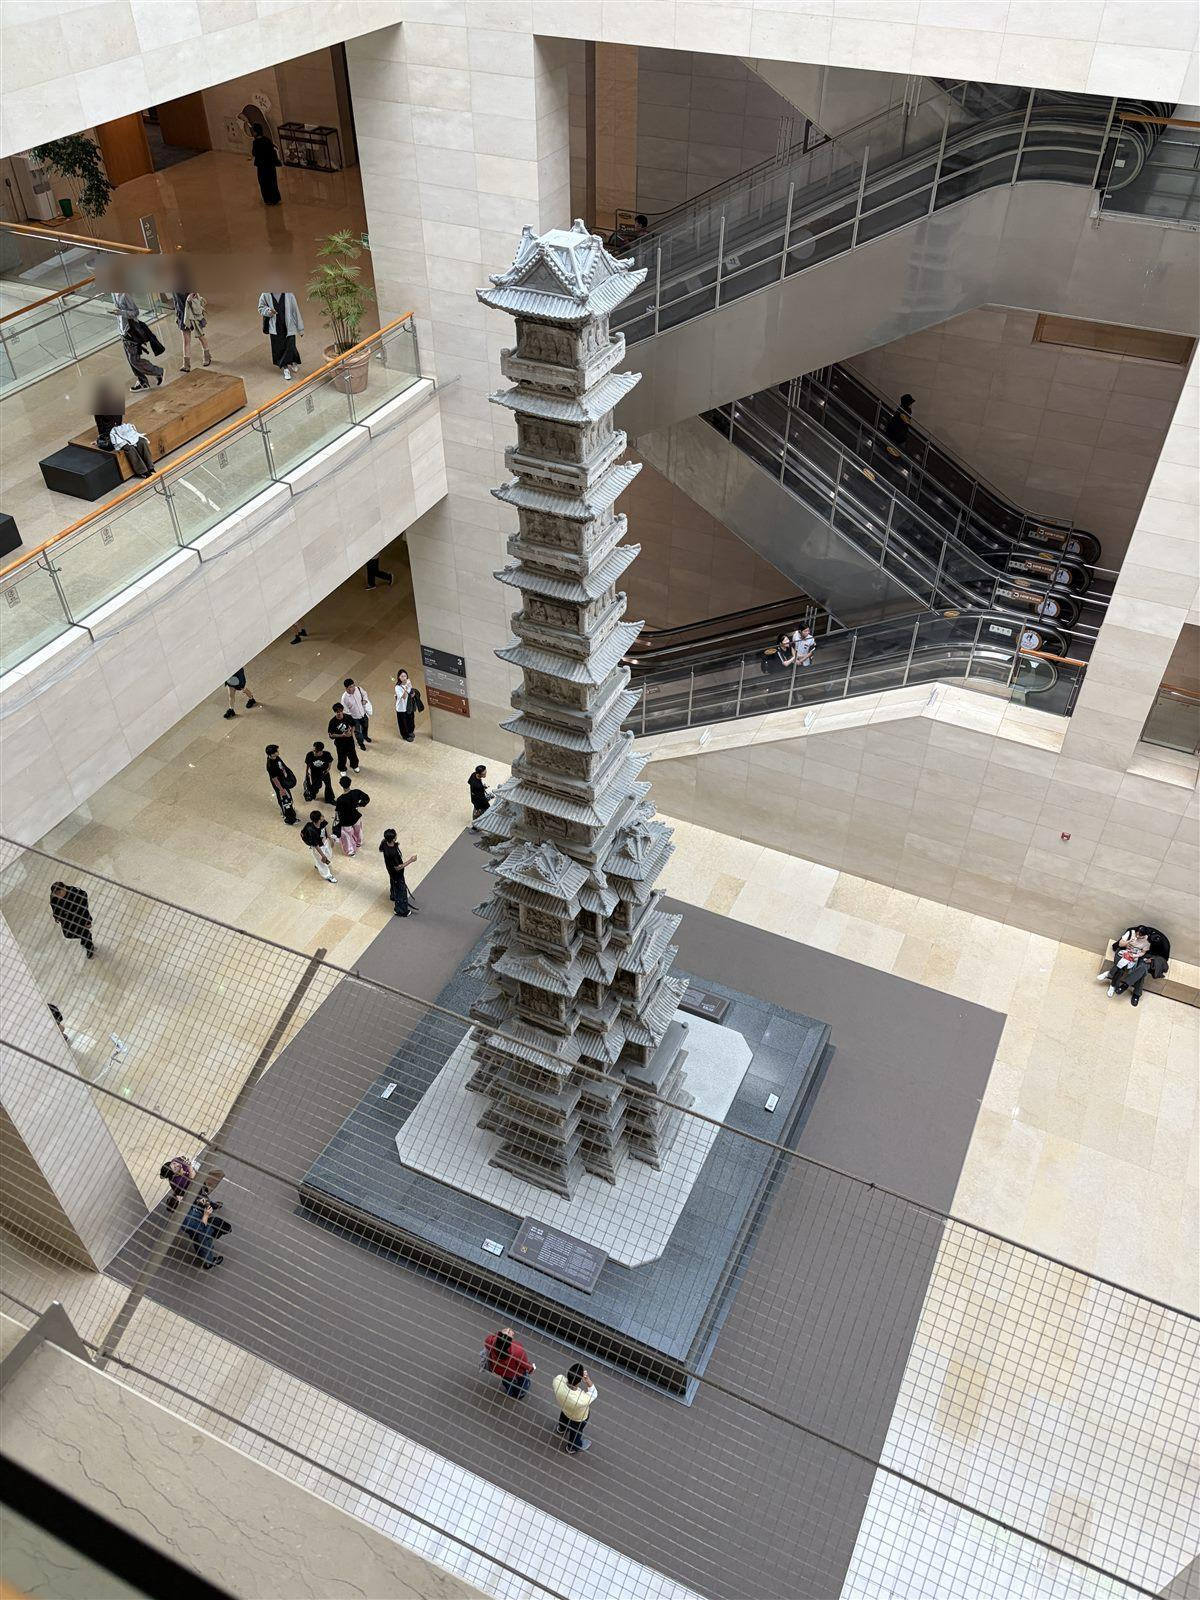
상설전시관 1층 ‘역사의 길’ 끝에는 높이 13m가 넘는 국보 개성 경천사지 십층석탑이 서 있다. 탑은 부처님의 사리를 모시는 ‘부처님의 집’이다. 우리나라에서는 신라의 3층, 고구려의 5층처럼 홀수 층 탑이 유행했다. 그런데 이 탑은 10층이다. 탑이 세워진 1348년은 고려가 원나라의 간섭을 받던 시기로, 원에서는 10을 완성된 숫자로 여겼다. 우리 문화와 원나라 문화가 만나 탄생한 탑인 셈이다. 탑에는 누가, 왜 세웠는지도 새겨져 있다.
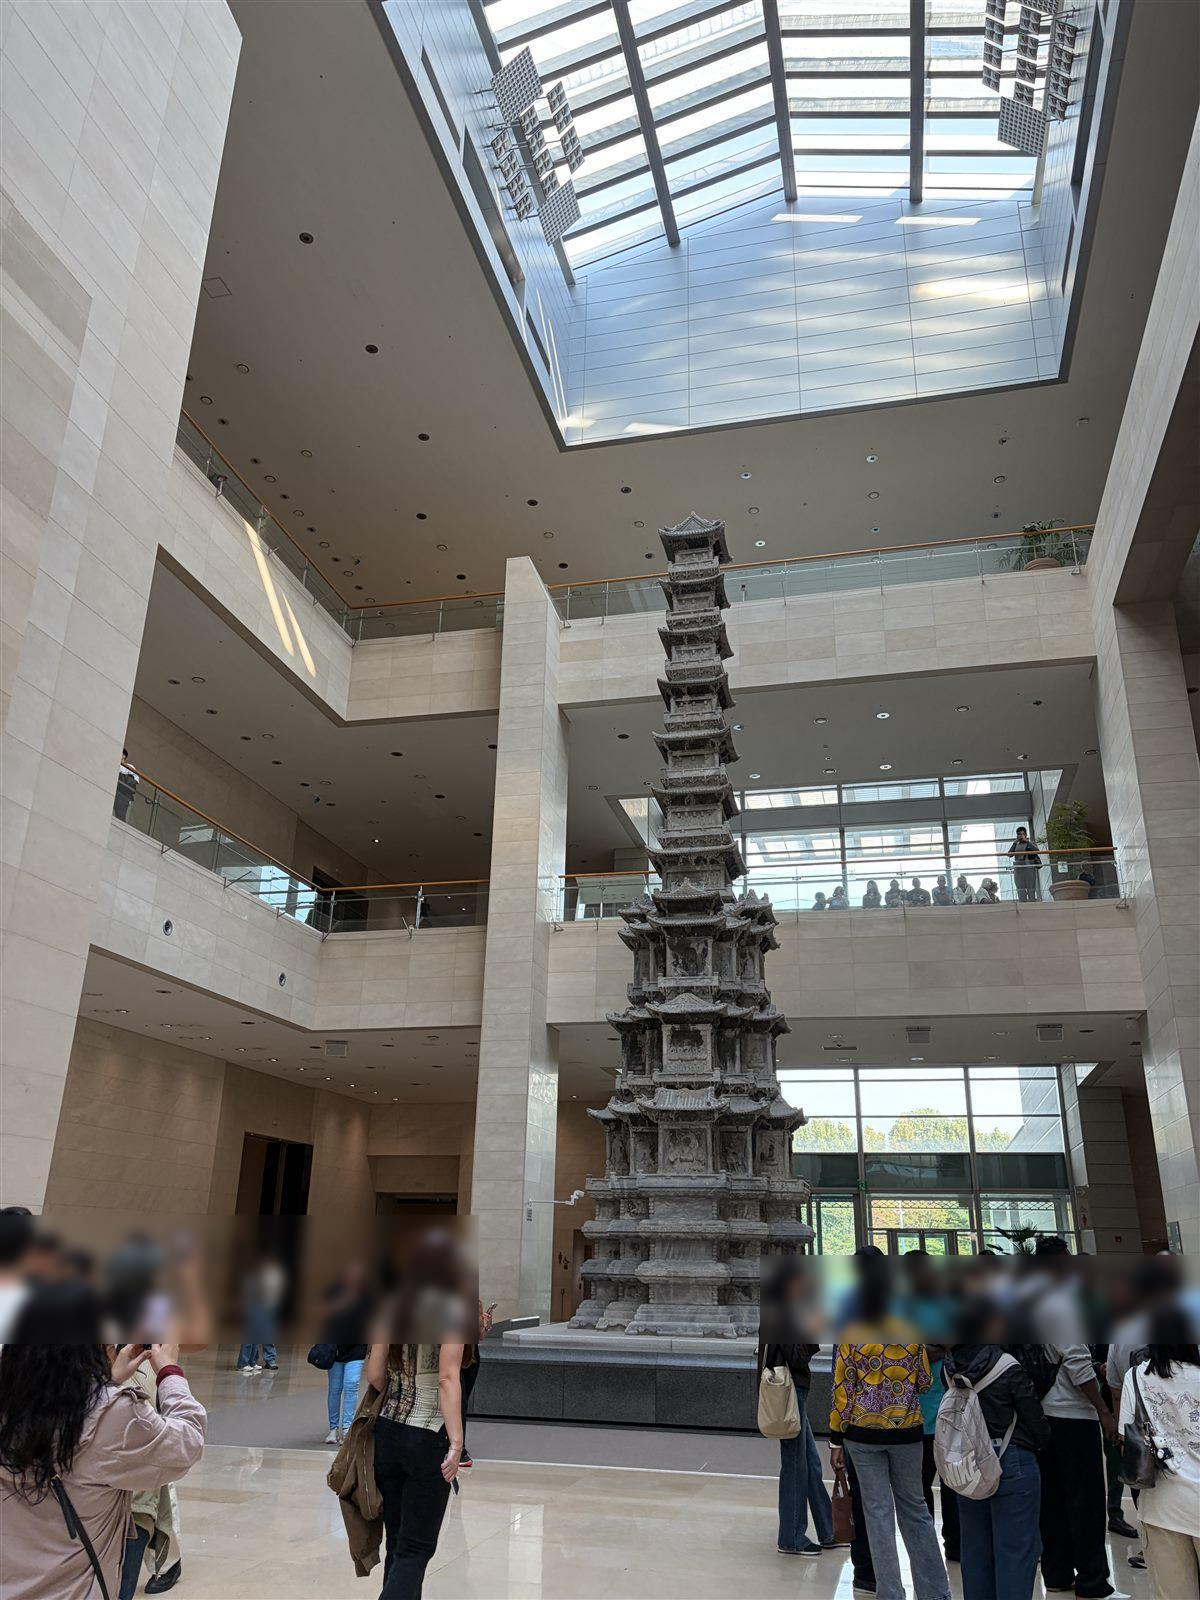
재료도 남다르다. 우리 전통 탑은 대부분 화강암으로 만들었는데, 화강암은 단단해서 섬세하게 조각하기 어렵다. 개성 경천사지 십층석탑은 대리석으로 만들어 층마다 법회 장면 같은 이야기를 정교하게 새길 수 있었다. 4층부터 10층까지는 보살들이 자리한다. 서울 탑골공원에 있는 국보 서울 원각사지 십층석탑이 바로 이 탑을 본떠 만든 것이다.
석탑을 올려다본 뒤에는 3층으로 올라가 고려와 조선의 그릇을 만났다.
비색청자와 달항아리, 그릇에 담긴 미감
3층 청자실과 백자실은 일부 전시실 리뉴얼 공사 중에도 관람할 수 있었다. 3층은 내년 1월 재개관을 앞두고 있다.
비색청자
12세기는 장식 없이 빛깔만으로 승부한 순청자가 절정에 이른 시기다. 고려청자의 ‘비색’은 비취옥 빛깔이라는 뜻으로, 중국 청자와는 확연히 다른 색이다. 당시 중국에서도 고려 비색청자를 으뜸으로 꼽았다. 반면 일본에는 청자 문화가 없었다고 한다. 고려 장인들은 뾰족한 칼로 문양을 새기고 그 자리에 다른 흙을 메워 넣는 상감 기법도 썼다.
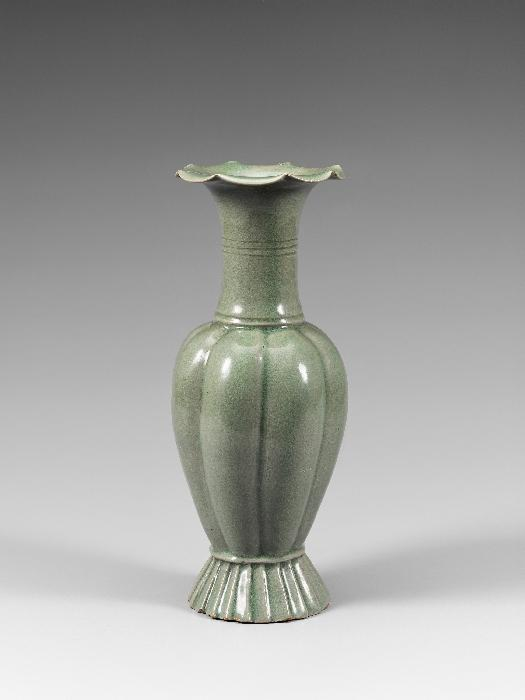
출처: 국립중앙박물관 소장품 검색(공공누리 제1유형)
동물이나 식물 모양을 본뜬 ‘상형청자’도 볼거리다. 국보 청자 사자형뚜껑 향로는 향을 피우면 사자의 입으로 연기가 빠져나가는 것으로 유명하다. 국보 청자 투각칠보문뚜껑 향로는 받침을 떠받친 토끼들의 눈까지 콕 찍어 표현했다. 해설사님은 두 향로를 상형청자의 대표작으로 꼽았다.
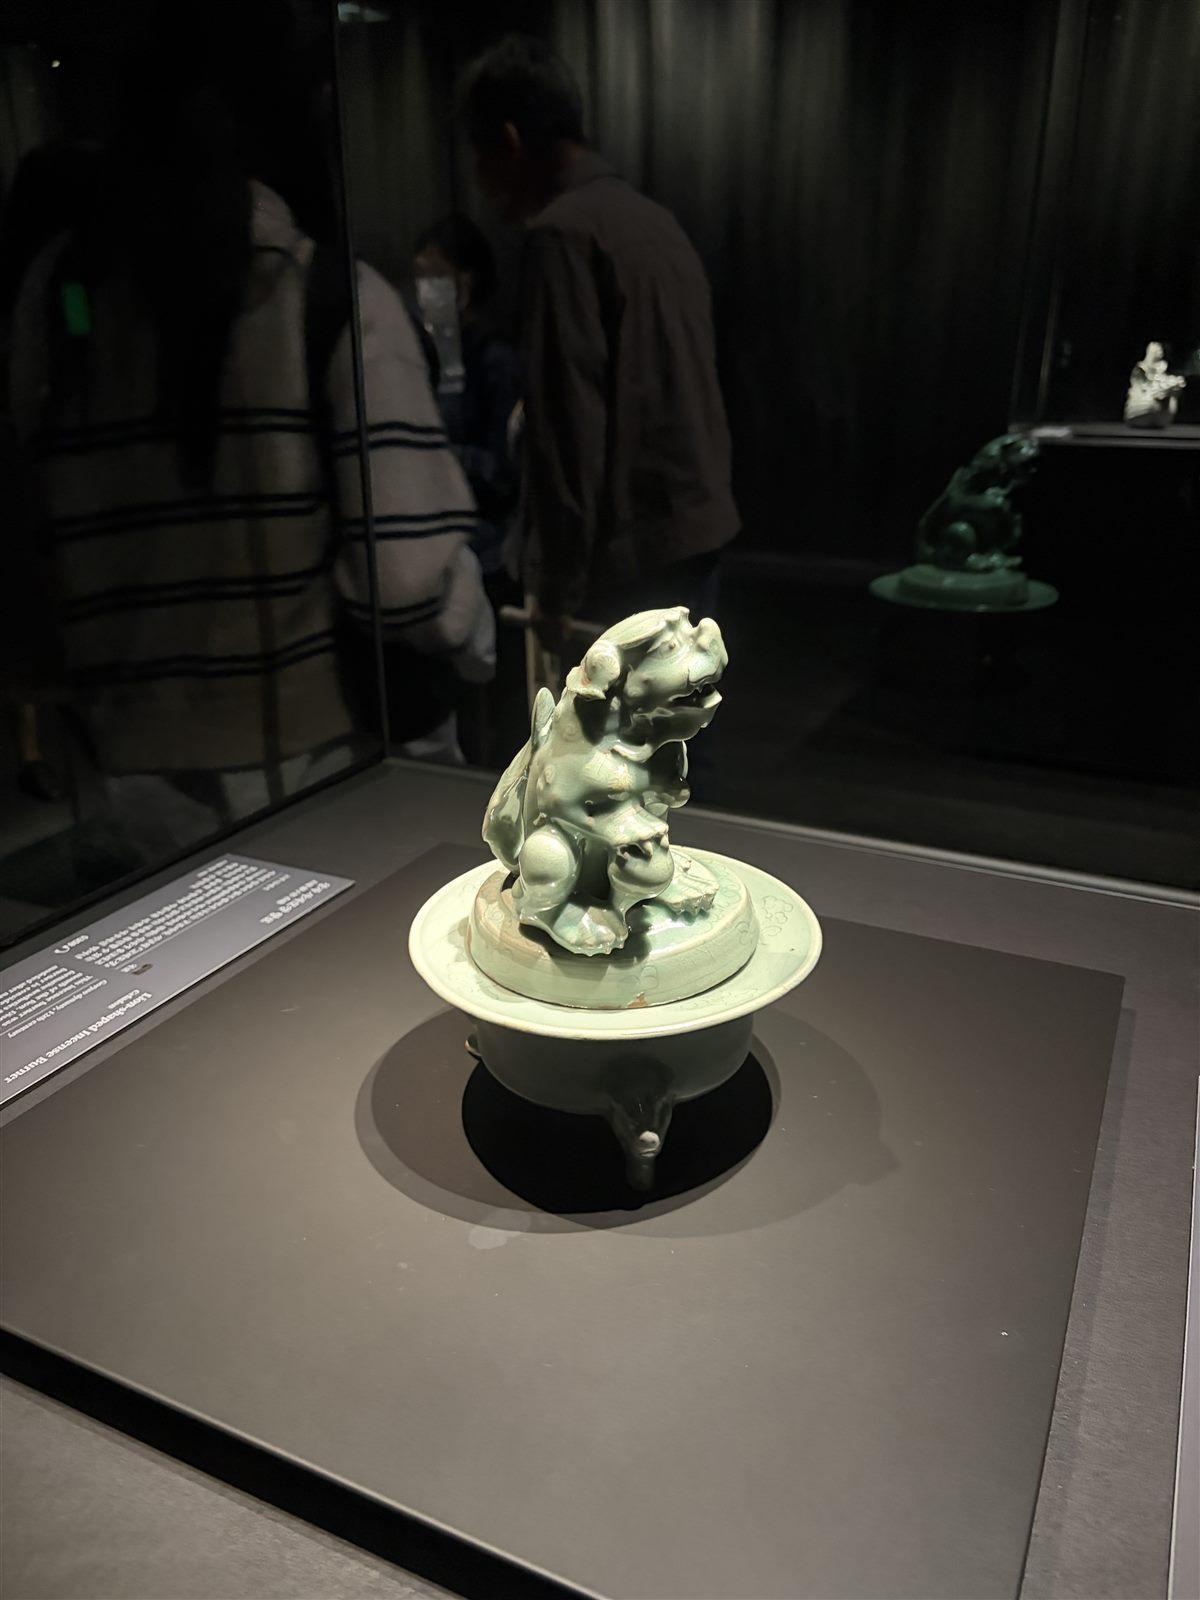
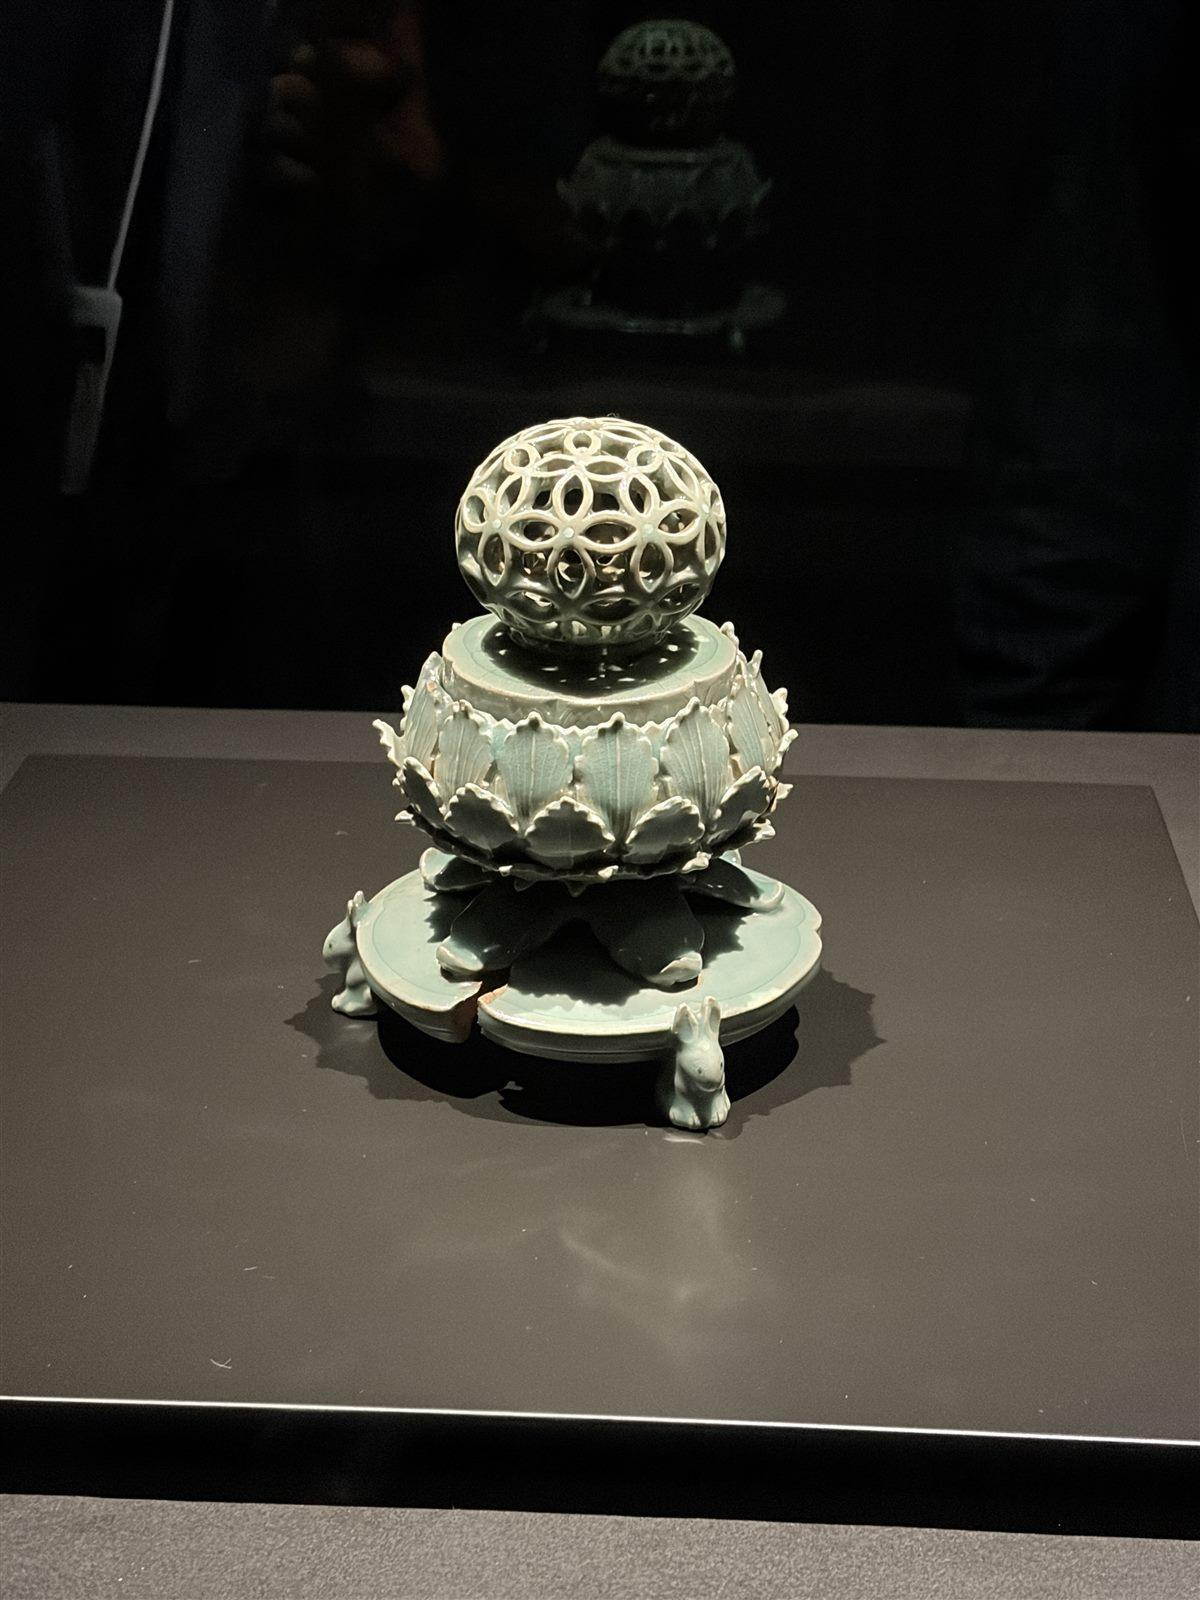
달항아리
백자 큰 항아리가 보름달을 닮았다고 해서 달항아리라는 이름이 붙었다고 한다. 달항아리는 한 번에 빚기 어려울 만큼 커서, 큰 대접 두 개를 만들어 이어 붙인다. 그래서인지 어딘가 반듯하지 않은 자연스러운 뒤틀림이 있었다. 가마에서 구울 때 흙이 수축하면서 모양이 조금씩 어그러지기 때문에 똑같이 생긴 달항아리는 하나도 없다. 선도 반듯하지 않고 색도 순백이 아닌 그 모습이 우리 정서를 닮았다고 한다. 요즘 유행하는 반듯한 기성품 달항아리와는 전혀 다른 느낌이라 조금 놀랐다.
받침보다 입구가 넓어 바닥에서 살짝 떠 있는 듯 보이니 더욱 달처럼 느껴졌다.
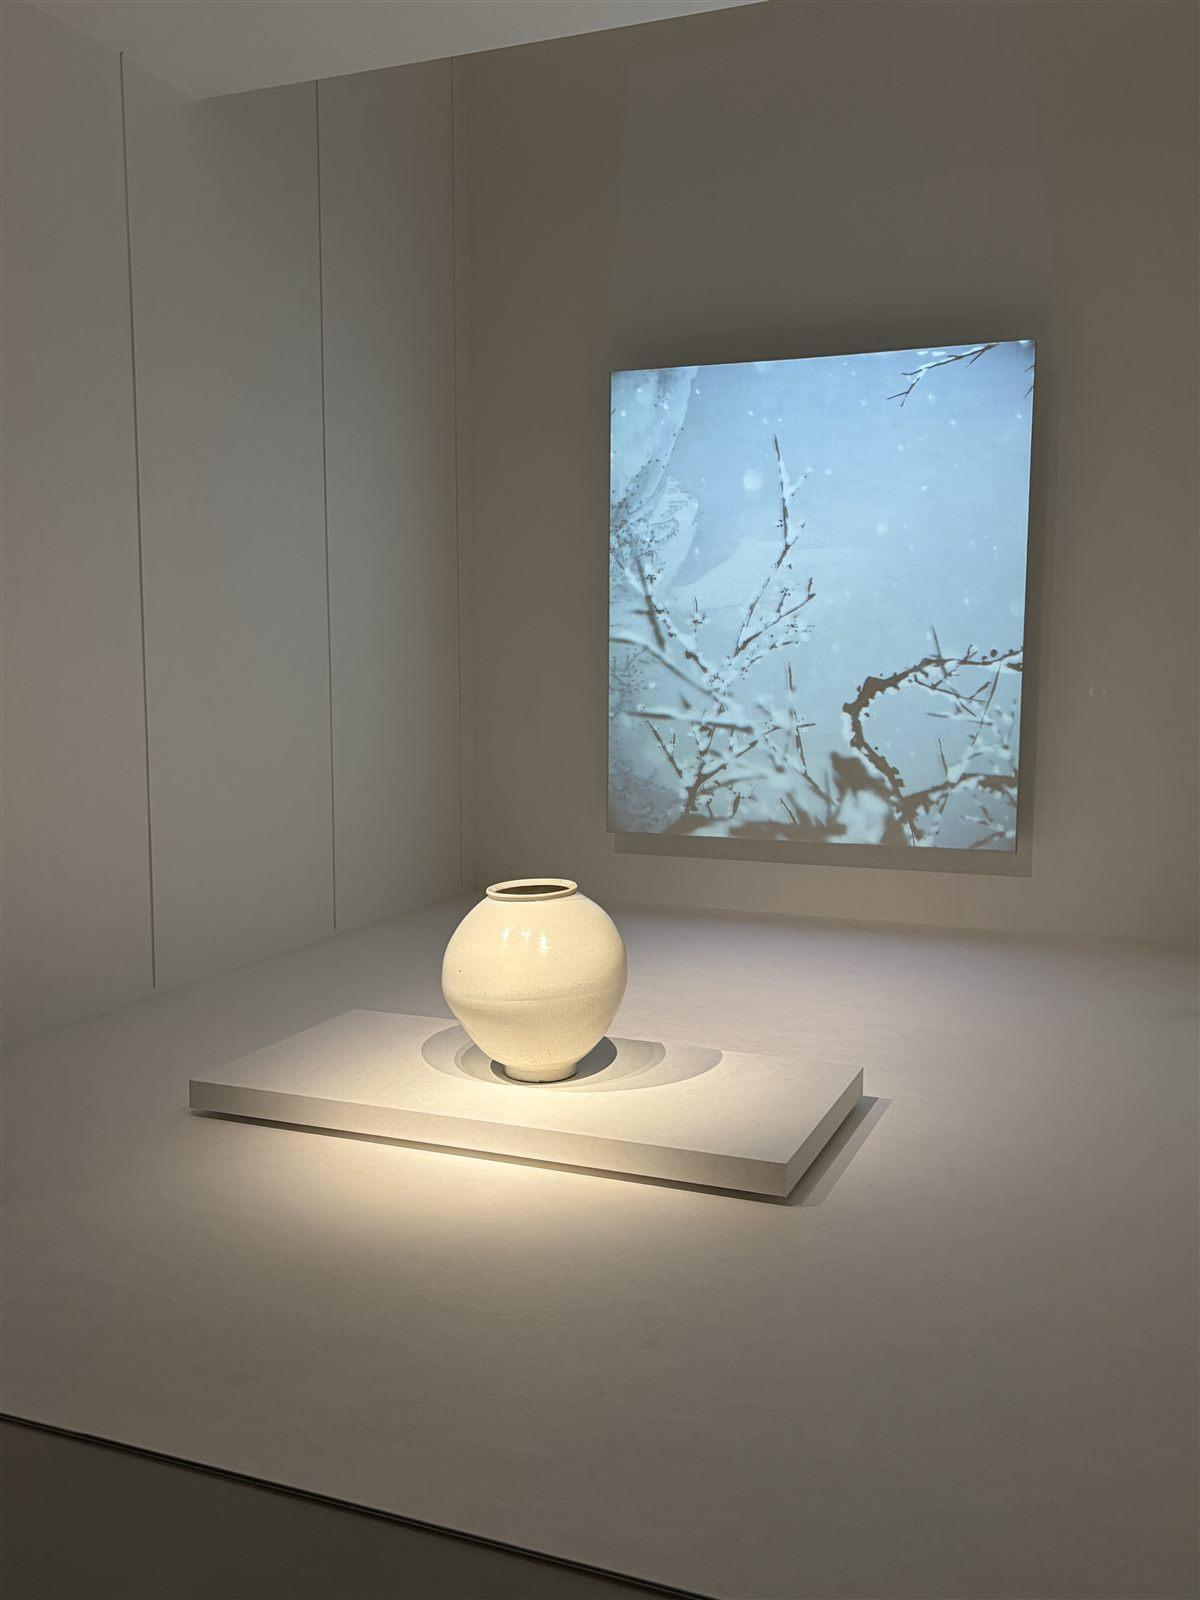
달항아리 전시실에도 직접 만져 볼 수 있는 촉각 체험 공간이 있다. 손바닥에 닿는 매끈하면서도 비정형적인 둥근 곡선이 신기했다.
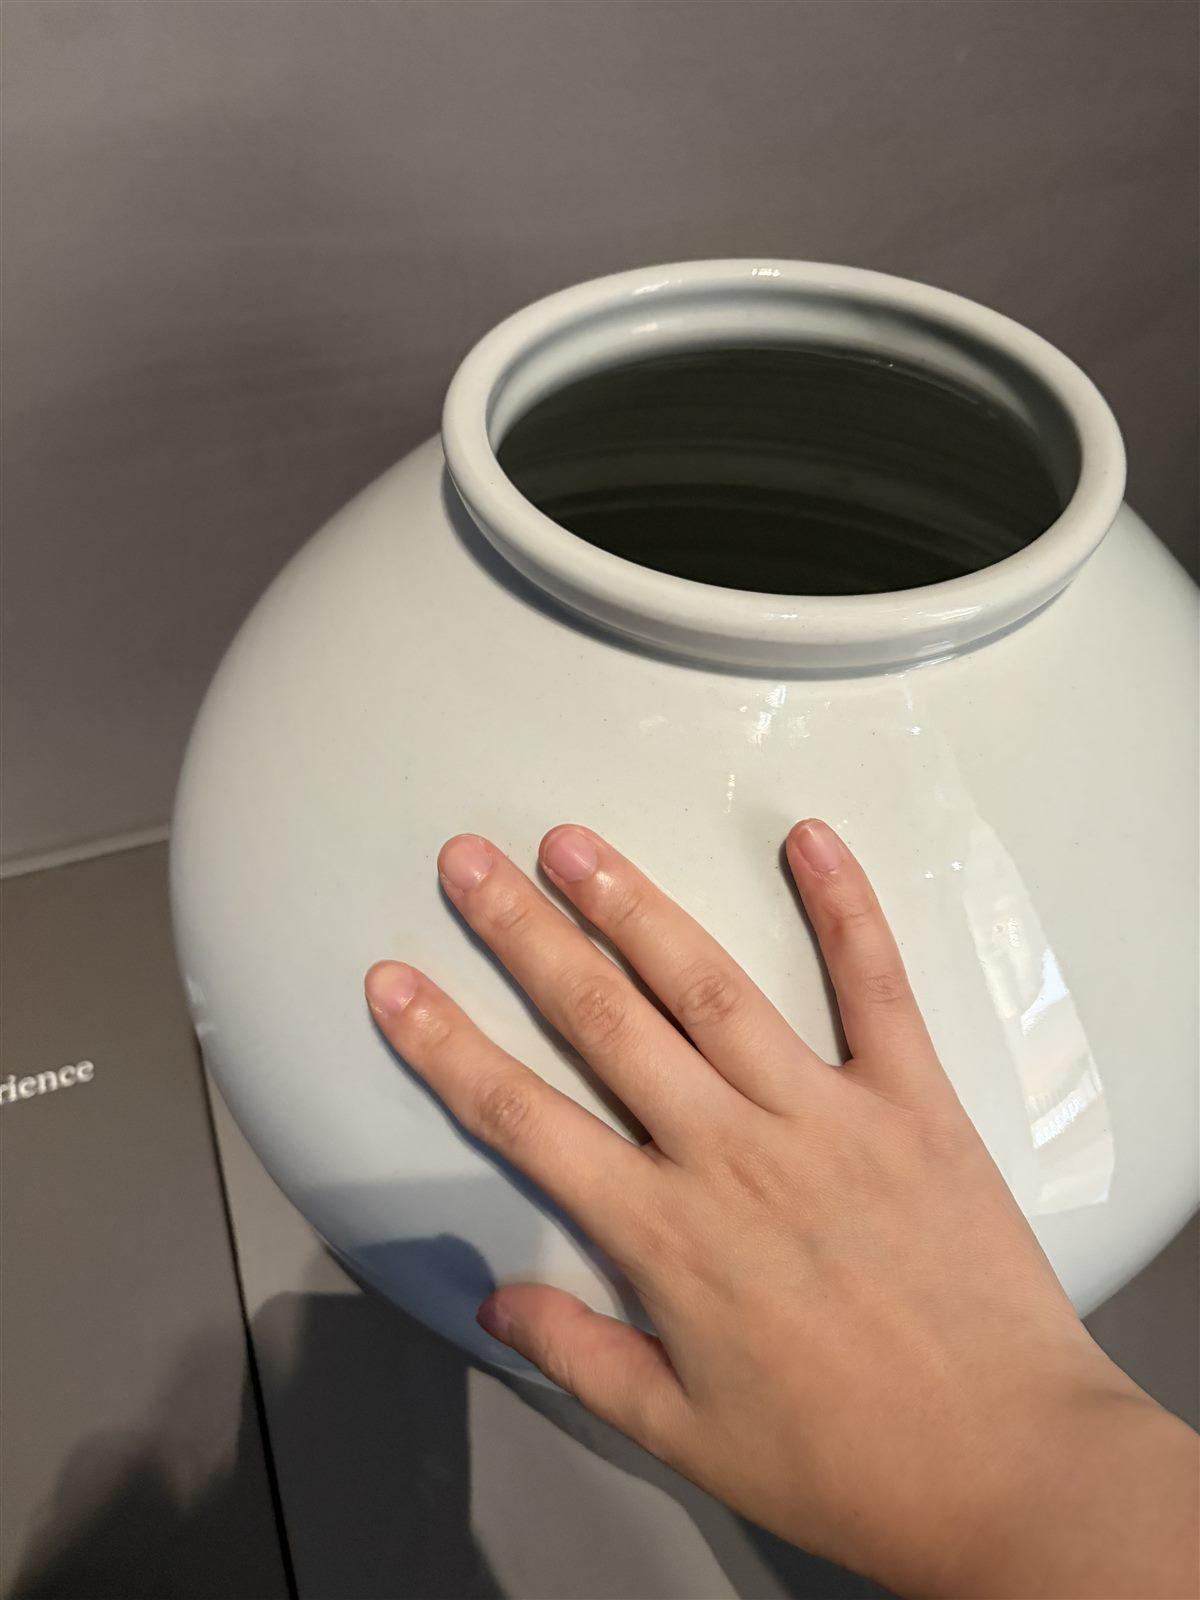
달항아리의 곡선을 손으로 더듬고 나니 투어는 어느덧 마지막 장소를 향하고 있었다.
몰입의 끝, ‘사유의 방’
대표유물해설의 마지막 장소는 2층 ‘사유의 방’이었다. 이곳에서는 해설사님이 함께 들어가지 않고 입구 앞에서 설명을 마친다. 관람객이 오롯이 혼자 작품과 마주하도록 하기 위해서다. 사유의 방은 다른 나라에는 없는 우리 문화재만의 방을 만들겠다는 목적으로 기획됐다. 2021년 문을 연 사유의 방을 꾸미는 데에는 청자정 기와를 기증한 YFM도 힘을 보탰다.
방 안에는 국보 금동미륵보살반가사유상 두 점이 나란히 놓여 있다. 반가사유상은 한쪽 다리만 올려 반만 가부좌를 튼 자세로 깊은 생각에 잠긴 모습이다. 다른 나라에도 반가사유상이 있지만 대부분 돌로 만든 부조상이다. 해설사님은 청동으로 만든 입체상이라는 점을 우리 반가사유상의 특징으로 꼽았다. 불교에서는 깨달은 사람이 모두 부처라고 하는데, 반가사유상은 생로병사에서 벗어날 방법을 고민하는 모습이다. 미래에 올 구원자인 미륵을 표현했다고 보기도 하며, 삼국이 한강 유역을 두고 다투던 6~7세기에는 신라의 화랑을 미륵에 빗대기도 했다.
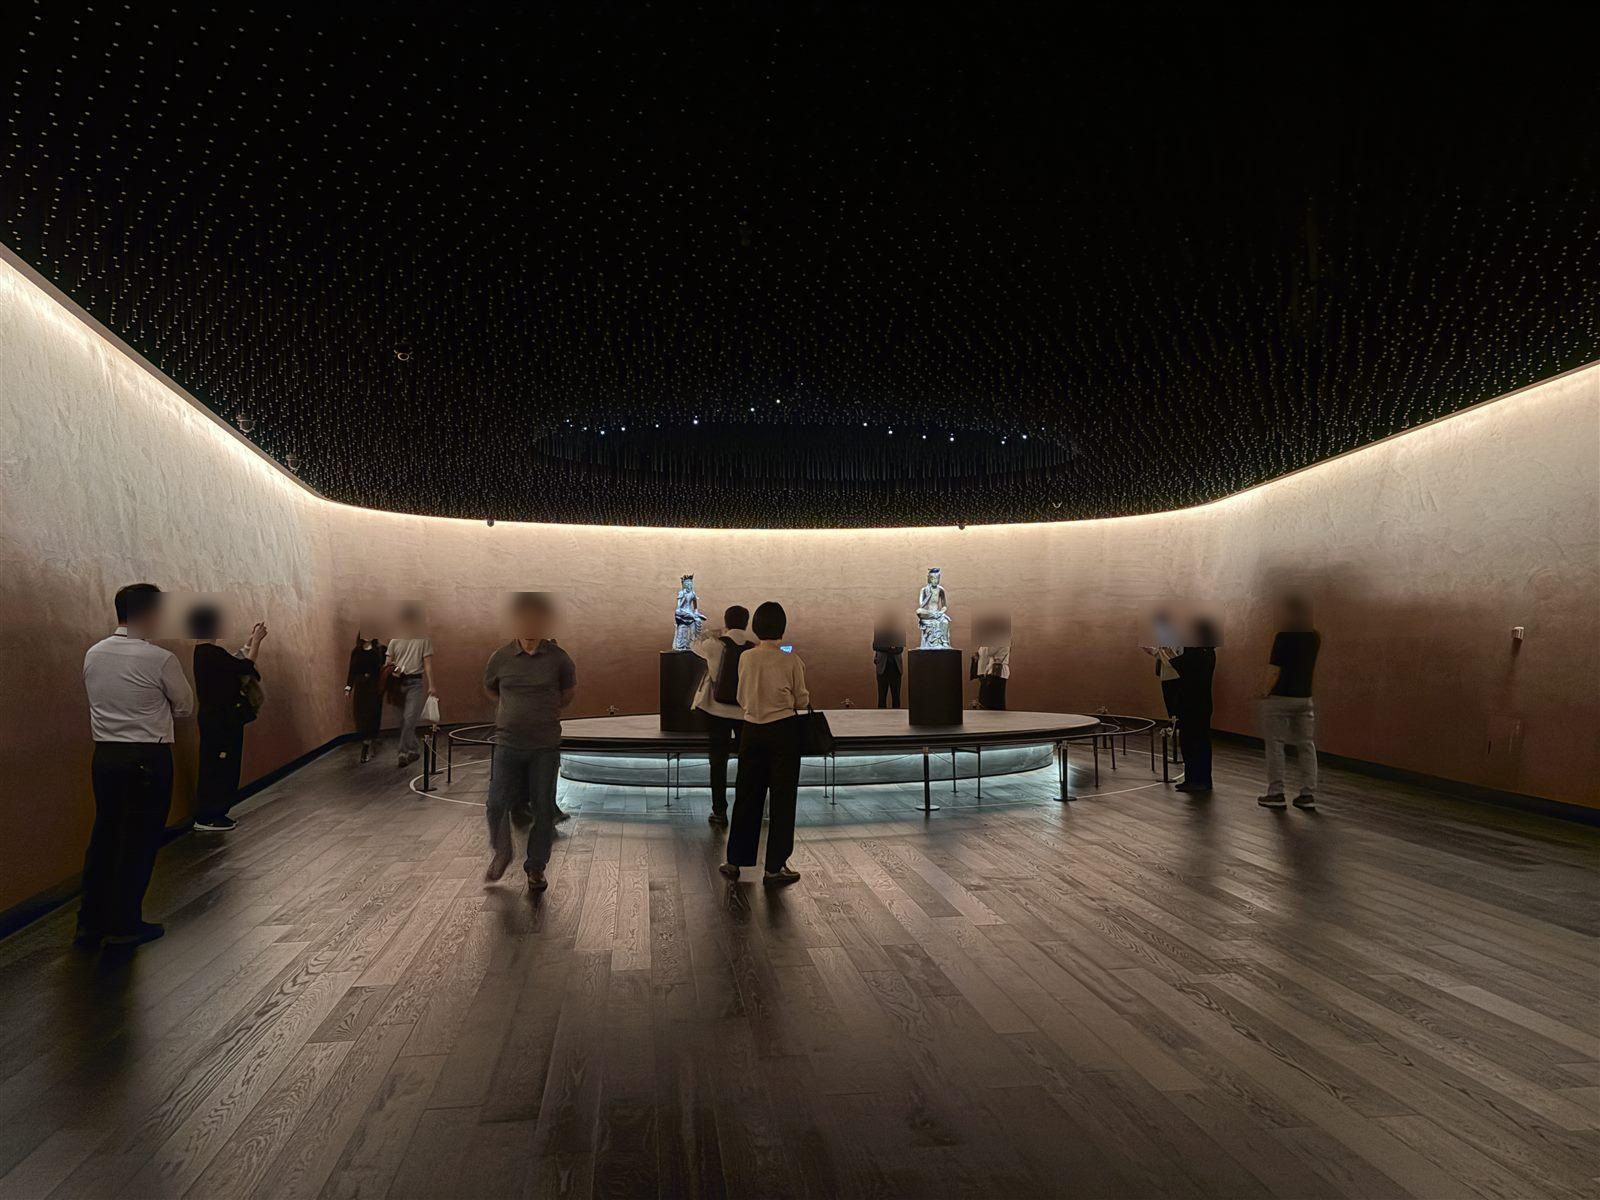
두 불상은 약 50년의 시차를 두고 만들어졌다. 한 점은 장식이 화려하고 복잡하고, 다른 한 점은 단순하고 절제되어 있다. 머리에 쓴 관으로 두 불상을 구분해 보기도 하지만, 어느 나라에서 만들었는지는 아직 정확히 알기 어렵다.
해설사님이 꼭 보고 가라고 당부한 것은 입가의 미소였다. 볼에 살짝 닿은 손가락의 각도, 바닥을 지그시 누른 발가락의 힘까지 보고 나면 뒤편의 광배가 만들어 내는 아우라도 다르게 느껴진다.
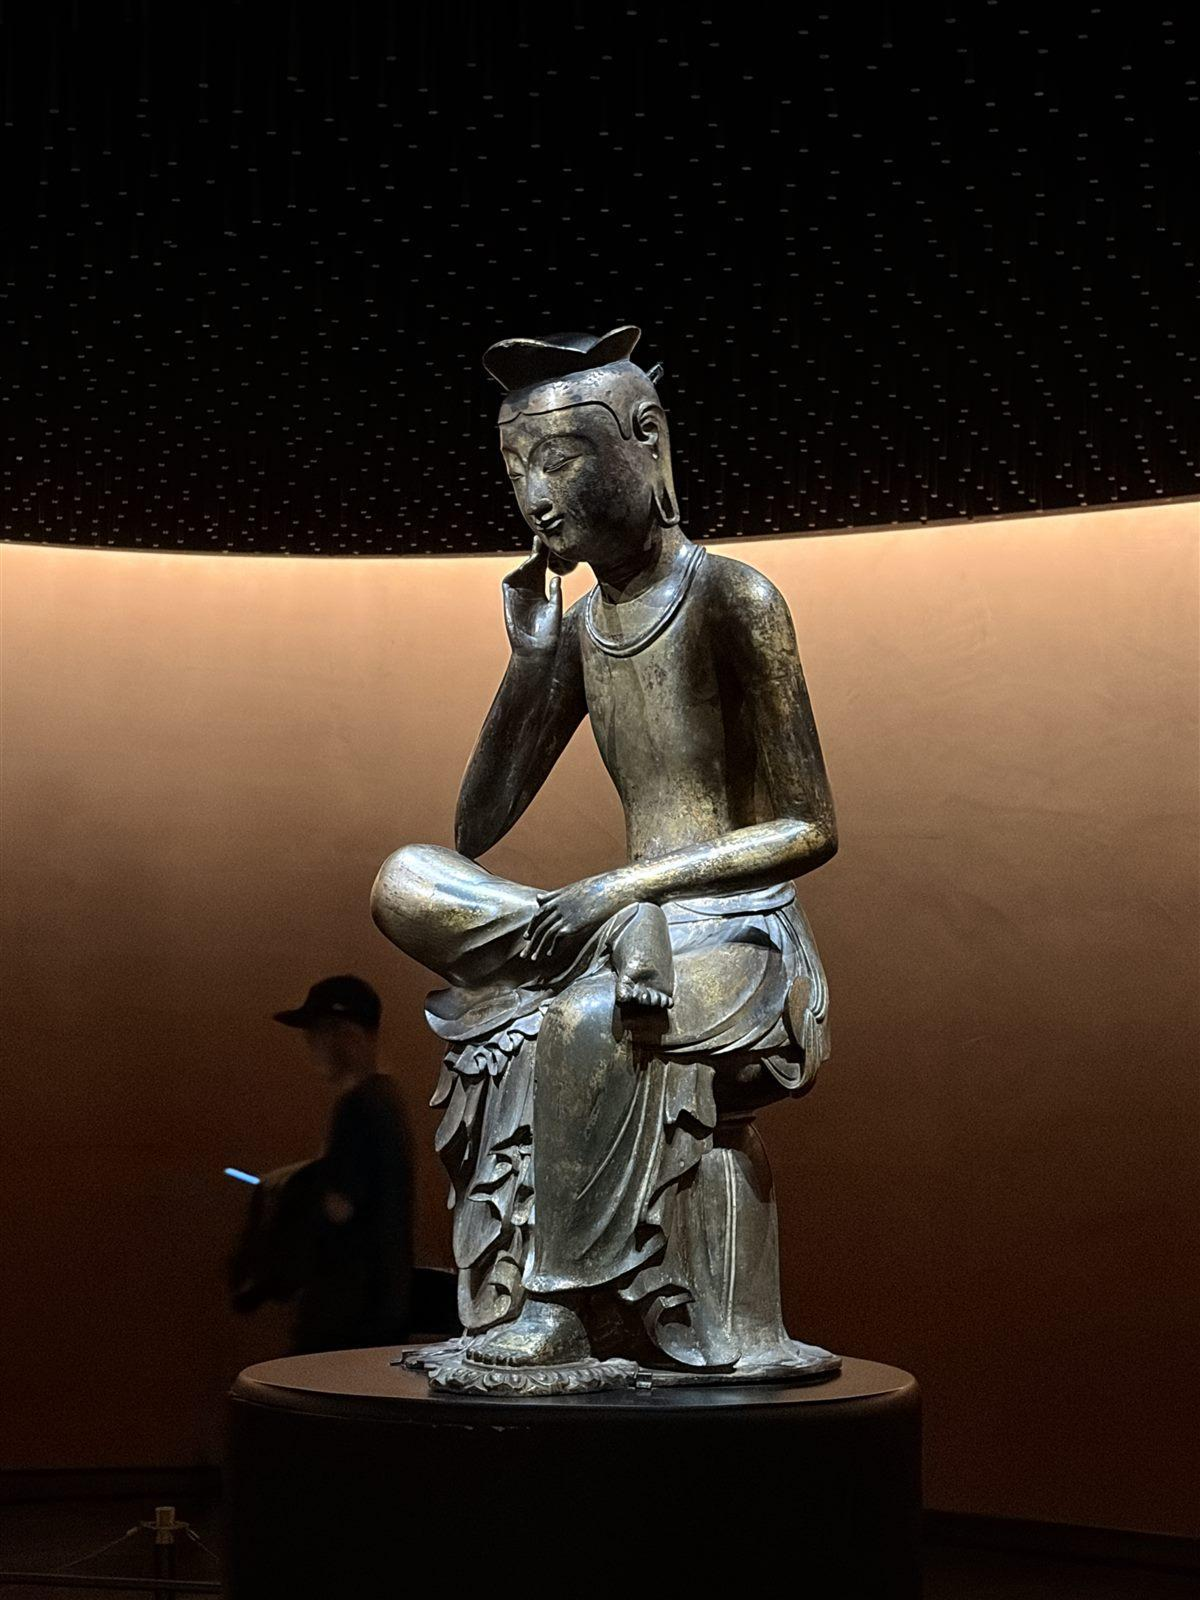
“우리 조상이 저 앞에서 기도했을 마음을 알고 바라보면, 유물이 나에게 다가올 겁니다.”
– 국립중앙박물관 정기해설 해설사 –
외규장각 의궤실 ‘왕의 서고’
사유의 방 맞은편에는 외규장각 의궤 전용 전시실 ‘왕의 서고, 어진 세상을 꿈꾸다’가 있다. ‘의식의 궤범’이라는 뜻의 의궤는 왕실 행사를 글과 그림으로 꼼꼼히 남긴 기록이다. 외규장각 의궤는 1866년 병인양요 때 프랑스로 반출됐다가 145년 만인 2011년 고국으로 돌아왔다.
2024년 11월 문을 연 의궤 전용 전시실도 (사)국립중앙박물관회와 YFM의 지원으로 조성됐다. 개관 당시 YFM 위원장으로 축사를 전한 송병준 의장은 의궤실이 사유의 방과 함께 박물관을 대표하는 공간이 되기를 바랐다.
“지난 2021년에 개관한 반가사유상 전시실 ‘사유의 방’과 함께 박물관을 대표하는 전시 공간으로, 우리 문화의 깊이와 가치를 전하는 중요한 역할을 해주기를 기대합니다.”
– 송병준 컴투스 의장(당시 국립중앙박물관회 YFM 위원장), 2024년 ‘왕의 서고’ 개관 축사 중 –
사유의 방에서 반가사유상과 마주한 뒤 의궤실까지 이어서 둘러보면, 우리 기록문화의 정수를 함께 만날 수 있다.
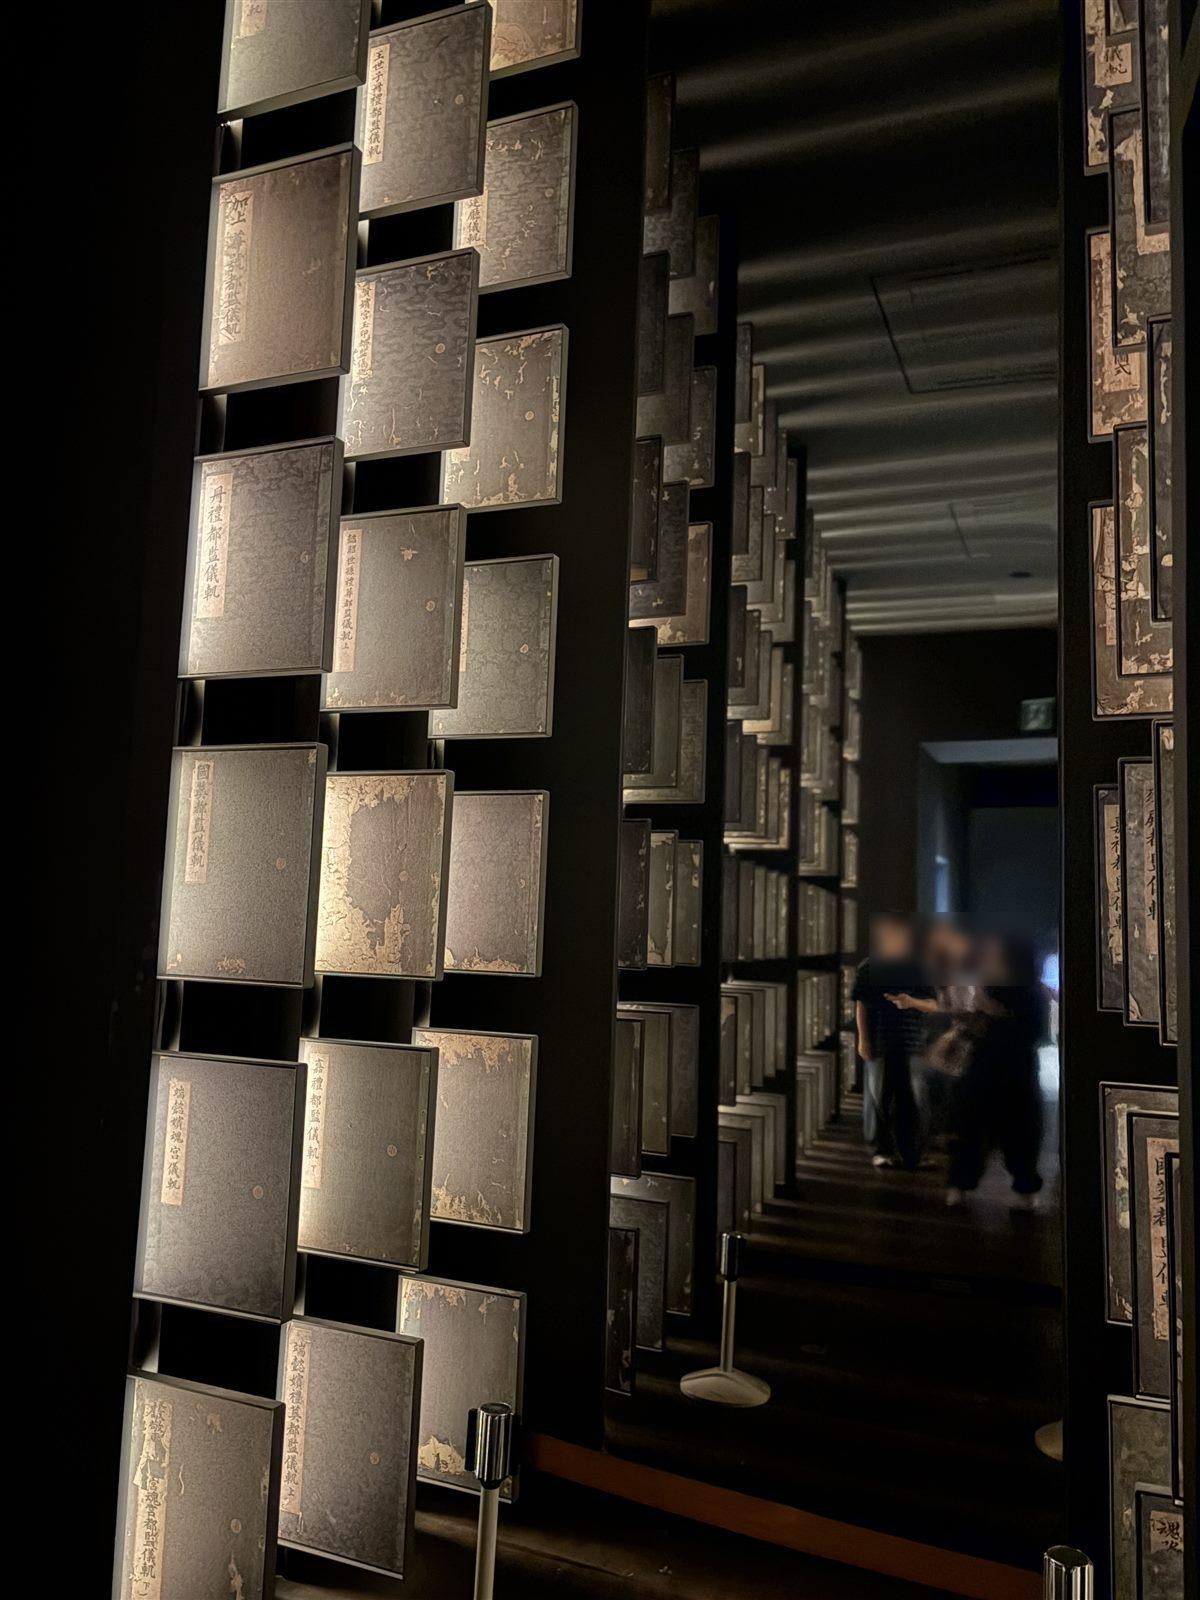
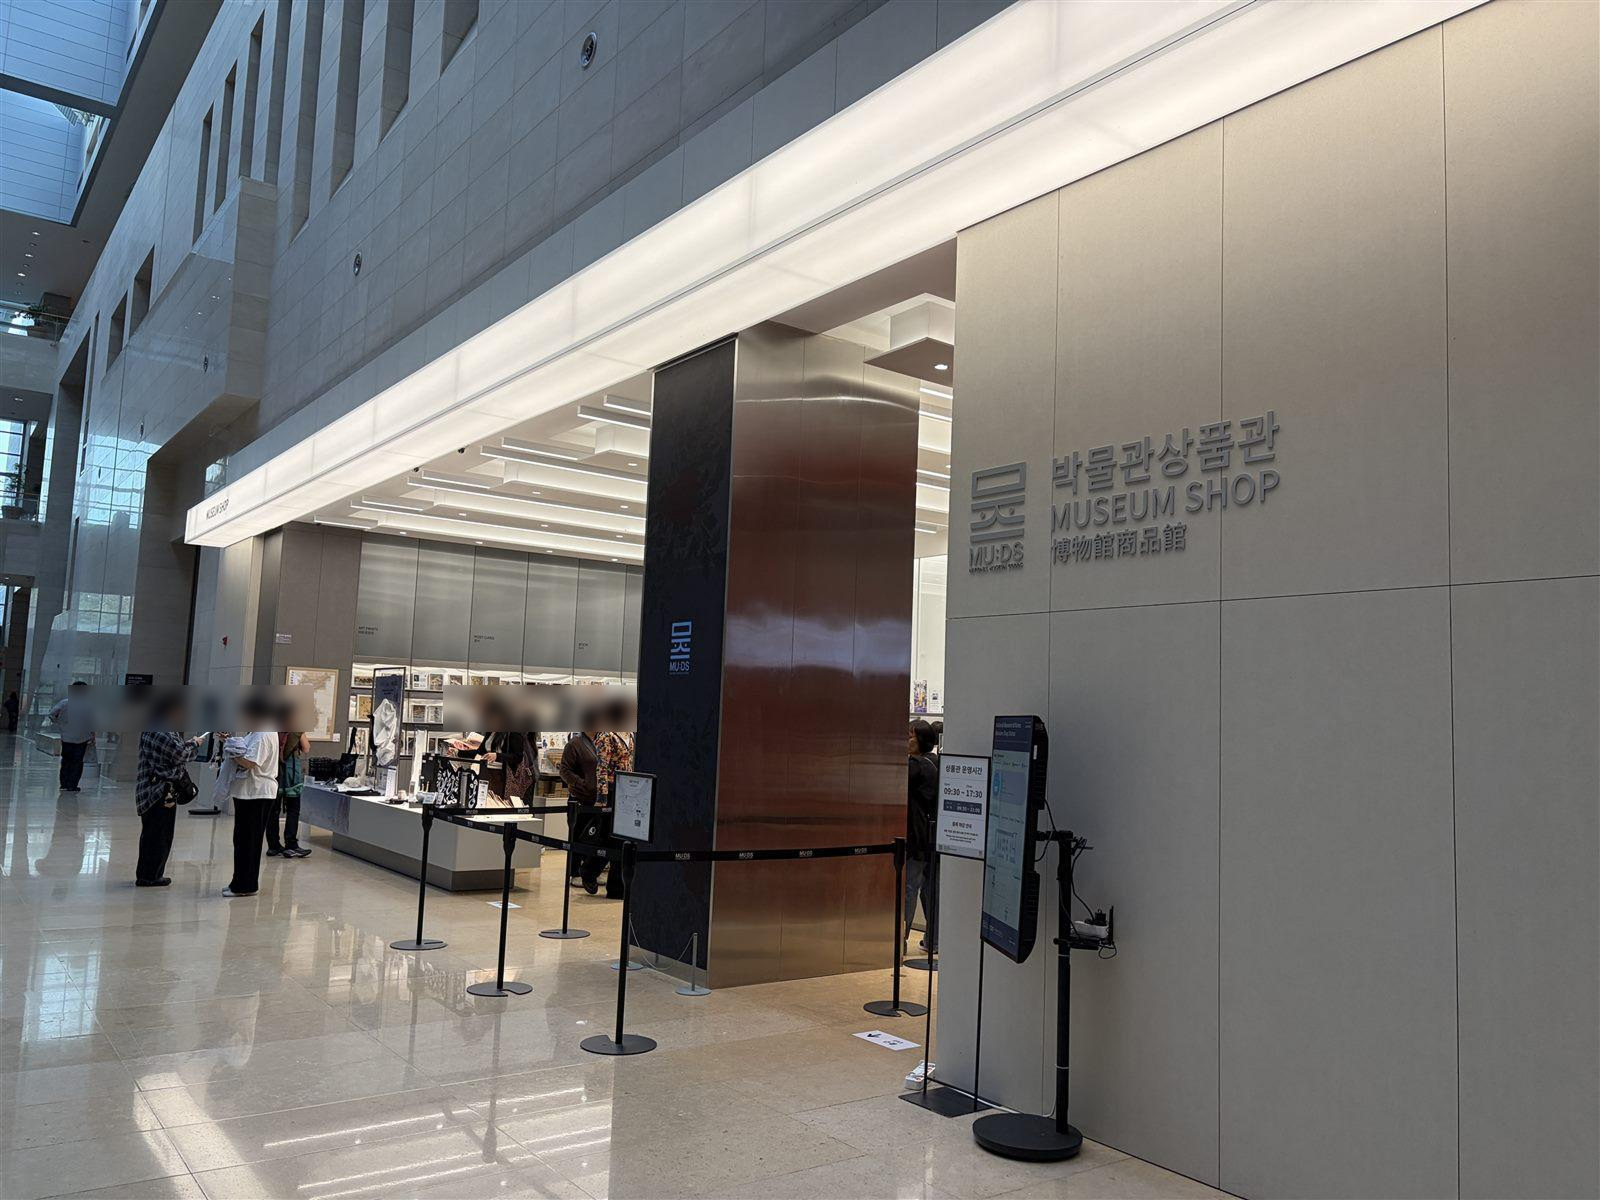
사유의 방과 의궤실까지 둘러보고 나니 자연스럽게 발길이 박물관 상품관으로 향했다.
투어의 여운은 뮷즈로
국립중앙박물관 상품관은 박물관 내부와 외부에 한 곳씩, 모두 두 곳이 있다. 국립중앙박물관의 굿즈 브랜드 ‘뮷즈(MU:DS)’는 방금 본 유물을 일상 소품으로 옮겨 놓은 듯해 구경하는 재미가 쏠쏠했다. 이번에는 투어에서 들은 이야기와 이어지는 굿즈를 골랐다.
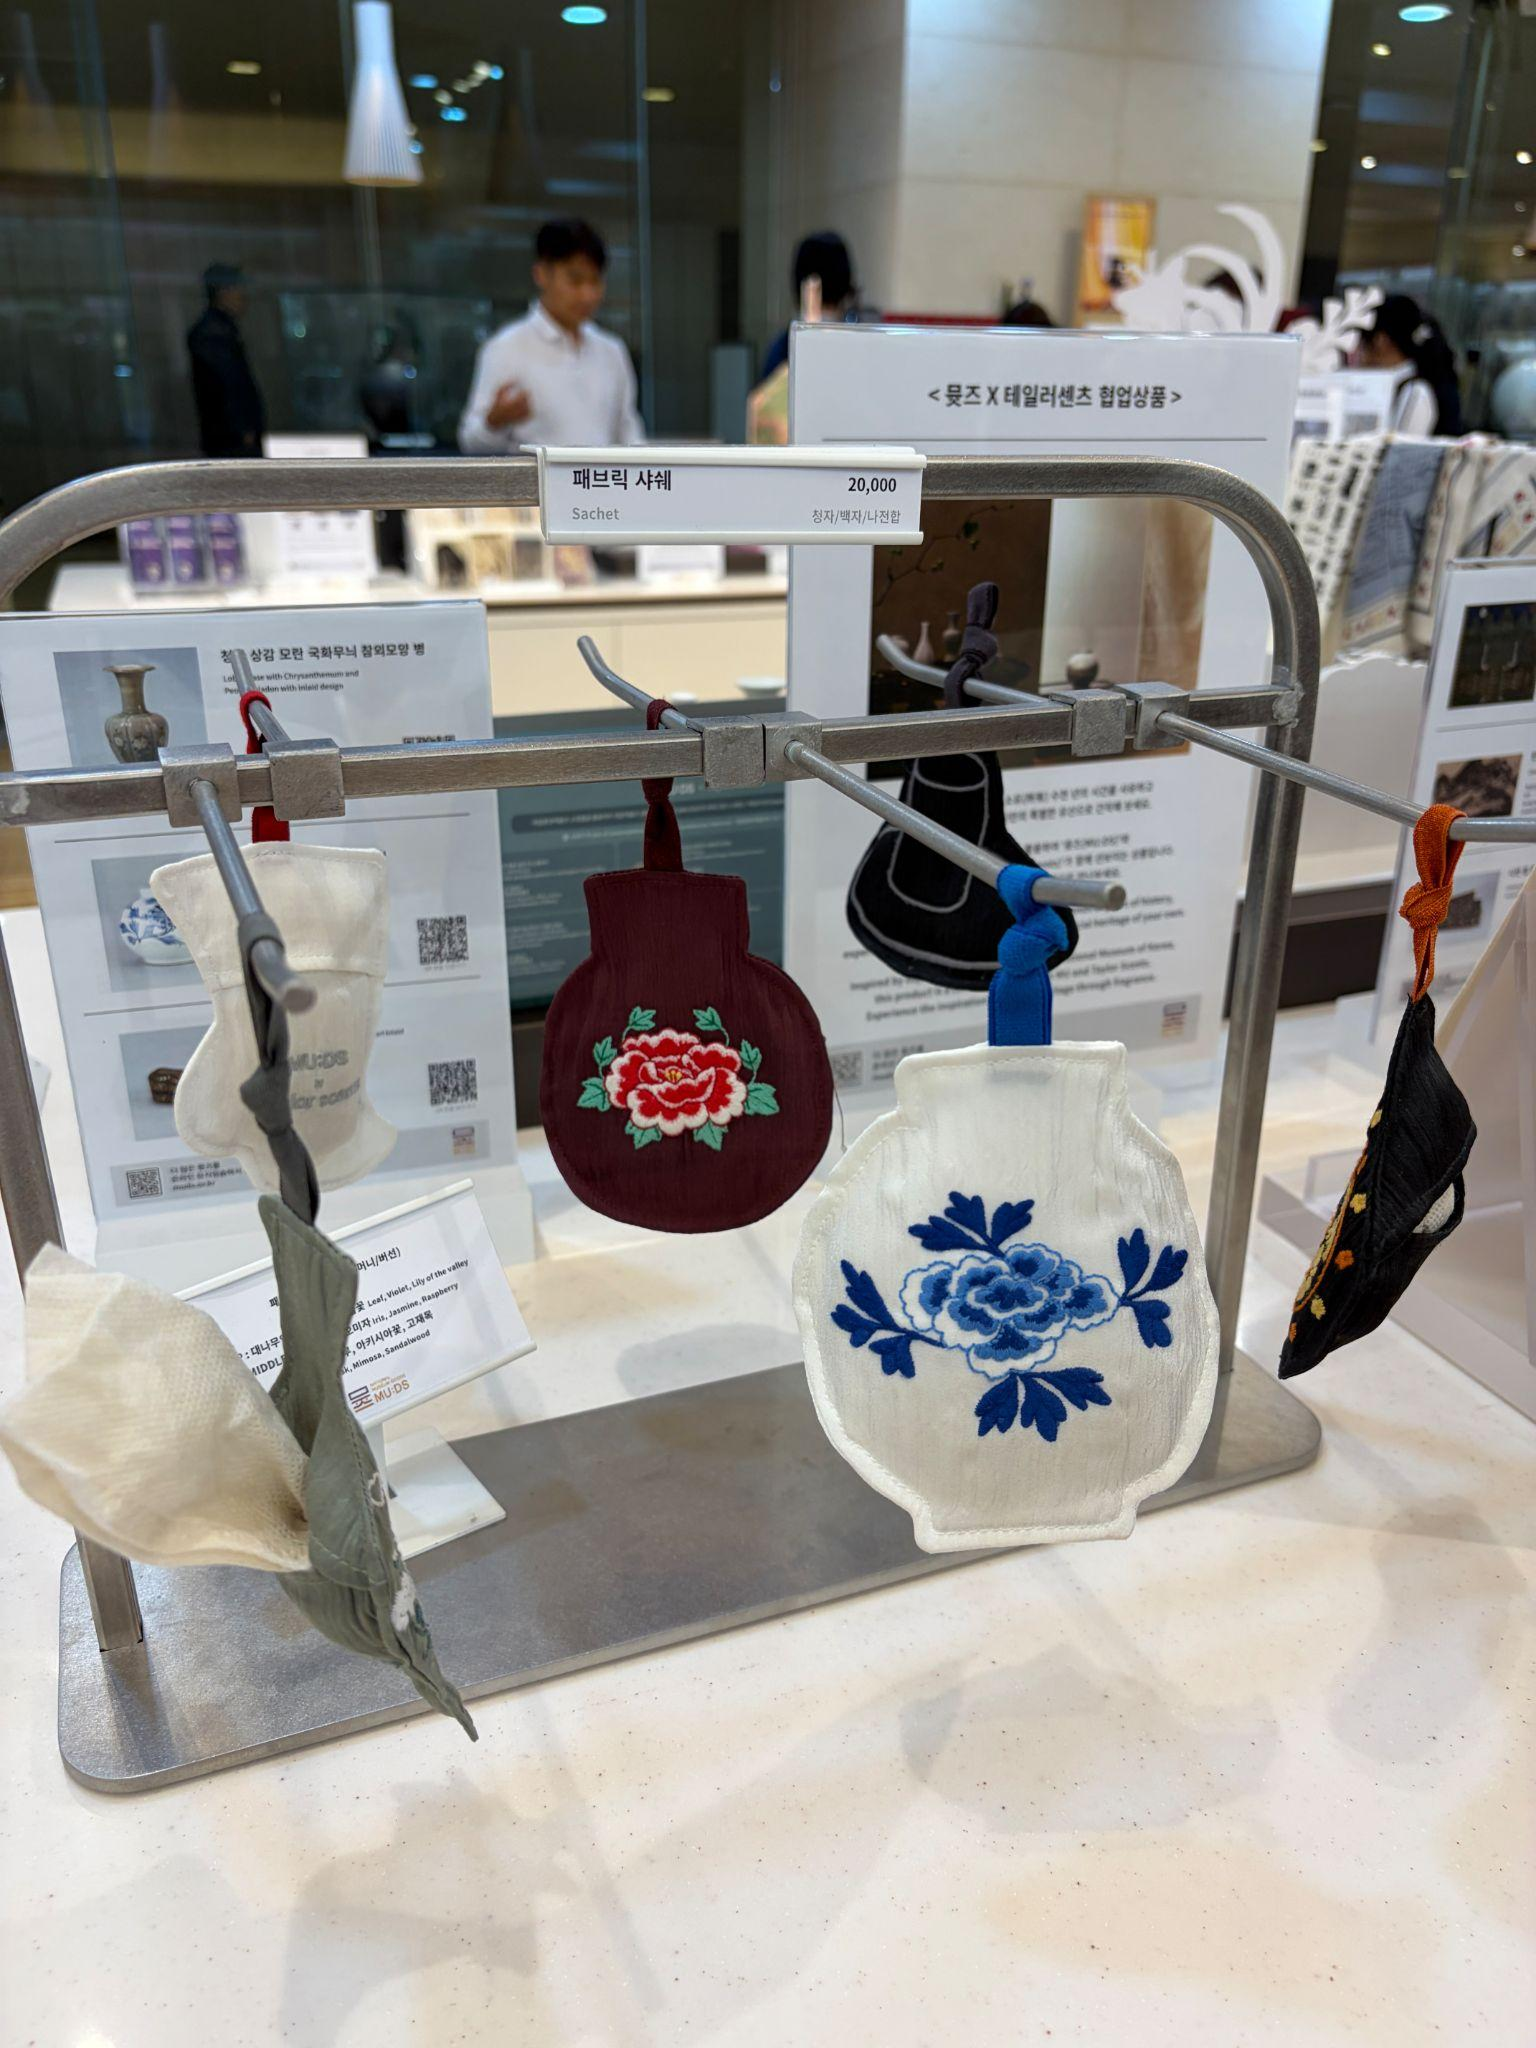
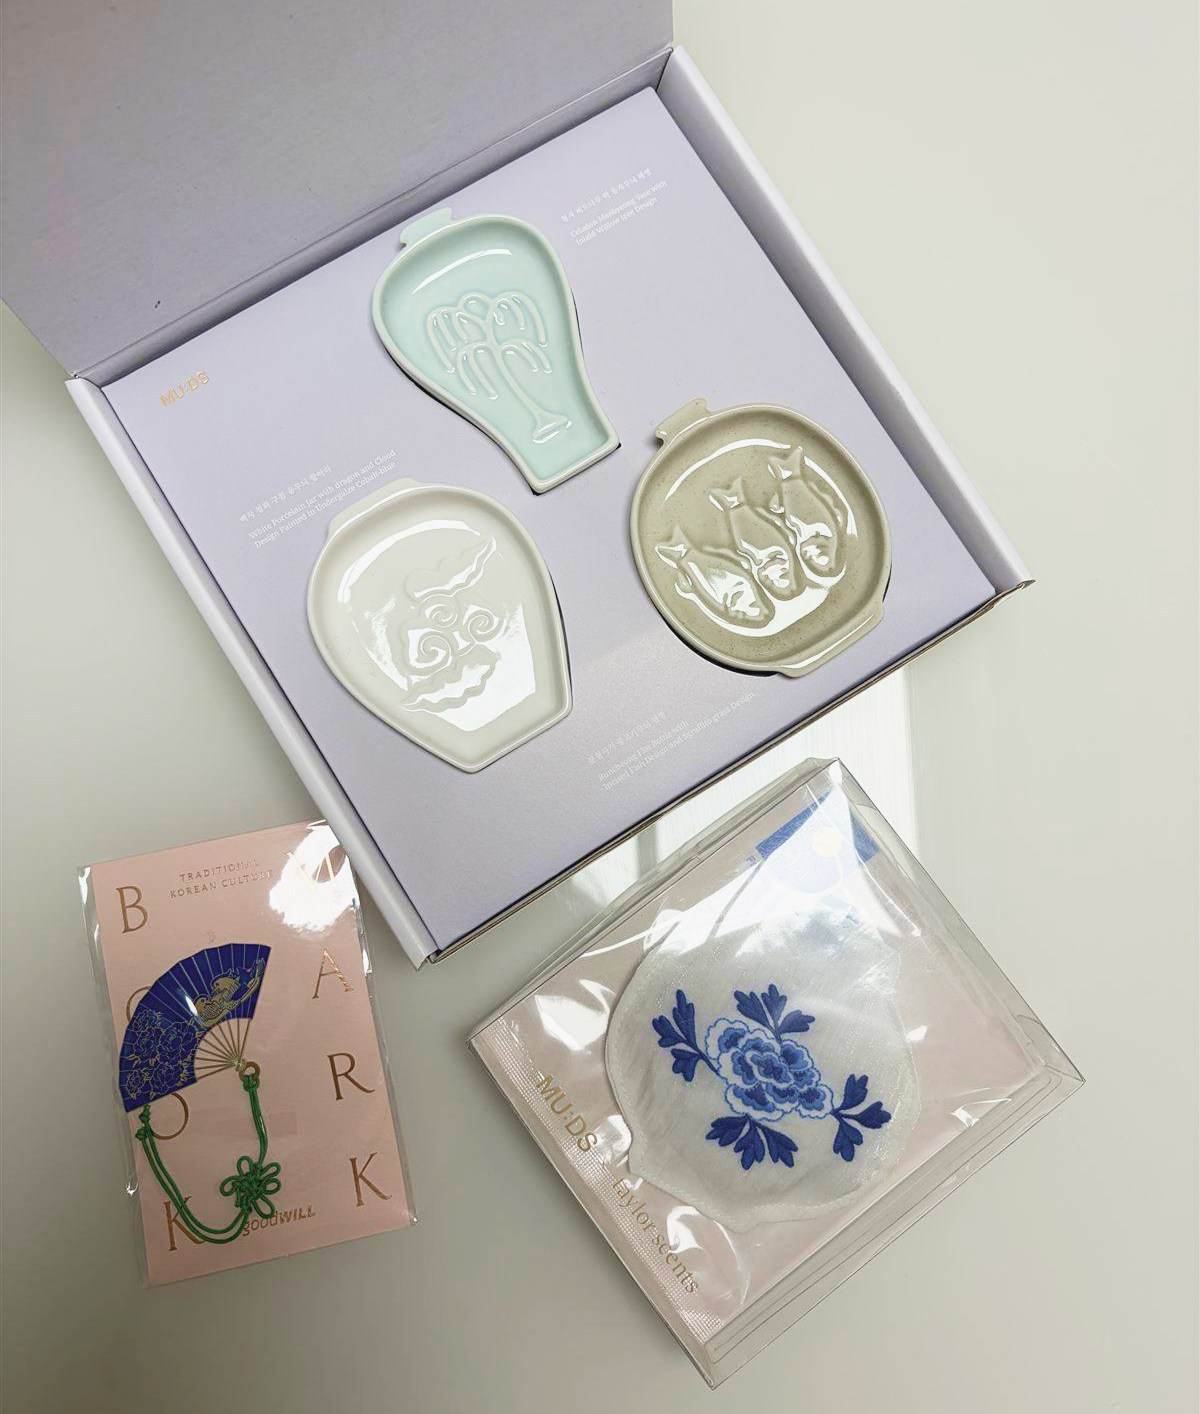
뮷즈 x 테일러센츠 패브릭 샤쉐 ‘백자’
달항아리 앞에서 들은 ‘순백이 아닌 백자’ 이야기가 떠올라 집어 든 한정판 방향제다. 조선 19세기 백자 청화 모란무늬 항아리의 푸른 모란을 패브릭 위에 그대로 옮겼다. 향 이름은 ‘사유의 먹(Ink of Contemplation)’이다. 유칼립투스, 샌달우드, 패출리가 어우러진 향이 사유의 방에서 느낀 고요함을 집으로 옮겨 온 듯하다. 향은 진하게 퍼지지 않고 오래된 원목 가구처럼 은은하게 머문다. 안방 도어스토퍼에 걸어 두었더니 방문을 열 때마다 좋은 향기가 퍼진다.
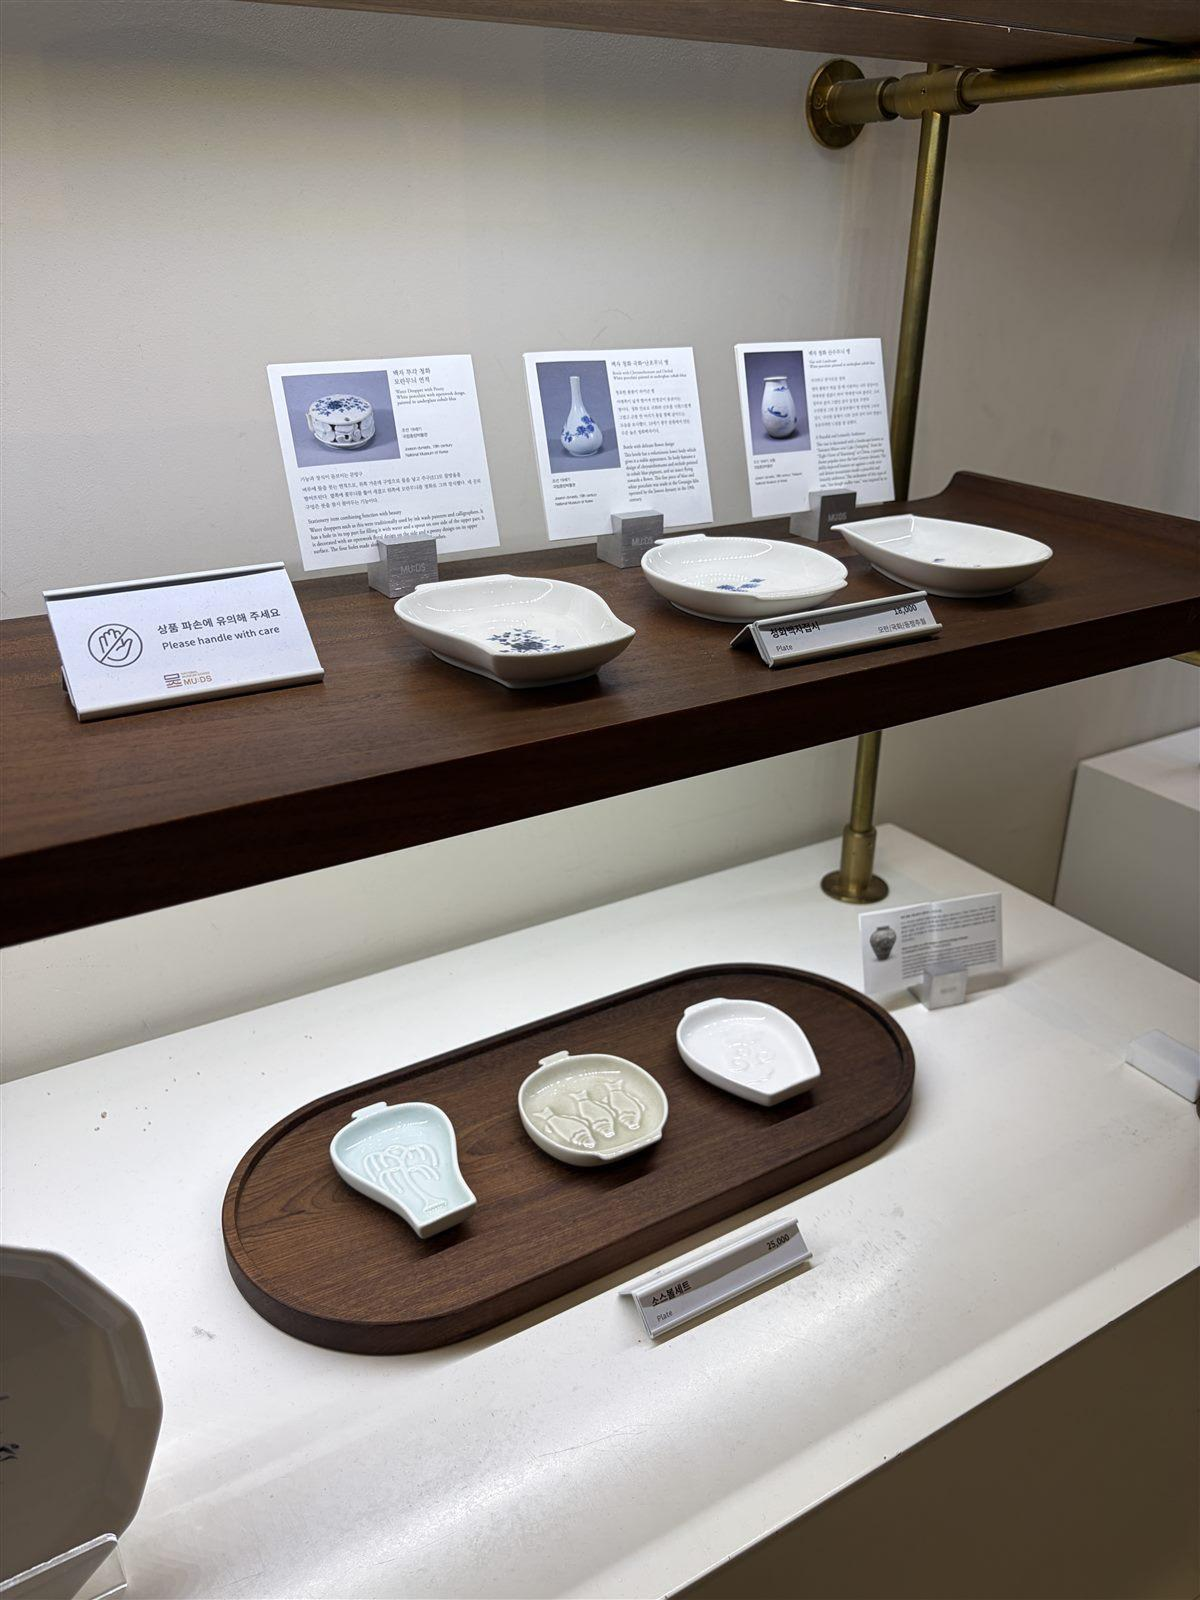
도자 유물 소스볼 세트(국립광주박물관 도자문화관 특화상품)
상형청자를 보고 나니 그릇 모양 하나에도 눈길이 갔다. 도자 유물의 형태를 그대로 본뜬 광주요의 소스볼 세트로, 은은한 빛깔의 접시 세 개가 한 상자에 담겼다. 바닥에 도드라진 양각 문양은 간장을 담으면 더 선명하게 드러난다. 국립중앙박물관에서 다른 국립박물관의 특화상품까지 만날 수 있다는 점도 반가웠다.
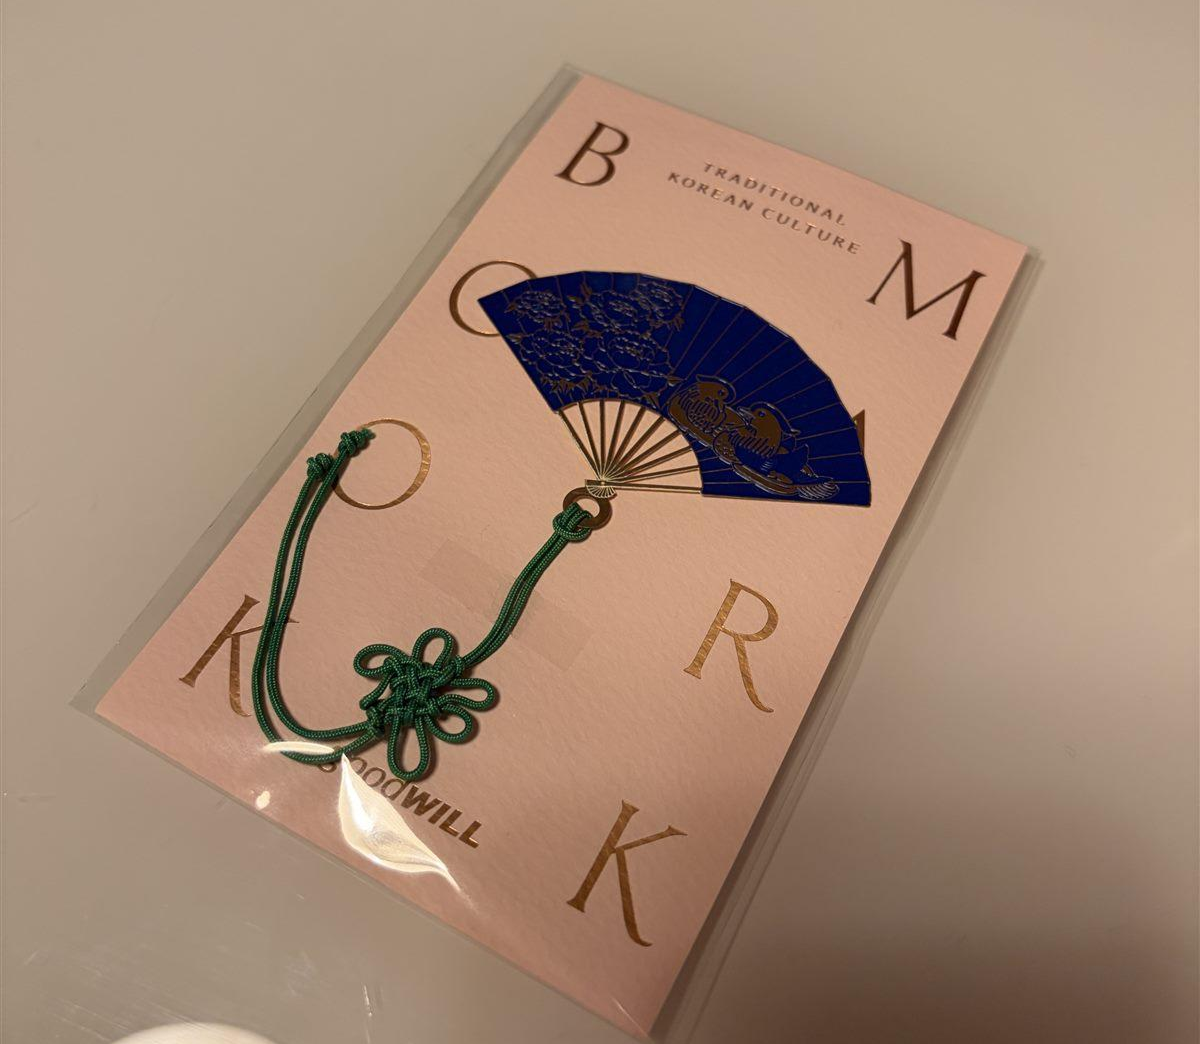
굿윌 폴딩 부채 북마크
전통 접부채를 펼친 모습을 금속으로 담아낸 책갈피다. 남색 부채 위에 금빛 살이 펼쳐지고 초록 매듭 술이 달려 있어, 책 사이에 꽂아 두면 작은 노리개처럼 보인다. 책장을 넘길 때마다 한국적인 멋이 따라와 외국인 친구에게 한국을 소개하는 선물로도 제격이다.
양손 가득 굿즈를 챙겨 상품관을 나서니, 어느새 해가 기울고 있었다.
해 질 녘의 거울못을 뒤로하며
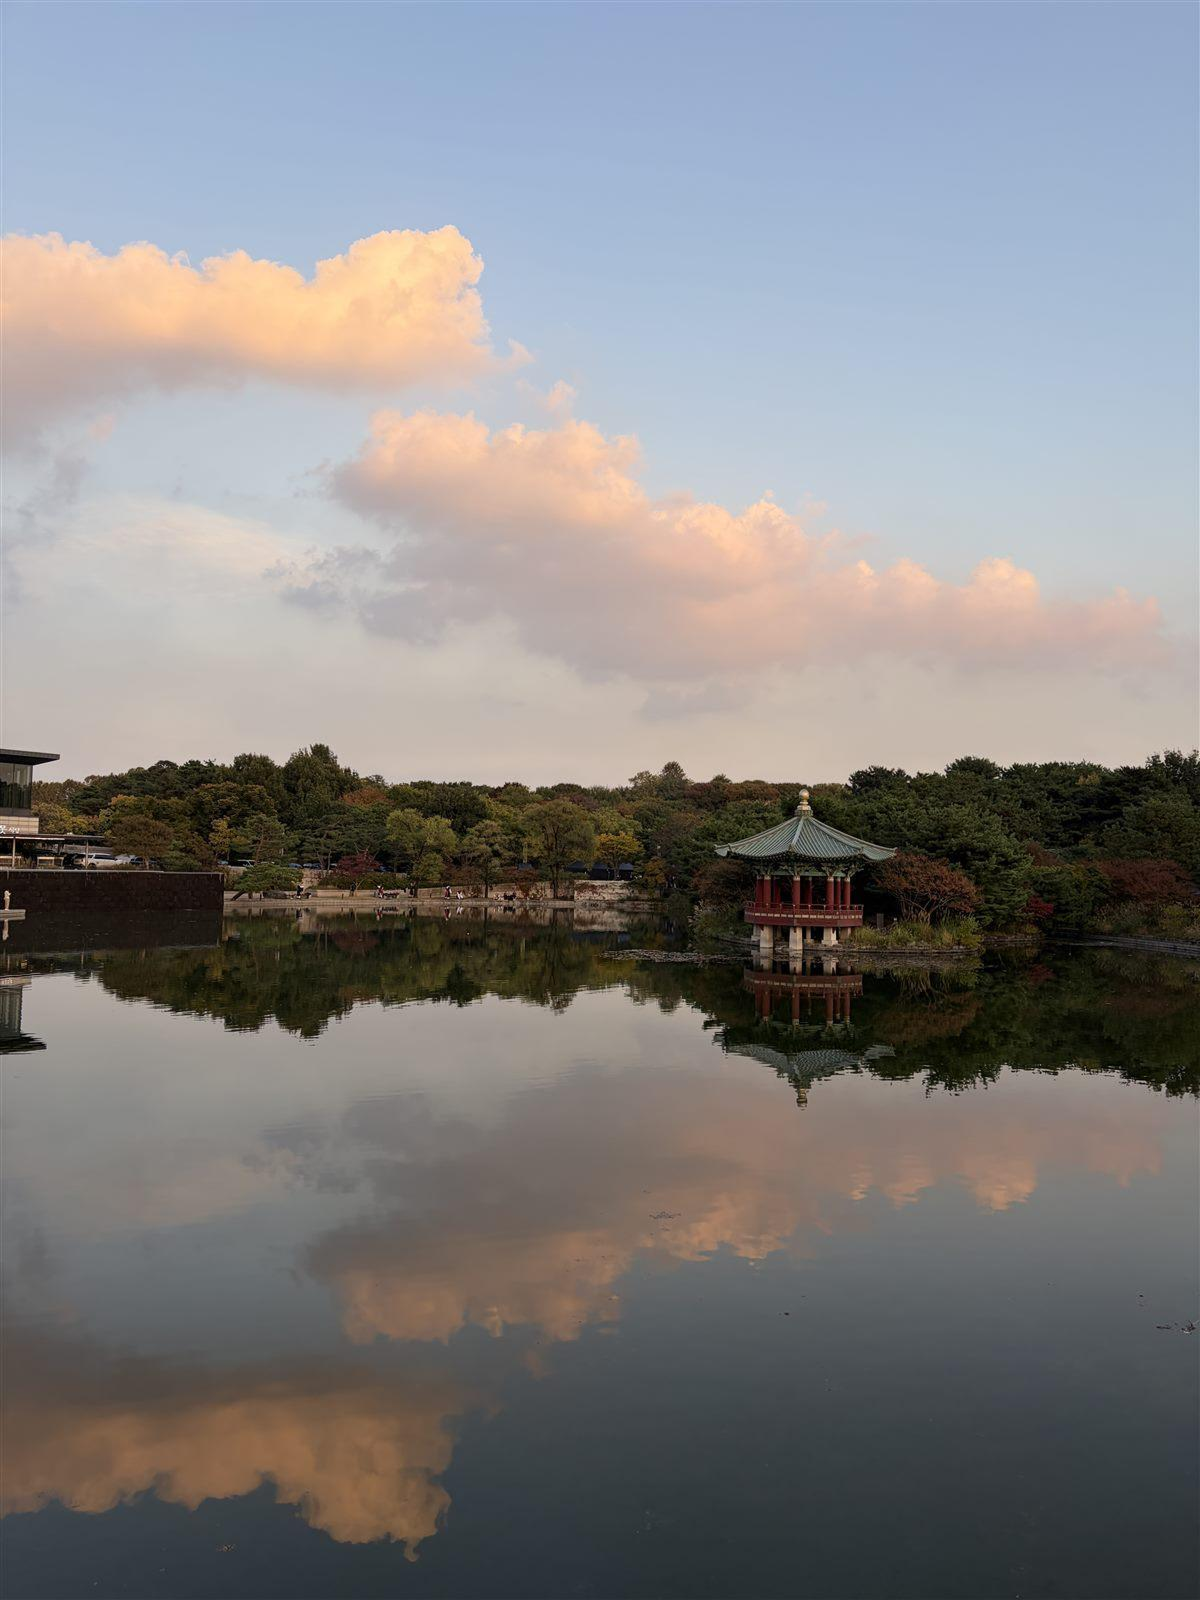
투어를 마치고 나오니 거울못 위로 노을이 내려앉고 있었다. 같은 유물이라도 이야기를 알고 보면 전혀 다르게 다가온다는 해설사님의 말이 오래 남았다. 미술 유물은 3개월마다 바뀐다고 하니, 계절이 바뀔 때마다 대표유물해설 시간에 맞춰 다시 찾아오고 싶다.
이번 주말, 해설사님과 함께 국립중앙박물관을 한 바퀴 걸어보는 건 어떨까? 🙋♀️
Hive 애널리틱스의 이벤트 원본 데이터는 BigQuery의 habq-storage 프로젝트에서 SQL로 직접 조회할 수 있다. 애널리틱스 관리자가 빅쿼리 접근 권한 관리에서 Google 계정의 조회 권한을 환경별로 신청하고, SQL을 실행할 Google Cloud 프로젝트를 준비하면 된다. 조회할 때는 UTC로 저장된 dateTime을 KST로 변환하고, checksum 기준으로 중복을 제거하며, 날짜 조건으로 필요한 파티션만 조회한다.
원본 데이터 활용한 데이터 검증
게임 이벤트를 수집한 뒤에는 이용자의 행동이 의도한 시점에 기록되었는지, 분석에 필요한 값이 빠짐없이 포함되었는지 확인해야 한다. 조회 기간이 길거나 여러 조건을 함께 적용해야 한다면 원본 이벤트를 직접 확인해야 할 때가 있다.
예를 들어 전송한 이벤트가 애널리틱스에서 확인되지 않는다면 수집 기준을 충족하지 못해 격리 테이블에 저장되었는지 점검해야 한다. 집계 수치가 예상보다 높다면 동일한 이벤트가 중복 전송되고 있지 않은지 확인할 수 있으며, 특정 기간·앱·국가에서 비정상적인 값이 반복되는지도 원본 로그를 통해 살펴볼 수 있다. 마켓 정산액과 매출 지표가 다를 때에는 대량의 구매 로그를 정산 데이터와 대조해 차이가 발생한 범위를 찾아야 한다.
BigQuery에서는 이러한 상황에 필요한 데이터를 SQL로 조회하고 중복 제거, 시간대 변환, 속성 추출 등의 전처리를 수행할 수 있다. 이를 통해 화면에 표시된 결과만으로는 알기 어려운 수집 오류와 집계 차이의 원인을 구체적으로 확인할 수 있다.
Hive 애널리틱스의 BigQuery 조회 환경
Hive 애널리틱스는 수집된 이벤트 데이터를 BigQuery에서 직접 조회할 수 있는 환경을 제공한다. 권한 신청부터 SQL 실행까지의 과정은 다음과 같다.
- Google 계정 준비
BigQuery에 접근할 Gmail 또는 회사에서 사용하는 Google 계정을 준비한다. - 권한 신청
애널리틱스 관리자 권한을 가진 사용자가 계정 메뉴의빅쿼리 접근 권한 관리에서 Google 계정을 등록한다. 권한은 신청한 애널리틱스 콘솔 환경에만 적용되므로 상용과 샌드박스 데이터를 모두 조회해야 한다면 각 환경에서 따로 신청한다. 신청 후에는 신청 내역에서 대기·완료·거절 등의 처리 상태를 확인한다. 권한은 일반적으로 즉시 부여되며, 신청 내역이 대기 상태인 경우에는 영업일 기준 최대 2일이 걸릴 수 있다. - Google Cloud 프로젝트 준비
SQL을 실행할 Google Cloud 프로젝트를 준비한다. Google Cloud 결제 계정이 없다면 BigQuery 샌드박스를 설정해 제한된 무료 범위에서 시작할 수 있다. 설정 방법과 제한 사항은 Google Cloud의 BigQuery 샌드박스 사용해 보기에서 확인할 수 있다. - 애널리틱스 프로젝트 연결
BigQuery 탐색기에서habq-storage프로젝트를 즐겨찾기에 추가한다. 프로젝트가 보이지 않는다면데이터 추가에서 이름으로 프로젝트에 별표표시를 선택하고habq-storage를 입력한다. - 데이터셋과 테이블 확인
프로젝트를 펼쳐 권한이 부여된 데이터셋과 이벤트 테이블을 확인한다. 상용 데이터는habq-storage.analytics_N_live, 샌드박스 데이터는habq-storage.analytics_N_sandbox에 저장된다. 데이터셋 이름의N에는 회사별 식별값이 들어가며, 접근 가능한 데이터셋만 탐색기에 표시되므로 이 값을 별도로 확인할 필요는 없다. 조회할 수 있는 테이블의 종류와 용도, 주요 컬럼은 개발자 사이트의 BigQuery 테이블에서 확인할 수 있다. - SQL 실행
SQL을 실행하려면 선택한 Google Cloud 프로젝트에 BigQuery 작업 사용자 권한이 필요하다. BigQuery 샌드박스로 만든 프로젝트는 무료 사용량 한도까지 별도 권한 설정 없이 조회할 수 있다. 프로젝트를 선택한 뒤 SQL 편집기에서 쿼리를 실행한다.
업무 변경이나 퇴사 등으로 원본 데이터 조회가 더 이상 필요하지 않은 계정은 애널리틱스의 빅쿼리 접근 권한 관리에서 권한 회수를 신청한다. 필요한 계정과 환경만 유지하면 원본 데이터에 대한 접근 범위를 명확하게 관리할 수 있다.
BigQuery 조회 권한의 신청과 회수, Google Cloud 프로젝트 준비에 관한 자세한 절차는 개발자 사이트의 BigQuery 설정에서 확인할 수 있다.
BigQuery에서 이벤트 원본 데이터 조회해보기
예를 들어 상용 환경에서 수집된 contents_success 이벤트의 기본 정보와 속성을 확인한다고 가정해보자. Google BigQuery에 접속한 후, BigQuery 콘솔 왼쪽 상단의 프로젝트 선택 영역에서 SQL을 실행할 Google Cloud 프로젝트를 선택한다. SQL 편집기를 열어 다음과 같이 조회 조건을 구성한다.
SELECT
  userId,
  deviceId,
  appIdGroup,
  appId,
  DATETIME(TIMESTAMP_ADD(dateTime, INTERVAL 32400 SECOND)) AS dateTime_kst,
  attributes
FROM `habq-storage.analytics_N_live.t_raw_event_log`  --analytics_N_live: 권한이 부여된 상용 데이터셋
WHERE identifierProvider = 'hive'
  AND eventName = 'contents_success'  --조회할 이벤트명
  AND appIdGroup = 'com.sample.test'  --조회할 게임의 실제 appIdGroup
  AND dateTime >= TIMESTAMP_SUB(TIMESTAMP('2026-10-01 00:00:00'), INTERVAL 32400 SECOND)  --조회할 기간의 시작일
  AND dateTime < TIMESTAMP_SUB(TIMESTAMP('2026-10-08 00:00:00'), INTERVAL 32400 SECOND)  --조회할 기간의 종료일
QUALIFY ROW_NUMBER() OVER (
  PARTITION BY checksum
  ORDER BY bigqueryRegistTimestamp DESC
) = 1
LIMIT 100
쿼리를 실행하기 전에는 주석으로 표시한 값을 실제 조회 환경에 맞게 변경한다.
dateTime은 UTC 기준으로 저장되므로 예시에서는 9시간을 더해 KST로 표시한다. 조회 기간도 KST를 기준으로 설정하려면 시작 시각과 종료 시각에서 9시간을 빼 UTC 조건으로 변환한다.
동일한 이벤트가 다시 전송되면 중복 데이터가 저장될 수 있다. 예시의 QUALIFY 절은 checksum이 같은 데이터 중 bigqueryRegistTimestamp가 가장 최근인 한 건만 남긴다. 중복 제거 기준은 분석 목적과 이벤트 전송 방식에 맞게 적용한다.
t_raw_event_log는 dateTime을 기준으로 구성된 일별 파티션 테이블이다. 쿼리에는 날짜 조건을 함께 입력해 필요한 파티션만 조회하여 조회 비용을 줄일 수 있다. 실행 전에 BigQuery에 표시되는 예상 처리 용량도 확인하면 불필요한 데이터 조회와 비용을 줄일 수 있다.
조회 결과에서는 이용자와 앱 정보뿐만 아니라 attributes에 저장된 이벤트 속성도 확인할 수 있다. 특정 속성을 별도 열로 확인하려면 JSON_VALUE와 자료형 변환 함수를 이용해 필요한 값을 추출한다.
Hive 애널리틱스 시작해보기
BigQuery 조회 환경을 준비하면 특정 이벤트와 속성값을 원하는 조건으로 확인하고, 지표의 집계 기준을 원본 데이터와 비교할 수 있다.
Hive 애널리틱스는 Hive SDK를 통해 수집된 이벤트를 BigQuery에서 직접 조회할 수 있는 환경을 제공하는 게임 전문 애널리틱스 솔루션이다. 지금 Hive 애널리틱스에서 BigQuery 조회 권한을 신청하고 게임 데이터를 직접 살펴보자.


